

Hola, Habr.
Recientemente compartí sobre los parámetros que utilizamos con más frecuencia en nuestro equipo para Kafka Producer y Consumer, con el fin de acercarnos a la entrega garantizada. En este artículo quiero contar cómo organizamos el reprocesamiento de eventos recibidos de Kafka debido a la indisponibilidad temporal de un sistema externo.
Las aplicaciones modernas operan en un entorno muy complejo. La lógica de negocio, envuelta en una pila tecnológica moderna, que funciona en una imagen de Docker gestionada por un orquestador como Kubernetes u OpenShift, y que se comunica con otras aplicaciones o soluciones empresariales a través de una cadena de enrutadores físicos y virtuales. En un entorno así, siempre puede fallar algo, por lo que el reprocesamiento de eventos en caso de la indisponibilidad de uno de los sistemas externos es una parte importante de nuestros procesos de negocio.
Cómo era antes de Kafka
Anteriormente en el proyecto utilizábamos IBM MQ para la entrega asíncrona de mensajes. Cuando se producía algún error durante la operación del servicio, el mensaje recibido podía ser colocado en una cola de mensajes muertos (DLQ) para su posterior revisión manual. La DLQ se creaba junto a la cola de entrada, y el traslado del mensaje ocurría dentro de IBM MQ.
Si el error era temporal y podíamos determinarlo (por ejemplo, ResourceAccessException al hacer una llamada HTTP o MongoTimeoutException al hacer una consulta en MongoDb), se activaba la estrategia de reintentos. Independientemente de la ramificación de la lógica de la aplicación, el mensaje original se trasladaba ya sea a una cola del sistema para envío diferido o a una aplicación separada que se había creado hace tiempo para reenvío de mensajes. En este caso, se registraba en el encabezado del mensaje el número de reenvío, que estaba vinculado al intervalo de retardo o al final de la estrategia a nivel de la aplicación. Si llegábamos al final de la estrategia, pero el sistema externo seguía sin estar disponible, el mensaje se colocaría en la DLQ para revisión manual.
Búsqueda de solución
, se puede encontrar lo siguiente . En resumen, se sugiere establecer un tema para cada intervalo de retardo y realizar en la parte de la aplicación Consumers que leerán los mensajes con el retraso necesario.
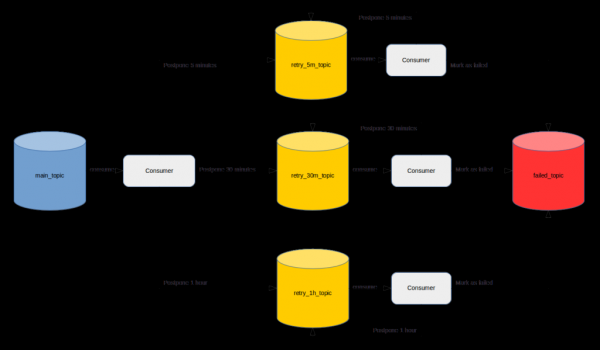
A pesar de la gran cantidad de comentarios positivos, me parece que no es del todo adecuado. En primer lugar, porque al desarrollador, además de implementar los requisitos comerciales, le llevará mucho tiempo implementar el mecanismo descrito.
Además, si se habilita el control de acceso en el clúster de Kafka, se necesitará algo de tiempo para crear los temas y garantizar los accesos necesarios a ellos. Además de esto, será necesario elegir el parámetro correcto retention.ms para cada uno de los temas de reintento, de modo que los mensajes puedan ser reenviados a tiempo y no se pierdan. La implementación y la solicitud de accesos deberán repetirse para cada servicio existente o nuevo.
Ahora veamos qué mecanismos para el re-procesamiento de mensajes nos ofrece Spring en general y Spring-Kafka en particular. Spring-Kafka tiene una dependencia transitiva en Spring-Retry, que proporciona abstracciones para gestionar diferentes BackOffPolicy. Es una herramienta bastante flexible, pero su desventaja significativa es que almacena los mensajes para reenvío en la memoria de la aplicación. Esto significa que el reinicio de la aplicación debido a una actualización o un error durante la explotación resultará en la pérdida de todos los mensajes que esperan ser re-procesados. Dado que este aspecto es crítico para nuestro sistema, no lo consideramos más adelante.
Spring-Kafka ofrece varias implementaciones de ContainerAwareErrorHandler, como por ejemplo , que permite procesar el mensaje más tarde sin mover el offset en caso de un error. A partir de la versión 2.3 de Spring-Kafka, se introdujo la posibilidad de establecer BackOffPolicy.
Este enfoque permite que los mensajes re-procesados sobrevivan al reinicio de la aplicación, pero el mecanismo DLQ sigue siendo ausente. Precisamente esta opción elegimos a principios de 2019, optimistamente pensando que no necesitaríamos DLQ (tuvimos suerte y realmente no lo necesitábamos durante varios meses de explotación de la aplicación con este sistema de re-procesamiento). Los errores temporales provocaban la activación de SeekToCurrentErrorHandler. Los demás errores se imprimían en el registro, llevaban al desplazamiento del offset y el procesamiento continuaba con el siguiente mensaje.
Solución final
La implementación basada en SeekToCurrentErrorHandler nos llevó a desarrollar nuestro propio mecanismo para el reenvío de mensajes.
Primero que nada, queríamos aprovechar la experiencia existente y ampliarla según la lógica de la aplicación. Para una aplicación con una lógica lineal, lo óptimo sería detener la lectura de nuevos mensajes durante un breve intervalo de tiempo, establecido dentro de la estrategia de reintentos. Para otras aplicaciones, nos gustaría tener un punto único que garantizara la ejecución de la estrategia de reintentos. Además, este punto único debería contar con funcionalidad DLQ para ambos enfoques.
La estrategia de reintentos en sí debe almacenarse en la aplicación responsable de obtener el siguiente intervalo en caso de un error temporal.
Detener el Consumer para una aplicación con lógica lineal
Al trabajar con spring-kafka, el código para detener el Consumer podría verse aproximadamente así:
public void pauseListenerContainer(MessageListenerContainer listenerContainer,
                                   Instant retryAt) {
        if (nonNull(retryAt) && listenerContainer.isRunning()) {
            listenerContainer.stop();
            taskScheduler.schedule(() -> listenerContainer.start(), retryAt);
            return;
        }
        // a DLQ
    }
En el ejemplo, retryAt es el momento en que se debe reiniciar el MessageListenerContainer, si todavía está funcionando. El reinicio se llevará a cabo en un hilo separado que se ejecuta en TaskScheduler, cuya implementación también proporciona spring.
El valor de retryAt lo encontramos de la siguiente manera:
- Se busca el valor del contador de reintentos.
- De acuerdo con el valor del contador, se busca el intervalo actual de retraso en la estrategia de reintentos. La estrategia se declara en la propia aplicación, para su almacenamiento elegimos el formato JSON.
- El intervalo encontrado en el array JSON contiene la cantidad de segundos después de los cuales se deberá repetir el procesamiento. Esta cantidad de segundos se suma al tiempo actual, formando el valor para retryAt.
- Si no se encuentra el intervalo, el valor de retryAt es null y el mensaje se enviará a la DLQ para su análisis manual.
Con este enfoque, solo queda guardar la cantidad de intentos para cada mensaje que actualmente está en proceso, por ejemplo, en la memoria de la aplicación. Mantener un contador de intentos en la memoria no es crítico para este enfoque, ya que una aplicación con lógica lineal no puede procesar en su totalidad. A diferencia de spring-retry, el reinicio de la aplicación no resultará en la pérdida de todos los mensajes para re-procesamiento, sino simplemente en un reinicio de la estrategia.
Este enfoque ayuda a aliviar la carga de un sistema externo que puede estar inalcanzable debido a una carga excesiva. En otras palabras, además de la re-procesamiento, hemos logrado implementar el patrón .
En nuestro caso, el umbral de error es de solo 1, y para minimizar el tiempo de inactividad del sistema debido a una interrupción temporal de la red, utilizamos una estrategia de reintentos muy granular con pequeños intervalos de retraso. Esto puede no ser adecuado para todas las aplicaciones del grupo empresarial, por lo que la relación entre el umbral de error y el tamaño del intervalo debe ajustarse según las características del sistema.
Una aplicación separada para procesar mensajes de aplicaciones con lógica no determinística
Aquí hay un ejemplo de código que envía un mensaje a tal aplicación (Retryer), que volverá a enviar al tema DESTINATION al alcanzar el tiempo RETRY_AT:
public  void retry(ConsumerRecord record, String retryToTopic,
                         Instant retryAt, String counter, String groupId, Exception e) {
        Headers headers = ofNullable(record.headers()).orElse(new RecordHeaders());
        List arrayOfHeaders =
            new ArrayList(Arrays.asList(headers.toArray()));
        updateHeader(arrayOfHeaders, GROUP_ID, groupId::getBytes);
        updateHeader(arrayOfHeaders, DESTINATION, retryToTopic::getBytes);
        updateHeader(arrayOfHeaders, ORIGINAL_PARTITION,
                     () -> Integer.toString(record.partition()).getBytes());
        if (nonNull(retryAt)) {
            updateHeader(arrayOfHeaders, COUNTER, counter::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "retry"::getBytes);
            updateHeader(arrayOfHeaders, RETRY_AT, retryAt.toString()::getBytes);
        } else {
            updateHeader(arrayOfHeaders, REASON,
                         ExceptionUtils.getStackTrace(e)::getBytes);
            updateHeader(arrayOfHeaders, SEND_TO, "backout"::getBytes);
        }
        ProducerRecord messageToSend =
            new ProducerRecord(retryTopic, null, null, record.key(), record.value(), arrayOfHeaders);
        kafkaTemplate.send(messageToSend);
    }
Del ejemplo se puede ver que se transmite mucha información en los encabezados. El valor RETRY_AT se encuentra también, al igual que para el mecanismo de reintento a través de la detención del Consumer.
- GROUP_ID, por el cual agrupamos los mensajes para análisis manual y facilitar la búsqueda.
- ORIGINAL_PARTITION, para intentar mantener el mismo Consumer para el procesamiento posterior. Este parámetro puede ser nulo, en cuyo caso se obtendrá una nueva partición por la clave record.key() del mensaje original.
- Valor actualizado de COUNTER, para seguir la estrategia de reintentos.
- SEND_TO — constante que indica si se debe reenvíar el mensaje para su procesamiento nuevamente al alcanzar RETRY_AT o colocarlo en DLQ.
- REASON — razón por la cual el procesamiento del mensaje fue interrumpido.
Retryer guarda los mensajes para reenvío y análisis manual en PostgreSQL. Una tarea se activa por temporizador, que encuentra mensajes con RETRY_AT alcanzado y los envía de regreso a la partición ORIGINAL_PARTITION del tema DESTINATION con la clave record.key().
Después de enviar, los mensajes se eliminan de PostgreSQL. El análisis manual de los mensajes se realiza en una interfaz simple, que interactúa con Retryer a través de REST API. Sus características principales son reenvío o eliminación de mensajes de DLQ, visualización de información de errores y búsqueda de mensajes, por ejemplo, por nombre de error.
Dado que en nuestros clústeres se habilita el control de acceso, es necesario solicitar permisos adicionales para el tema que escucha Retryer, y permitir que Retryer escriba en el tema DESTINATION. Esto es incómodo, pero, a diferencia del enfoque con un tema a intervalos, tenemos una DLQ completa y una interfaz para gestionarla.
Puede haber casos en los que el tema de entrada sea leído por varios grupos de consumidores diferentes, cuyas aplicaciones implementan diferentes lógicas. El reenvío del mensaje a través de Retryer para una de estas aplicaciones resultará en un duplicado en otra. Para protegerse contra esto, creamos un tema separado para el reenvío. El consumidor puede leer tanto el tema de entrada como el tema de reintentos sin restricciones.
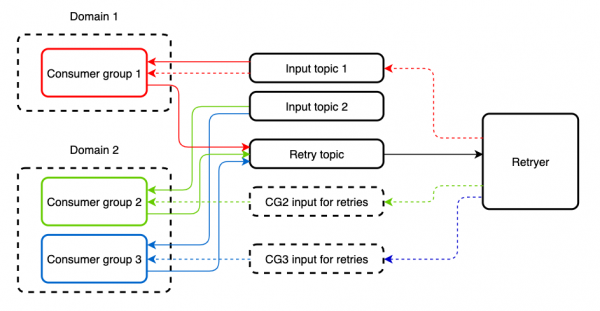
Por defecto, este enfoque no proporciona un mecanismo de cortafuegos, sin embargo, se puede agregar al aplicativo a través de o del nuevo , envolviendo los lugares de llamadas a servicios externos en las abstracciones correspondientes. Además, se presenta la posibilidad de elegir la estrategia para el patrón , lo que también puede ser útil. Por ejemplo, en spring-cloud-netflix puede ser un grupo de hilos o un semáforo.
Salida
Como resultado, hemos creado una aplicación independiente que permite repetir el procesamiento de mensajes ante la indisponibilidad temporal de algún sistema externo.
Una de las principales ventajas de la aplicación es que puede ser utilizada por sistemas externos que operan en el mismo clúster de Kafka, ¡sin necesidad de grandes modificaciones de su parte! Esta aplicación solo necesitará acceder al tema de reintentos, llenar algunos encabezados de Kafka y enviar el mensaje al Retryer. No es necesario levantar infraestructura adicional. Además, para reducir la cantidad de mensajes que se trasladan de la aplicación al Retryer y viceversa, hemos aislado aplicaciones con lógica lineal y hemos implementado el re-procesamiento mediante la detención del Consumer.
Fuente: habr.com
