

¡Hola a todos, amigos!
* Este artículo está basado en el taller público de REBRAIN & Yandex.Cloud; si prefieres ver el video, puedes encontrarlo en este enlace —
Recientemente tuvimos la oportunidad de tocar Yandex.Cloud en persona. Como queríamos experimentar a fondo, inmediatamente descartamos la idea de lanzar un simple blog de wordpress con una base de datos en la nube; eso sería demasiado aburrido. Tras una breve reflexión, decidimos desplegar algo que se asemejara a una arquitectura de producción para la recepción y análisis de eventos en modo casi en tiempo real.
Estoy absolutamente seguro de que la vastedad de los negocios en línea (y otros) recopilan una gran cantidad de información sobre sus usuarios y sus acciones. Como mínimo, esto es necesario para tomar ciertas decisiones; por ejemplo, si gestionas un juego en línea, puedes observar las estadísticas sobre en qué nivel los usuarios suelen estancarse y abandonan tu juego. O por qué los usuarios se van de tu sitio sin comprar nada (hola, Yandex.Metrica).
Así que, nuestra historia: cómo escribimos una aplicación en golang, probamos kafka vs rabbitmq vs yqs, escribimos streaming de datos en un clúster de Clickhouse y visualizamos datos usando Yandex Datalens. Naturalmente, todo esto fue sazonado con ingeniosos detalles de infraestructura en forma de docker, terraform, gitlab ci y, por supuesto, prometheus. ¡Vamos!
Primero quiero aclarar que no podremos configurar todo de una vez; para esto necesitaremos varios artículos en la serie. Un poco sobre la estructura:
Parte 1 (la que estás leyendo). Definiremos el TLD y la arquitectura de la solución, así como escribiremos una aplicación en golang.
Parte 2. Llevamos nuestra aplicación a producción, la hacemos escalable y probamos la carga.
Parte 3. Intentaremos entender por qué necesitamos almacenar mensajes en un buffer y no en archivos, además de comparar kafka, rabbitmq y el servicio de cola de Yandex.
Parte 4. Desplegaremos un clúster de Clickhouse, escribiremos un streaming para mover datos al mismo desde el buffer y configuraremos la visualización en datalens.
Parte 5. Pondremos toda la infraestructura en orden — configuraremos ci/cd usando gitlab ci, conectaremos monitoreo y descubrimiento de servicios con prometheus y consul.
TLD
Primero, formularemos el requerimiento técnico — qué es exactamente lo que queremos obtener al final.
- Queremos tener un endpoint como events.kis.im (kis.im es el dominio de prueba que utilizaremos a lo largo de todos los artículos), que debe recibir eventos a través de HTTPS.
- Los eventos son simplemente un JSON del tipo: {"event": "view", "os": "linux", "browser": "chrome"}. En la etapa final, agregaremos algunos campos más, pero eso no tendrá un gran impacto. Si se desea, se puede cambiar a protobuf.
- El servicio debe ser capaz de procesar 10,000 eventos por segundo.
- Debe haber la posibilidad de escalar horizontalmente, simplemente añadiendo nuevas instancias a nuestra solución. Y sería ideal si pudiéramos distribuir la parte frontal en diferentes ubicaciones geográficas para reducir la latencia en las solicitudes de los clientes.
- Alta disponibilidad. La solución debe ser lo suficientemente estable y capaz de sobrevivir a la caída de cualquier parte (hasta un cierto número, por supuesto).
Arquitectura
Para este tipo de tareas, ya se han desarrollado arquitecturas clásicas que permiten escalar de manera eficiente. En la imagen se muestra un ejemplo de nuestra solución.
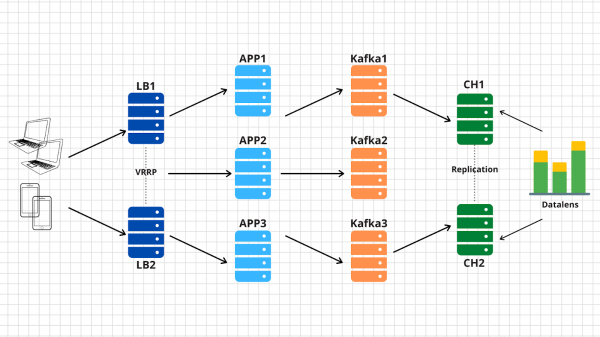
Entonces, ¿qué tenemos?
1. A la izquierda se muestran nuestros dispositivos que generan diversos eventos, ya sea el avance de los jugadores en un juego en un smartphone o la creación de un pedido en una tienda en línea a través de un navegador convencional. Un evento, como se indica en el pliego de condiciones, es un simple JSON que se envía a nuestro endpoint: events.kis.im.
2. Los primeros dos servidores son simples equilibradores de carga, sus principales tareas son:
- Estar siempre disponibles. Para esto, se puede utilizar, por ejemplo, keepalived, que cambiará la IP virtual entre nodos en caso de problemas.
- Terminar TLS. Sí, terminaremos TLS precisamente en ellos. Primero, para que nuestra solución cumpla con el pliego de condiciones, y segundo, para aliviar la carga de establecer la conexión cifrada de nuestros servidores backend.
- Balancear las solicitudes entrantes a los servidores backend disponibles. La palabra clave aquí es disponibles. Por lo tanto, entendemos que los equilibradores de carga deben ser capaces de monitorear nuestros servidores con aplicaciones y dejar de balancear el tráfico en los nodos caídos.
3. Detrás de los equilibradores de carga están nuestros servidores de aplicaciones, en los que se ejecuta una aplicación bastante simple. Debe ser capaz de recibir solicitudes entrantes a través de HTTP, validar el JSON enviado y almacenar los datos en un búfer.
4. En el esquema, se muestra un buffer como kafka, aunque, por supuesto, a este nivel se pueden utilizar otros servicios similares. Compararemos Kafka, rabbitmq y yqs en el tercer artículo.
5. El penúltimo punto de nuestra arquitectura es Clickhouse, una base de datos columnar que permite almacenar y procesar grandes volúmenes de datos. En este nivel, necesitamos trasladar los datos del buffer al sistema de almacenamiento propiamente dicho (de esto hablaremos en el artículo 4).
Este esquema nos permite escalar horizontalmente cada capa de forma independiente. Si los servidores backend no pueden manejar la carga, simplemente agregamos más, ya que son aplicaciones sin estado, lo que significa que se pueden agregar de forma automática. Si el buffer en forma de Kafka no es suficiente, agregaremos más servidores y trasladaremos algunas de las particiones de nuestro tópico. Si Clickhouse no puede manejar la carga, eso no es posible 🙂. En realidad, también agregaremos servidores y haremos un sharding de los datos.
Por cierto, si deseas implementar la parte opcional de nuestro pliego de condiciones y realizar la escalabilidad en diferentes geolocalizaciones, no hay nada más sencillo:
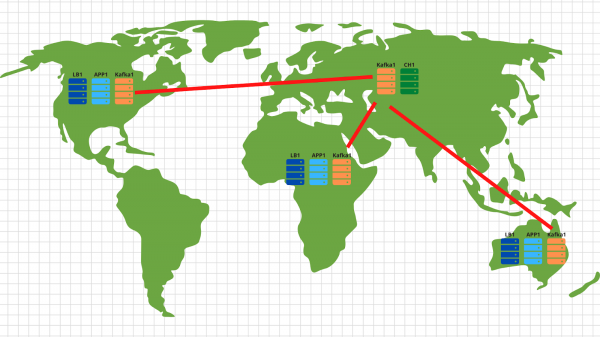
En cada geolocalización, desplegamos un balanceador de carga con la aplicación y kafka. En general, con 2 servidores de aplicación, 3 nodos de kafka y un balanceador en la nube, por ejemplo, cloudflare, que verificará la disponibilidad de los nodos de la aplicación y equilibrará las solicitudes según las geolocalizaciones basándose en la dirección IP de origen del cliente, es suficiente. De este modo, los datos enviados por un cliente estadounidense aterrizarán en servidores estadounidenses. Y los datos de África, en servidores africanos.
A partir de ahí, todo es muy simple: utilizamos la herramienta mirror del conjunto de kafka y copiamos todos los datos de todas las ubicaciones a nuestro centro de datos central, ubicado en Rusia. Internamente, procesamos los datos y los escribimos en Clickhouse para su posterior visualización.
Así que ya entendimos la arquitectura: ¡empezamos a poner a prueba Yandex.Cloud!
Escribimos una aplicación
Tendremos que esperar un poco más a la nube y escribir un servicio bastante simple para procesar los eventos entrantes. Usaremos golang, porque se ha establecido como un excelente lenguaje para la creación de aplicaciones de red.
Después de gastar una hora (quizás un par de horas), obtenemos algo así: .
¿Cuáles son los puntos principales que me gustaría destacar aquí?
1. Al iniciar la aplicación, se pueden especificar dos flags. Uno controla el puerto en el que escucharemos las solicitudes http entrantes (-addr). El segundo es la dirección del servidor kafka, donde registraremos nuestros eventos (-kafka):
addr     = flag.String("addr", ":8080", "Dirección TCP para escuchar")
kafka    = flag.String("kafka", "127.0.0.1:9092", "Puntos finales de Kafka")
2. La aplicación utiliza la biblioteca sarama () para enviar mensajes al clúster de kafka. Inmediatamente configuramos los ajustes orientados a la máxima velocidad de procesamiento:
config := sarama.NewConfig()
config.Producer.RequiredAcks = sarama.WaitForLocal
config.Producer.Compression = sarama.CompressionSnappy
config.Producer.Return.Successes = true
3. Además, nuestra aplicación incluye un cliente prometheus, que recopila diversas métricas, tales como:
- número de solicitudes a nuestra aplicación;
- número de errores al procesar la solicitud (no se puede leer la solicitud post, json dañado, no se puede escribir en kafka);
- tiempo de procesamiento de una solicitud del cliente, incluyendo el tiempo de escritura del mensaje en kafka.
4. Tres endpoint’s que maneja nuestra aplicación:
- /status — просто возвращаем ok, чтобы показать, что мы живы. Хотя можно и добавить некоторые проверки, типа доступности кафка кластера.
- /metrics — по этому url prometheus client будет возвращать собранные им метрики.
- /post — основной endpoint, куда будут приходить POST запросы с json внутри. Наше приложение проверяет json на валидность и если все ок — записывает данные в кафка-кластер.
Cabe aclarar que el código no es perfecto; se puede (¡y debe!) mejorar. Por ejemplo, se puede prescindir del uso de net/http incorporado y cambiar a fasthttp, que es más rápido. O se puede optimizar el tiempo de procesamiento y los recursos CPU, moviendo la validación del json a una etapa posterior, cuando los datos se transfieran del buffer al clúster de clickhouse.
Aparte de la parte de desarrollo, ya pensamos en nuestra futura infraestructura y decidimos desplegar nuestra aplicación a través de docker. El Dockerfile final para compilar la aplicación es . En general, es bastante sencillo, el único aspecto al que me gustaría llamar la atención es la compilación multietapa, que permite reducir el tamaño final de nuestra imagen de contenedor.
Primeros pasos en la nube
Primero, nos registramos en . Tras completar todos los campos necesarios, se nos creará una cuenta y se nos otorgará un crédito por una cierta cantidad de dinero, que se puede utilizar para probar los servicios de la nube. Si deseas repetir todos los pasos de nuestro artículo, este crédito debería ser suficiente.
Después del registro, se creará para ti una nube separada y un catálogo default, donde podrás empezar a crear recursos en la nube. En general, la interconexión de recursos en Yandex.Cloud se muestra de la siguiente manera:
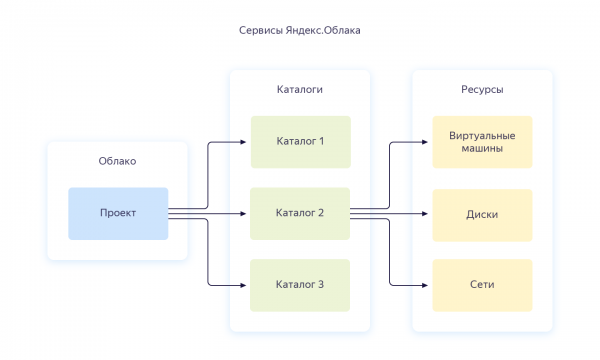
Con una cuenta, puedes crear varios nubes. Y dentro de cada nube, puedes hacer diferentes directorios para distintos proyectos de la empresa. Puedes leer más al respecto en la documentación — . Por cierto, a continuación me referiré a ella con frecuencia. Cuando configuré toda la infraestructura desde cero, la documentación me ayudó en más de una ocasión, así que te aconsejo que la estudies.
Para gestionar la nube, puedes usar tanto la interfaz web como la herramienta de consola — yc. La instalación se realiza con un solo comando (para Linux y Mac OS):
curl https://storage.yandexcloud.net/yandexcloud-yc/install.sh | bashSi tienes dudas sobre ejecutar scripts de Internet, primero puedes abrir el script y leerlo, y segundo, lo ejecutamos bajo nuestro propio usuario — sin derechos de root.
Si deseas instalar el cliente para Windows, puedes usar la instrucción y luego ejecutar yc init, para configurarlo completamente:
vozerov@mba:~ $ yc init
¡Bienvenido! Este comando te guiará a través del proceso de configuración.
Por favor, visita https://oauth.yandex.ru/authorize?response_type=token&client_id= para obtener el token OAuth.

Por favor, introduce el token OAuth:
Por favor, selecciona la nube que deseas usar:
 [1] cloud-b1gv67ihgfu3bp (id = b1gv67ihgfu3bpt24o0q)
 [2] fevlake-cloud (id = b1g6bvup3toribomnh30)
Introduce tu elección numérica: 2
Tu nube actual se ha configurado como 'fevlake-cloud' (id = b1g6bvup3toribomnh30).
Por favor, elige la carpeta que deseas usar:
 [1] default (id = b1g5r6h11knotfr8vjp7)
 [2] Crear una nueva carpeta
Introduce tu elección numérica: 1
Tu carpeta actual se ha configurado como 'default' (id = b1g5r6h11knotfr8vjp7).
¿Quieres configurar una zona de Computación predeterminada? [Y/n]
¿Cuál zona deseas usar como predeterminada en el perfil?
 [1] ru-central1-a
 [2] ru-central1-b
 [3] ru-central1-c
 [4] No establecer zona predeterminada
Introduce tu elección numérica: 1
La zona de Computación predeterminada de tu perfil se ha configurado como 'ru-central1-a'.
vozerov@mba:~ $
En principio, el proceso no es complicado: primero necesitas obtener un token OAuth para gestionar la nube, elegir la nube y la carpeta que vas a utilizar.
Si tienes varias cuentas o carpetas dentro de una misma nube, puedes crear perfiles adicionales con configuraciones separadas a través de yc config profile create y alternar entre ellos.
Además de los métodos mencionados anteriormente, el equipo de Yandex.Cloud ha escrito un muy buen para gestionar recursos en la nube. Por mi parte, he preparado un repositorio en git, donde he descrito todos los recursos que se crearán en el marco del artículo — . Nos interesa la rama master, así que clonémosla localmente:
vozerov@mba:~ $ git clone https://github.com/rebrainme/yandex-cloud-events/ events
Clonando en 'events'...
remoto: Enumerando objetos: 100, hecho.
remoto: Contando objetos: 100% (100/100), hecho.
remoto: Comprimiendo objetos: 100% (68/68), hecho.
remoto: Total 100 (delta 37), reutilizado 89 (delta 26), pack-reutilizado 0
Recibiendo objetos: 100% (100/100), 25.65 KiB | 168.00 KiB/s, hecho.
Resolviendo deltas: 100% (37/37), hecho.
vozerov@mba:~ $ cd events/terraform/
Todas las variables principales utilizadas en terraform están definidas en el archivo main.tf. Para comenzar, creamos en la carpeta terraform el archivo private.auto.tfvars con el siguiente contenido:
# Yandex Cloud Oauth token
yc_token = ""
# Yandex Cloud ID
yc_cloud_id = ""
# Yandex Cloud folder ID
yc_folder_id = ""
# Default Yandex Cloud Region
yc_region = "ru-central1-a"
# Cloudflare email
cf_email = ""
# Cloudflare token
cf_token = ""
# Cloudflare zone id
cf_zone_id = ""
Todas las variables se pueden obtener de yc config list, ya que la utilidad de consola ya la hemos configurado. Recomiendo agregar inmediatamente private.auto.tfvars a .gitignore para no publicar accidentalmente datos privados.
En private.auto.tfvars también hemos indicado los datos de Cloudflare, para crear registros dns y proxiar el dominio principal events.kis.im en nuestros servidores. Si no desea utilizar cloudflare, elimine la inicialización del proveedor cloudflare en main.tf y el archivo dns.tf, que se encarga de crear los registros dns necesarios.
En nuestro trabajo combinaremos los tres métodos: la interfaz web, la utilidad de consola y terraform.
Redes Virtuales
Honestamente, este paso podría omitirse, ya que al crear una nueva nube se creará automáticamente una red separada y 3 subredes, una en cada zona de disponibilidad. Pero aún así, me gustaría crear una red separada para nuestro proyecto con su propia dirección. El esquema general del funcionamiento de la red en Yandex.Cloud se presenta en la imagen a continuación (tomada de )
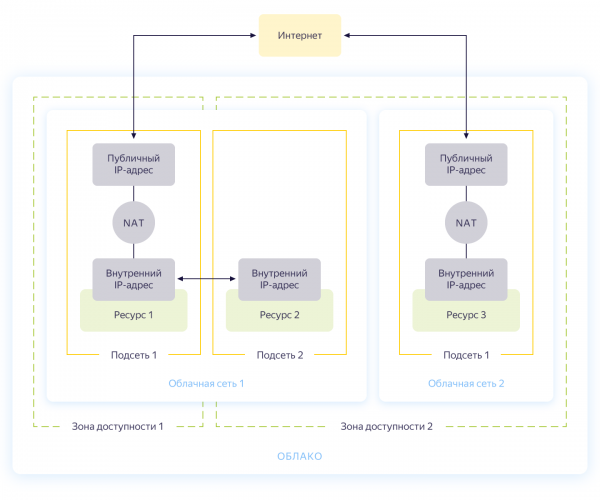
Entonces, creas una red común dentro de la cual los recursos podrán comunicarse entre sí. Para cada zona de disponibilidad se crea una subred con su propia dirección y se conecta a la red común. Como resultado, todos los recursos en la nube pueden comunicarse, incluso estando en diferentes zonas de disponibilidad. Los recursos conectados a diferentes redes en la nube sólo podrán verse a través de direcciones externas. Por cierto, cómo funciona esta magia por dentro .
La creación de la red se describe en el archivo network.tf del repositorio. Allí creamos una red privada común llamada internal y conectamos a ella tres subredes en diferentes zonas de disponibilidad: internal-a (172.16.1.0/24), internal-b (172.16.2.0/24), internal-c (172.16.3.0/24).
Inicializamos terraform y creamos redes:
vozerov@mba:~\/events\/terraform (master) $ terraform init
... omitido ...

vozerov@mba:~\/events\/terraform (master) $ terraform apply -target yandex_vpc_subnet.internal-a -target yandex_vpc_subnet.internal-b -target yandex_vpc_subnet.internal-c

... omitido ...

Plan: 4 para agregar, 0 para cambiar, 0 para destruir.

¿Quieres realizar estas acciones?
  Terraform llevará a cabo las acciones descritas arriba.
  Solo 'yes' será aceptado para aprobar.

  Introduce un valor: yes

yandex_vpc_network.internal: Creando...
yandex_vpc_network.internal: Creación completada después de 3s [id=enp2g2rhile7gbqlbrkr]
yandex_vpc_subnet.internal-a: Creando...
yandex_vpc_subnet.internal-b: Creando...
yandex_vpc_subnet.internal-c: Creando...
yandex_vpc_subnet.internal-a: Creación completada después de 6s [id=e9b1dad6mgoj2v4funog]
yandex_vpc_subnet.internal-b: Creación completada después de 7s [id=e2liv5i4amu52p64ac9p]
yandex_vpc_subnet.internal-c: Aún creando... [10s transcurridos]
yandex_vpc_subnet.internal-c: Creación completada después de 10s [id=b0c2qhsj2vranoc9vhcq]

¡Aplicación completa! Recursos: 4 añadidos, 0 cambiados, 0 destruidos.
¡Excelente! Hemos creado nuestra red y ahora estamos listos para crear nuestros servicios internos.
Creación de máquinas virtuales
Para probar la aplicación, nos bastará con crear dos máquinas virtuales: la primera la necesitaremos para compilar y ejecutar la aplicación, la segunda para ejecutar Kafka, que utilizaremos para almacenar los mensajes entrantes. Y crearemos otra máquina, donde configuraremos Prometheus para monitorear la aplicación.
Las máquinas virtuales se configurarán con Ansible, así que antes de ejecutar Terraform, asegúrate de tener una de las versiones más recientes de Ansible. Y instala los roles necesarios con Ansible Galaxy:
vozerov@mba:~\/events\/terraform (master) $ cd ..\/ansible\/\nvozerov@mba:~\/events\/ansible (master) $ ansible-galaxy install -r requirements.yml
- cloudalchemy-prometheus (master) ya está instalado, omitiendo.
- cloudalchemy-grafana (master) ya está instalado, omitiendo.
- sansible.kafka (master) ya está instalado, omitiendo.
- sansible.zookeeper (master) ya está instalado, omitiendo.
- geerlingguy.docker (master) ya está instalado, omitiendo.
vozerov@mba:~\/events\/ansible (master) $
Dentro de la carpeta ansible hay un ejemplo de archivo de configuración .ansible.cfg que utilizo. Puede que te sea útil.
Antes de crear las máquinas virtuales, asegúrate de que el agente SSH esté en ejecución y que la clave SSH esté añadida, de lo contrario, Terraform no podrá conectarse a las máquinas creadas. Me topé con un error en OS X: . Para que no te pase lo mismo, antes de ejecutar Terraform, añade una pequeña variable en env:
vozerov@mba:~\/events\/terraform (master) $ export OBJC_DISABLE_INITIALIZE_FORK_SAFETY=YESEn la carpeta con Terraform, creamos los recursos necesarios:
vozerov@mba:~\/events\/terraform (master) $ terraform apply -target yandex_compute_instance.build -target yandex_compute_instance.monitoring -target yandex_compute_instance.kafka
yandex_vpc_network.internal: Actualizando estado... [id=enp2g2rhile7gbqlbrkr]
data.yandex_compute_image.ubuntu_image: Actualizando estado...
yandex_vpc_subnet.internal-a: Actualizando estado... [id=e9b1dad6mgoj2v4funog]

Se ha generado un plan de ejecución y se muestra a continuación.
Las acciones de los recursos están indicadas con los siguientes símbolos:
  + crear

... omitido ...

Plan: 3 por agregar, 0 por cambiar, 0 por destruir.

... omitido ...
Si todo ha salido bien (y así debería ser), tendremos tres máquinas virtuales:
- build — máquina para pruebas y compilación de la aplicación. Docker se instaló automáticamente mediante Ansible.
- monitoring — máquina de monitoreo — en ella se instalaron Prometheus & grafana. Nombre de usuario/contraseña estándar: admin/admin
- kafka — pequeña máquina con Kafka instalada, accesible por el puerto 9092.
Verifiquemos que todas estén presentes:
vozerov@mba:~\/events (master) $ yc compute instance list
+----------------------+------------+---------------+---------+---------------+-------------+
|          ID          |    NOMBRE  |    ZONA ID    | ESTADO  |  IP EXTERNO   | IP INTERNO  |
+----------------------+------------+---------------+---------+---------------+-------------+
| fhm081u8bkbqf1pa5kgj | monitoring | ru-central1-a | EN FUNCIONAMIENTO | 84.201.159.71 | 172.16.1.35 |
| fhmf37k03oobgu9jmd7p | kafka      | ru-central1-a | EN FUNCIONAMIENTO | 84.201.173.41 | 172.16.1.31 |
| fhmt9pl1i8sf7ga6flgp | build      | ru-central1-a | EN FUNCIONAMIENTO | 84.201.132.3  | 172.16.1.26 |
+----------------------+------------+---------------+---------+---------------+-------------+
Los recursos están en su lugar, y desde aquí podemos extraer sus direcciones IP. A partir de ahora, utilizaré las direcciones IP para conectarme por SSH y probar la aplicación. Si tienes una cuenta en Cloudflare conectada a Terraform, siéntete libre de usar los nombres DNS recién creados.
Por cierto, al crear la máquina virtual se asigna una IP interna y un nombre DNS interno, por lo que se puede acceder a los servidores dentro de la red por sus nombres:
ubuntu@build:~$ ping kafka.ru-central1.internal
PING kafka.ru-central1.internal (172.16.1.31) 56(84) bytes of data.
64 bytes desde kafka.ru-central1.internal (172.16.1.31): icmp_seq=1 ttl=63 time=1.23 ms
64 bytes desde kafka.ru-central1.internal (172.16.1.31): icmp_seq=2 ttl=63 time=0.625 ms
^C
--- estadísticas de ping a kafka.ru-central1.internal ---
2 paquetes transmitidos, 2 recibidos, 0% de pérdida de paquetes, tiempo 1001ms
rtt min/avg/max/mdev = 0.625/0.931/1.238/0.308 ms
Esto nos será útil para indicar al aplicativo la dirección del endpoint de Kafka.
Compilando la aplicación
Excelente, tenemos los servidores, tenemos la aplicación — solo falta compilarla y publicarla. Para la compilación utilizaremos el comando docker build, y como almacenamiento de imágenes tomaremos el servicio de Yandex — container registry. Pero todo a su debido tiempo.
Copiamos la aplicación en la máquina build, accedemos por SSH y compilamos la imagen:
vozerov@mba:~\/events\/terraform (master) $ cd ..
vozerov@mba:~\/events (master) $ rsync -av app\/ ubuntu@84.201.132.3:app\/\n\n... skipped ...\n\nsent 3849 bytes  received 70 bytes  7838.00 bytes\/sec\ntotal size is 3644  speedup is 0.93\n\nvozerov@mba:~\/events (master) $ ssh 84.201.132.3 -l ubuntu
ubuntu@build:~$ cd app
ubuntu@build:~\/app$ sudo docker build -t app .\nSending build context to Docker daemon  6.144kB\nStep 1\/9 : FROM golang:latest AS build\n... skipped ...\n\nSuccessfully built 9760afd8ef65\nSuccessfully tagged app:latest
Se ha hecho medio trabajo; ahora podemos comprobar el funcionamiento de nuestra aplicación, ejecutándola y dirigiéndola a kafka:
ubuntu@build:~\/app$ sudo docker run --name app -d -p 8080:8080 app \/app\/app -kafka=kafka.ru-central1.internal:9092\n\nDesde la máquina local se puede enviar un evento de prueba y ver la respuesta:\n\nvozerov@mba:~\/events (master) $ curl -D - -s -X POST -d '{"key1":"data1"}' http:\/\/84.201.132.3:8080\/post\nHTTP\/1.1 200 OK\nContent-Type: application\/json\nDate: Mon, 13 Apr 2020 13:53:54 GMT\nContent-Length: 41\n\n{"status":"ok","partition":0,"Offset":0}\nvozerov@mba:~\/events (master) $La aplicación respondió con éxito al registro, indicando el ID de la partición y el offset en el que se colocó el mensaje. Ahora solo falta crear un registro en Yandex.Cloud y subir nuestra imagen (cómo hacerlo se describe en el archivo registry.tf). Creamos el almacenamiento:
vozerov@mba:~\/events\/terraform (master) $ terraform apply -target yandex_container_registry.events\n\n... skipped ...\n\nPlan: 1 to add, 0 to change, 0 to destroy.\n\n... skipped ...\n\nApply complete! Resources: 1 added, 0 changed, 0 destroyed.Para la autenticación en el container registry hay varias formas: utilizando un token oauth, un token iam o una clave de cuenta de servicio. Más detalles sobre estos métodos se pueden encontrar en la documentación . Usaremos la clave de la cuenta de servicio, así que creamos la cuenta:
vozerov@mba:~\/events\/terraform (master) $ terraform apply -target yandex_iam_service_account.docker -target yandex_resourcemanager_folder_iam_binding.puller -target yandex_resourcemanager_folder_iam_binding.pusher\n\n... skipped ...\n\nApply complete! Resources: 3 added, 0 changed, 0 destroyed.Ahora solo queda crear la clave:
vozerov@mba:~\/events\/terraform (master) $ yc iam key create --service-account-name docker -o key.json\nid: ajej8a06kdfbehbrh91p\nservice_account_id: ajep6d38k895srp9osij\ncreated_at: "2020-04-13T14:00:30Z"\nkey_algorithm: RSA_2048Obtenemos información sobre el ID de nuestro almacenamiento, transferimos la clave y nos autenticamos:
vozerov@mba:~\/events\/terraform (master) $ scp key.json ubuntu@84.201.132.3:\nkey.json 100% 2392 215.1KB\/s 00:00\n\nvozerov@mba:~\/events\/terraform (master) $ ssh 84.201.132.3 -l ubuntu\n\nubunt...@build:~$ cat key.json | sudo docker login --username json_key --password-stdin cr.yandex\nWARNING! Your password will be stored unencrypted in \/home\/ubuntu\/.docker\/config.json.\nConfigure a credential helper to remove this warning. See\nhttps:\/\/docs.docker.com\/engine\/reference\/commandline\/login\/#credentials-store\n\nLogin Succeeded\nubunt...@build:~$Para subir la imagen al registro necesitaremos el ID del container registry, lo obtenemos de la utilidad yc:
vozerov@mba:~ $ yc container registry get events
id: crpdgj6c9umdhgaqjfmm
folder_id:
name: events
status: ACTIVE
created_at: "2020-04-13T13:56:41.914Z"
Después de esto, etiquetamos nuestra imagen con un nuevo nombre y la subimos:
ubuntu@build:~$ sudo docker tag app cr.yandex/crpdgj6c9umdhgaqjfmm/events:v1
ubuntu@build:~$ sudo docker push cr.yandex/crpdgj6c9umdhgaqjfmm/events:v1
The push refers to repository [cr.yandex/crpdgj6c9umdhgaqjfmm/events]
8c286e154c6e: Pushed
477c318b05cb: Pushed
beee9f30bc1f: Pushed
v1: digest: sha256:1dd5aaa9dbdde2f60d833be0bed1c352724be3ea3158bcac3cdee41d47c5e380 size: 946
Podemos asegurarnos de que la imagen se haya subido con éxito:
vozerov@mba:~/events/terraform (master) $ yc container repository list
+----------------------+-----------------------------+
|          ID          |            NAME             |
+----------------------+-----------------------------+
| crpe8mqtrgmuq07accvn | crpdgj6c9umdhgaqjfmm/events |
+----------------------+-----------------------------+
Por cierto, si instalas la utilidad yc en una máquina con Linux, puedes usar el comando
yc container registry configure-dockerpara configurar Docker.
Conclusión
Hemos hecho un gran trabajo duro y como resultado:
- Hemos diseñado la arquitectura de nuestro futuro servicio.
- Hemos escrito una aplicación en golang que implementa nuestra lógica de negocio.
- La hemos compilado y vertido en un registro de contenedores privado.
En la siguiente parte pasaremos a lo interesante: vamos a desplegar nuestra aplicación en producción y finalmente la pondremos a prueba. ¡No cambies de canal!
Este material está disponible en la grabación del workshop abierto REBRAIN & Yandex.Cloud: Aceptamos 10,000 solicitudes por segundo en Yandex Cloud —
Si te interesa asistir a estos eventos en línea y hacer preguntas en tiempo real, únete a.
Un agradecimiento especial a Yandex.Cloud por la posibilidad de llevar a cabo este evento. Enlace a ellos —
Si necesitas migrar a la nube o tienes preguntas sobre tu infraestructura, .
P.S. Tenemos 2 auditorías gratuitas al mes, tal vez tu proyecto sea uno de ellos.
Fuente: habr.com
