

El artículo aborda la problemática de la limpieza de imágenes que se acumulan en los registros de contenedores (Docker Registry y sus análogos) en el contexto de las modernas tuberías CI/CD para aplicaciones cloud native entregadas en Kubernetes. Se presentan los principales criterios de relevancia de las imágenes y las complicaciones que surgen en su limpieza automatizada, preservación de espacio y satisfacción de las necesidades de los equipos. Finalmente, a través de un ejemplo concreto de un proyecto de código abierto, describiremos cómo se pueden superar estas dificultades.
Introducción
La cantidad de imágenes en el registro de contenedores puede crecer rápidamente, ocupando más espacio en el almacenamiento y, en consecuencia, aumentando significativamente su costo. Para controlar, limitar o mantener un crecimiento aceptable del espacio ocupado en el registry, se establece:
- utilizar un número fijo de etiquetas para las imágenes;
- limpiar las imágenes de alguna manera.
La primera limitación es a veces aceptable para equipos pequeños. Si a los desarrolladores les bastan etiquetas fijas (latest, main, test, boris ), el registro no se expandirá en tamaño y durante mucho tiempo se puede no pensar en la limpieza. Dado que todas las imágenes obsoletas se sobrescriben, no queda trabajo para limpiar (todo lo hace el recolector de basura estándar).
Sin embargo, este enfoque limita severamente el desarrollo y rara vez se aplica a CI/CD de proyectos modernos. La automatizaciónha pasado a ser parte integral del desarrollo, permitiendo probar, desplegar y entregar nuevas funcionalidades a los usuarios con mayor rapidez. Por ejemplo, en todos nuestros proyectos, se crea automáticamente una tubería CI con cada commit. En ella, se construye la imagen, se prueba, se despliega en varios entornos de Kubernetes para depuración y comprobaciones restantes, y si todo va bien, los cambios llegan al usuario final. Y esto ya no es ciencia espacial, sino una rutina para muchos — probablemente también para usted, dado que está leyendo este artículo.
Dado que la corrección de errores y el desarrollo de nuevas funcionalidades se llevan a cabo en paralelo, y los lanzamientos pueden realizarse varias veces al día, es evidente que el proceso de desarrollo genera una cantidad sustancial de commits, lo que significa que hay un gran número de imágenes en el registry.Como resultado, surge con urgencia la cuestión de organizar una limpieza efectiva del registry, es decir, eliminar imágenes obsoletas.
¿Pero cómo determinar si la imagen es realmente relevante?
Criterios de relevancia de la imagen
En la gran mayoría de los casos, los criterios principales serán los siguientes:
1. El primero (el más obvio y crítico de todos) son las imágenes que actualmente se utilizan en Kubernetes. Eliminar estas imágenes puede resultar en costos significativos debido a la inactividad de la producción (por ejemplo, es posible que se necesiten imágenes durante la replicación) o puede anular los esfuerzos del equipo que está depurando en cualquiera de los entornos. (Por esta razón, incluso hemos creado un , que monitorea la ausencia de tales imágenes en cualquier clúster de Kubernetes.)
2. El segundo (menos obvio, pero también muy importante y que nuevamente se relaciona con la operación) son las imágenes que se requieren para un revertir en caso de que se detecten problemas graves en la versión actual. Por ejemplo, en el caso de Helm, son las imágenes que se utilizan en las versiones guardadas del lanzamiento. (Por cierto, de forma predeterminada, Helm tiene un límite de 256 revisiones, pero es poco probable que alguien realmente necesite conservar de eso una gran cantidad de versiones?..) De hecho, guardamos versiones precisamente para que se puedan usar posteriormente, es decir, "revertir" a ellas en caso de necesidad.
3. El tercero son las necesidades de los desarrolladores: todas las imágenes que están relacionadas con su trabajo actual. Por ejemplo, si estamos considerando un PR, tiene sentido mantener la imagen correspondiente al último commit y, digamos, al commit anterior: así el desarrollador podrá regresar rápidamente a cualquier tarea y trabajar con los cambios más recientes.
4. El cuarto son las imágenes que corresponden a las versiones de nuestra aplicación, es decir, son el producto final: v1.0.0, 20.04.01, sierra, etc.
NB: Los criterios aquí definidos se han formulado en base a la experiencia de interacción con decenas de equipos de desarrollo de diferentes empresas. Sin embargo, por supuesto, dependiendo de las características en los procesos de desarrollo y de la infraestructura utilizada (por ejemplo, si no se utiliza Kubernetes), estos criterios pueden variar.
Cumplimiento de los criterios y soluciones existentes
Los servicios populares de container registry suelen ofrecer sus propias políticas de limpieza de imágenes: en ellas puedes definir las condiciones bajo las cuales una etiqueta se elimina del registry. Sin embargo, las posibilidades de estas condiciones se limitan a parámetros como nombres, tiempo de creación y cantidad de etiquetas*.
* Depende de las implementaciones específicas de container registry. Hemos considerado las capacidades de las siguientes soluciones: Azure CR, Docker Hub, ECR, GCR, GitHub Packages, GitLab Container Registry, Harbor Registry, JFrog Artifactory, Quay.io — a fecha de septiembre de 2020.
Este conjunto de parámetros es más que suficiente para satisfacer el cuarto criterio — es decir, seleccionar imágenes que correspondan a las versiones. Sin embargo, para todos los demás criterios, hay que optar por alguna solución de compromiso (una política más estricta o, por el contrario, más indulgente) — dependiendo de las expectativas y las capacidades financieras.
Por ejemplo, el tercer criterio — relacionado con las necesidades de los desarrolladores — puede resolverse organizando procesos dentro de los equipos: nombramiento específico de imágenes, mantenimiento de listas de permitidos y acuerdos internos. Pero, al final, aún es necesario automatizarlo. Y si las capacidades de las soluciones listas no son suficientes, hay que hacer algo propio.
La situación es similar con los dos primeros criterios: no se pueden satisfacer sin obtener datos de un sistema externo — el mismo donde se realiza la implementación de aplicaciones (en nuestro caso, es Kubernetes).
Ilustración del flujo de trabajo en Git
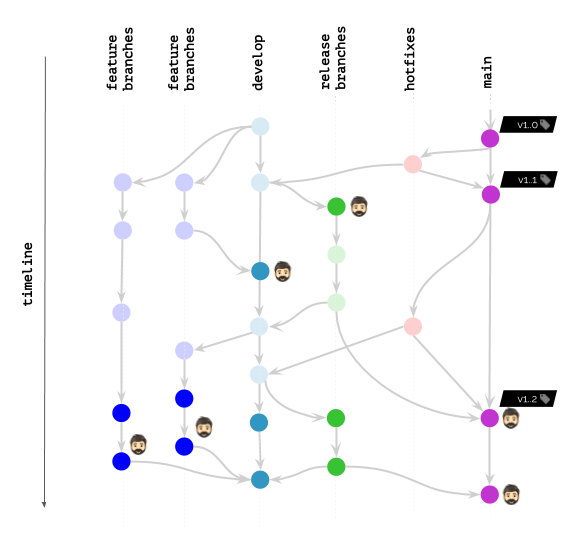
Supongamos que trabajas más o menos con este esquema en Git:
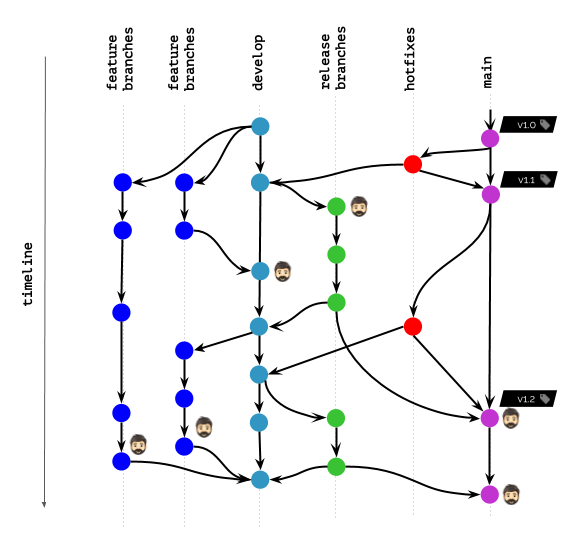
La imagen con un icono de cabeza en el esquema marca las imágenes de contenedor que actualmente están desplegadas en Kubernetes para ciertos usuarios (usuarios finales, testers, gerentes, etc.) o son utilizadas por los desarrolladores para depuración y objetivos similares.
¿Qué sucederá si las políticas de limpieza permiten dejar (no eliminar) imágenes solo por nombres de etiquetas específicos??
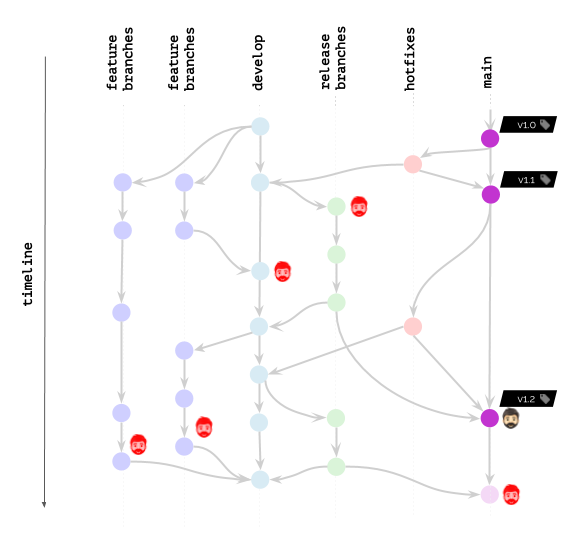
Obviamente, tal escenario no le agradará a nadie.
¿Qué cambiará si las políticas permiten no eliminar imágenes por un intervalo de tiempo específico / número de últimos commits??
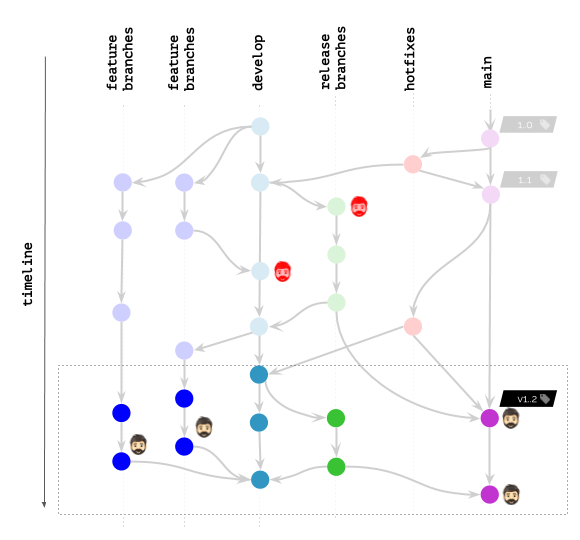
El resultado es significativamente mejor, aunque todavía está lejos de ser ideal. Después de todo, todavía tenemos desarrolladores que necesitan imágenes en el registry (o incluso desplegadas en K8s) para depurar errores...
Resumiendo la situación actual del mercado: las funciones disponibles en los registros de contenedores no ofrecen la flexibilidad suficiente para la limpieza, y la principal razón es que no hay posibilidad de interactuar con el mundo exterior.Esto significa que los equipos que requieren dicha flexibilidad deben implementar por su cuenta la eliminación de imágenes "externamente", utilizando la API de Docker Registry (o la API nativa de la implementación correspondiente).
Sin embargo, estábamos buscando una solución universal que automatizara la limpieza de imágenes para diferentes equipos que utilizan diferentes registros...
Nuestro camino hacia la limpieza universal de imágenes.
¿De dónde proviene esta necesidad? La cuestión es que no somos un grupo aislado de desarrolladores, sino un equipo que atiende a muchos de ellos, ayudando a resolver integralmente los problemas de CI/CD. Y la principal herramienta técnica para esto es una utilidad de código abierto . Su característica es que no realiza una única función, sino que acompaña los procesos de entrega continua en todas las etapas: desde la construcción hasta el despliegue.
La publicación en el registro* de imágenes (inmediatamente después de su construcción) es una función evidente de dicha utilidad. Y dado que las imágenes se almacenan allí, si su almacenamiento no es ilimitado, también se debe responder por su posterior limpieza. A continuación, se explicará cómo logramos esto, cumpliendo con todos los criterios establecidos.
* Aunque los registros en sí pueden ser diversos (Docker Registry, GitLab Container Registry, Harbor, etc.), sus usuarios se enfrentan a los mismos problemas. La solución universal en nuestro caso no depende de la implementación del registro, ya que se lleva a cabo fuera de los propios registros y ofrece un comportamiento uniforme para todos.
A pesar de que utilizamos werf como ejemplo de implementación, esperamos que los enfoques utilizados sean útiles para otros equipos que enfrenten dificultades similares.
Así que nos dedicamos a la implementación externa de un mecanismo para limpiar imágenes — en lugar de las capacidades que ya están integradas en los registros para contenedores. El primer paso fue utilizar la API de Docker Registry para crear las mismas políticas primitivas sobre la cantidad de etiquetas y el tiempo de su creación (mencionadas anteriormente). A ellas se añadió una lista permitida basada en las imágenes utilizadas en la infraestructura desplegada., es decir, Kubernetes. Para esto último, bastaba con recorrer todos los recursos desplegados a través de la API de Kubernetes y obtener una lista de valores. image.
Esta solución trivial resolvió el problema más crítico (criterio n.º 1), pero solo fue el comienzo de nuestro camino hacia la mejora del mecanismo de limpieza. El siguiente, y mucho más interesante, paso fue encontrar la forma de vincular las imágenes publicadas con el historial de Git..
Esquemas de etiquetado
Para comenzar, elegimos un enfoque en el que la imagen final debe almacenar la información necesaria para la limpieza, y construimos el proceso sobre esquemas de etiquetado. Al publicar la imagen, el usuario seleccionaba una opción de etiquetado específica (git-branch, git-commit o git-tag) y utilizaba el valor correspondiente. En los sistemas CI, la configuración de estos valores se realizaba automáticamente según las variables de entorno. En esencia, la imagen final se vinculaba a un determinado primitivo de Git,almacenando los datos necesarios para la limpieza en las etiquetas.
Con este enfoque, se logró un conjunto de políticas que permitieron usar Git como la única fuente de verdad:
- Al eliminar una rama/etiqueta en Git, se eliminaban automáticamente las imágenes relacionadas en el registro.
- La cantidad de imágenes vinculadas a las etiquetas y commits de Git se podía regular mediante la cantidad de etiquetas utilizadas en el esquema elegido y el tiempo de creación del commit relacionado.
En general, la implementación resultante satisfacía nuestras necesidades, pero pronto nos esperaría un nuevo desafío. Resulta que, durante el uso de esquemas de etiquetado basados en primitivos de Git, nos encontramos con varias desventajas. (Dado que su descripción está fuera del alcance de este artículo, todos los interesados pueden consultar los detalles. .) Por lo tanto, al decidir pasar a un enfoque de etiquetado más eficiente (etiquetado basado en contenido), tuvimos que reconsiderar también la implementación de la limpieza de imágenes.
Nuevo algoritmo
¿Por qué? En el etiquetado dentro del etiquetado basado en contenido, cada etiqueta puede satisfacer a múltiples commits en Git. En la limpieza de imágenes ya no se puede basar solo en el commit en el que se añadió una nueva etiqueta al registro.
Para el nuevo algoritmo de limpieza, se decidió prescindir de los esquemas de etiquetado y construir el proceso sobre meta-imágenes,cada una de las cuales almacena un par de:
- el commit en el que se realizó la publicación (no importa si se agregó, cambió o permaneció igual en el registro de contenedores);
- y nuestro identificador interno correspondiente a la imagen compilada.
En otras palabras, se garantizó la conexión entre las etiquetas publicadas y los commits en Git.
La configuración final y el algoritmo general
A los usuarios se les hicieron disponibles políticas para la configuración de limpieza, que determinan la selección de imágenes actuales. Cada una de estas políticas se define por:
- un conjunto de references, es decir, etiquetas de Git o ramas de Git que se utilizan durante el escaneo;
- y un límite de imágenes buscadas para cada reference del conjunto.
Para ilustrar: así es como se configuró la política predeterminada:
cleanup:
  keepPolicies:
  - references:
      tag: \/.*\/\
      limit:
        last: 10
  - references:
      branch: \/.*\/\
      limit:
        last: 10
        in: 168h
        operator: And
    imagesPerReference:
      last: 2
      in: 168h
      operator: And
  - references:
      branch: \/^(main|staging|production)$\/\
    imagesPerReference:
      last: 10
Esta configuración contiene tres políticas, que corresponden a las siguientes reglas:
- Conservar la imagen para las 10 últimas etiquetas de Git (según la fecha de creación de la etiqueta).
- Conservar no más de 2 imágenes publicadas en la última semana para no más de 10 ramas con actividad durante la última semana.
- Conservar 10 imágenes para las ramas
main,stagingyproducción.
El algoritmo final se reduce a los siguientes pasos:
- Obtener los manifiestos del registro de contenedores.
- Excluir las imágenes utilizadas en Kubernetes, ya que estas ya las hemos seleccionado previamente, consultando la API de K8s.
- Escanear el historial de Git y excluir imágenes según las políticas establecidas.
- Eliminar las imágenes restantes.
Regresando a nuestra ilustración, esto es lo que sucede con werf:
Sin embargo, incluso si no usas werf, un enfoque similar para la limpieza avanzada de imágenes — en alguna implementación (de acuerdo con el enfoque preferido para etiquetar imágenes) — puede aplicarse también en otros sistemas/utilidades. Solo es necesario tener en cuenta los problemas que surgen y encontrar las oportunidades en tu stack que permiten integrar su solución de la manera más fluida. Esperamos que el camino que hemos recorrido ayude a ver tu caso particular con nuevos detalles y reflexiones.
Conclusión
- Tarde o temprano, la mayoría de los equipos se enfrentan al problema de la saturación del registro.
- Al buscar soluciones, es esencial establecer primero los criterios de relevancia de la imagen.
- Las herramientas ofrecidas por los servicios populares de registro de contenedores permiten organizar una limpieza muy sencilla que no tiene en cuenta el "mundo exterior": las imágenes utilizadas en Kubernetes y las peculiaridades de los flujos de trabajo del equipo.
- Un algoritmo flexible y eficaz debe tener en cuenta los procesos de CI/CD y no solo operar con los datos de las imágenes de Docker.
P.D.
También puedes leer en nuestro blog:
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
