

Nota del traductor: esta es la traducción de un informe post-mortem público del blog de ingeniería de la empresa . En él se describe un problema con conntrack en el clúster de Kubernetes, que provocó un tiempo de inactividad parcial de algunos servicios de producción.
Este artículo puede ser útil para aquellos que desean aprender un poco más sobre los informes post-mortem o prevenir posibles problemas de DNS en el futuro.
No es DNS
No puede ser que sea DNS
Eso fue DNS
Un poco sobre los informes post-mortem y los procesos en Preply
El informe post-mortem describe una falla en el funcionamiento o algún evento en producción. Un post-mortem incluye una cronología de eventos, descripción del impacto en el usuario, la causa raíz, las acciones y las lecciones aprendidas.
En las reuniones semanales con pizza, en el círculo del equipo técnico, compartimos diversa información. Una de las partes más importantes de estas reuniones son los post-mortem, que a menudo van acompañados de una presentación con diapositivas y un análisis más profundo del incidente ocurrido. Aunque no 'aplaudimos' tras los post-mortem, nos esforzamos por fomentar una cultura de 'sin culpa' (). Creemos que redactar y presentar informes post-mortem puede ayudarnos (y no solo a nosotros) a prevenir incidentes similares en el futuro, por eso los compartimos.
Las personas involucradas en el incidente deben sentir que pueden contar en detalle sobre él, sin temor a castigos o represalias. ¡Nada de reprensiones! Redactar un post-mortem no es un castigo, sino una oportunidad de aprendizaje para toda la empresa.
Problemas de DNS en Kubernetes. Informe post-mortem
Fecha: 28.02.2020
Autores: Amet U., Andrey S., Igor K., Alexei P.
Estado: Concluido
Resumen: Interrupción parcial del DNS (26 min) para algunos servicios en el clúster de Kubernetes
Impacto: 15000 eventos perdidos para los servicios A, B y C
Causa raíz: Kube-proxy no pudo eliminar correctamente la antigua entrada de la tabla de conntrack, por lo que algunos servicios seguían intentando conectarse a pods inexistentes
E0228 20:13:53.795782 1 proxier.go:610] Falló al eliminar kube-system/kube-dns:dns endpoint connections, error: error al eliminar entradas de conntrack para el par UDP {100.64.0.10, 100.110.33.231}, error: el comando de conntrack devolvió: ...Detonante: Debido a la baja carga dentro del clúster de Kubernetes, el CoreDNS-autoscaler redujo el número de pods en el despliegue de tres a dos
Solución: El último despliegue de la aplicación inició la creación de nuevos nodos, el CoreDNS-autoscaler agregó más pods para servir al clúster, lo que provocó la reescritura de la tabla de conntrack.
Detección: La monitorización de Prometheus detectó una gran cantidad de errores 5xx para los servicios A, B y C e inició una llamada a los ingenieros de guardia.
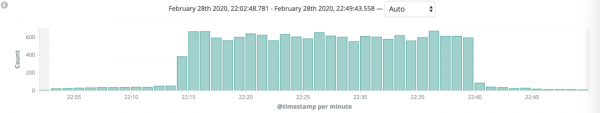
Errores 5xx en Kibana.
Acciones
Acción
Tipo
Responsable.
Tarea
Desactivar el autoescalador para CoreDNS.
prevención.
Amet U.
DEVOPS-695.
Instalar un servidor DNS con caché.
reducir.
Max V.
DEVOPS-665.
Configurar la monitorización de conntrack.
prevención.
Amet U.
DEVOPS-674.
Lecciones aprendidas.
Lo que salió bien:
- La monitorización funcionó correctamente. La reacción fue rápida y organizada.
- No nos encontramos con ningún límite en los nodos.
Lo que salió mal:
- Todavía se desconoce la verdadera causa raíz, parece un en conntrack.
- Todas las acciones solo abordan las consecuencias, no la causa raíz (error).
- Sabíamos que tarde o temprano podríamos tener problemas con DNS, pero no priorizamos las tareas.
Donde tuvimos suerte:
- El último despliegue activó el CoreDNS-autoscaler, que reescribió la tabla de conntrack.
- Este error afectó solo a una parte de los servicios.
Cronología (EET).
Tiempo
Acción
22:13
CoreDNS-autoscaler redujo el número de pods de tres a dos.
22:18
Los ingenieros de guardia comenzaron a recibir llamadas del sistema de monitorización.
22:21
Los ingenieros de guardia comenzaron a investigar la causa de los errores.
22:39
Los ingenieros de guardia comenzaron a revertir uno de los últimos servicios a una versión anterior.
22:40
Los errores 5xx dejaron de aparecer, la situación se estabilizó.
- Tiempo hasta el descubrimiento: 4 min.
- Tiempo hasta la toma de medidas: 21 min.
- Tiempo hasta la reparación: 1 min.
Información adicional
- Registros de CoreDNS:
I0228 20:13:53.507780 1 event.go:221] Evento(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): tipo: 'Normal' razón: 'ScalingReplicaSet' Reducción de la escala del conjunto de réplicas coredns-6cbb6646c9 a 2. - Enlaces a Kibana (recortado), Grafana (recortado).
Para minimizar el uso de CPU, el núcleo de Linux utiliza una cosa llamada conntrack. En resumen, es una utilidad que contiene una lista de entradas NAT que se almacenan en una tabla especial. Cuando el siguiente paquete llega desde el mismo pod al mismo pod que antes, la dirección IP de destino no se calculará nuevamente, sino que se tomará de la tabla de conntrack.
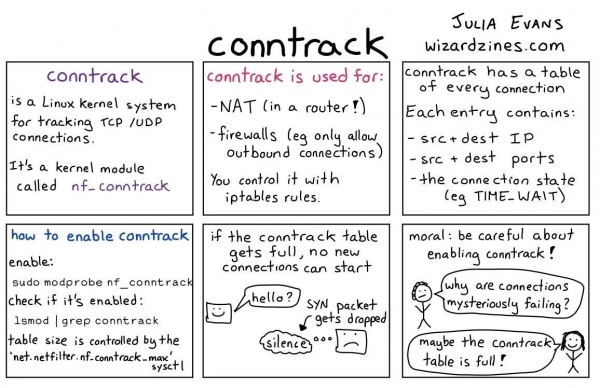
Cómo funciona conntrack.
Resultados
Este fue un ejemplo de uno de nuestros postmortems con algunos enlaces útiles. En este artículo, compartimos información que puede ser útil para otras empresas. Por eso no tenemos miedo de cometer errores y por eso hacemos público uno de nuestros postmortems. Aquí hay algunos otros postmortems públicos interesantes:
- GitLab:
- Dropbox:
- Spotify:
- Muchos otros de y repositorio
- También postmortem público con el libro SRE
Fuente: habr.com
