

Esta historia trata sobre cómo utilizamos contenedores en un entorno de producción, especialmente bajo Kubernetes. El artículo se dedica a la recolección de métricas y registros de los contenedores, así como a la construcción de imágenes.
Somos de la empresa fintech Exness, que se dedica al desarrollo de servicios para el trading en línea y productos fintech para B2B y B2C. En nuestro departamento de I+D hay muchos equipos diferentes, y en el departamento de desarrollo hay más de 100 empleados.
Representamos al equipo responsable de la plataforma para el recopilado y ejecución de código de nuestros desarrolladores. En particular, somos responsables de la recopilación, almacenamiento y provisión de métricas, registros y eventos de las aplicaciones. Actualmente, operamos aproximadamente tres mil contenedores Docker en un entorno de producción, mantenemos nuestro almacén de big data de 50 TB y ofrecemos soluciones arquitectónicas que se construyen alrededor de nuestra infraestructura: Kubernetes, Rancher y varios proveedores de nube pública.
Nuestra motivación
¿Qué está en llamas? Nadie puede responder. ¿Dónde está el foco? Difícil de comprender. ¿Cuándo comenzó el incendio? Se puede averiguar, pero no de inmediato.
¿Por qué algunos contenedores se detienen y otros caen? ¿Qué contenedor es el responsable? Porque por fuera los contenedores son iguales, pero por dentro cada uno tiene su propio Neo.
Nuestros desarrolladores son chicos competentes. Hacen buenos servicios que generan beneficios para la empresa. Pero a veces hay fallos, cuando los contenedores de aplicaciones se dispersan. Un contenedor consume demasiada CPU, otro la red, otro operaciones de entrada/salida, y un cuarto no está claro qué hace con los sockets. Todo esto se desmorona y el barco se hunde.
Agentes
Para entender qué sucede por dentro, decidimos colocar agentes directamente en los contenedores.
Estos agentes son programas de control que mantienen los contenedores en un estado tal que no se rompan entre sí. Los agentes están estandarizados, lo que permite estandarizar el enfoque para el mantenimiento de los contenedores.
En nuestro caso, los agentes deben proporcionar registros en un formato estándar, etiquetados y con limitación de frecuencia. También deben proporcionarnos métricas estandarizadas, ampliables desde el punto de vista de las aplicaciones de negocio.
Los agentes también se refieren a utilidades para la explotación y mantenimiento, capaces de trabajar en diferentes sistemas de orquestación, y que soporten diferentes imágenes (Debian, Alpine, Centos, etc.).
Finalmente, los agentes deben mantener un CI/CD simple que incluya archivos Docker. De lo contrario, el barco se desmoronará porque los contenedores comenzarán a entregarse por rieles "torcidos".
El proceso de construcción y la creación de la imagen objetivo
Para que todo esté estandarizado y gestionable, es necesario seguir algún proceso estándar de construcción. Por lo tanto, decidimos construir contenedores utilizando otros contenedores — una especie de recursividad.
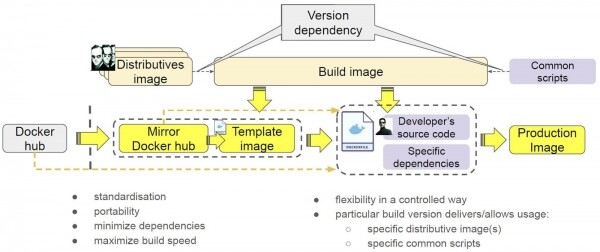
Aquí los contenedores se presentan como contornos sólidos. Además, decidimos incluir distribuciones en ellos para que "la vida no parezca tan sencilla". A continuación explicaremos por qué se hizo esto.
Como resultado, se creó una herramienta de construcción: un contenedor de una versión específica que se refiere a versiones específicas de distribuciones y versiones específicas de scripts.
¿Cómo lo aplicamos? Tenemos Docker Hub, donde reside el contenedor. Lo duplicamos dentro de nuestro sistema para eliminar dependencias externas. Resultó un contenedor marcado en color amarillo. Creamos una plantilla para instalar todas las distribuciones y scripts necesarios en el contenedor. Después de eso, construimos una imagen lista para la producción: los desarrolladores colocan su código y algunas dependencias especiales.
¿Cuál es la ventaja de este enfoque?
- En primer lugar, control de versión completo de las herramientas de construcción: contenedor de construcción, versiones de scripts y distribuciones.
- En segundo lugar, hemos logrado estandarización: creamos plantillas, imágenes intermedias y listas para la producción de manera uniforme.
- En tercer lugar, los contenedores nos proporcionan portabilidad. Hoy usamos Gitlab, y mañana podemos pasar a TeamCity o Jenkins y, de igual manera, podemos ejecutar nuestros contenedores.
- En cuarto lugar, minimización de dependencias. No es por azar que colocamos distribuciones en el contenedor, ya que esto evita descargarlas cada vez de Internet.
- En quinto lugar, se ha aumentado la velocidad de construcción: la existencia de copias locales de imágenes permite no perder tiempo en descargas, ya que hay una imagen local disponible.
En otras palabras, hemos logrado un proceso de construcción controlado y flexible. Utilizamos las mismas herramientas para construir cualquier contenedor con un versionado completo.
¿Cómo funciona nuestro procedimiento de construcción?
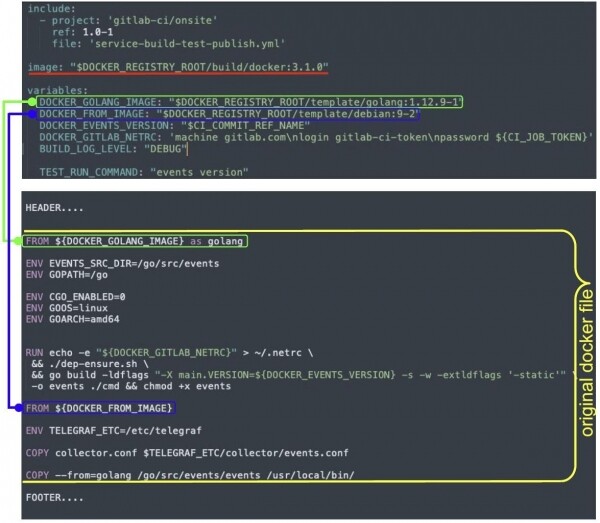
La compilación se inicia con un solo comando, el proceso se ejecuta en la imagen (resaltada en rojo). El desarrollador tiene un archivo Docker (resaltado en amarillo), lo rendersamos, reemplazando las variables con valores. Y al mismo tiempo, añadimos encabezados y pies de página: estos son nuestros agentes.
El encabezado agrega distribuciones de las imágenes correspondientes. Y el pie de página inserta nuestros servicios, configura el inicio de la carga de trabajo, la registración y otros agentes, reemplaza el entrypoint, etc.
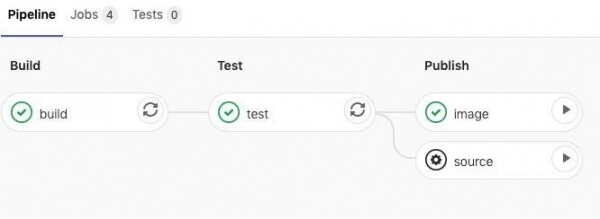
Estuvimos pensando mucho si debíamos implementar un supervisor. Al final, decidimos que lo necesitábamos. Elegimos S6. El supervisor proporciona gestión del contenedor: permite conectarse a él en caso de que el proceso principal falle y proporciona control manual del contenedor sin necesidad de recrearlo. Los registros y métricas son procesos que se ejecutan dentro del contenedor. También necesitamos controlarlos, y lo hacemos usando el supervisor. Finalmente, S6 se encarga de realizar tareas de mantenimiento, gestionar señales y otras tareas.
Dado que aplicamos diferentes sistemas de orquestación, después de la compilación y el inicio, el contenedor debe entender en qué entorno se encuentra y actuar en consecuencia. Por ejemplo:
Esto nos permite crear una sola imagen y ejecutarla en diferentes sistemas de orquestación, adaptándose a las especificaciones de dicho sistema de orquestación.
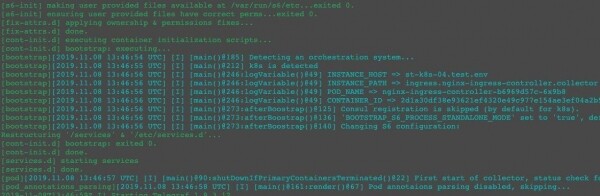
Para un mismo contenedor obtenemos diferentes árboles de procesos en Docker y Kubernetes:
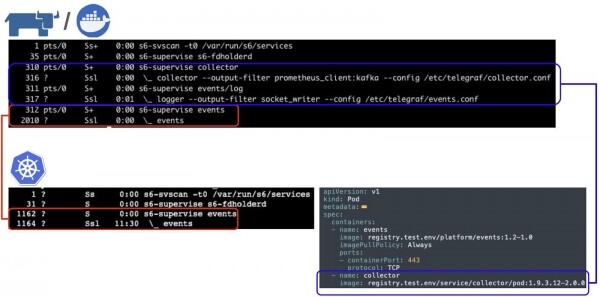
La carga útil se ejecuta bajo el supervisor S6. Tenga en cuenta el collector y events: estos son nuestros agentes responsables de los registros y métricas. No están en Kubernetes, pero sí en Docker. ¿Por qué?
Si miramos la especificación del 'pod' (de aquí en adelante – Kubernetes pod), veremos que el contenedor events se ejecuta en el pod, donde hay un contenedor collector separado que realiza la función de recopilar métricas y registros. Podemos aprovechar las capacidades de Kubernetes: iniciar contenedores en un mismo pod, en un espacio de proceso y/o red único. De hecho, implementar nuestros propios agentes y realizar ciertas funciones. Y si este mismo contenedor se inicia en Docker, obtendrá las mismas capacidades, lo que significa que podrá enviar registros y métricas, ya que los agentes se ejecutarán internamente.
Métricas y registros
La entrega de métricas y registros es una tarea complicada. La solución implica varios aspectos.
La infraestructura se crea para la ejecución de cargas útiles, no para la entrega masiva de logs. Es decir, este proceso debe llevarse a cabo con requisitos mínimos de recursos para los contenedores. Nos esforzamos por ayudar a nuestros desarrolladores: «Tomen un contenedor de Docker Hub, inicien, y podremos entregar los logs».
El segundo aspecto es la limitación del volumen de logs. Si en varios contenedores ocurre una situación de picos en el volumen de logs (una aplicación en un bucle emite stack-trace), aumenta la carga en la CPU, los canales de comunicación, el sistema de procesamiento de logs, y esto afecta el funcionamiento del host en general y de otros contenedores en el host, lo que a veces puede llevar a la «caída» del host.
El tercer aspecto es la necesidad de soportar, de manera estándar, tantas metodologías de recolección de métricas como sea posible. Desde la lectura de archivos y la consulta del endpoint de Prometheus hasta el uso de protocolos específicos de aplicaciones.
Y el último aspecto es la necesidad de minimizar el consumo de recursos.
Hemos elegido una solución de código abierto en Go llamada Telegraf. Este es un conector versátil que admite más de 140 tipos de entradas (input plugins) y 30 tipos de salidas (output plugins). Lo hemos modificado y ahora contaremos cómo se utiliza con nosotros en el ejemplo de Kubernetes.
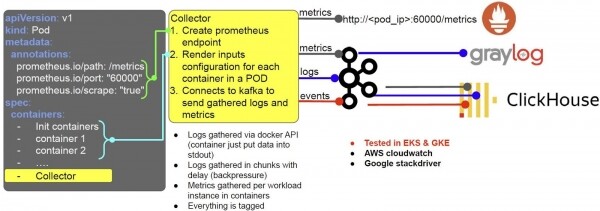
Supongamos que un desarrollador despliega una carga de trabajo, y Kubernetes recibe una solicitud para crear un pod. En ese momento, para cada pod se crea automáticamente un contenedor llamado Collector (usamos un webhook de mutación). Collector es nuestro agente. Al iniciar, este contenedor se configura para trabajar con Prometheus y el sistema de recolección de logs.
- Para ello utiliza anotaciones del pod, y dependiendo de su contenido, crea, digamos, un endpoint final de Prometheus;
- Con base en la especificación del pod y configuraciones específicas de los contenedores, decide cómo entregar los logs.
Recolectamos logs a través de la API de Docker: a los desarrolladores solo les basta con colocarlos en stdout o stderr, y luego Collector se encarga de ello. Los logs se recopilan por fragmentos con un cierto retraso para prevenir una posible sobrecarga del host.
Las métricas se recolectan por instancias de carga de trabajo (procesos) en contenedores. Todo se etiqueta: namespace, pod y así sucesivamente, y luego se convierte al formato de Prometheus – y se vuelve accesible para la recolección (además de los logs). También, enviamos logs, métricas y eventos a Kafka y posteriormente:
- Los logs están disponibles en Graylog (para análisis visual);
- Los logs, métricas y eventos se envían a Clickhouse para almacenamiento a largo plazo.
Así es como funciona en AWS, solo que sustituimos Graylog con Kafka por Cloudwatch. Enviamos los logs allí, y todo resulta muy conveniente: queda claro a qué clúster y contenedor pertenecen. Lo mismo es cierto para Google Stackdriver. Es decir, nuestro esquema funciona tanto en on-premise con Kafka como en la nube.
Sin embargo, si no tenemos Kubernetes con pods, el esquema se vuelve un poco más complicado, pero funciona bajo los mismos principios.
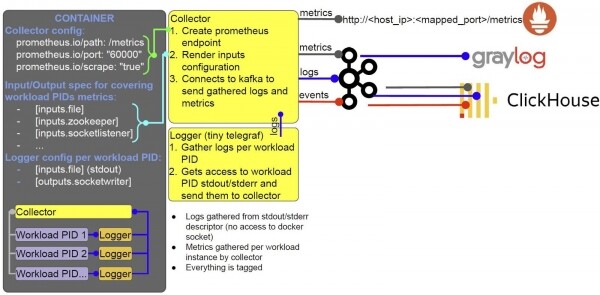
Dentro del contenedor se ejecutan los mismos procesos, orquestados con S6. Todos esos mismos procesos se ejecutan dentro de un solo contenedor.
En resumen
Hemos creado una solución integral para la construcción y despliegue de imágenes, con opciones para recopilar y entregar logs y métricas:
- Desarrollamos un enfoque estandarizado para la construcción de imágenes, sobre el cual diseñamos plantillas de CI;
- Los agentes para la recopilación de datos son nuestras extensiones Telegraf. Los hemos probado bien en producción;
- Utilizamos un webhook de mutación para implementar contenedores con agentes en pods;
- Nos hemos integrado en el ecosistema de Kubernetes/Rancher;
- Podemos ejecutar contenedores idénticos en diferentes sistemas de orquestación y obtener los resultados esperados;
- Creamos una configuración completamente dinámica para la gestión de contenedores.
Coautor: Ilya Prudnikov
Fuente: habr.com
