

El futuro ha llegado, las tecnologías de inteligencia artificial y aprendizaje automático ya son utilizadas con éxito por tus tiendas favoritas, empresas de transporte e incluso granjas que crían pavos.
Y si algo existe, significa que ya hay algo en Internet sobre ello... ¡un proyecto abierto! Mira cómo Open Data Hub ayuda a escalar nuevas tecnologías y a evitar dificultades en su implementación.
A pesar de todos los beneficios de la inteligencia artificial (artificial Intelligence, AI) y el aprendizaje automático (machine learning, ML), las organizaciones a menudo enfrentan dificultades para escalar estas tecnologías. Los problemas principales suelen ser los siguientes:
- Intercambio de información y colaboración – intercambiar información sin esfuerzo adicional y colaborar en ciclos rápidos de iteración es prácticamente imposible.
- Acceso a datos – para cada tarea, es necesario construirlo de nuevo y manualmente, lo que lleva mucho tiempo.
- Acceso on-demand – no hay posibilidad de obtener acceso on-demand a las herramientas y plataformas de aprendizaje automático, así como a la infraestructura computacional.
- Producción – los modelos permanecen en la etapa de prototipo y no se llevan a producción.
- Seguimiento y explicación de los resultados del AI – la reproductibilidad, seguimiento y explicación de los resultados de AI/ML son problemáticos.
Si no se abordan, estos problemas afectan negativamente la velocidad, eficiencia y productividad de los valiosos especialistas en procesamiento y análisis de datos. Esto conduce a su frustración, decepción en el trabajo, y en última instancia, las expectativas del negocio con respecto a AI/ML se desvanecen.
La responsabilidad de solucionar estos problemas recae en los especialistas de TI, que deben proporcionar a los analistas de datos – correctamente, algo así como una nube. En términos más amplios, se necesita una plataforma que brinde libertad de elección y tenga un acceso conveniente y sencillo. A la vez, debe ser rápida, fácilmente reconfigurable, escalable según demanda y resistente a fallos. Construir tal plataforma sobre tecnologías de código abierto ayuda a evitar la dependencia del proveedor y a mantener una ventaja estratégica a largo plazo en términos de control de costos.
Hace varios años, algo similar ocurrió en el desarrollo de aplicaciones y condujo a la aparición de microservicios, entornos híbridos de nube, automatización de TI y procesos ágiles. Para hacer frente a todo esto, los especialistas en TI comenzaron a utilizar contenedores, Kubernetes y nubes híbridas abiertas.
Ahora, esta experiencia se aplica para responder a los desafíos de la IA. Por lo tanto, los especialistas en TI están creando plataformas basadas en contenedores que permiten desarrollar servicios de AI/ML dentro de procesos ágiles, aceleran la innovación y se construyen con visión hacia la nube híbrida.
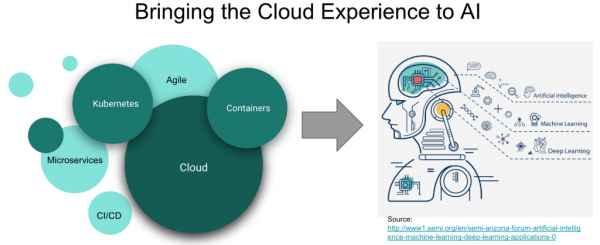
Comenzaremos a construir tal plataforma con Red Hat OpenShift, nuestra plataforma de contenedores Kubernetes para nubes híbridas, que tiene un ecosistema de soluciones ML de software y hardware de rápido crecimiento (NVIDIA, H2O.ai, Starburst, PerceptiLabs, etc.). Algunos de los clientes de Red Hat, como BMW Group, ExxonMobil y otros, ya han implementado cadenas de herramientas ML en contenedores y procesos DevOps basados en esta plataforma y su ecosistema para llevar sus arquitecturas ML a un modo de producción industrial y acelerar el trabajo de los analistas de datos.
Otra razón por la que lanzamos el proyecto Open Data Hub es demostrar un ejemplo de arquitectura basada en múltiples proyectos de código abierto y mostrar cómo realizar todo el ciclo de vida de una solución ML en la plataforma OpenShift.
Proyecto Open Data Hub
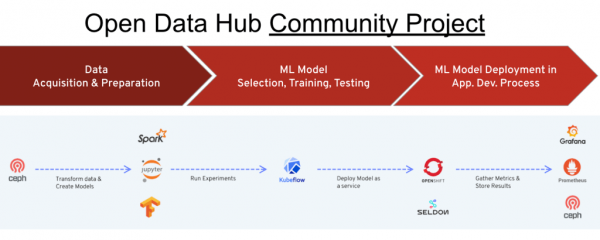
Es un proyecto de código abierto que se desarrolla dentro de la comunidad de desarrollo correspondiente y realiza el ciclo completo de operaciones, desde la carga y transformación de datos iniciales hasta la formación, entrenamiento y mantenimiento de modelos, al abordar problemas de AI/ML utilizando contenedores y Kubernetes en la plataforma OpenShift. Este proyecto se puede considerar como una implementación de referencia, un ejemplo de cómo construir una solución abierta del tipo ‘AI/ML como servicio’ basada en OpenShift y herramientas de código abierto, como Tensorflow, JupyterHub, Spark y otras. Es importante destacar que Red Hat utiliza este proyecto para ofrecer sus servicios de AI/ML. Además, OpenShift se integra con soluciones clave de software y hardware de ML de proveedores como NVIDIA, Seldon, Starburst y otros, lo que facilita la construcción y el lanzamiento de sistemas de aprendizaje automático propios.
El proyecto Open Data Hub está orientado a las siguientes categorías de usuarios y escenarios de uso:
- Analista de datos que necesita una solución para la implementación de proyectos de ML organizada en la nube con funciones de autoservicio.
- Analista de datos que necesita la máxima variedad de herramientas y plataformas AI/ML de código abierto más recientes.
- Analista de datos que necesita acceso a fuentes de datos al entrenar modelos.
- Analista de datos que necesita acceso a recursos computacionales (CPU, GPU, memoria).
- Analista de datos que requiere la posibilidad de colaborar y compartir resultados con colegas, recibir retroalimentación e introducir mejoras mediante iteraciones rápidas.
- Analista de datos que quiere interactuar con desarrolladores (y equipos de devops) para que sus modelos de ML y resultados se implementen en producción.
- Ingeniero de datos que necesita proporcionar a los analistas de datos acceso a diversas fuentes de datos cumpliendo con normativas y requisitos de seguridad.
- Administrador/operador de sistemas IT que necesita poder controlar sin esfuerzo el ciclo de vida (instalación, configuración, actualización) de componentes y tecnologías de código abierto. Así como las herramientas de gestión y cuotas correspondientes.
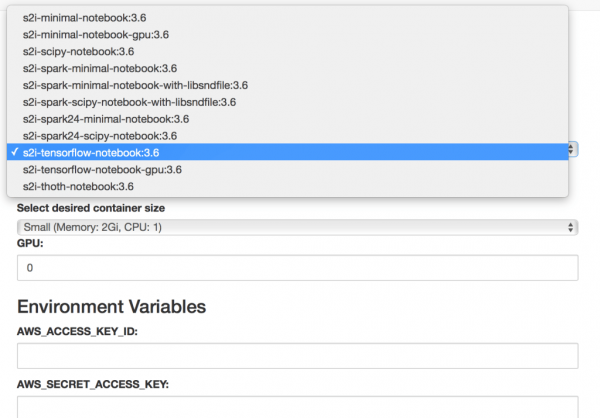
El proyecto Open Data Hub integra una serie de herramientas de código abierto para llevar a cabo el ciclo completo de operaciones AI/ML. Como herramienta principal para el analista de datos se utiliza Jupyter Notebook. Esta herramienta es muy popular entre los especialistas en procesamiento y análisis de datos, y Open Data Hub les permite crear y gestionar fácilmente entornos de trabajo en Jupyter Notebook, utilizando JupyterHub integrado. Además de crear e importar notebooks Jupyter, el proyecto Open Data Hub también incluye una serie de notebooks listos en forma de biblioteca AI Library.
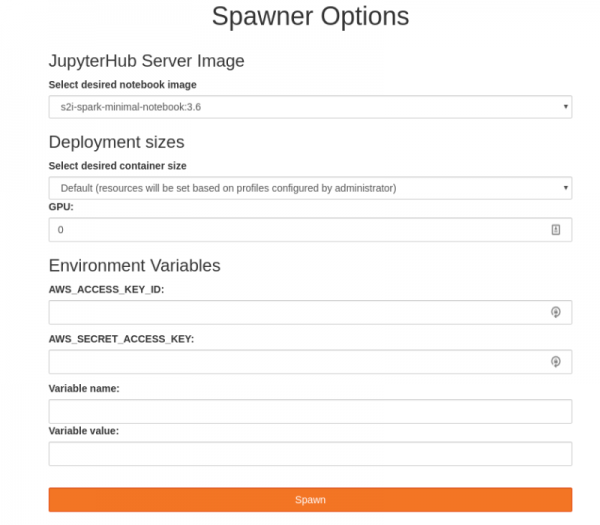
Esta biblioteca es una colección de componentes de aprendizaje automático de código abierto y soluciones para escenarios comunes que facilitan la rápida creación de prototipos. JupyterHub está integrado con un modelo de acceso RBAC de OpenShift, lo que permite utilizar cuentas de OpenShift ya existentes y realizar un inicio de sesión único. Además, JupyterHub ofrece una interfaz de usuario conveniente llamada spawner, con la cual el usuario puede configurar fácilmente la cantidad de recursos computacionales (núcleos de CPU, memoria, GPU) para el Jupyter Notebook seleccionado.
Una vez que el analista de datos crea y configura el cuaderno, todas las demás preocupaciones recaen en el programador de Kubernetes, que es parte de OpenShift. Los usuarios solo tienen que llevar a cabo sus experimentos, guardar y compartir los resultados de su trabajo. Además, los usuarios avanzados pueden acceder directamente a la línea de comandos de OpenShift desde los cuadernos de Jupyter para utilizar primitivas de Kubernetes, como Job, o funcionalidades de OpenShift, como Tekton o Knative. Alternativamente, se puede usar la conveniente GUI de OpenShift, que se llama 'consola web de OpenShift'.
Pasando a la siguiente etapa, Open Data Hub permite gestionar pipelines de datos. Para ello, se utiliza un objeto Ceph, que se ofrece como un almacenamiento de objetos compatible con S3. Apache Spark proporciona streaming de datos desde fuentes externas o el almacenamiento integrado Ceph S3, además de permitir la realización de transformaciones de datos previas. Apache Kafka ofrece gestión avanzada de pipelines de datos (donde se pueden realizar cargas múltiples, así como operaciones de transformación, análisis y almacenamiento de datos).
Así que el analista de datos ha accedido a los datos y ha construido un modelo. Ahora desea compartir los resultados obtenidos con colegas o desarrolladores de aplicaciones, poniendo a su disposición su modelo bajo un enfoque de servicio. Para ello, se necesita un servidor de salida, y Open Data Hub cuenta con dicho servidor, llamado Seldon, que permite publicar el modelo como un servicio RESTful.
En algún momento, hay varios modelos en el servidor Seldon, lo que genera la necesidad de monitorear cómo se utilizan. Para ello, Open Data Hub ofrece una colección de métricas relevantes y un motor de informes basado en herramientas de monitoreo de código abierto ampliamente utilizadas como Prometheus y Grafana. Como resultado, obtenemos retroalimentación para monitorear el uso de modelos de IA, especialmente en entornos de producción.
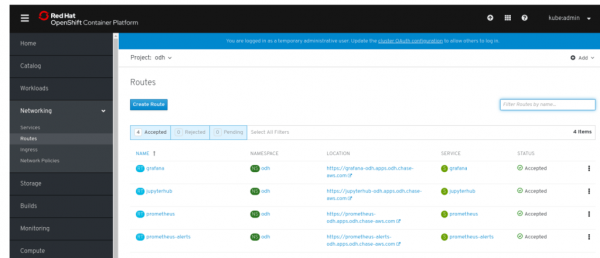
Así, Open Data Hub proporciona un enfoque en la nube durante todo el ciclo de operaciones de AI/ML, desde el acceso y la preparación de datos hasta el entrenamiento y la explotación industrial del modelo.
Reuniendo todo en uno
Ahora surge la pregunta de cómo organizar todo esto para el administrador de OpenShift. Aquí es donde entra en juego un operador de Kubernetes especial para proyectos de Open Data Hub.
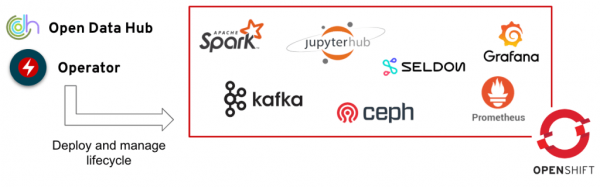
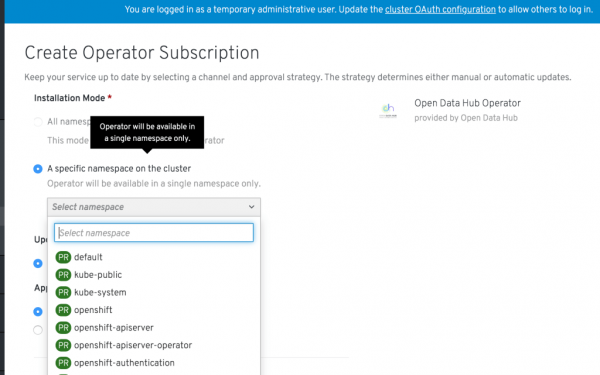
Este operador gestiona la instalación, configuración y ciclo de vida del proyecto Open Data Hub, incluyendo el despliegue de herramientas mencionadas anteriormente como JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus y Grafana. El proyecto Open Data Hub se puede encontrar en la consola web de OpenShift, en la sección de operadores comunitarios. Así, el administrador de OpenShift puede establecer que los proyectos correspondientes de OpenShift se clasifiquen como "proyectos Open Data Hub". Esto se hace una vez. Después, el analista de datos a través de la consola web de OpenShift ingresa a su espacio de proyectos y ve que el operador de Kubernetes correspondiente está instalado y disponible para sus proyectos. Luego, crea una instancia del proyecto Open Data Hub con un solo clic y obtiene acceso inmediato a las herramientas descritas anteriormente. Y todo esto se puede configurar en modo de alta disponibilidad y tolerancia a fallos.
Si deseas probar por ti mismo el proyecto Open Data Hub, comienza con . Los detalles técnicos de la arquitectura de Open Data Hub se pueden encontrar , los planes de desarrollo del proyecto son . En el futuro, se planea implementar integración adicional con Kubeflow, resolver una serie de cuestiones relacionadas con la regulación de datos y la seguridad, y organizar la integración con sistemas basados en reglas Drools y Optaplanner. Puedes expresar tu opinión y convertirte en participante del proyecto en la página .
Resumiendo: los problemas graves de escalabilidad impiden que las organizaciones aprovechen al máximo el potencial de la inteligencia artificial y el aprendizaje automático. Red Hat OpenShift se ha utilizado durante mucho tiempo con éxito para abordar problemas similares en la industria del software. El proyecto Open Data Hub, implementado dentro de la comunidad de desarrollo de código abierto, ofrece una arquitectura de referencia para organizar el ciclo completo de operaciones de IA/ML en la nube híbrida de OpenShift. Tenemos un plan claro y bien pensado para el desarrollo de este proyecto y estamos comprometidos a crear una comunidad activa y productiva de desarrollo de soluciones de IA abiertas en la plataforma OpenShift.
Fuente: habr.com
