

Hoy hablaremos sobre cómo almacenar mejor los datos en un mundo donde las redes de quinta generación, los escáneres genómicos y los vehículos autónomos generan más datos en un día que toda la humanidad en el período anterior a la revolución industrial.
Nuestro mundo está generando cada vez más información. Parte de ella es efímera y se pierde tan rápido como se recoge. Otra debe almacenarse por más tiempo, y otra está destinada a durar "por siglos", al menos así lo vemos desde el presente. Los flujos de información se asientan en los centros de datos a tal velocidad que cualquier nuevo enfoque o tecnología destinada a satisfacer esta incesante "demanda" rápidamente queda obsoleta.
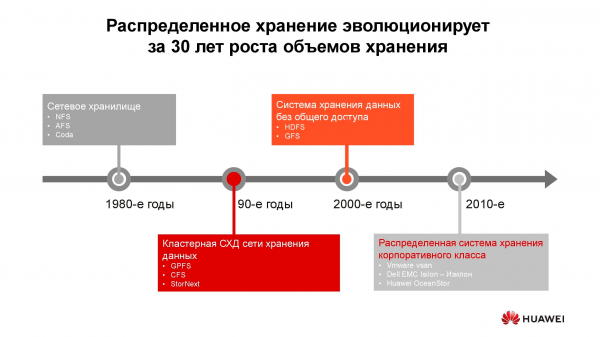
40 años de desarrollo de sistemas de almacenamiento distribuidos
Los primeros almacenamientos de red en la forma que conocemos aparecieron en la década de 1980. Muchos de ustedes se han encontrado con NFS (Network File System), AFS (Andrew File System) o Coda. Una década después, la moda y la tecnología cambiaron, y los sistemas de archivos distribuidos dieron paso a sistemas de almacenamiento en clúster basados en GPFS (General Parallel File System), CFS (Clustered File Systems) y StorNext. Se utilizaban almacenes de bloques de arquitectura clásica como base, sobre la cual se creaba un sistema de archivos único mediante una capa de software. Estas y soluciones similares aún se aplican, ocupan su nicho y son bastante demandadas.
A la vuelta del milenio, la paradigma de los almacenes distribuidos cambió un poco, y los sistemas con arquitectura SN (Shared-Nothing) ganaron posiciones líderes. Se produjo una transición del almacenamiento en clúster al almacenamiento en nodos individuales, que generalmente eran servidores clásicos con software que garantizaba un almacenamiento fiable; sobre estos principios se construyeron, por ejemplo, HDFS (Hadoop Distributed File System) y GFS (Global File System).
Cerca de 2010, los conceptos fundamentales en los sistemas de almacenamiento distribuidos comenzaron a reflejarse cada vez más en productos comerciales completos, como VMware vSAN, Dell EMC Isilon y nuestra . Detrás de estas plataformas ya no hay solo una comunidad de entusiastas, sino proveedores concretos que son responsables de la funcionalidad, el soporte, el mantenimiento del producto y garantizan su desarrollo futuro. Estas soluciones son especialmente demandadas en varios sectores.
Operadores de telecomunicaciones
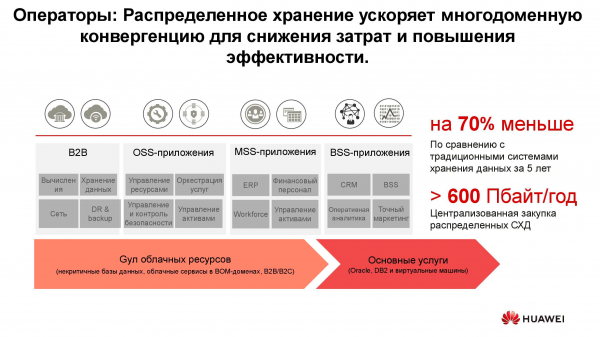
Probablemente, uno de los consumidores más antiguos de sistemas de almacenamiento distribuidos son los operadores de telecomunicaciones. En el esquema se puede ver qué grupos de aplicaciones generan el mayor volumen de datos. OSS (Sistemas de Soporte a las Operaciones), MSS (Servicios de Soporte a la Gestión) y BSS (Sistemas de Soporte a los Negocios) son tres capas de software que se complementan entre sí, necesarias para ofrecer servicio a los abonados, informes financieros al proveedor y soporte operativo a los ingenieros del operador.
A menudo, los datos de estas capas están muy mezclados entre sí y, para evitar la acumulación de copias innecesarias, se utilizan precisamente almacenes distribuidos, que acumulan todo el volumen de información que proviene de la red en funcionamiento. Los almacenes se agrupan en un conjunto común al que acceden todos los servicios.
Nuestros cálculos muestran que la transición de sistemas de almacenamiento tradicionales a almacenamiento en bloque permite ahorrar hasta un 70% del presupuesto solo al renunciar a los sistemas de almacenamiento dedicados de alta gama y al utilizar servidores convencionales de arquitectura clásica (generalmente x86), que operan en conjunto con software especializado. Los operadores de telefonía móvil han comenzado a adquirir este tipo de soluciones en grandes volúmenes desde hace ya bastante tiempo. En particular, los operadores rusos han estado utilizando productos similares de Huawei durante más de seis años.
Sí, hay una serie de tareas que no se pueden realizar con sistemas distribuidos. Por ejemplo, en caso de altos requerimientos de rendimiento o compatibilidad con protocolos antiguos. Sin embargo, no menos del 70% de los datos que maneja el operador pueden ubicarse en un grupo distribuido.
Sector bancario
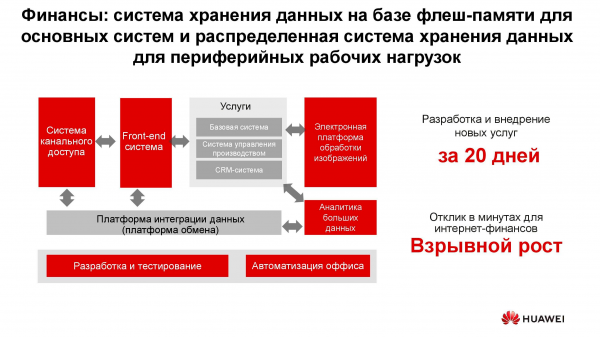
En cualquier banco coexisten numerosos sistemas de TI diversos, desde procesamiento hasta sistemas bancarios automatizados. Esta infraestructura también trabaja con un enorme volumen de información, y la mayoría de las tareas no requieren un alto rendimiento y fiabilidad de los sistemas de almacenamiento, como el desarrollo, la prueba, la automatización de procesos de oficina, entre otros. Aquí, el uso de sistemas de almacenamiento tradicionales es posible, pero cada año resulta menos rentable. Además, en este caso, falta la flexibilidad en el consumo de recursos de estos sistemas, cuya capacidad se calcula en función de la carga máxima.
Al utilizar sistemas de almacenamiento distribuidos, sus nodos, que en realidad son servidores normales, pueden ser convertidos en cualquier momento, por ejemplo, en un conjunto de servidores y utilizados como una plataforma de computación.
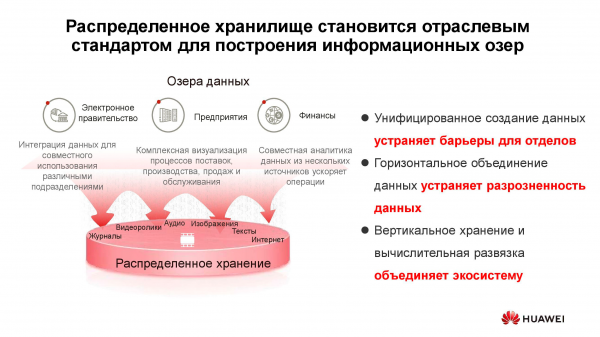
Lagos de datos
En el esquema anterior se presenta una lista de consumidores típicos de servicios . Pueden ser servicios gubernamentales electrónicos (por ejemplo, "Servicios del Estado"), empresas que han pasado por la digitalización, instituciones financieras, entre otros. Todos ellos necesitan trabajar con grandes volúmenes de información heterogénea.
La operación de soluciones de almacenamiento clásicas para abordar tales tareas no es eficiente, ya que se requiere tanto acceso de alto rendimiento a bases de datos en bloque como acceso normal a bibliotecas de documentos escaneados almacenados como objetos. También podría estar vinculada, por ejemplo, a un sistema de pedidos a través de un portal web. Para implementar todo esto en una plataforma de almacenamiento clásica, se necesitaría un gran conjunto de equipos para diferentes tareas. Un solo sistema de almacenamiento horizontal y versátil puede cubrir todas las tareas mencionadas anteriormente: solo sería necesario crear en él varios grupos con diferentes características de almacenamiento.
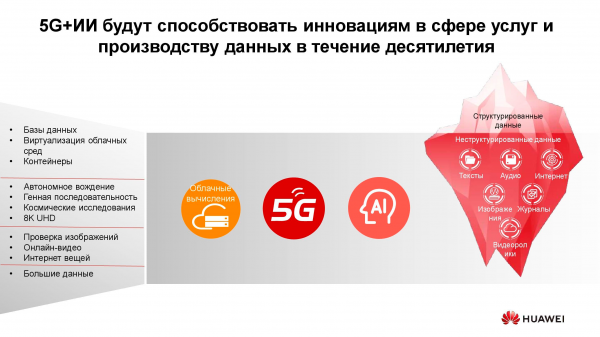
Generadores de nueva información
La cantidad de información almacenada en el mundo crece aproximadamente un 30% al año. Son buenas noticias para los proveedores de sistemas de almacenamiento, pero ¿cuál es y será la principal fuente de estos datos?
Hace diez años, las redes sociales se convirtieron en tales generadores, lo que requirió la creación de una gran cantidad de nuevos algoritmos, soluciones de hardware, etc. Actualmente, se destacan tres principales motores de crecimiento del volumen de almacenamiento. El primero es la computación en la nube. En la actualidad, aproximadamente el 70% de las empresas utilizan de alguna manera servicios en la nube. Pueden ser sistemas de correo electrónico, copias de seguridad y otras entidades virtualizadas.
El segundo motor son las redes de quinta generación. Estas implican nuevas velocidades y nuevos volúmenes de transmisión de datos. Según nuestras proyecciones, la amplia adopción del 5G conducirá a una disminución en la demanda de tarjetas de memoria flash. Por muchas capacidades que tenga la memoria de un teléfono, siempre se termina, y con un canal de 100 megabits en el dispositivo no hay necesidad de almacenar fotos localmente.
Entre los terceros grupos de razones por las que aumenta la demanda de sistemas de almacenamiento se encuentran el desarrollo acelerado de la inteligencia artificial, la transición a la analítica de grandes datos y la tendencia hacia la automatización total de todo lo posible.
Una característica del "nuevo tráfico" es su . Necesitamos almacenar estos datos sin definir su formato. Este solo se requiere para la lectura posterior. Por ejemplo, un sistema bancario de scoring para determinar el tamaño de crédito disponible examinará las fotografías que ha publicado en sus redes sociales, evaluando con qué frecuencia visita el mar y los restaurantes, y al mismo tiempo revisará los extractos de sus documentos médicos disponibles. Estos datos son, por un lado, exhaustivos, y por el otro, carecen de homogeneidad.
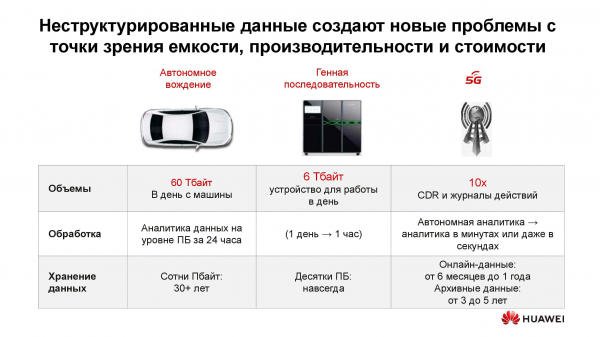
El océano de datos no estructurados
¿Qué problemas conlleva la aparición de "nuevos datos"? El más importante es, por supuesto, el volumen de información y los plazos de almacenamiento calculados. Un solo automóvil autónomo moderno sin conductor genera hasta 60 TB de datos al día provenientes de todos sus sensores y mecanismos. Para desarrollar nuevos algoritmos de movimiento, esta información debe ser procesada en el mismo día, de lo contrario comenzará a acumularse. Además, debe almacenarse durante mucho tiempo: décadas. Solo entonces en el futuro se podrán hacer conclusiones basadas en grandes muestras analíticas.
Un dispositivo para descifrar secuencias genéticas produce alrededor de 6 TB al día. Y los datos recopilados a través de él no contemplan la eliminación, es decir, hipotéticamente deben almacenarse para siempre.
Finalmente, las mismas redes de quinta generación. Además de la información transmitida, dicha red también es un enorme generador de datos: registros de acciones, grabaciones de llamadas, resultados intermedios de interacciones entre máquinas, etc.
Todo esto requiere el desarrollo de nuevos enfoques y algoritmos para el almacenamiento y procesamiento de información. Y tales enfoques están surgiendo.
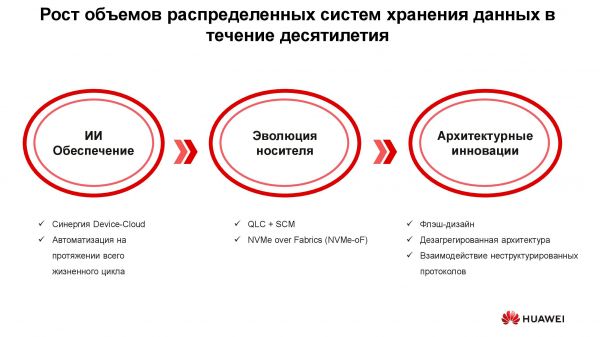
Tecnologías de una nueva era
Se pueden distinguir tres grupos de soluciones destinadas a hacer frente a los nuevos requisitos de los sistemas de almacenamiento de información: la implementación de inteligencia artificial, la evolución técnica de los soportes de datos y las innovaciones en el campo de la arquitectura de sistemas. Comencemos con la IA.
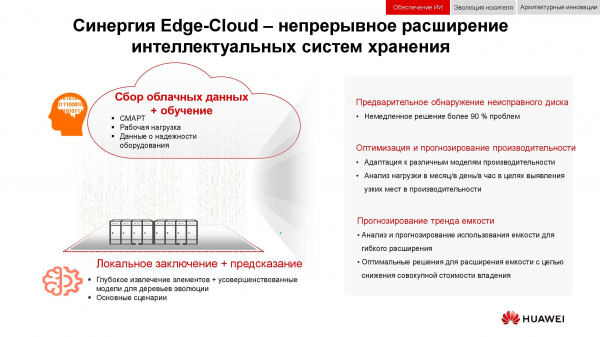
En las nuevas soluciones de Huawei, la inteligencia artificial ya se utiliza a nivel del almacenamiento mismo, que está equipado con un procesador de IA que permite al sistema analizar su estado de manera autónoma y predecir fallos. Si se conecta el sistema de almacenamiento a una nube de servicios con capacidades computacionales significativas, la inteligencia artificial podrá procesar más información y aumentar la precisión de sus hipótesis.
Además de los fallos, esta IA puede prever la futura carga máxima y el tiempo restante antes de que se agote la capacidad. Esto permite optimizar el rendimiento y escalar el sistema incluso antes de que ocurran eventos no deseados.
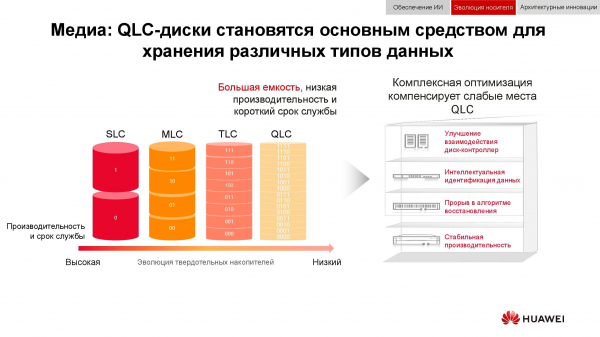
Ahora hablemos de la evolución de los soportes de datos. Las primeras unidades flash se fabricaron con tecnología SLC (Single-Level Cell). Los dispositivos basados en esta tecnología eran rápidos, fiables y estables, pero tenían una capacidad pequeña y eran muy costosos. Se logró aumentar el volumen y reducir el precio mediante ciertos compromisos técnicos que disminuyeron la velocidad, la fiabilidad y la vida útil de los soportes. Sin embargo, esta tendencia no afectó a los sistemas de almacenamiento, que, gracias a diversas artimañas arquitectónicas, se volvieron en general más eficientes y más fiables.
Pero, ¿por qué eran necesarios los sistemas de almacenamiento de clase All-Flash? ¿No bastaba con simplemente reemplazar los antiguos HDD en un sistema ya en uso por nuevos SSD del mismo factor de forma? Esto fue necesario para utilizar de manera efectiva todos los recursos de los nuevos dispositivos de estado sólido, algo que no era posible en los sistemas antiguos.
La empresa Huawei, por ejemplo, desarrolló una serie de tecnologías para abordar esta tarea, una de las cuales fue , que permitió optimizar al máximo las interacciones entre "disco - controlador".
La identificación inteligente permitió distribuir los datos en varios flujos y resolver una serie de fenómenos no deseados, como (amplificación de escritura). Al mismo tiempo, los nuevos algoritmos de recuperación, en particular, , aumentaron la velocidad de rebuild, reduciendo su tiempo a valores completamente insignificantes.
El fallo, el desbordamiento, la "recolección de basura" — estos factores también ya no afectan al rendimiento del sistema de almacenamiento gracias a una mejora especial en los controladores.
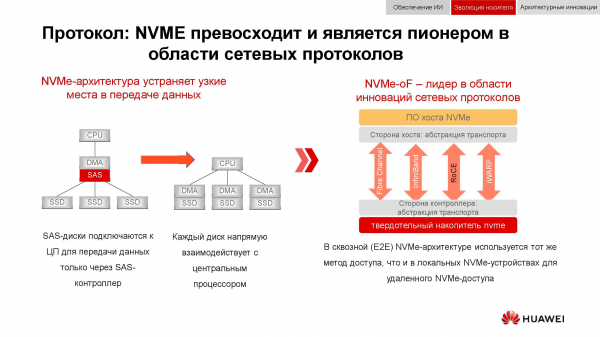
Además, los almacenes de datos en bloques están preparados para recibir . Recordemos que el esquema clásico de acceso a los datos funcionaba así: el procesador se comunicaba con el controlador RAID a través del bus PCI Express. Este, a su vez, interactuaba con discos mecánicos a través de SCSI o SAS. La implementación de NVMe en el backend aceleró notablemente todo el proceso, aunque tenía una desventaja: los dispositivos debían tener una conexión directa al procesador para asegurar el acceso directo a la memoria.
La siguiente fase de desarrollo de la tecnología que estamos observando ahora es la aplicación de NVMe-oF (NVMe sobre redes). En cuanto a las tecnologías de bloques de Huawei, ya soportan FC-NVMe (NVMe sobre Fibre Channel), y se aproxima NVMe sobre RoCE (RDMA sobre Ethernet convergido). Los modelos de prueba son funcionales, y queda pocos meses antes de su presentación oficial. Cabe mencionar que todo esto también aparecerá en sistemas distribuidos, donde 'Ethernet sin pérdidas' será muy demandado.
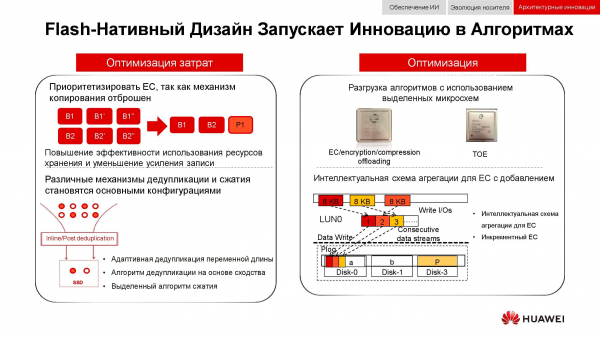
Un método adicional para optimizar el funcionamiento de los almacenes distribuidos ha sido la eliminación total de la duplicación de datos. Las soluciones de Huawei ya no utilizan n copias, como en el clásico RAID 1, y han cambiado completamente al mecanismo (codificación de borrado). Un paquete matemático especial calcula periódicamente bloques de control que permiten recuperar datos intermedios en caso de pérdidas.
Los mecanismos de deduplicación y compresión se están volviendo obligatorios. Si en los sistemas de almacenamiento clásicos estamos limitados por la cantidad de procesadores instalados en los controladores, en los sistemas de almacenamiento distribuidos y escalables horizontalmente, cada nodo contiene todo lo necesario: discos, memoria, procesadores e interconexión. Estos recursos son suficientes para que la deduplicación y compresión tengan un impacto mínimo en el rendimiento.
Y sobre los métodos de optimización de hardware. Aquí, la carga en los procesadores centrales se ha reducido mediante microchips dedicados adicionales (o bloques dedicados dentro del propio procesador), que desempeñan el papel de (Motor de descarga TCP/IP) o que asumen tareas matemáticas de EC, deduplicación y compresión.
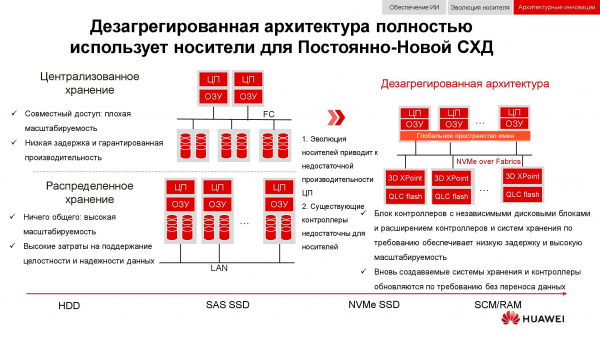
Los nuevos enfoques para el almacenamiento de datos se han materializado en una arquitectura desacoplada (distribuida). En los sistemas de almacenamiento centralizado, hay una fábrica de servidores conectada a través de Fibre Channel a un gran número de matrices. Las desventajas de este enfoque son las dificultades para escalar y garantizar un nivel de servicio (en términos de rendimiento o latencias). Los sistemas hiperconvergentes utilizan los mismos hosts tanto para el almacenamiento como para el procesamiento de la información. Esto ofrece un prácticamente ilimitado espacio para escalar, pero conlleva altos costos para mantener la integridad de los datos.
A diferencia de las dos arquitecturas anteriores, la arquitectura desacoplada implica la división del sistema en una fábrica de computación y un sistema de almacenamiento horizontal.Esto proporciona las ventajas de ambas arquitecturas y permite escalar prácticamente ilimitadamente solo aquel elemento cuya capacidad de rendimiento sea insuficiente.
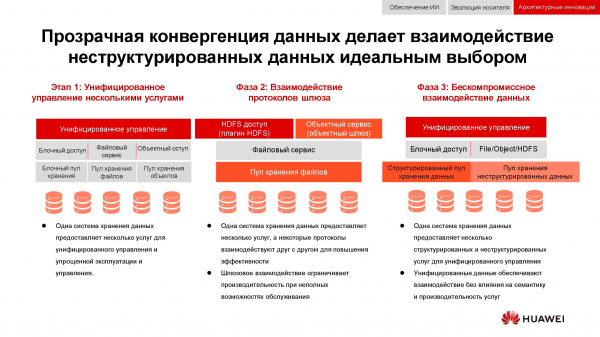
De la integración a la convergencia
Un desafío clásico cuya relevancia ha ido en aumento durante los últimos 15 años es la necesidad de proporcionar simultáneamente almacenamiento en bloques, acceso a archivos, acceso a objetos, y operar un clúster para grandes datos, etc. La guinda del pastel podría ser, por ejemplo, un sistema de respaldo en cinta magnética.
En la primera fase, solo se logró unificar la gestión de estos servicios. Los sistemas de almacenamiento de datos heterogéneos se ataban a algún software especializado, a través del cual el administrador distribuía recursos de los grupos disponibles. Pero dado que estos grupos eran hardware diferente, la migración de carga entre ellos era imposible. En un nivel más alto de integración, la consolidación sucedía a nivel de puerta de enlace. Con un acceso común a archivos, podría ofrecerse a través de diferentes protocolos.
El método más avanzado de convergencia disponible para nosotros en este momento implica la creación de un sistema híbrido universal. Así es como debe convertirse nuestra . El acceso universal utiliza los mismos recursos de hardware, lógicamente divididos en diferentes grupos, pero que permiten la migración de carga. Todo esto se puede hacer a través de una única consola de gestión. De esta manera, hemos logrado implementar el concepto de "un centro de datos — un sistema de almacenamiento".
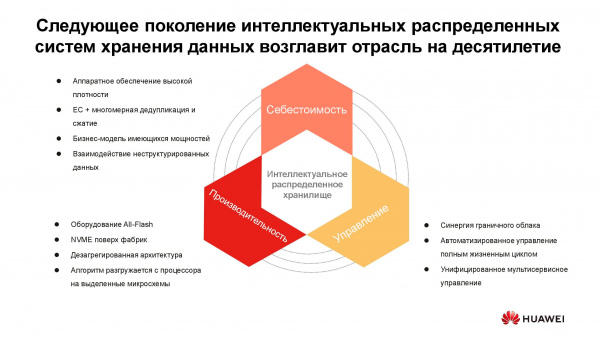
El costo de almacenamiento de información ahora determina muchas decisiones arquitectónicas. Y aunque se puede considerar como un aspecto central, hoy discutimos el almacenamiento "en vivo" con acceso activo, por lo que el rendimiento también debe tenerse en cuenta. Otra característica importante de los sistemas distribuidos de próxima generación es la unificación. Nadie quiere tener múltiples sistemas dispares, gestionados desde diferentes consolas. Todas estas cualidades se han plasmado en la nueva serie de productos de Huawei. .
Sistema de almacenamiento masivo de nueva generación
OceanStor Pacific cumple con los requisitos de fiabilidad de "seis nueves" (99,9999%) y puede utilizarse para crear centros de datos de clase HyperMetro. Con una distancia entre dos centros de datos de hasta 100 km, los sistemas muestran una latencia adicional de 2 ms, lo que permite construir cualquier solución de recuperación ante desastres, incluidos servidores de mayoría.
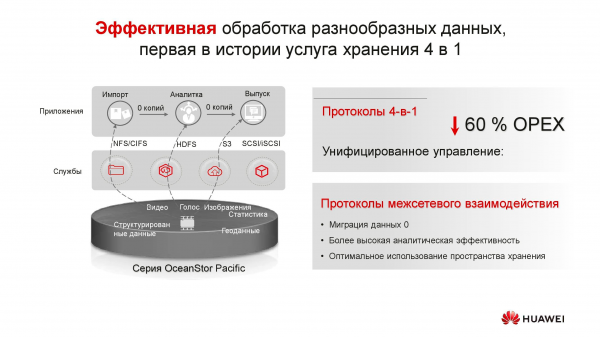
Los productos de la nueva serie muestran versatilidad en protocolos. OceanStor 100D ya admite acceso de bloques, acceso a objetos y acceso Hadoop. Pronto también se implementará el acceso a archivos. No hay necesidad de almacenar múltiples copias de datos si se pueden proporcionar a través de diferentes protocolos.
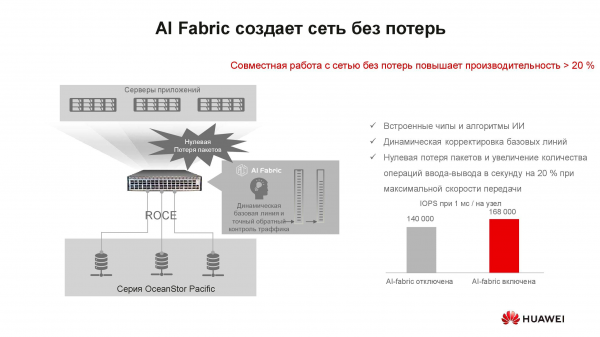
A primera vista, ¿qué relación tiene el concepto de "red sin pérdidas" con el almacenamiento? La cuestión es que los sistemas distribuidos de almacenamiento de datos se construyen sobre una red rápida que admite los algoritmos y mecanismos correspondientes de RoCE. Además, nuestra sistema de inteligencia artificial, soportada por nuestros conmutadores, ayuda a aumentar aún más la velocidad de la red y reducir la latencia. . La mejora en el rendimiento del sistema de almacenamiento al activar AI Fabric puede alcanzar hasta un 20%.
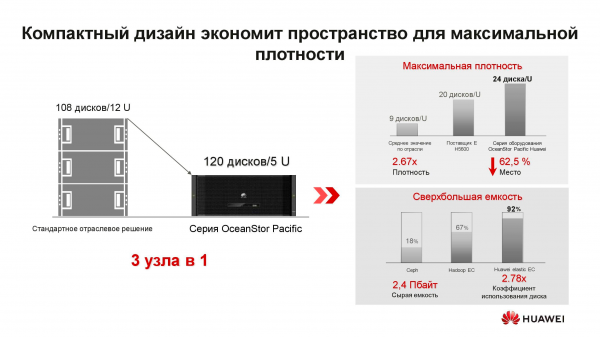
¿Qué representa el nuevo nodo del sistema de almacenamiento distribuido OceanStor Pacific? La solución en formato de 5U incluye 120 unidades de almacenamiento y puede reemplazar tres nodos clásicos, lo que proporciona más del doble de ahorro de espacio en el rack. Al eliminar el almacenamiento de copias, la eficiencia de los discos aumenta notablemente (hasta un +92%).
Estamos acostumbrados a que un sistema de almacenamiento definido por software sea un programa especial instalado en un servidor clásico. Pero ahora, para alcanzar parámetros óptimos, esta solución arquitectónica también requiere nodos especiales. Está compuesta por dos servidores basados en procesadores ARM, que gestionan un conjunto de unidades de almacenamiento de tres pulgadas.
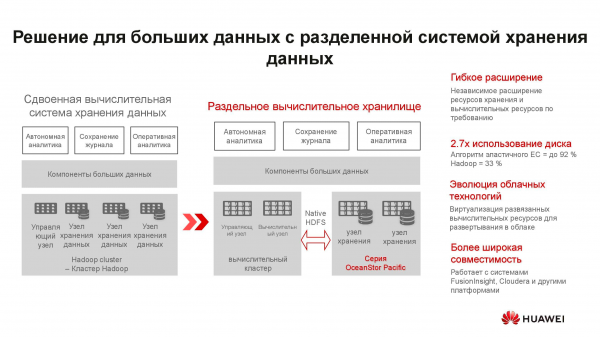
Estos servidores son poco adecuados para soluciones hiperconvergentes. En primer lugar, hay muy pocas aplicaciones para ARM, y en segundo lugar, es difícil mantener un equilibrio de carga. Proponemos pasar al almacenamiento separado: un clúster computacional, compuesto por servidores clásicos o servidores en bastidor, funciona de manera independiente, pero se conecta a los nodos de almacenamiento OceanStor Pacific, que también realizan sus tareas directas. Y esto resulta justificable.
Por ejemplo, tomemos una solución clásica para el almacenamiento de grandes datos con un sistema hiperconvergente que ocupa 15 racks de servidor. Si se distribuye la carga entre servidores computacionales separados y los nodos de almacenamiento OceanStor Pacific, separándolos entre sí, ¡el número de racks necesarios se reduce a la mitad! Esto reduce los costos de operación del centro de datos y disminuye el costo total de propiedad. En un mundo donde el volumen de información almacenada crece un 30% al año, tales ventajas no deben desperdiciarse.
***
Puede obtener más información sobre las soluciones de Huawei y sus escenarios de aplicación en nuestro o comunicándose directamente con los representantes de la empresa.
Fuente: habr.com
