

He subido a Github .
Es una tabla hash simple para GPU, capaz de procesar cientos de millones de inserciones por segundo. En mi portátil con NVIDIA GTX 1060, el código inserta 64 millones de pares clave-valor generados aleatoriamente en aproximadamente 210 ms y elimina 32 millones de pares en aproximadamente 64 ms.
Es decir, la velocidad en el portátil es de aproximadamente 300 millones de inserciones/segundo y 500 millones de eliminaciones/segundo.
La tabla está escrita en CUDA, aunque la misma metodología se puede aplicar a HLSL o GLSL. La implementación tiene algunas limitaciones que garantizan un alto rendimiento en la tarjeta gráfica:
- Solo se procesan claves de 32 bits y valores de igual tamaño.
- La tabla hash tiene un tamaño fijo.
- Y este tamaño debe ser una potencia de dos.
Para las claves y valores se necesita reservar un simple marcador de delimitación (en el código presentado es 0xffffffff).
Tabla hash sin bloqueos
En la tabla hash se utiliza direccionamiento abierto con , es simplemente un arreglo de pares clave-valor que se almacena en la memoria y tiene un excelente rendimiento de caché. Esto no se puede decir de la vinculación en cadena (chaining), donde se implica la búsqueda de un puntero en una lista enlazada. La tabla hash es un simple arreglo que almacena elementos KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
El tamaño de la tabla es una potencia de dos, no un número primo, porque para aplicar la máscara pow2/AND basta con una instrucción rápida, mientras que el operador de módulo es mucho más lento. Esto es importante en el caso del sondeo lineal, ya que al buscar linealmente en la tabla, el índice de la ranura debe ser envuelto en cada ranura. Y como resultado se añade el costo de la operación de módulo en cada ranura.
La tabla solo almacena la clave y el valor para cada elemento, no el hash de la clave. Como la tabla solo almacena claves de 32 bits, el hash se calcula muy rápido. En el código presentado se utiliza el hash Murmur3, que realiza solo unos pocos desplazamientos, XOR y multiplicaciones.
En la tabla hash se aplica un método de protección contra bloqueos que no depende del orden en que se almacena en la memoria. Incluso si algunas operaciones de escritura interrumpen el orden de otras, la tabla hash seguirá manteniendo un estado correcto. Hablaremos de ello más adelante. Este método funciona muy bien con tarjetas gráficas, donde miles de hilos se ejecutan de manera concurrente.
Las claves y los valores en la tabla hash se inicializan como vacíos.
El código se puede modificar para que pueda manejar claves y valores de 64 bits. Se requieren operaciones atómicas de lectura, escritura y comparación con intercambio (compare-and-swap) para las claves. Y para los valores, se necesitan operaciones atómicas de lectura y escritura. Afortunadamente, en CUDA las operaciones de lectura-escritura para valores de 32 y 64 bits son atómicas siempre que estén alineadas de manera natural (ver ), y las tarjetas gráficas modernas permiten operaciones atómicas de comparación con intercambio de 64 bits. Por supuesto, al pasar a 64 bits, el rendimiento disminuirá un poco.
Estado de la tabla hash
Cada par clave-valor en la tabla hash puede tener uno de los cuatro estados:
- La clave y el valor están vacíos. En este estado, la tabla hash se inicializa.
- La clave ha sido escrita, pero el valor aún no. Si otro hilo de ejecución lee los datos en este momento, devolverá un valor vacío. Esto es normal; lo mismo ocurriría si otro hilo de ejecución hubiese terminado un poco antes, y hablamos de una estructura de datos concurrente.
- Tanto la clave como el valor han sido escritos.
- El valor está disponible para otros hilos de ejecución, pero la clave aún no. Esto puede suceder porque el modelo de programación de CUDA implica un modelo de memoria débilmente ordenado. Esto es normal; en cualquier caso, la clave sigue estando vacía, incluso si el valor ya no lo es.
Un punto importante es que una vez que una clave ha sido escrita en un espacio, no se mueve más — incluso si la clave se elimina, hablaremos de ello más adelante.
El código de la tabla hash funciona incluso con modelos de memoria débilmente ordenados, en los que no se conoce el orden de lectura y escritura en la memoria. Cuando revisemos la inserción, búsqueda y eliminación en la tabla hash, recuerde que cada par clave-valor se encuentra en uno de los cuatro estados descritos anteriormente.
Inserción en la tabla hash
La función CUDA que inserta pares clave-valor en la tabla hash se ve así:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Para insertar la clave, el código itera sobre el arreglo de la tabla hash comenzando desde el hash de la clave que se está insertando. En cada ranura del arreglo se realiza una operación atómica de comparación e intercambio, en la que la clave en esa ranura se compara con un valor vacío. Si se encuentra una discrepancia, la clave en la ranura se actualiza a la clave que se está insertando y luego se devuelve la clave original de la ranura. Si esta clave original estaba vacía o coincidía con la clave que se está insertando, entonces el código ha encontrado una ranura adecuada para insertar y coloca el valor a insertar en la ranura.
Si en una llamada al núcleo gpu_hashtable_insert() hay varios elementos con la misma clave, entonces cualquiera de sus valores puede ser escrito en la ranura de la clave. Esto se considera normal: una de las operaciones de escritura de clave-valor durante la llamada será exitosa, pero dado que todo esto ocurre de manera paralela en el contexto de varios hilos de ejecución, no podemos predecir qué operación de escritura en memoria será la última.
Búsqueda en la tabla hash
Código para buscar claves:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Para encontrar el valor de una clave almacenada en la tabla, iteramos sobre el arreglo comenzando desde el hash de la clave buscada. En cada ranura, verificamos si la clave es la que estamos buscando y, si es así, devolvemos su valor. También verificamos si la clave está vacía y, de ser así, interrumpimos la búsqueda.
Si no podemos encontrar la clave, el código devuelve un valor vacío.
Todas estas operaciones de búsqueda pueden realizarse concurrentemente durante inserciones y eliminaciones. Cada par en la tabla tendrá uno de los cuatro estados descritos anteriormente para el hilo.
Eliminación en la tabla hash
Código para eliminar claves:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
La eliminación de la clave se realiza de manera inusual: dejamos la clave en la tabla y marcamos su valor (no la clave en sí) como vacío. Este código es muy similar a lookup(), excepto que al encontrar una coincidencia por clave, se hace que su valor sea vacío.
Como se mencionó anteriormente, una vez que la clave se escribe en la ranura, ya no se mueve. Incluso al eliminar un elemento de la tabla, la clave permanece en su lugar; simplemente su valor se vuelve vacío. Esto significa que no necesitamos usar una operación atómica para escribir el valor de la ranura, ya que no importa si el valor actual está vacío o no: de todos modos, se convertirá en vacío.
Redimensionamiento de la tabla hash
Se puede redimensionar la tabla hash creando una tabla más grande e insertando en ella elementos no vacíos de la tabla antigua. No implementé esta funcionalidad porque quería mantener el código simple. Además, en programas CUDA, la asignación de memoria a menudo se realiza en el código del host y no en el núcleo de CUDA.
En el artículo describe cómo modificar tal estructura de datos libre de bloqueos.
Concurrencia
En los fragmentos de código anteriores, las funciones gpu_hashtable_insert(), _lookup() y _delete() procesan una pareja clave-valor a la vez. A continuación, gpu_hashtable_insert(), _lookup() y _delete() procesan un arreglo de pares en paralelo, cada par en un hilo de ejecución de GPU separado:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Una tabla hash protegida contra bloqueos admite inserciones, búsquedas y eliminaciones concurrentes. Dado que los pares clave-valor siempre están en uno de cuatro estados y las claves no se mueven, la tabla garantiza la corrección incluso al usar operaciones de diferentes tipos simultáneamente.
Sin embargo, si procesamos en paralelo un lote de inserciones y eliminaciones, y si el arreglo de entrada de pares contiene claves duplicadas, no podremos predecir qué pares 'ganarán' — es decir, cuáles se escribirán en la tabla hash últimos. Supongamos que llamamos al código de inserción con un arreglo de entrada de pares A/0 B/1 A/2 C/3 A/4. Cuando el código termine, los pares B/1 y C/3 garantizarán estar presentes en la tabla, pero también estará cualquiera de los pares A/0, A/2 o A/4Esto puede ser un problema o no, todo depende de la aplicación. Puedes saber de antemano que en el array de entrada no hay claves duplicadas, o puede que no te importe qué valor se haya escrito al final.
Si para ti esto es un problema, entonces necesitas dividir las parejas duplicadas en diferentes llamadas al sistema CUDA. En CUDA, cualquier operación con una llamada al kernel siempre se completa antes de la siguiente llamada al kernel (al menos dentro de un hilo. En diferentes hilos, los kernels se ejecutan en paralelo). Si en el ejemplo anterior llamas a un kernel con A/0 B/1 A/2 C/3, y otro con A/4, entonces la clave A recibirá el valor 4.
Ahora hablemos sobre si las funciones lookup() y delete() deben utilizar un puntero simple (plain) o un puntero variable (volatile) a un array de parejas en la tabla hash. afirma que:
El compilador puede optimizar a su criterio las operaciones de lectura y escritura en la memoria global o compartida… Estas optimizaciones se pueden desactivar utilizando la palabra clave
volatile: … cualquier referencia a esta variable se compila en una instrucción real de lectura o escritura en memoria.
Las consideraciones de corrección no requieren su uso. volatileSi el hilo de ejecución utiliza un valor en caché de una operación de lectura anterior, eso significa que utilizará una información un poco desactualizada. Sin embargo, sigue siendo información del estado correcto de la tabla hash en un momento específico de la llamada al kernel. Si necesitas utilizar la información más reciente, puedes utilizar un puntero volatile, pero entonces la productividad se reducirá un poco: según mis pruebas, al eliminar 32 millones de elementos, la velocidad se redujo de 500 millones de eliminaciones/seg a 450 millones de eliminaciones/seg.
Rendimiento
En la prueba de inserción de 64 millones de elementos y eliminación de 32 millones de ellos, la competencia entre std::unordered_map y la tabla hash para GPU es prácticamente inexistente:
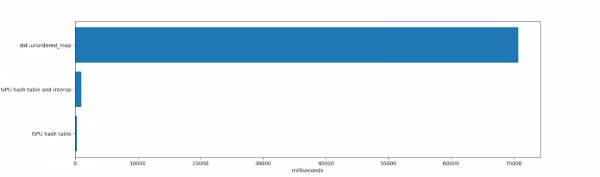
std::unordered_map se tardaron 70,691 ms en insertar y eliminar elementos, seguido de la liberación de unordered_map (la liberación de millones de elementos lleva un tiempo considerable, ya que dentro unordered_map se realizan numerosas asignaciones de memoria). Honestamente, en std::unordered_map completamente diferentes restricciones. Este es un único hilo de CPU, que soporta claves y valores de cualquier tamaño, funciona bien con altos coeficientes de utilización y muestra un rendimiento estable después de múltiples eliminaciones.
La duración del funcionamiento de la tabla hash para GPU y la intercomunicación fue de 984 ms. Esto incluye el tiempo gasto en colocar la tabla en la memoria y su eliminación (una única asignación de 1 GB de memoria, lo que lleva algo de tiempo en CUDA), la inserción y eliminación de elementos, así como la iteración sobre ellos. También se han tenido en cuenta todas las copias hacia y desde la memoria de la tarjeta gráfica.
El funcionamiento de la propia tabla hash tomó 271 ms. Esto incluye el tiempo que la GPU gastó en insertar y eliminar elementos, y no considera el tiempo de copias en memoria ni la iteración sobre la tabla resultante. Si la tabla GPU vive mucho tiempo, o si la tabla hash se mantiene completamente en la memoria de la tarjeta gráfica (por ejemplo, para crear una tabla hash que será utilizada por otro código GPU, y no por el procesador central), entonces el resultado de la prueba es relevante.
La tabla hash para la tarjeta gráfica demuestra un alto rendimiento gracias a su gran ancho de banda y la activa paralelización.
Desventajas
La arquitectura de la tabla hash tiene varios problemas que se deben tener en cuenta:
- La sonda lineal se ve obstaculizada por la clústerización, lo que hace que las claves en la tabla no se coloquen de manera óptima.
- Las claves no se eliminan mediante la función
deletey con el tiempo saturan la tabla.
Como resultado, el rendimiento de la tabla hash puede disminuir gradualmente, especialmente si existe durante mucho tiempo y se realizan numerosas inserciones y eliminaciones. Una forma de mitigar estas desventajas es la rehashing en una nueva tabla con un coeficiente de utilización suficientemente bajo y filtrando las claves eliminadas al realizar el rehashing.
Para ilustrar los problemas descritos, utilizo el código anterior para crear una tabla de 128 millones de elementos, insertando cíclicamente 4 millones de elementos hasta llenar 124 millones de espacios (coeficiente de utilización de alrededor de 0.96). Aquí están los resultados, cada fila es una llamada al núcleo CUDA con la inserción de 4 millones de nuevos elementos en una tabla hash:
Coeficiente de utilización
Duración de la inserción de 4 194 304 elementos
0,00
11,608448 ms (361,314798 millones de claves/seg.)
0,03
11,751424 ms (356,918799 millones de claves/seg.)
0,06
11,942592 ms (351,205515 millones de claves/seg.)
0,09
12,081120 ms (347,178429 millones de claves/seg.)
0,12
12,242560 ms (342,600233 millones de claves/seg.)
0,16
12,396448 ms (338,347235 millones de claves/seg.)
0,19
12,533024 ms (334,660176 millones de claves/seg.)
0,22
12,703328 ms (330,173626 millones de claves/seg.)
0,25
12,884512 ms (325,530693 millones de claves/seg.)
0,28
13,033472 ms (321,810182 millones de claves/seg.)
0,31
13,239296 ms (316,807174 millones de claves/seg.)
0,34
13,392448 ms (313,184256 millones de claves/seg.)
0,37
13,624000 ms (307,861434 millones de claves/seg.)
0,41
13,875520 ms (302,280855 millones de claves/seg.)
0,44
14,126528 ms (296,909756 millones de claves/seg.)
0,47
14,399328 ms (291,284699 millones de claves/seg.)
0,50
14,690304 ms (285,515123 millones de claves/seg.)
0,53
15,039136 ms (278,892623 millones de claves/seg.)
0,56
15,478656 ms (270,973402 millones de claves/seg.)
0,59
15,985664 ms (262,379092 millones de claves/seg.)
0,62
16,668673 ms (251,627968 millones de claves/seg.)
0,66
17,587200 ms (238,486174 millones de claves/seg.)
0,69
18,690048 ms (224,413765 millones de claves/seg.)
0,72
20,278816 ms (206,831789 millones de claves/seg.)
0,75
22,545408 ms (186,038058 millones de claves/seg.)
0,78
26,053312 ms (160,989275 millones de claves/seg.)
0,81
31,895008 ms (131,503463 millones de claves/seg.)
0,84
42,103294 ms (99,619378 millones de claves/seg.)
0,87
61,849056 ms (67,815164 millones de claves/seg.)
0,90
105,695999 ms (39,682713 millones de claves/seg.)
0,94
240,204636 ms (17,461378 millones de claves/seg.)
A medida que aumenta el coeficiente de utilización, el rendimiento disminuye. Esto no es deseable en la mayoría de los casos. Si la aplicación inserta elementos en la tabla y luego los descarta (por ejemplo, al contar palabras en un libro), no es un problema. Pero si la aplicación utiliza una tabla hash de larga duración (por ejemplo, en un editor gráfico para almacenar partes no vacías de imágenes, cuando el usuario inserta y elimina información con frecuencia), este comportamiento puede ser problemático.
Y medí la profundidad de sondeo de la tabla hash después de 64 millones de inserciones (coeficiente de utilización 0,5). La profundidad media fue de 0,4774, por lo que la mayoría de las claves estaban en el mejor de los espacios posibles, o en un espacio de la mejor posición. La profundidad máxima de sondeo fue de 60.
Luego medí la profundidad de sondeo en la tabla con 124 millones de inserciones (coeficiente de utilización 0,97). La profundidad media ya fue de 10,1757, y la máxima fue 6474 (!!). El rendimiento del sondeo lineal disminuye drásticamente con grandes coeficientes de utilización.
Es mejor mantener un bajo factor de utilización para esta tabla hash. Pero esto aumenta el rendimiento a expensas del consumo de memoria. Afortunadamente, en el caso de claves y valores de 32 bits, esto puede justificarse. Si en el ejemplo anterior se mantiene un factor de utilización de 0.25 en una tabla con 128 millones de elementos, solo podremos almacenar hasta 32 millones de elementos, y los otros 96 millones de espacios estarán desperdiciados, perdiendo 768 MB de memoria, ya que cada par ocupa 8 bytes.
Ten en cuenta que estamos hablando de la pérdida de memoria de la tarjeta gráfica, que es un recurso más valioso que la memoria del sistema. Aunque la mayoría de las tarjetas gráficas de escritorio modernas que admiten CUDA tienen al menos 4 GB de memoria (en el momento de escribir este artículo, la NVIDIA 2080 Ti tiene 11 GB), perder tal cantidad no sería la mejor decisión.
Más adelante escribiré con más detalle sobre la creación de tablas hash para tarjetas gráficas que no tienen problemas de profundidad de sondeo, así como sobre métodos para reutilizar espacios eliminados.
Medición de la profundidad de sondeo
Para determinar la profundidad de sondeo de una clave, podemos extraer el hash de la clave (su índice ideal en la tabla) de su índice real en la tabla:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Debido a la magia de dos números binarios en complemento a dos y al hecho de que la capacidad de la tabla hash es una potencia de dos, este enfoque funcionará incluso cuando el índice de la clave se desplace hacia el comienzo de la tabla. Tomemos una clave que se hash en 1, pero se inserta en el espacio 3. Entonces, para una tabla con capacidad 4, obtendremos (3 - 1) & 3, que es equivalente a 2.
Conclusión
Si tienes preguntas o comentarios, escríbeme en o abre un nuevo tema en.
Este código está inspirado en los maravillosos artículos:
En el futuro continuaré escribiendo sobre implementaciones de tablas hash para tarjetas gráficas y analizaré su rendimiento. Tengo planes de explorar encadenamiento, hash de Robin Hood y hash de Cuckoo utilizando operaciones atómicas en estructuras de datos amigables para las tarjetas gráficas.
Fuente: habr.com
