

Esta publicación se escribe porque nuestros empleados han tenido muchas conversaciones con clientes sobre el desarrollo de aplicaciones en Kubernetes y las particularidades de dicho desarrollo en OpenShift.
Normalmente comenzamos con la tesis de que Kubernetes es simplemente Kubernetes, mientras que OpenShift es ya una plataforma Kubernetes, como Microsoft AKS o Amazon EKS. Cada una de estas plataformas tiene sus ventajas, orientadas a un público objetivo específico. Después de esto, la conversación fluye hacia la comparación de las fortalezas y debilidades de plataformas concretas.
En general, pensamos en escribir esta publicación con una conclusión como: 'Escuchen, realmente da igual dónde ejecutar el código, en OpenShift, AKS, EKS, en algún Kubernetes personalizado, sí, en cualquier Kubernetes' (para abreviar, llamémoslo KUK) – es realmente fácil, en ambos casos.
Luego planeamos tomar un sencillo 'Hola Mundo' y, a través de su ejemplo, mostrar qué tienen en común y en qué se diferencian KUK y Red Hat OpenShift Container Platform (en adelante, OCP o simplemente OpenShift).
Sin embargo, a medida que escribíamos esta publicación, nos dimos cuenta de que nos hemos acostumbrado tanto a usar OpenShift que simplemente no nos damos cuenta de cómo ha crecido y se ha convertido en una plataforma impresionante, que es mucho más que un simple distribuidor de Kubernetes. Hemos llegado a considerar la madurez y simplicidad de OpenShift como un hecho, pasando por alto su grandeza.
En general, ha llegado el momento de un arrepentimiento activo, y ahora compararemos paso a paso la implementación de nuestro 'Hola Mundo' en KUK y en OpenShift, y lo haremos de la manera más objetiva posible (bueno, tal vez alguna vez manifestando nuestra opinión personal sobre el tema). Si te interesa una opinión puramente subjetiva al respecto, puedes leerla . En esta publicación nos ceñiremos a los hechos y solo a los hechos.
Clústeres
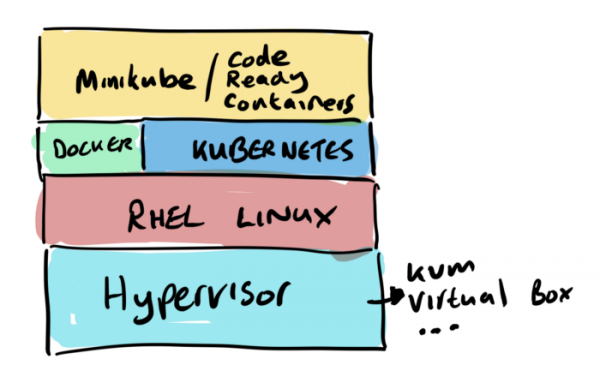
Así que, para nuestro 'Hola Mundo' necesitamos clústeres. Desde un principio diremos que 'no' a nubes públicas, para no tener que pagar por servidores, registros, redes, transferencia de datos, etc. Por lo tanto, optamos por un sencillo clúster de un solo nodo en (para KUK) y (para el clúster OpenShift). Ambas opciones son realmente fáciles de instalar, pero requerirán bastantes recursos en tu portátil.
Construcción en KUK
Así que, ¡empecemos!
Paso 1 – construimos nuestra imagen de contenedor
Comenzaré desplegando nuestro 'Hola Mundo' en minikube. Para esto necesitaremos:
- 1. Docker instalado.
- 2. Git instalado.
- 3. Maven instalado (en este proyecto se utiliza el binario mvnw, por lo que no es necesario).
- 4. En realidad, el código fuente, es decir, un clon del repositorio
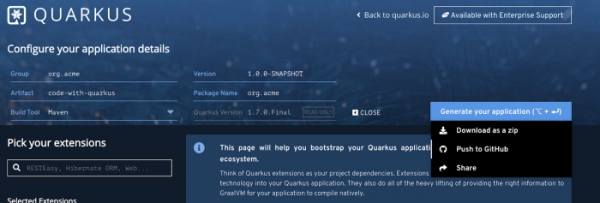
Primero, hay que crear un proyecto Quarkus. No se asusten si nunca han trabajado con el sitio Quarkus.io: es fácil. Simplemente eligen los componentes que desean usar en el proyecto (RestEasy, Hibernate, Amazon SQS, Camel, etc.), y luego Quarkus se encarga de configurar automáticamente el arquetipo de Maven y subir todo a GitHub. Es decir, literalmente, un solo clic del mouse y está listo. Por eso amamos Quarkus.
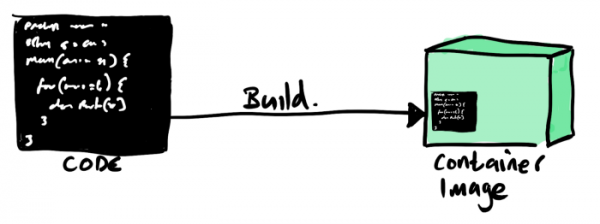
La forma más simple de construir nuestro 'Hello World' en una imagen de contenedor es usar la extensión quarkus-maven para Docker, que hace todo el trabajo necesario. Con la llegada de Quarkus, esto se ha vuelto muy fácil y sencillo: solo añaden la extensión container-image-docker y pueden crear imágenes con comandos de Maven.
./mvnw quarkus:add-extension -Dextensions="container-image-docker"
Y, finalmente, construimos nuestra imagen usando Maven. Como resultado, nuestro código fuente se convierte en una imagen de contenedor lista para ser ejecutada en un entorno de contenedores.
./mvnw -X clean package -Dquarkus.container-image.build=true
Eso es todo, ahora se puede ejecutar el contenedor con el comando docker run, mapeando nuestro servicio al puerto 8080 para poder acceder a él.
docker run -i --rm -p 8080:8080 gcolman/quarkus-hello-world
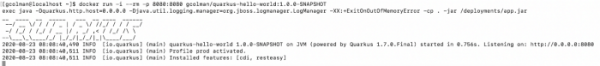
Después de que la instancia del contenedor se haya iniciado, solo queda verificar con el comando curl que nuestro servicio esté funcionando:

Así que, todo funciona, y realmente fue fácil y sencillo.
Paso 2 – enviamos nuestro contenedor al repositorio de imágenes de contenedores
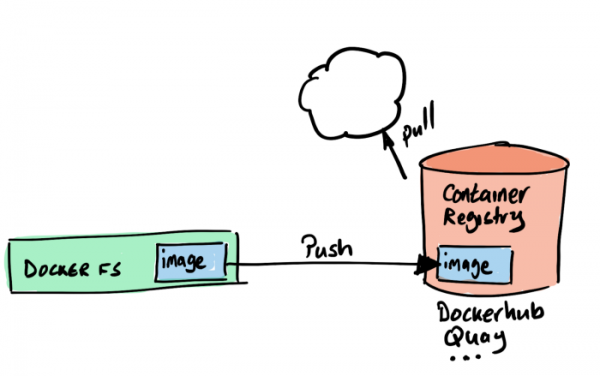
Hasta ahora, la imagen que hemos creado se almacena localmente, en nuestro almacenamiento local de contenedores. Si queremos usar esta imagen en nuestro entorno de Kubernetes, debemos subirla a otro repositorio. Kubernetes no tiene estas funciones, por eso utilizaremos Docker Hub. Porque, en primer lugar, es gratuito, y en segundo lugar, (casi) todos lo hacen.
Esto también es muy simple, y solo se necesita tener una cuenta en Docker Hub.
Así que, subimos a Docker Hub y enviamos nuestra imagen allí.
Paso 3 – iniciamos Kubernetes
Hay muchas formas de construir la configuración de Kubernetes para ejecutar nuestro 'Hello World', pero usaremos la más simple, ya que así somos.
Primero, iniciamos el clúster minikube:
minikube start
Paso 4 – desplegamos nuestra imagen de contenedor
Ahora necesitamos convertir nuestro código y la imagen del contenedor en configuraciones de Kubernetes. En otras palabras, necesitamos una definición de pod y deployment que apunte a nuestra imagen en Docker Hub. Una de las formas más sencillas de hacerlo es ejecutar el comando create deployment, especificando nuestra imagen:
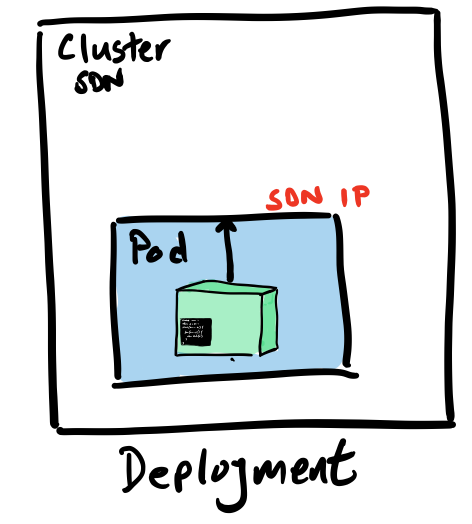
kubectl create deployment hello-quarkus --image=gcolman/quarkus-hello-world:1.0.0-SNAPSHOT
Con este comando le hemos dicho a Kubernetes que cree una configuración de deployment, que debe contener la especificación del pod para nuestra imagen de contenedor. Este comando también aplicará esta configuración a nuestro clúster minikube y creará un deployment que descargará nuestra imagen de contenedor y ejecutará el pod en el clúster.
Paso 5 – abrimos el acceso a nuestro servicio
Ahora que tenemos nuestro contenedor desplegado, es hora de pensar cómo configurar el acceso externo a este servicio RESTful, que en realidad está programado en nuestro código.
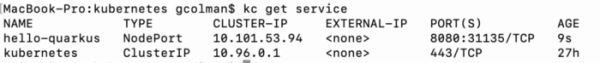
Hay muchas maneras de hacerlo. Por ejemplo, podemos usar el comando expose para crear automáticamente los componentes de Kubernetes correspondientes, como services y endpoints. De hecho, así lo haremos, ejecutando el comando expose para nuestro objeto de deployment:
kubectl expose deployment hello-quarkus --type=NodePort --port=8080
Detengámonos un momento en la opción ' --type' del comando expose.
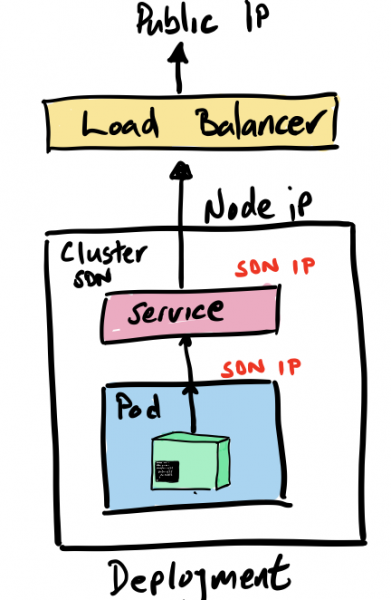
Cuando hacemos un expose y creamos los componentes necesarios para ejecutar nuestro servicio, entre otras cosas, necesitamos que se pueda conectar externamente al servicio hello-quarkus, que está dentro de nuestra red definida por software. Y el parámetro tipo nos permite crear y conectar elementos como balanceadores de carga para enrutar el tráfico a esta red.
Por ejemplo, al especificar type=LoadBalancer, automáticamente inicializamos un balanceador de carga en la nube pública para conectarnos a nuestro clúster de Kubernetes. Esto, por supuesto, es fantástico, pero hay que entender que tal configuración estará estrechamente vinculada a una nube pública específica y será más difícil de trasladar entre instancias de Kubernetes en diferentes entornos.
En nuestro ejemplo type=NodePort, es decir, la conexión a nuestro servicio se realiza a través de la dirección IP del nodo y el número del puerto. Esta opción permite no utilizar ninguna nube pública, pero requiere una serie de pasos adicionales. Primero, necesitamos nuestro propio equilibrador de carga, por lo que desplegaremos un equilibrador de carga NGINX en nuestro clúster.
Paso 6 – Instalamos el equilibrador de carga
Minikube tiene una serie de funciones de plataforma que facilitan la creación de los componentes necesarios para el acceso externo, como los controladores de ingreso. Minikube viene con un controlador de ingreso Nginx, y solo necesitamos activarlo y configurarlo.
minikube addons enable ingress
Ahora, con un solo comando, crearé el controlador de ingreso Nginx, que funcionará dentro de nuestro clúster minikube:
ingress-nginx-controller-69ccf5d9d8-j5gs9 1/1 En ejecución 1 33m
Paso 7 – Configuramos el ingreso
Ahora necesitamos configurar el controlador de ingreso Nginx para que reconozca las solicitudes hello-quarkus.
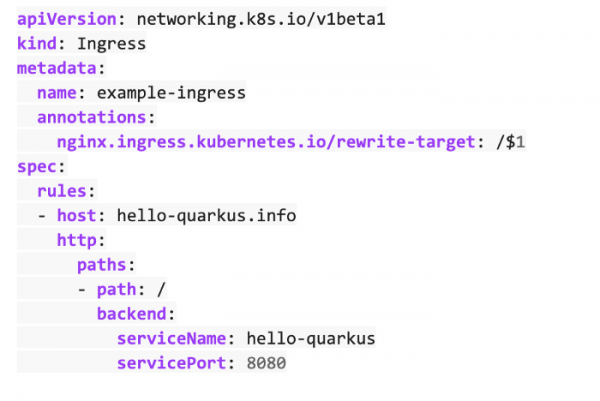
Y, por último, necesitamos aplicar esta configuración.
kubectl apply -f ingress.yml

Dado que estamos haciendo todo esto en nuestra computadora, simplemente añadimos la dirección IP de nuestro nodo al archivo /etc/hosts para dirigir las solicitudes http a nuestro minikube en el equilibrador de carga NGINX.
192.168.99.100 hello-quarkus.info
Listo, ahora nuestro servicio minikube está disponible externamente a través del controlador de ingreso Nginx.
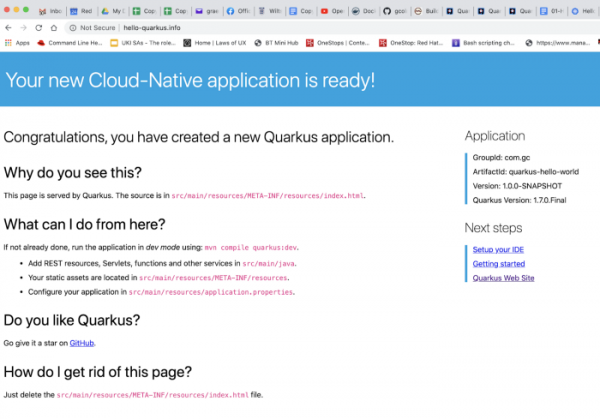
Bueno, eso fue fácil, ¿verdad? ¿O no tanto?
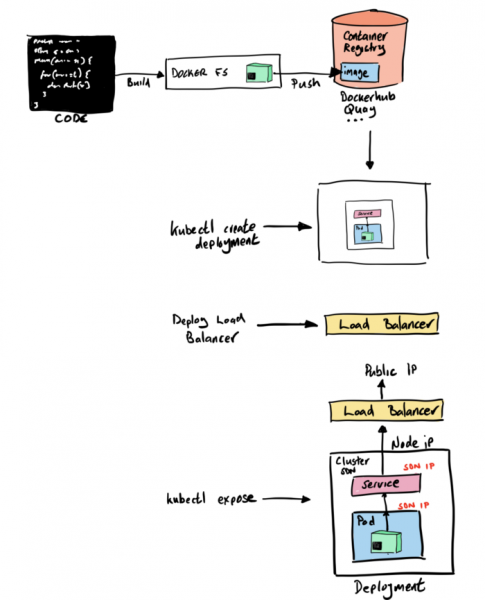
Ejecutando en OpenShift (Code Ready Containers)
Ahora veamos cómo se hace todo esto en la Red Hat OpenShift Container Platform (OCP).
Al igual que con minikube, elegimos la opción de clúster de un solo nodo en OpenShift en forma de Code Ready Containers (CRC). Anteriormente se conocía como minishift y se basaba en el proyecto OpenShift Origin, y ahora es CRC y está construido sobre la Red Hat OpenShift Container Platform.
Aquí, disculpen, no podemos evitar decir: “¡OpenShift es maravilloso!”
Inicialmente pensamos en escribir que el desarrollo en OpenShift no es diferente del desarrollo en Kubernetes. Y en esencia, así es. Pero al escribir este post, recordamos cuántos pasos adicionales hay que dar cuando no tienes OpenShift, y por eso, lo repito, es maravilloso. Nos encanta cuando todo es fácil, y la forma en que nuestro ejemplo se despliega y se ejecuta en OpenShift, en comparación con minikube, es lo que nos motivó a escribir este post.
Vamos a recorrer el proceso y ver qué necesitamos hacer.
Así que, en el ejemplo de minikube comenzamos con Docker… Espera, ya no necesitamos que Docker esté instalado en la máquina.
Y no necesitamos git local.
Tampoco necesitamos Maven.
Y no hay necesidad de crear manualmente la imagen del contenedor.
Y no hay necesidad de buscar algún repositorio de imágenes de contenedores.
Y tampoco hay que instalar un controlador de ingreso.
Y tampoco hay que configurar el ingreso.
¿Lo entienden, verdad? Para desplegar y ejecutar nuestra aplicación en OpenShift, no es necesario nada de lo mencionado anteriormente. Y el proceso es el siguiente.
Paso 1 – Iniciamos nuestro clúster OpenShift
Utilizamos Code Ready Containers de Red Hat, que es esencialmente lo mismo que Minikube, pero con un clúster OpenShift de un solo nodo completo.
crc start
Paso 2 – Realizamos la construcción y despliegue de la aplicación en el clúster OpenShift
En este paso, la simplicidad y comodidad de OpenShift se manifiestan en todo su esplendor. Al igual que en todas las distribuciones de Kubernetes, tenemos muchas formas de iniciar una aplicación en el clúster. Y, como en el caso de KUK, elegimos deliberadamente la opción más simple.
OpenShift siempre se ha construido como una plataforma para crear y ejecutar aplicaciones en contenedores. La construcción de contenedores siempre ha sido una parte integral de esta plataforma, por lo que aquí hay un montón de recursos adicionales de Kubernetes para las tareas correspondientes.
Utilizaremos el proceso Source 2 Image (S2I) de OpenShift, que tiene varias formas de tomar nuestro código fuente (código o archivos binarios) y convertirlo en una imagen de contenedor que se ejecuta en el clúster OpenShift.
Para esto, necesitaremos dos cosas:
- Nuestro código fuente en un repositorio git
- Una imagen Builder, a partir de la cual se llevará a cabo la construcción.
Existen muchas de estas imágenes, respaldadas tanto por Red Hat como a nivel comunitario, y utilizaremos la imagen de OpenJDK, ya que estoy construyendo una aplicación Java.
Se puede iniciar la construcción S2I tanto desde la consola gráfica del OpenShift Developer como desde la línea de comandos. Usaremos el comando new-app, especificándole de dónde obtener la imagen builder y nuestro código fuente.
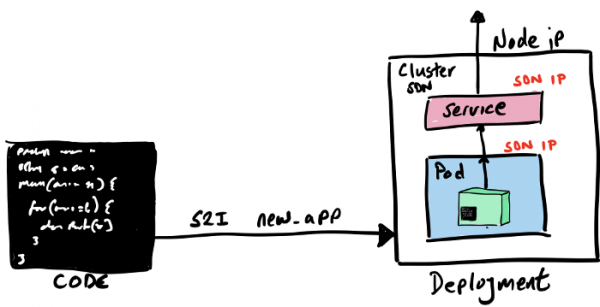
oc new-app registry.access.redhat.com/ubi8/openjdk-11:latest~https://github.com/gcolman/quarkus-hello-world.git
Listo, nuestra aplicación ha sido creada. Durante este proceso, S2I realizó las siguientes acciones:
- Creó un pod de construcción auxiliar para todas las cosas relacionadas con la construcción de la aplicación.
- Creó una configuración de OpenShift Build.
- Descargó la imagen builder en el registro docker interno de OpenShift.
- Clonó 'Hello World' en el repositorio local.
- Vi una maven pom allí, por lo que compilé la aplicación utilizando maven.
- Creé una nueva imagen de contenedor que contiene la aplicación Java compilada y la coloqué en el registro interno de contenedores.
- Creé un Deployment de Kubernetes con las especificaciones del pod, del servicio, etc.
- Lancé el despliegue de la imagen del contenedor.
- Eliminé el pod de build temporal.
Hay muchas cosas en esta lista, pero lo principal es que toda la construcción ocurre exclusivamente dentro de OpenShift, el registro de Docker interno está dentro de OpenShift, y el proceso de construcción crea todos los componentes de Kubernetes y los ejecuta en el clúster.
Si se sigue visualmente el lanzamiento de S2I en la consola, se puede ver cómo al realizar la construcción se inicia el pod de build.
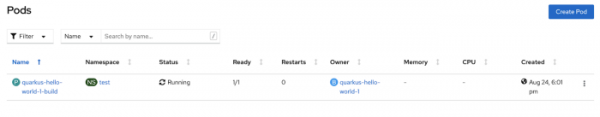
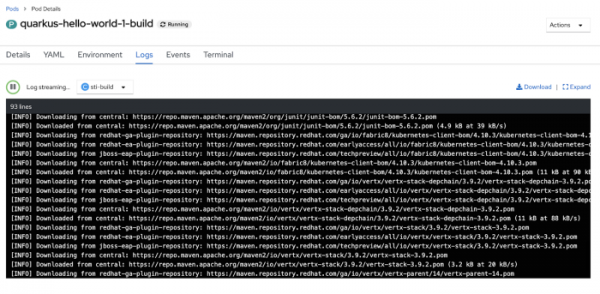
Ahora echemos un vistazo a los registros del pod de builder: en primer lugar, se puede ver cómo maven realiza su trabajo y descarga las dependencias para construir nuestra aplicación java.
Después de que se complete la construcción con maven, se inicia la construcción de la imagen del contenedor, y luego esta imagen construida se envía al repositorio interno.
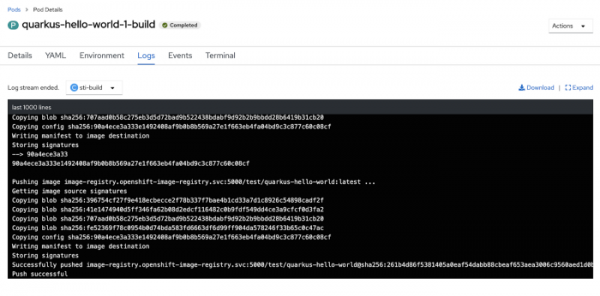
Todo, el proceso de construcción ha terminado. Ahora asegurémonos de que los pods y servicios de nuestra aplicación están en funcionamiento en el clúster.
oc get service
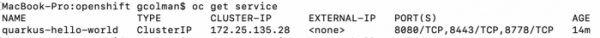
Eso es todo. Y solo un comando. Solo nos queda exponer este servicio para acceso externo.
Paso 3 - exponer el servicio para acceso externo
Al igual que en el caso de KUK, en la plataforma OpenShift, nuestra «Hello World» también necesita un enrutador para dirigir el tráfico externo hacia el servicio dentro del clúster. En OpenShift, esto es muy sencillo. Primero, el componente de enrutamiento HAProxy está instalado de forma predeterminada en el clúster (puede ser cambiado por el mismo NGINX). En segundo lugar, hay recursos especiales y altamente configurables que se llaman Routes y recuerdan a los objetos Ingress en el viejo Kubernetes (de hecho, las Routes de OpenShift influyeron en el diseño de los objetos Ingress, que ahora también se pueden usar en OpenShift), pero para nuestro «Hello World», y en casi todos los demás casos, nos será suficiente con el Route estándar sin configuración adicional.
Para crear un FQDN enrutado para «Hello World» (sí, en OpenShift hay su propio DNS para enrutamiento por nombres de servicio), simplemente ejecutaremos el expose para nuestro servicio:
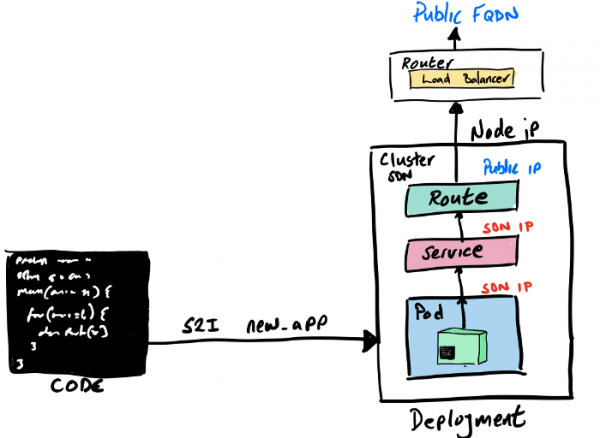
oc expose service quarkus-hello-world
Si miramos el Route recién creado, podemos encontrar el FQDN y otra información sobre el enrutamiento:
oc get route

Y finalmente, accedemos a nuestro servicio desde el navegador:
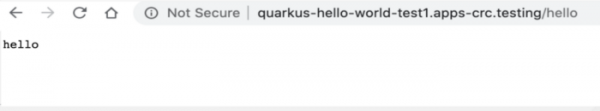
¡Ahora sí, esto fue realmente fácil!
Amamos Kubernetes y todo lo que esta tecnología permite hacer, así como apreciamos la simplicidad y la facilidad. Kubernetes fue diseñado para simplificar increíblemente la operación de contenedores distribuidos y escalables, pero hoy en día su simplicidad ya no es suficiente para implementar aplicaciones. Aquí es donde entra en juego OpenShift, que se mantiene al día y ofrece un Kubernetes orientado principalmente al desarrollador. Se han realizado enormes esfuerzos para adaptar la plataforma OpenShift precisamente para los desarrolladores, incluyendo la creación de herramientas como S2I, ODI, Developer Portal, OpenShift Operator Framework, integración con IDE, catálogos para desarrolladores, integración con Helm, monitoreo y muchas otras.
Esperamos que este artículo haya sido interesante y útil para usted. Puede encontrar recursos adicionales, materiales y otros elementos útiles para el desarrollo en la plataforma OpenShift en el portal .
Fuente: habr.com
