

Es realmente interesante observar el protocolo QUIC, por lo que nos encanta escribir sobre él. Sin embargo, si las publicaciones anteriores sobre QUIC tenían un carácter más histórico (si se quiere, patrimonial) y técnico, hoy estamos encantados de publicar una traducción diferente: se tratará de la aplicación real del protocolo en 2019. Y no se trata de una pequeña infraestructura basada en un garaje, sino de Uber, que opera en casi todo el mundo. Cómo los ingenieros de la empresa decidieron usar QUIC en producción, cómo realizaron pruebas y lo que observaron después de la implementación en producción, se detallará a continuación.
Las imágenes son clicables. ¡Disfruta la lectura!
Uber es de escala mundial, específicamente en 600 ciudades, en cada una de las cuales la aplicación depende completamente de Internet inalámbrico de más de 4,500 operadores de telefonía móvil. Los usuarios esperan que la aplicación no solo funcione rápido, sino en tiempo real. Para garantizar esto, la aplicación de Uber necesita baja latencia y una conexión muy confiable. Sin embargo, la pila se comporta mal en redes inalámbricas dinámicas y propensas a pérdidas. Nos dimos cuenta de que en este caso, el bajo rendimiento estaba directamente relacionado con las implementaciones de TCP en los núcleos de los sistemas operativos.
Para resolver el problema, aplicamos , un protocolo moderno con multiplexión de canales, que nos da más control sobre el rendimiento del protocolo de transporte. Actualmente, el grupo de trabajo está estandarizando QUIC como .
Después de pruebas detalladas, llegamos a la conclusión de que la implementación de QUIC en nuestra aplicación reduciría las latencias "de cola" en comparación con TCP. Observamos una disminución en el rango del 10-30% para el tráfico HTTPS en el caso de las aplicaciones de conductores y pasajeros. Además, QUIC nos proporcionó control total sobre los paquetes de los usuarios.
En este artículo compartimos nuestra experiencia en la optimización de TCP para las aplicaciones de Uber utilizando una pila que admite QUIC.
La última palabra en tecnología: TCP
Hoy en día, TCP es el protocolo de transporte más utilizado para la entrega de tráfico HTTPS en Internet. TCP garantiza un flujo confiable de bytes, gestionando así la congestión de la red y las pérdidas a nivel de enlace. El amplio uso de TCP para el tráfico HTTPS se explica por la omnipresencia del primero (casi todos los sistemas operativos incluyen TCP), su disponibilidad en gran parte de la infraestructura (por ejemplo, en balanceadores de carga, proxies HTTPS y CDN) y la funcionalidad "listo para usar" que está disponible en casi la mayoría de plataformas y redes.
La mayoría de los usuarios utilizan nuestra aplicación en movimiento, y las "retrasos de cola" de TCP estaban lejos de satisfacer las demandas de nuestro tráfico HTTPS en tiempo real. En pocas palabras, esto lo experimentaron usuarios de todo el mundo; en la Figura 1 se reflejan los retrasos en las principales ciudades:
Figura 1. La magnitud de los "retrasos de cola" varía en las principales ciudades donde Uber tiene presencia.
A pesar de que los retrasos en las redes de India y Brasil fueron mayores que en EE. UU. y el Reino Unido, los retrasos de cola son significativamente más altos que los retrasos promedio. Y esto es así incluso para EE. UU. y el Reino Unido.
El rendimiento de TCP en el aire
TCP fue diseñado para redes alámbricas, es decir, con un enfoque en enlaces bien predecibles. Sin embargo, las redes inalámbricas tienen sus propias peculiaridades y desafíos. En primer lugar, las redes inalámbricas son sensibles a las pérdidas por interferencias y desvanecimiento de la señal. Por ejemplo, las redes Wi-Fi son sensibles a los microondas, Bluetooth y otras ondas de radio. Las redes celulares sufren pérdidas de señal ( pérdida de trayectoria ) debido a la reflexión / absorción de la señal por objetos y edificaciones, así como porde torres celulares vecinas. Esto resulta en demoras circulares (RTT) más significativas (de 4 a 10 veces) y variadas, así como en pérdidas de paquetes en comparación con una conexión alámbrica. bufferización de red excesiva, hinchazón del búfer problema muy grave y es un problema muy
serio. (), y esto es muy de Internet moderno.
Finalmente, el rendimiento de la red celular varía según el operador, la región y el momento. En la Figura 2, recopilamos las latencias medianas del tráfico HTTPS en celdas a una distancia de 2 kilómetros. Los datos fueron recolectados de los dos principales operadores de telefonía móvil en Delhi, India. Como se puede observar, el rendimiento varía de una celda a otra. Además, el rendimiento de un operador difiere del rendimiento del segundo. Esto se ve afectado por factores como los patrones de acceso a la red en función del tiempo y la ubicación, la movilidad de los usuarios, así como la infraestructura de red considerando la densidad de torres y la proporción de tipos de red (LTE, 3G, etc.).
Figura 2. Latencias en un radio de 2 kilómetros. Delhi, India.
El rendimiento de las redes celulares también varía con el tiempo. En la Figura 3 se muestra la latencia mediana por días de la semana. También observamos diferencias en una escala más pequeña: dentro de un mismo día y hora.
Figura 3. Las latencias pueden variar significativamente en diferentes días, pero con el mismo operador.
Todo lo anterior lleva a que el rendimiento de TCP sea ineficaz en las redes inalámbricas. Sin embargo, antes de buscar alternativas a TCP, queríamos desarrollar una comprensión precisa sobre los siguientes puntos:
- ¿Es TCP el principal culpable de las latencias en nuestras aplicaciones?
- ¿Tienen las redes modernas retrasos circulares (RTT) significativos y variados?
- ¿Cuál es el impacto del RTT y de las pérdidas en el rendimiento de TCP?
Análisis del rendimiento de TCP
Para entender cómo analizamos el rendimiento de TCP, recordemos brevemente cómo TCP transmite datos del remitente al receptor. Primero, el remitente establece una conexión TCP mediante un proceso de tres vías. : el remitente envía un paquete SYN, espera un paquete SYN-ACK del receptor y luego envía un paquete ACK. Pasos adicionales de la segunda y tercera fase son necesarios para establecer la conexión TCP. El receptor confirma la recepción de cada paquete (ACK) para garantizar una entrega confiable.
Si se pierde un paquete o un ACK, el remitente retransmite después de un tiempo de espera (RTO, ). El RTO se calcula dinámicamente, basado en diferentes factores, como la latencia RTT esperada entre el remitente y el receptor.
Figura 4. El intercambio de paquetes a través de TCP/TLS incluye mecanismos de retransmisión.
Para determinar cómo funcionaba TCP en nuestras aplicaciones, rastreamos paquetes TCP con durante una semana en el tráfico en vivo proveniente de servidores fronterizos indios. Luego analizamos las conexiones TCP utilizando . Además, creamos una aplicación para Android que envía tráfico simulado a un servidor de prueba, imitando al máximo el tráfico real. Los smartphones con esta aplicación fueron distribuidos a varios empleados, quienes recogieron registros durante varios días.
Los resultados de ambos experimentos fueron coherentes entre sí. Observamos altas latencias RTT; los valores extremos eran casi 6 veces mayores que la mediana; el promedio de las latencias fue de más de 1 segundo. Muchas conexiones tuvieron pérdidas, lo que hizo que TCP retransmitiera el 3,5% de todos los paquetes. En áreas con congestión, como aeropuertos y estaciones, observamos pérdidas del 7%. Estos resultados ponen en duda la noción común de que los reducen significativamente las pérdidas a nivel de transporte. A continuación se presentan los resultados de las pruebas de la aplicación simuladora:
Métricas de red
Valores
RTT, milisegundos [50%, 75%, 95%, 99%]
[350, 425, 725, 2300]
Desviación RTT, segundos
En promedio ~1,2 s
Pérdida de paquetes en conexiones inestables
En promedio ~3.5% (7% en áreas con congestión)
Casi la mitad de estas conexiones presentaron al menos una pérdida de paquetes, siendo en su mayoría paquetes SYN y SYN-ACK. La mayoría de las implementaciones de TCP utilizan un valor RTO de 1 segundo para los paquetes SYN, que incrementa exponencialmente para las pérdidas subsiguientes. El tiempo de carga de la aplicación puede aumentar debido a que TCP necesita más tiempo para establecer conexiones.
En el caso de los paquetes de datos, altos valores de RTO reducen significativamente la utilización útil de la red en presencia de pérdidas temporales en redes inalámbricas. Descubrimos que el tiempo promedio de retransmisión es de aproximadamente 1 segundo con una latencia extrema de casi 30 segundos. Estas altas latencias a nivel de TCP provocaron timeouts de HTTPS y reenvíos de solicitudes, lo que aumentó aún más la latencia y la ineficiencia de la red.
Mientras que el percentil 75 del RTT medido estuvo alrededor de 425 ms, el percentil 75 para TCP fue de casi 3 segundos. Esto sugiere que las pérdidas obligaron a TCP a realizar entre 7 y 10 intentos para transmitir los datos con éxito. Esto puede ser consecuencia de un cálculo ineficiente de RTO, o la incapacidad de TCP para reaccionar rápidamente a las pérdidas. en la ventana y la ineficacia del algoritmo de control de congestión que no distingue entre pérdidas inalámbricas y pérdidas por congestión de red. A continuación, se presentan los resultados de las pruebas de pérdida de TCP:
Estadísticas de pérdida de paquetes TCP
Valor
Porcentaje de conexiones con al menos 1 pérdida de paquete
45%
Porcentaje de conexiones con pérdidas durante el establecimiento de la conexión
30%
Porcentaje de conexiones con pérdidas durante la transmisión de datos
76%
Distribución de latencias en la retransmisión, segundos [50%, 75%, 95%, 99%]
[1, 2.8, 15, 28]
Distribución del número de retransmisiones para un paquete o segmento TCP
[1,3,6,7]
Implementación de QUIC
Diseñado originalmente por Google, QUIC es un protocolo de transporte moderno y multiprotocolar que funciona sobre UDP. Actualmente, QUIC está (ya hemos mencionado que existen dos versiones de QUIC, los curiosos – nota del traductor). Como se muestra en la Figura 5, QUIC se sitúa sobre HTTP/3 (de hecho, HTTP/2 sobre QUIC es HTTP/3, que ahora se está estandarizando activamente). Este reemplaza parcialmente las capas de HTTPS y TCP, utilizando UDP para formar paquetes. QUIC solo admite la transmisión segura de datos, ya que TLS está completamente integrado en QUIC.
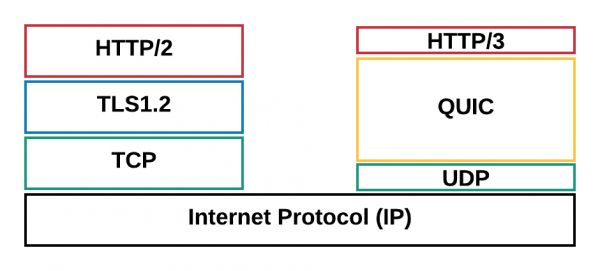
Figura 5: QUIC funciona sobre HTTP/3, reemplazando a TLS, que antes funcionaba sobre HTTP/2.
A continuación, enumeramos las razones que nos convencieron para utilizar QUIC y mejorar TCP:
- Establecimiento de conexión 0-RTT. QUIC permite la reutilización de autorizaciones de conexiones anteriores, reduciendo el número de handshakes de seguridad. En el futuro, admitirá 0-RTT, sin embargo, el handshake TCP de tres vías seguirá siendo obligatorio.
- superar el bloqueo por HoL. HTTP/2 utiliza una sola conexión TCP para cada cliente para mejorar el rendimiento, pero esto puede llevar al bloqueo HoL (head-of-line). QUIC simplifica el multiplexado y entrega las solicitudes a la aplicación de forma independiente entre sí.
- control de congestión. QUIC opera a nivel de aplicación, lo que permite actualizar más fácilmente el algoritmo de transporte principal que gestiona el envío, basándose en los parámetros de la red (cantidad de pérdidas o RTT). La mayoría de las implementaciones de TCP utilizan el algoritmo , que no es óptimo para el tráfico sensible a la latencia. Algoritmos recientemente desarrollados como modelan de manera más precisa la red y optimizan las latencias. QUIC permite utilizar BBR y actualizar este algoritmo a medida que su .
- la recuperación de pérdidas. QUIC provoca dos TLP () antes de que se active el RTO, incluso cuando las pérdidas son muy significativas. Esto difiere de las implementaciones de TCP. TLP retransmite principalmente el último paquete (o uno nuevo, si existe) para iniciar una recuperación rápida. El manejo de las retrasos terminales es especialmente útil para cómo Uber interactúa con la red, es decir, para transmisiones de datos cortas, episódicas y sensibles a la latencia.
- ACK optimizado. Dado que cada paquete tiene un número de secuencia único, no existe el problema de los paquetes durante su retransmisión. Los paquetes ACK también contienen el tiempo para procesar el paquete y generar el ACK del lado del cliente. Estas características garantizan que QUIC calcula de manera más precisa el RTT. El ACK en QUIC admite hasta 256 rangos , ayudando al emisor a ser más resistente a la reordenación de paquetes y a utilizar menos bytes en el proceso. El ACK selectivo () en TCP no resuelve este problema en todos los casos.
- migración de conexión. Las conexiones QUIC se identifican mediante un ID de 64 bits, por lo que si el cliente cambia de direcciones IP, se puede seguir utilizando el ID de la conexión antigua en la nueva dirección IP, sin interrupciones. Esto es una práctica muy común para las aplicaciones móviles, cuando el usuario cambia entre conexiones Wi-Fi y de datos móviles.
Alternativas a QUIC
Hemos considerado enfoques alternativos para resolver el problema antes de elegir QUIC.
Primero intentamos implementar TPC PoPs (Puntos de Presencia) para cerrar las conexiones TCP más cerca de los usuarios. Esencialmente, los PoPs cierran la conexión TCP con el dispositivo móvil más cerca de la red celular y enrutan el tráfico a la infraestructura original. Al cerrar TCP más cerca, potencialmente podemos reducir el RTT y asegurarnos de que TCP responda de manera más activa al entorno inalámbrico dinámico. Sin embargo, nuestros experimentos mostraron que, en gran medida, el RTT y las pérdidas provienen de las redes celulares y el uso de PoPs no proporciona una mejora significativa en el rendimiento.
También exploramos la optimización de los parámetros TCP. Ajustar el stack TCP en nuestros servidores de borde heterogéneos fue difícil, ya que TCP tiene implementaciones incomparables en diferentes versiones de SO. Fue complicado implementar y probar diferentes configuraciones de red. La configuración de TCP directamente en los dispositivos móviles era imposible debido a la falta de permisos. Lo que es aún más importante, características como las conexiones con 0-RTT y la mejora en la predicción del RTT son críticas para la arquitectura del protocolo y, por lo tanto, no se puede lograr una ventaja sustancial simplemente configurando TCP.
Finalmente, evaluamos varios protocolos basados en UDP que abordan fallos en la transmisión de video; queríamos saber si estos protocolos ayudarían en nuestro caso. Lamentablemente, carecían en gran medida de muchas configuraciones de seguridad y también requerían una conexión TCP adicional para metadatos y información de control.
Nuestra investigación mostró que QUIC es prácticamente el único protocolo que puede ayudar con el problema del tráfico de Internet, considerando tanto la seguridad como el rendimiento.
Integración de QUIC en la plataforma
Para integrar QUIC con éxito y mejorar el rendimiento de la aplicación en condiciones de mala conexión, reemplazamos la antigua pila (HTTP/2 sobre TLS/TCP) por el protocolo QUIC. Utilizamos la biblioteca de red de , que contiene la versión original del protocolo – gQUIC. Esta implementación también se mejora constantemente para seguir la última especificación de la IETF.
Primero, integramos Cronet en nuestras aplicaciones Android para agregar soporte para QUIC. La integración se realizó de tal forma que se minimizaron los costos de migración. En lugar de reemplazar completamente la antigua pila de red, que utilizaba la biblioteca , integramos Cronet BAJO el marco de la API de OkHttp. Al realizar la integración de esta manera, evitamos cambios en nuestras llamadas de red (que utilizan ) a nivel de API.
De manera similar al enfoque para dispositivos Android, implementamos Cronet en las aplicaciones de Uber para iOS, interceptando el tráfico HTTP de las , utilizando . Esta abstracción, proporcionada por iOS Foundation, maneja los datos URL específicos del protocolo y garantiza que podemos integrar Cronet en nuestras aplicaciones de iOS sin costos de migración significativos.
Terminación de QUIC en los balanceadores de carga de Google Cloud
En el lado del backend, la terminación de QUIC está garantizada por la infraestructura de Google Cloud Load Balancing, que utiliza Encabezados en las respuestas para soportar QUIC. En general, para cada solicitud HTTP, el balanceador añade un encabezado alt-svc y ya con eso valida el soporte de QUIC para el dominio. Cuando el cliente Cronet recibe una respuesta HTTP con tal encabezado, utiliza QUIC para las siguientes solicitudes HTTP a este dominio. Una vez que el balanceador termina QUIC, nuestra infraestructura envía explícitamente esta acción por HTTP2/TCP a nuestros centros de datos.
Rendimiento: resultados
El rendimiento emitido es la razón principal de nuestra búsqueda del mejor protocolo. Para comenzar, creamos un banco de pruebas con , para determinar cómo se comportará QUIC bajo diferentes perfiles de red. Para probar el funcionamiento de QUIC en redes reales, llevamos a cabo experimentos recorriendo Nueva Delhi mientras utilizábamos tráfico de red emulado, muy similar a las llamadas HTTP en la aplicación del pasajero.
Experimento 1
Inventario para el experimento:
- dispositivos de prueba en Android con pilas OkHttp y Cronet, para asegurarnos de que estamos enviando tráfico HTTPS por TCP y QUIC respectivamente;
- servidor de emulación basado en Java, que envía encabezados HTTPS homogéneos en las respuestas y carga los dispositivos cliente para recibir solicitudes de ellos;
- proxies en la nube, que están físicamente ubicados cerca de India, para finalizar conexiones TCP y QUIC. Mientras que para la finalización de TCP utilizamos un proxy inverso en , fue difícil encontrar un proxy inverso de código abierto para QUIC. Creamos un proxy inverso para QUIC nosotros mismos, usando la pila base de QUIC de Chromium y lo incluimos en Chromium como código abierto.
Figura 6. El conjunto de pruebas para TCP vs QUIC consistió en dispositivos Android con OkHttp y Cronet, proxies en la nube para finalizar conexiones y un servidor de emulación.
Experimento 2
Cuando Google hizo que QUIC estuviera disponible a través de , utilizamos el mismo inventario, pero con una modificación: en lugar de NGINX, tomamos los balanceadores de Google para finalizar conexiones TCP y QUIC desde los dispositivos, así como para dirigir el tráfico HTTPS al servidor de emulación. Los balanceadores están distribuidos en todo el mundo, pero usan el servidor PoP más cercano al dispositivo (gracias a la geolocalización).
Figura 7. En el segundo experimento queríamos comparar la latencia de finalización entre TCP y QUIC: utilizando Google Cloud y nuestro proxy en la nube.
Al final, tuvimos varias revelaciones:
- la finalización a través de PoP mejoró el rendimiento de TCP. Dado que los balanceadores de carga cierran la conexión TCP más cerca de los usuarios y están optimizados, esto resulta en RTT más bajos, lo que mejora el rendimiento de TCP. Aunque esto ha afectado menos a QUIC, aun así superó a TCP en la reducción de las latencias por el final (de un 10 a un 30 por ciento).
- impactos en las colas . Aunque nuestro proxy QUIC estaba más lejos de los dispositivos (con una latencia de aproximadamente 50 ms más alta) que los balanceadores de Google, ofrecía un rendimiento similar: una reducción del 15% en la latencia frente a una reducción del 20% en el percentil 99 de TCP. Esto indica que el salto en la última milla es un cuello de botella (bottleneck) en el funcionamiento de la red.
Figura 8. Los resultados de los dos experimentos muestran que QUIC supera significativamente a TCP.
Tráfico en producción
Inspirados en los experimentos, implementamos soporte para QUIC en nuestras aplicaciones de Android e iOS. Realizamos pruebas A/B para determinar el impacto de QUIC en las ciudades donde Uber tiene presencia. En general, vimos una disminución significativa de las latencias de cola en todos los regiones, así como en los operadores de telecomunicaciones y tipos de red.
A continuación, los gráficos muestran las mejoras porcentuales en las colas (percentiles 95 y 99) por macroregiones y diferentes tipos de red: LTE, 3G, 2G.
Figura 9. En las pruebas en producción, QUIC superó a TCP en términos de latencia.
Solo adelante
Probablemente, esto es solo el comienzo: la implementación de QUIC en producción ha proporcionado sorprendentes oportunidades para mejorar el rendimiento de las aplicaciones en redes tanto estables como inestables, específicamente:
Aumento de cobertura
Al analizar el rendimiento del protocolo en tráfico real, vimos que aproximadamente el 80% de las sesiones utilizaron QUIC con éxito para todas solicitudes, mientras que el 15% de las sesiones utilizaron una combinación de QUIC y TCP. Supongamos que esta combinación surgió porque la biblioteca Cronet retrocede a TCP por tiempo de espera, ya que no puede distinguir entre fallos reales de UDP y malas condiciones de red. Actualmente estamos buscando una solución a este problema mientras trabajamos en la implementación posterior de QUIC.
Optimización de QUIC
El tráfico de aplicaciones móviles es sensible a la latencia, pero no al ancho de banda. Además, nuestras aplicaciones se utilizan principalmente en redes móviles. Basándonos en experimentos, las latencias de cola siguen siendo elevadas, incluso con el uso de proxies para finalizar TCP y QUIC cerca de los usuarios. Estamos buscando activamente formas de mejorar la gestión de la congestión y aumentar la eficiencia de los algoritmos de recuperación de pérdidas de QUIC.
Con estas y algunas otras mejoras, planeamos optimizar la experiencia del usuario independientemente de la red y la región, haciendo que el transporte de paquetes sea más accesible de manera cómoda y fluida en todo el mundo.
Fuente: habr.com
