

Muchos piensan que basta con trasladar la aplicación a Kubernetes (ya sea mediante Helm o manualmente) para alcanzar la felicidad. Pero no es tan sencillo.
Comando He traducido el artículo del ingeniero DevOps Julian Gindi. Él narra con qué obstáculos se enfrentó su empresa durante el proceso de migración, para que ustedes no cometan los mismos errores.
Paso uno: configuración de solicitudes de pod y límites
Empecemos configurando un entorno limpio donde funcionarán nuestros pods. Kubernetes se encarga magistralmente de planificar pods y manejar estados de falla. Sin embargo, se ha demostrado que a veces el programador no puede colocar un pod si no puede estimar cuántos recursos necesita para funcionar con éxito. Aquí es donde entran las solicitudes de recursos y los límites. Hay mucho debate sobre el mejor enfoque para configurar solicitudes y límites. A veces parece más un arte que una ciencia. Este es nuestro enfoque.
Solicitudes de pod (pod requests) son el valor fundamental que utiliza el programador para la colocación óptima del pod.
De : en la fase de filtrado se determina el conjunto de nodos donde se puede programar el pod. Por ejemplo, el filtro PodFitsResources verifica si hay suficientes recursos en el nodo para satisfacer las solicitudes específicas del pod.
Utilizamos las solicitudes de las aplicaciones de tal manera que se pueda evaluar cuántos recursos realmente necesita la aplicación para funcionar correctamente. Así, el programador podrá colocar nodos de forma realista. Inicialmente, queríamos establecer las solicitudes con un margen de seguridad para asegurar una cantidad adecuada de recursos para cada pod, pero notamos que el tiempo de planificación aumentó considerablemente y algunos pods no se programaron completamente, como si no hubiera recibido solicitudes de recursos.
En este caso, a menudo el programador "expulsaba" pods y no podía reprogramarlos porque la capa de control no tenía idea de cuántos recursos necesitaría la aplicación, y eso es un componente clave del algoritmo de planificación.
Límites de pod (pod limits) son una restricción más clara para el pod. Representan la cantidad máxima de recursos que el clúster asignará al contenedor.
Una vez más, de : si se establece un límite de memoria de 4 GiB para el contenedor, kubelet (y el entorno de ejecución del contenedor) lo impondrá. El entorno de ejecución no permite que el contenedor use más que el límite de recursos especificado. Por ejemplo, cuando un proceso en el contenedor intenta usar más de la cantidad permitida de memoria, el núcleo del sistema termina ese proceso con el error 'fuera de memoria' (OOM).
El contenedor siempre puede usar más recursos de los que se especifican en la solicitud de recursos, pero nunca puede usar más de lo que se indica en el límite. Este valor es difícil de establecer correctamente, pero es muy importante.
Idealmente, queremos que las solicitudes de recursos del pod cambien a lo largo del ciclo de vida del proceso, sin interferir con otros procesos en el sistema; ese es el objetivo de establecer límites.
Desafortunadamente, no puedo dar indicaciones específicas sobre qué valores establecer, pero nosotros mismos seguimos las siguientes pautas:
- Usando una herramienta de pruebas de carga, modelamos el nivel básico de tráfico y observamos el uso de recursos del pod (memoria y CPU).
- Establecemos las solicitudes del pod en un valor arbitrariamente bajo (con un límite de recursos aproximadamente 5 veces mayor que el valor de las solicitudes) y observamos. Cuando las solicitudes están a un nivel demasiado bajo, el proceso no puede iniciarse, lo que a menudo provoca errores misteriosos en tiempo de ejecución de Go.
Quiero señalar que límites de recursos más altos complican la planificación, ya que el pod necesita un nodo objetivo con suficientes recursos disponibles.
Imagina una situación en la que tienes un servidor web liviano con un límite de recursos muy alto, por ejemplo, 4 GB de memoria. Probablemente, este proceso necesitará escalar horizontalmente y cada nuevo módulo deberá planificarse en un nodo con al menos 4 GB de memoria disponible. Si no existe tal nodo, el clúster deberá introducir un nuevo nodo para manejar este pod, lo que puede llevar algún tiempo. Es importante lograr una mínima diferencia entre las solicitudes de recursos y los límites para asegurar un escalado rápido y fluido.
Paso dos: configurar las pruebas de Liveness y Readiness
Este es otro tema delicado que a menudo se discute en la comunidad de Kubernetes. Es importante entender bien las pruebas de vitalidad (Liveness) y de preparación (Readiness), ya que proporcionan un mecanismo para un funcionamiento estable del software y minimizan el tiempo de inactividad. Sin embargo, pueden tener un impacto serio en el rendimiento de su aplicación si no se configuran correctamente. A continuación, se presenta un breve resumen de lo que representan ambas pruebas.
Liveness indica si el contenedor está funcionando. Si falla, kubelet mata el contenedor y se activa la política de reinicio. Si el contenedor no está configurado con una prueba de Liveness, el estado por defecto será éxito, así se indica en .
Las pruebas de Liveness deben ser baratas, es decir, no consumir muchos recursos, porque se ejecutan con frecuencia y deben informar a Kubernetes que la aplicación está activa.
Si establece el parámetro para ejecutarse cada segundo, esto añadirá 1 solicitud por segundo, así que tenga en cuenta que se necesitarán recursos adicionales para manejar este tráfico.
En nuestra empresa, las pruebas de Liveness verifican los componentes clave de la aplicación, incluso si los datos (por ejemplo, de una base de datos remota o caché) no están completamente disponibles.
Hemos configurado en las aplicaciones un endpoint de 'salud', que simplemente devuelve un código de respuesta 200. Esto indica que el proceso está en marcha y es capaz de procesar solicitudes (pero aún no tráfico).
Prueba Disponibilidad indica si el contenedor está listo para atender solicitudes. Si la prueba de preparación falla, el controlador de endpoints retira la dirección IP del pod de los endpoints de todos los servicios que corresponden al pod. Esto también se indica en la documentación de Kubernetes.
Las pruebas de Readiness consumen más recursos, ya que deben interactuar con el backend de manera que muestren que la aplicación está lista para aceptar solicitudes.
En la comunidad hay muchos debates sobre si se debe hacer consultas directas a la base de datos. Dada la sobrecarga (las verificaciones se realizan con frecuencia, pero se pueden regular), decidimos que para algunas aplicaciones, la disponibilidad del tráfico solo se cuenta después de verificar que se devuelven registros de la base de datos. Pruebas de disponibilidad bien pensadas han proporcionado un mayor nivel de acceso y han eliminado tiempos de inactividad durante el despliegue.
Si decides hacer una consulta a la base de datos para verificar la disponibilidad de la aplicación, asegúrate de que sea lo más económica posible. Consideremos esta consulta:
SELECT small_item FROM table LIMIT 1Aquí hay un ejemplo de cómo configuramos estos dos valores en Kubernetes:
livenessProbe:
 httpGet:
   path: /api/liveness
   port: http
readinessProbe:
 httpGet:
   path: /api/readiness
   port: http  periodSeconds: 2
Se pueden agregar algunos parámetros de configuración adicionales:
initialDelaySeconds— cuántos segundos pasarán desde el inicio del contenedor hasta que comience a ejecutar las comprobaciones.periodSeconds— intervalo de espera entre ejecuciones de las comprobaciones.timeoutSeconds— el número de segundos después de los cuales el pod se considera fallido. Un tiempo de espera habitual.failureThreshold— el número de fallos en las comprobaciones antes de que se envíe una señal de reinicio al pod.successThreshold— el número de comprobaciones exitosas necesarias antes de que el pod cambie a estado de disponibilidad (después de un fallo, cuando el pod se reinicia o se recupera).
Paso tres: configuración de políticas de red predeterminadas del pod
En Kubernetes, la topología de red es "plana", por defecto todos los pods se comunican directamente entre sí. En algunos casos, esto no es deseable.
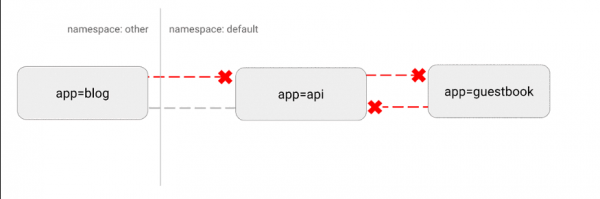
Un problema potencial de seguridad es que un atacante puede aprovechar una única aplicación vulnerable para enviar tráfico a todos los pods en la red. Al igual que en muchas áreas de seguridad, aquí se aplica el principio de menor privilegio. Idealmente, las políticas de red deberían especificar explícitamente qué conexiones entre pods están permitidas y cuáles no.
Por ejemplo, a continuación se muestra una política simple que prohíbe todo el tráfico entrante para un espacio de nombres específico:
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
 name: default-deny-ingress
spec:
 podSelector: {}
 policyTypes:
   - Ingress
Visualización de esta configuración:
(https://miro.medium.com/max/875/1*-eiVw43azgzYzyN1th7cZg.gif)
Más detalles .
Paso cuatro: comportamiento no estándar mediante ganchos y contenedores init
Una de nuestras principales tareas fue garantizar despliegues en Kubernetes sin interrupción para los desarrolladores. Esto es complicado debido a que hay numerosas formas en que las aplicaciones pueden finalizar y liberar los recursos que utilizan.
Se presentaron dificultades particulares con . Notamos que durante el despliegue secuencial de estos pods, las conexiones activas se interrumpían antes de que se completara exitosamente.
Después de una extensa investigación en internet, descubrimos que Kubernetes no espera a que las conexiones de Nginx se agoten antes de finalizar el pod. Mediante el gancho pre-stop, implementamos esta funcionalidad y eliminamos completamente el tiempo de inactividad:
lifecycle:
 preStop:
   exec:
     command: ["/usr/local/bin/nginx-killer.sh"]
Y aquí está nginx-killer.sh:
#!/bin/bash
sleep 3
PID=$(cat /run/nginx.pid)
nginx -s quit
while [ -d /proc/$PID ]; do
   echo "Waiting while shutting down nginx..."
   sleep 10
done
Otra paradigma extremadamente útil es el uso de contenedores init para manejar el inicio de aplicaciones específicas. Esto es especialmente útil si tiene un proceso de migración de base de datos que consume muchos recursos y que debe ejecutarse antes de iniciar la aplicación. Para este proceso, también puede especificar un límite de recursos más alto sin establecer dicho límite para la aplicación principal.
Otro esquema común es el acceso a secretos en el contenedor init, que proporciona estas credenciales al módulo principal, lo que previene el acceso no autorizado a los secretos desde el propio módulo principal de la aplicación.
Como de costumbre, una cita de la documentación: los contenedores init ejecutan de manera segura código o utilidades de usuario, que de otro modo reducirían la seguridad de la imagen del contenedor de la aplicación. Al almacenar herramientas innecesarias por separado, limitas la superficie de ataque de la imagen del contenedor de la aplicación.
Paso cinco: configuración del núcleo
Por último, hablaremos sobre una técnica más avanzada.
Kubernetes es una plataforma increíblemente flexible que permite ejecutar cargas de trabajo como consideres necesario. Contamos con una serie de aplicaciones de alto rendimiento que requieren una cantidad extrema de recursos. Tras realizar extensas pruebas de carga, descubrimos que una de las aplicaciones tenía dificultades para manejar la carga de tráfico esperada si se aplicaban las configuraciones predeterminadas de Kubernetes.
Sin embargo, Kubernetes permite ejecutar un contenedor privilegiado que modifica los parámetros del kernel solo para un pod específico. Esto es lo que utilizamos para cambiar el número máximo de conexiones abiertas:
initContainers:
  - name: sysctl
     image: alpine:3.10
     securityContext:
         privileged: true
      command: ['sh', '-c', "sysctl -w net.core.somaxconn=32768"]
Esta es una técnica más avanzada que a menudo no es necesaria. Pero si su aplicación apenas puede manejar una gran carga, puede intentar ajustar algunos de estos parámetros. Más información sobre este proceso y cómo configurar diferentes valores se puede encontrar, como siempre, .
En conclusión
Aunque Kubernetes puede parecer una solución lista para usar, se deben tomar varios pasos clave para garantizar el funcionamiento continuo de las aplicaciones.
A lo largo de la migración a Kubernetes, es importante seguir el 'ciclo de pruebas de carga': ejecuta la aplicación, pruébala bajo carga, observa las métricas y el comportamiento al escalar, ajusta la configuración según estos datos y luego repite este ciclo.
Evalúe realísticamente el tráfico esperado y trate de superarlo para ver qué componentes fallarán primero. Con este enfoque iterativo, puede ser suficiente con solo algunas de las recomendaciones listadas para tener éxito. O puede requerir una configuración más profunda.
Siempre pregúntese lo siguiente:
- ¿Cuántos recursos consumen las aplicaciones y cómo cambiará este volumen?
- ¿Cuáles son los requisitos reales de escalabilidad? ¿Cuánto tráfico manejará la aplicación en promedio? ¿Y qué hay del tráfico pico?
- ¿Con qué frecuencia necesitará el servicio escalamiento horizontal? ¿Qué tan rápido debe desplegar nuevos pods para aceptar tráfico?
- ¿Cuán correctamente finalizan los pods? ¿Es esto necesario? ¿Se puede lograr un despliegue sin tiempo de inactividad?
- ¿Cómo minimizar los riesgos para la seguridad y limitar el daño de cualquier pod comprometido? ¿Hay permisos o accesos en algún servicio que no sean necesarios?
Kubernetes ofrece una plataforma increíble que permite aplicar las mejores prácticas para desplegar miles de servicios en un clúster. Sin embargo, todas las aplicaciones son diferentes. A veces, la implementación requiere un poco más de trabajo.
Afortunadamente, Kubernetes proporciona la configuración necesaria para alcanzar todos los objetivos técnicos. Utilizando una combinación de solicitudes de recursos y límites, sondas de Liveness y Readiness, contenedores init, políticas de red y ajustes personalizados del núcleo, puede lograr un alto rendimiento, así como resistencia ante fallos y escalabilidad rápida.
Qué más leer:
- .
- .
- .
Fuente: habr.com
