

La tolerancia a fallos y la alta disponibilidad son temas amplios, así que dedicaremos artículos separados a RabbitMQ y Kafka. Este artículo trata sobre RabbitMQ, y el siguiente será sobre Kafka, en comparación con RabbitMQ. El artículo es extenso, así que acomódense.
Analizaremos las estrategias de tolerancia a fallos, consistencia y alta disponibilidad (HA), así como los compromisos que hay que asumir en cada estrategia. RabbitMQ puede funcionar en un clúster de nodos, lo que lo clasifica como un sistema distribuido. Cuando hablamos de sistemas distribuidos, frecuentemente nos referimos a consistencia y disponibilidad.
Estos conceptos describen cómo se comporta un sistema ante fallos. La falla de una conexión de red, un servidor, un disco duro, la inaccesibilidad temporal de un servidor debido a la recolección de basura, la pérdida de paquetes o la ralentización de la conexión de red. Todo esto puede llevar a la pérdida de datos o a conflictos. Resulta que es prácticamente imposible tener un sistema que sea completamente consistente (sin pérdida de datos ni discrepancias) y disponible (que acepte operaciones de lectura y escritura) para todos los tipos de fallos.
Veremos que la consistencia y la disponibilidad están en extremos opuestos del espectro, y se debe elegir en qué dirección optimizar. La buena noticia es que con RabbitMQ esta elección es posible. Tienes esos pequeños "interruptores de nerd" para mover el equilibrio hacia una mayor consistencia o una mayor disponibilidad.
Prestaremos especial atención a las configuraciones que conducen a la pérdida de datos debido a confirmaciones de registro. Hay una cadena de responsabilidad entre publicadores, corredores y consumidores. Después de que un mensaje se envía al corredor, es su trabajo no perder el mensaje. Cuando el corredor confirma al publicador que ha recibido el mensaje, no esperamos que se pierda. Pero veremos que esto puede ocurrir realmente dependiendo de la configuración de tu corredor y publicador.
Primitivos de resistencia de un solo nodo
Colas resistentes/ruteo
En RabbitMQ hay dos tipos de colas: duraderas (durable) y no duraderas (non-durable). Todas las colas se almacenan en la base de datos Mnesia. Las colas duraderas se vuelven a declarar al iniciar el nodo y, de esta manera, sobreviven a un reinicio, una falla del sistema o una caída del servidor (mientras se conserven los datos). Esto significa que siempre que declares la ruta (exchange) y la cola como duraderas, la infraestructura de colas/rutas volverá a funcionar.
Las colas y rutas no duraderas se eliminan al reiniciar el nodo.
Mensajes duraderos
El hecho de que una cola sea duradera no significa que todos sus mensajes sobrevivan al reinicio del nodo. Solo se recuperarán los mensajes marcados por el publicador como duraderos (persistent). Los mensajes duraderos realmente generan una carga adicional en el broker, pero si la pérdida de un mensaje no es aceptable, no hay otra salida.
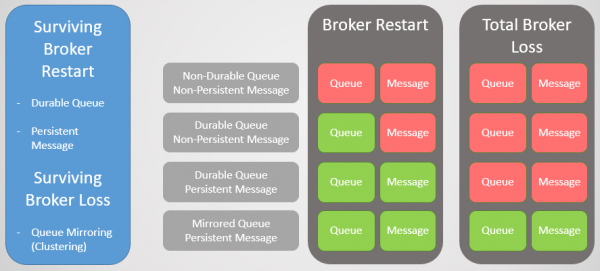
Fig. 1. Matriz de durabilidad
Clustering con replicación de colas
Para sobrevivir a la pérdida de un broker, necesitamos redundancia. Podemos unir varios nodos de RabbitMQ en un clúster y luego añadir redundancia adicional replicando las colas entre varios nodos. De esta forma, si un nodo falla, no perdemos datos y seguimos disponibles.
Replicación de colas:
- una cola principal (master), que recibe todos los comandos de escritura y lectura
- uno o más espejos, que reciben todos los mensajes y metadatos de la cola principal. Estos espejos no existen para escalar, sino exclusivamente para redundancia.
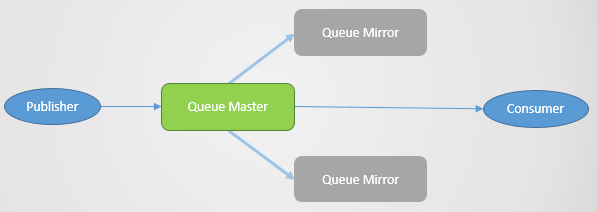
Fig. 2. Replicación de colas
La replicación se establece mediante una política correspondiente. En ella se puede elegir el coeficiente de replicación e incluso los nodos en los que debe residir la cola. Ejemplos:
ha-mode: allha-mode: exactly, ha-params: 2(un maestro y un espejo)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Confirmación al publicador
Para lograr una grabación coherente, se requieren confirmaciones del publicador (Publisher Confirms). Sin ellas, existe la posibilidad de pérdida de mensajes. La confirmación se envía al publicador después de que se grabe el mensaje en el disco. RabbitMQ graba mensajes en el disco no al recibirlos, sino de manera periódica, en el orden de varios cientos de milisegundos. Cuando se espejan colas, la confirmación se envía solo después de que todos los espejos también hayan grabado su copia del mensaje en el disco. Esto significa que el uso de confirmaciones agrega un retraso, pero si la seguridad de los datos es importante, son necesarias.
Cola tolerante a fallos
Cuando el corredor se apaga o falla, todas las colas principales (máster) en este nodo se desconectan junto con él. Luego, el clúster elige el espejo más antiguo de cada máster y lo promueve como nuevo máster.
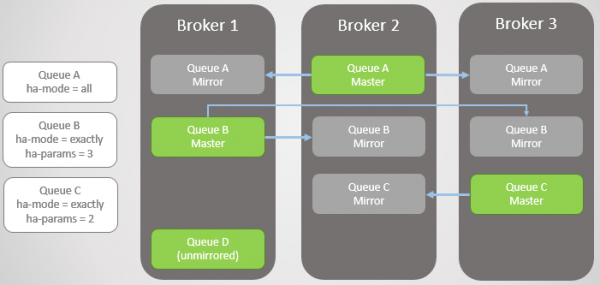
Fig. 3. Varias colas espejadas y sus políticas
El corredor 3 falla. Nota que el espejo de la Cola C en el Corredor 2 se eleva a máster. También se observa que se ha creado un nuevo espejo para la Cola C en el Corredor 1. RabbitMQ siempre intenta mantener la tasa de replicación indicada en sus políticas.
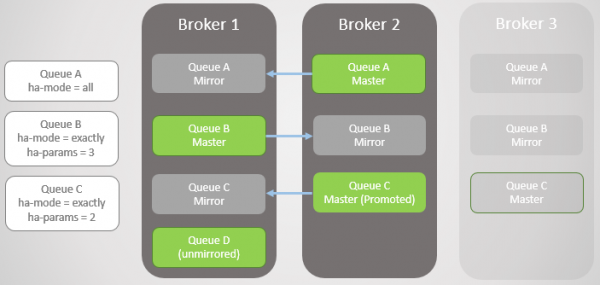
Fig. 4. El corredor 3 falla, lo que causa el fallo de la cola C
¡Falla el siguiente Corredor 1! Solo nos queda un corredor. El espejo de la Cola B se eleva a máster.
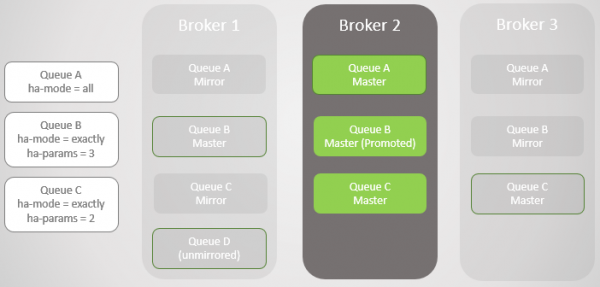
Fig. 5
Hemos recuperado el Corredor 1. Independientemente de cuán exitosamente los datos sobrevivieron a la pérdida y recuperación del corredor, todos los mensajes espejados de la cola se descartan al reiniciarse. Esto es importante señalar, ya que habrá consecuencias. Pronto revisaremos estas consecuencias. Así, el Corredor 1 ahora vuelve a ser miembro del clúster, y el clúster intenta cumplir con las políticas y, por lo tanto, crea espejos en el Corredor 1.
En este caso, la pérdida del Corredor 1 fue total, al igual que los datos, por lo que la Cola B no espejada se perdió completamente.
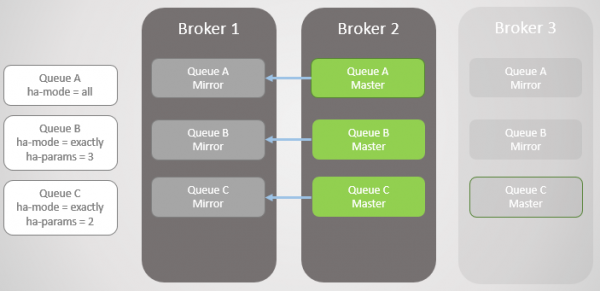
Fig. 6. El Corredor 1 vuelve a estar en funcionamiento
El Broker 3 ha vuelto a estar operativo, lo que permite que las colas A y B recuperen los espejos creados en él para satisfacer sus políticas de HA. Pero ahora todas las colas principales están en un solo nodo. ¡Esto no es ideal, es mejor tener una distribución uniforme entre nodos! Desafortunadamente, no hay muchas opciones aquí para reequilibrar los maestros. Volveremos a este problema más tarde, ya que primero debemos considerar la sincronización de la cola.
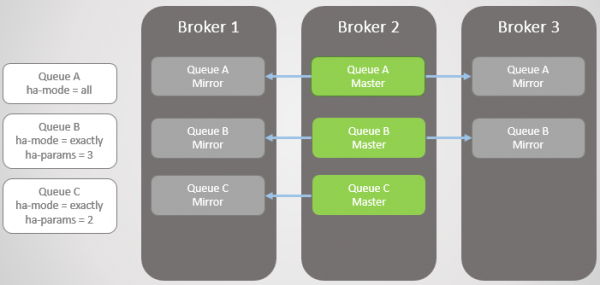
Fig. 7. El Broker 3 vuelve a estar operativo. ¡Todas las colas principales en un solo nodo!
Así que ahora deberían tener una idea de cómo los espejos proporcionan redundancia y alta disponibilidad. Esto garantiza la accesibilidad en caso de falla de un nodo y protege contra la pérdida de datos. Pero aún no hemos terminado, porque en realidad es mucho más complicado.
Sincronización
Al crear un nuevo espejo, todos los nuevos mensajes siempre se replicarán en este espejo y en cualquier otro. En cuanto a los datos existentes en la cola principal, podemos replicarlos en el nuevo espejo, que se convierte en una copia completa del maestro. También podemos optar por no replicar los mensajes existentes y permitir que la cola principal y el nuevo espejo se sincronicen con el tiempo, a medida que los nuevos mensajes llegan al final y los mensajes existentes salen del principio de la cola principal.
Esta sincronización se lleva a cabo automáticamente o manualmente y se gestiona mediante políticas de cola. Veamos un ejemplo.
Tenemos dos colas espejadas. La Cola A se sincroniza automáticamente, mientras que la Cola B se sincroniza manualmente. Ambas colas tienen diez mensajes.
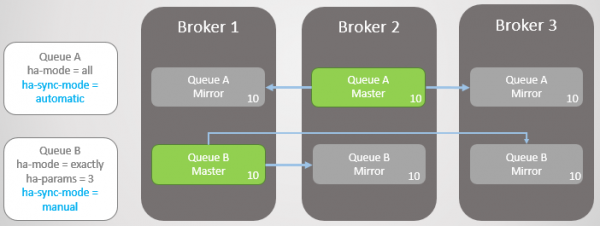
Fig. 8. Dos colas con diferentes modos de sincronización.
Ahora estamos perdiendo el Broker 3.
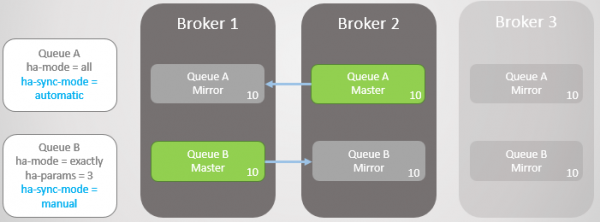
Fig. 9. El Broker 3 ha caído.
El Broker 3 vuelve a estar operativo. El clúster crea un espejo para cada cola en un nuevo nodo y sincroniza automáticamente la nueva Cola A con el maestro. Sin embargo, el espejo de la nueva Cola B permanece vacío. Por lo tanto, tenemos una redundancia completa para la Cola A y solo un espejo para los mensajes existentes de la Cola B.
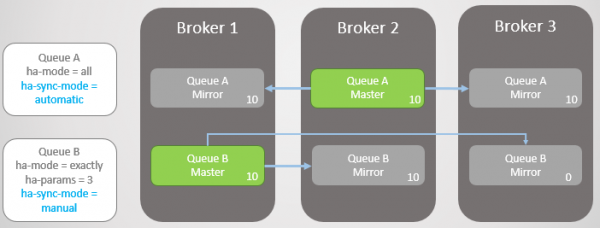
Fig. 10. El nuevo espejo de la Cola A recibe todos los mensajes existentes, mientras que el nuevo espejo de la Cola B no.
En ambas colas llegan otros diez mensajes. Luego, el Broker 2 se cae, y la Cola A retrocede al espejo más antiguo que se encuentra en el Broker 1. No hay pérdida de datos durante la falla. En la Cola B hay veinte mensajes en el maestro y solo diez en el espejo, ya que esta cola nunca replicó los diez mensajes originales.
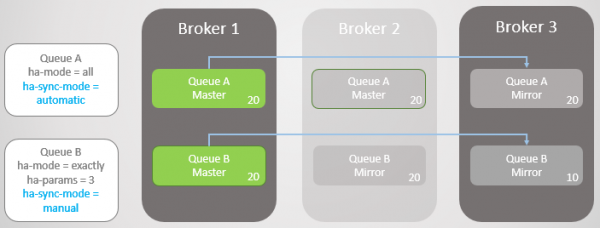
Fig. 11. La Cola A retrocede en el Broker 1 sin pérdida de mensajes
En ambas colas llegan otros diez mensajes. Ahora, se cae el Broker 1. La Cola A se cambia al espejo sin pérdida de mensajes. Sin embargo, la Cola B tiene problemas. En esta etapa, podemos optimizar ya sea la disponibilidad o la consistencia.
Si queremos optimizar la disponibilidad, entonces la política ha-promote-on-failure debería establecerse en always. Este es el valor predeterminado, así que simplemente podemos no especificar la política en absoluto. En este caso, de hecho, permitimos fallas en los espejos no sincronizados. Esto conducirá a la pérdida de mensajes, pero la cola seguirá siendo accesible para lectura y escritura.
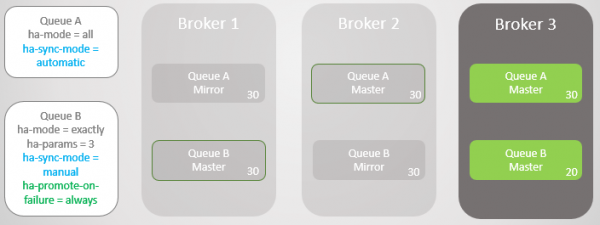
Fig. 12. La Cola A retrocede al Broker 3 sin pérdida de mensajes. La Cola B retrocede al Broker 3 con pérdida de diez mensajes
También podemos establecer ha-promote-on-failure en when-synced. En este caso, en lugar de retroceder al espejo, la cola esperará hasta que el Broker 1 regrese a modo operativo con sus datos. Tras su regreso, la cola principal vuelve a estar en el Broker 1 sin pérdida de datos. La disponibilidad se sacrifica a la seguridad de los datos. Pero este es un modo arriesgado que puede incluso llevar a la pérdida total de datos, lo que discutiremos pronto.
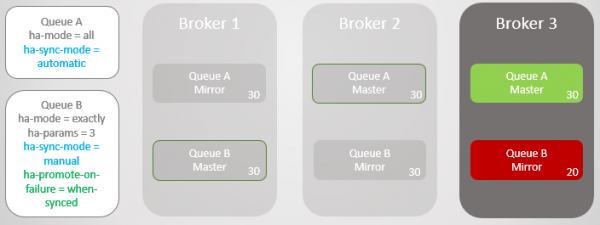
Fig. 13. La Cola B sigue siendo inaccesible después de la pérdida del Broker 1
Puedes preguntarte: "¿Quizás sea mejor nunca usar la sincronización automática?". La respuesta es que la sincronización es una operación bloqueante. ¡Durante la sincronización, la cola principal no puede realizar operaciones de lectura o escritura!
Consideremos un ejemplo. Ahora tenemos colas muy grandes. ¿Cómo pueden crecer a tal tamaño? Por varias razones:
- Las colas no se utilizan activamente
- Son colas de alta velocidad, y en este momento los consumidores están funcionando lentamente
- Son colas de alta velocidad, ha habido una falla, y los consumidores están recuperándose
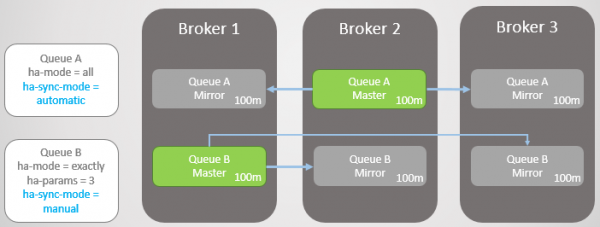
Fig. 14. Dos grandes colas con diferentes modos de sincronización
Ahora falla el Broker 3.
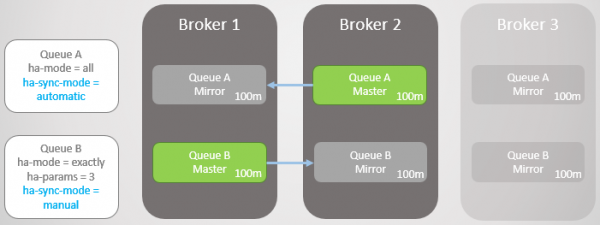
Fig. 15. El Broker 3 falla, dejando un maestro y un espejo en cada cola
El Broker 3 vuelve a estar operativo y se crean nuevos espejos. La Cola Principal A comienza a replicar los mensajes existentes en el nuevo espejo, y durante este tiempo la Cola no está disponible. La replicación de datos tarda dos horas, lo que resulta en dos horas de inactividad para esta Cola.
Sin embargo, la Cola B permanece disponible durante todo el período. Sacrificó cierta redundancia a favor de la disponibilidad.
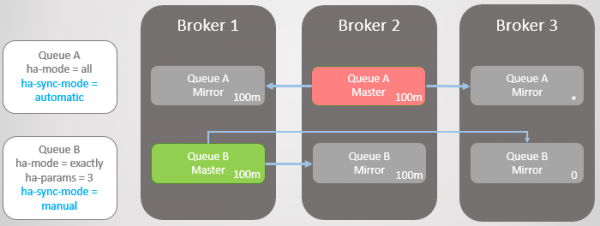
Fig. 16. La cola permanece sin disponibilidad durante la sincronización
Después de dos horas, la Cola A también se vuelve disponible y puede comenzar a aceptar operaciones de lectura y escritura nuevamente.
Actualizaciones
Este comportamiento bloqueante durante la sincronización dificulta la actualización de clústeres con colas muy grandes. En algún momento, es necesario reiniciar el nodo con el maestro, lo que significa pasar a un espejo o desactivar la cola durante la actualización del servidor. Si elegimos el paso, perderemos mensajes si los espejos no están sincronizados. Por defecto, durante la desconexión del broker, no se realiza la transición a un espejo no sincronizado. Esto significa que, una vez que el broker vuelve, no perdemos ningún mensaje, siendo la única pérdida el tiempo de inactividad de la cola. Las reglas de comportamiento al desconectar el broker son establecidas por la política ha-promote-on-shutdown. Se puede establecer uno de dos valores:
always= se activa el paso a espejos no sincronizadoswhen-synced= se pasa solamente a un espejo sincronizado, de lo contrario la cola se vuelve inaccesible para lectura y escritura. La cola vuelve a estar operativa tan pronto como regresa el broker
De una forma u otra, con colas grandes hay que elegir entre perder datos y la inaccesibilidad.
Cuando la disponibilidad aumenta la seguridad de los datos
Antes de tomar una decisión, es necesario considerar otra complicación. Aunque la sincronización automática es mejor para la redundancia, ¿cómo afecta esto a la seguridad de los datos? Ciertamente, gracias a una mejor redundancia, RabbitMQ tiene menos probabilidades de perder mensajes existentes, pero ¿qué pasa con los nuevos mensajes de los publicadores?
Aquí se debe considerar lo siguiente:
- ¿Puede el publicador simplemente devolver un error y el servicio superior o el usuario intentar de nuevo más tarde?
- ¿Puede el publicador guardar el mensaje localmente o en una base de datos para volver a intentarlo más tarde?
Si el publicador solo puede descartar el mensaje, entonces, de hecho, mejorar la disponibilidad también aumenta la seguridad de los datos.
Por lo tanto, se debe buscar un equilibrio y la solución depende de la situación concreta.
Problemas con ha-promote-on-failure=when-synced
La idea ha-promote-on-failure= when-synced es que evitamos cambiar a un espejo no sincronizado y, por lo tanto, evitamos la pérdida de datos. La cola permanece inaccesible para lectura o escritura. En lugar de eso, intentamos recuperar el corredor caído con datos intactos para que reanude su función como maestro sin pérdida de datos.
Pero (y esto es un gran pero) si el corredor ha perdido sus datos, entonces tenemos un gran problema: ¡la cola se ha perdido! ¡Todos los datos se han ido! Incluso si tienes espejos que principalmente alcanzan la cola principal, esos espejos también se descartan.
Para volver a añadir un nodo con el mismo nombre, le decimos al clúster que olvide el nodo perdido (con el comando rabbitmqctl forget_cluster_node) y empezamos un nuevo corredor con el mismo nombre de host. Mientras el clúster recuerde el nodo perdido, también recordará la vieja cola y los espejos no sincronizados. Cuando se le dice al clúster que olvide el nodo perdido, esa cola también se olvida. Ahora es necesario volver a declararla. Hemos perdido todos los datos, aunque teníamos espejos con un conjunto de datos parcial. ¡Hubiera sido mejor cambiar a un espejo no sincronizado!
Por lo tanto, la sincronización manual (y la falta de sincronización) junto con ha-promote-on-failure=when-synced, en mi opinión, es bastante arriesgada. La documentación dice que tal opción existe para la seguridad de los datos, pero es un arma de doble filo.
Rebalanceo de maestros
Como se prometió, volvemos al problema de que todos los maestros se acumulen en uno o varios nodos. Esto puede suceder incluso como resultado de una actualización 'deslizante' (rolling) del clúster. En un clúster con tres nodos, todas las colas principales se acumularán en uno o dos nodos.
El rebalanceo de maestros puede ser problemático por dos razones:
- No hay buenas herramientas para realizar el rebalanceo
- Sincronización de colas
Hay un complemento de terceros , que no es oficialmente soportado. En la documentación de RabbitMQ se menciona sobre los complementos de terceros : «El complemento proporciona algunas herramientas adicionales para la configuración y reportes, pero no es soportado ni verificado por el equipo de RabbitMQ. Úselo bajo su propio riesgo».
Hay otro truco para mover la cola principal a través de políticas de HA. En la documentación se menciona un para esto. Funciona de la siguiente manera:
- Elimina todos los espejos con una política temporal de mayor prioridad que la política de HA existente.
- Cambia la política temporal de HA para usar el modo 'nodos' especificando el nodo al que se debe mover la cola principal.
- Sincroniza la cola para forzar la migración.
- Una vez finalizada la migración, elimina la política temporal. Se activa la política de HA original y se crea el número necesario de espejos.
La desventaja es que este enfoque puede no funcionar si tiene colas grandes o estrictos requisitos de redundancia.
Ahora veamos cómo funcionan los clústeres de RabbitMQ con particiones de red.
Violación de la coherencia
Los nodos de un sistema distribuido están conectados por enlaces de red, y los enlaces de red pueden y se desconectarán. La frecuencia de las desconexiones depende de la infraestructura local o de la fiabilidad de la nube elegida. En cualquier caso, los sistemas distribuidos deben ser capaces de manejar estas situaciones. Nuevamente, nos enfrentamos a la elección entre disponibilidad y coherencia, y una vez más, la buena noticia es que RabbitMQ proporciona ambas opciones (simplemente no al mismo tiempo).
Con RabbitMQ tenemos dos opciones principales:
- Permitir la división lógica (split-brain). Esto garantiza la disponibilidad, pero puede provocar pérdida de datos.
- Prohibir la división lógica. Esto puede resultar en una pérdida temporal de disponibilidad dependiendo de cómo los clientes se conecten al clúster. También puede llevar a una falta total de disponibilidad en un clúster de dos nodos.
¿Pero qué es la división lógica? Es cuando un clúster se divide en dos debido a la pérdida de enlaces de red. En cada lado, los espejos se elevan a maestro, de modo que al final hay varios maestros para cada cola.
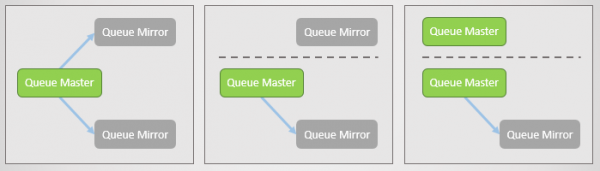
Fig. 17. Cola principal y dos espejos, cada uno en un nodo separado. Luego ocurre una falla en la red, y un espejo se separa. El nodo separado ve que los otros dos han caído, y promueve sus espejos a maestro. Ahora tenemos dos colas principales, y ambas permiten lectura y escritura.
Si los editores envían datos a ambos maestros, tendremos dos copias divergentes de la cola.
Los diferentes modos de RabbitMQ garantizan ya sea disponibilidad o consistencia.
Modo Ignorar (por defecto)
Este modo asegura disponibilidad. Después de perder la conectividad, ocurre una separación lógica. Tras la recuperación de la conectividad, el administrador debe decidir a qué sección dar preferencia. El lado perdedor se reiniciará, y todos los datos acumulados en ese lado se perderán.
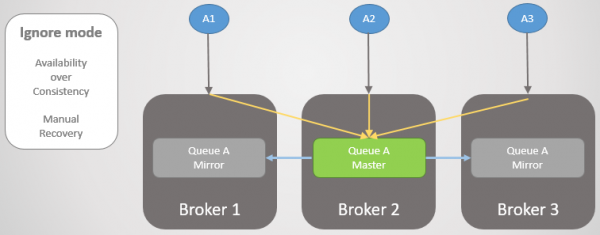
Fig. 18. Tres editores están conectados a tres brokers. Internamente, el clúster dirige todas las solicitudes a la cola principal en el Broker 2.
Ahora estamos perdiendo el Broker 3. Él ve que otros brokers han caído y promueve su espejo a maestro. Así es como ocurre la separación lógica.
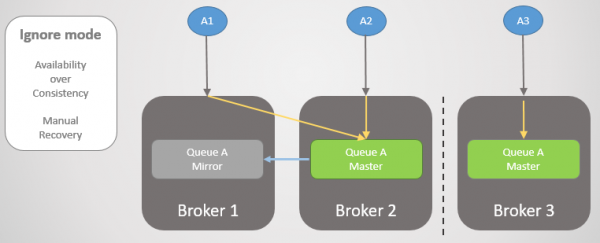
Fig. 19. Separación lógica (split-brain). Las escrituras van a dos colas principales, y las dos copias se divergen.
La conectividad se restaura, pero la separación lógica permanece. El administrador debe seleccionar manualmente el lado perdedor. En el caso siguiente, el administrador reinicia el Broker 3. Se pierden todos los mensajes que no se habían enviado.
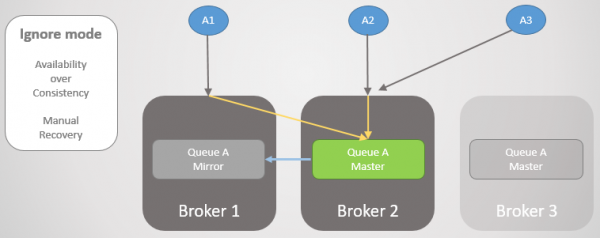
Fig. 20. El administrador desconecta el Broker 3.
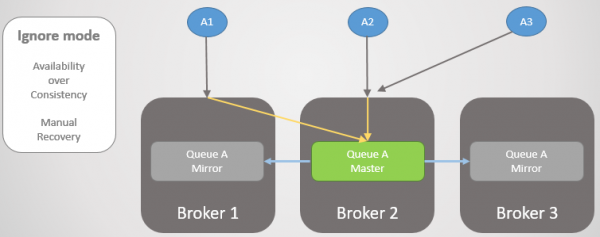
Fig. 21. El administrador inicia el Broker 3 y se une al clúster, perdiendo todos los mensajes que allí habían quedado.
Durante la pérdida de conectividad y después de su recuperación, el clúster y esta cola estuvieron disponibles para lectura y escritura.
Modo Autoheal
Funciona de manera similar al modo Ignorar, con la excepción de que el clúster automáticamente elige el lado perdedor después de la separación y restauración de la conectividad. El lado perdedor vuelve al clúster vacío, y la cola pierde todos los mensajes que se enviaron solo a ese lado.
Modo Pausar Minoría
Si no queremos permitir la división lógica, nuestra única opción es renunciar a la lectura y escritura en el lado menor después de la partición del clúster. Cuando el corredor ve que está en el lado menor, suspende su funcionamiento, es decir, cierra todas las conexiones existentes y rechaza cualquier nueva. Una vez por segundo, comprueba la recuperación de la conectividad. Tan pronto como la conectividad se restablece, reanuda su funcionamiento y se une al clúster.
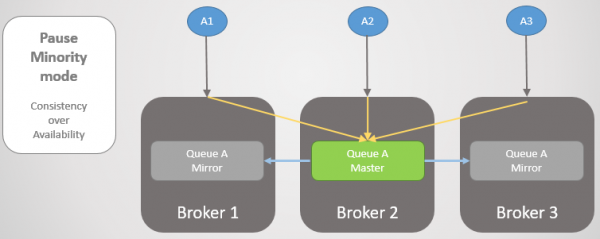
Fig. 22. Tres editores están conectados a tres corredores. Internamente, el clúster dirige todas las solicitudes a la cola principal del Corredor 2.
Luego, los Corredores 1 y 2 se separan del Corredor 3. En lugar de elevar su espejo a maestro, el Corredor 3 suspende su funcionamiento y se vuelve inaccesible.
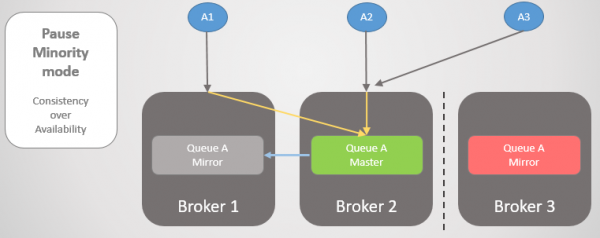
Fig. 23. El Corredor 3 suspende su funcionamiento, desconecta a todos los clientes y rechaza las solicitudes de conexión.
Una vez que se restablece la conectividad, regresa al clúster.
Veamos otro ejemplo, donde la cola principal está en el Corredor 3.
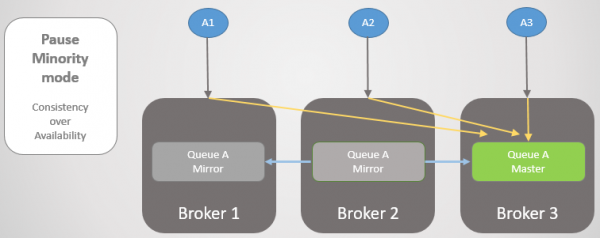
Fig. 24. Cola principal en el Corredor 3.
Luego ocurre la misma pérdida de conectividad. El Corredor 3 se pone en pausa, ya que está en el lado menor. En el otro lado, los nodos ven que el Corredor 3 ha fallado, así que un espejo más antiguo de los Corredores 1 y 2 se eleva a maestro.
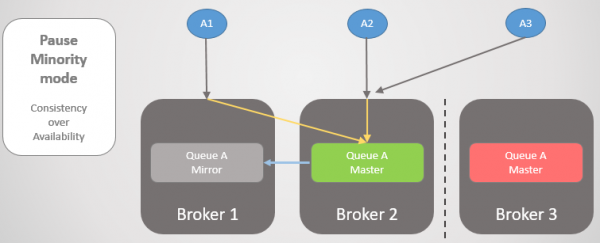
Fig. 25. Transición al Corredor 2 en la falta de disponibilidad del Corredor 3.
Cuando se restablece la conectividad, el Corredor 3 se unirá al clúster.

Fig. 26. El clúster ha vuelto a su funcionamiento normal.
Aquí es importante entender que obtenemos consistencia, pero también podemos obtener disponibilidad, si logramos trasladar a los clientes a la parte mayor de la partición. Para la mayoría de las situaciones, personalmente elegiría el modo Pause Minority, pero realmente depende del caso concreto.
Para garantizar la disponibilidad, es importante asegurarse de que los clientes se conecten con éxito al nodo. Veamos nuestras opciones.
Garantizando la conectividad de los clientes
Tenemos varias opciones sobre cómo redirigir a los clientes a la parte principal del clúster o a los nodos en funcionamiento después de una pérdida de conectividad (tras el fallo de un nodo). Primero recordemos que una cola específica se ubica en un nodo determinado, pero el enrutamiento y las políticas se replican en todos los nodos. Los clientes pueden conectarse a cualquier nodo y el enrutamiento interno los dirigirá donde sea necesario. Sin embargo, cuando un nodo está detenido, rechaza las conexiones, por lo que los clientes deben conectarse a otro nodo. Si un nodo falla, tiene muy poco que ofrecer.
Nuestras opciones:
- El acceso al clúster se realiza a través de un balanceador de carga que simplemente recorre cíclicamente los nodos, mientras que los clientes intentan reconectar hasta lograrlo. Si un nodo no está funcionando o está detenido, los intentos de conexión a este nodo fallarán, pero los intentos posteriores irán a otros servidores (en modo cíclico). Esto es adecuado para una pérdida temporal de conectividad o un servidor caído que se levantará rápidamente.
- Acceso al clúster a través de un balanceador de carga y eliminar nodos detenidos/caídos de la lista tan pronto como sean detectados. Si esto se hace rápidamente, y si los clientes pueden intentar reconectar, obtendremos disponibilidad continua.
- Dar a cada cliente una lista de todos los nodos, y el cliente al conectarse elige aleatoriamente uno de ellos. Si al intentar conectarse recibe un error, pasa al siguiente nodo de la lista hasta que se conecte.
- Eliminar el tráfico del nodo caído/detenido mediante DNS. Esto se hace usando un TTL bajo.
Conclusiones
La agrupación de RabbitMQ tiene sus ventajas y desventajas. Las desventajas más serias son que:
- al unirse al clúster, los nodos descartan sus datos;
- la sincronización bloqueante lleva a la inaccesibilidad de la cola.
Todas las decisiones difíciles surgen de estas dos características de la arquitectura. Si RabbitMQ pudiera almacenar datos al reconectar el clúster, la sincronización sería más rápida. Si pudiera realizar sincronización no bloqueante, manejaría mejor colas grandes. Abordar estos dos problemas mejoraría significativamente las características de RabbitMQ como tecnología de mensajería resistente y de alta disponibilidad. No me atrevería a recomendar RabbitMQ con clustering en las siguientes situaciones:
- Red poco fiable.
- Almacenamiento poco fiable.
- Colas muy grandes.
En cuanto a las configuraciones para alta disponibilidad, considere las siguientes:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(oautoheal)- mensajes persistentes
- asegúrese de que los clientes se conecten al nodo activo cuando algún nodo falle
Para consistencia (seguridad de datos), considere las siguientes configuraciones:
- Publisher Confirms y Acknowledgements Manuales del lado del consumidor
ha-promote-on-failure=when-synced, si los editores pueden reintentar más tarde y si tiene un almacenamiento muy fiable. ¡De lo contrario, configure=always.ha-sync-mode=automatic(pero para colas inactivas grandes puede ser necesario el modo manual; además, considere si la indisponibilidad puede conducir a la pérdida de mensajes)- modo Pause Minority
- mensajes persistentes
Aún no hemos cubierto todos los temas de resiliencia y alta disponibilidad; por ejemplo, cómo realizar procedimientos administrativos de manera segura (como actualizaciones deslizantes). También hay que hablar sobre la federación y el plugin Shovel.
Si he pasado por alto algo, por favor háganmelo saber.
Consulte también mi , donde realizo una revisión del clúster RabbitMQ utilizando Docker y Blockade para probar algunos escenarios de pérdida de mensajes, como se describe en este artículo.
Artículos anteriores de la serie:
#1 —
#2 —
#3 —
Fuente: habr.com
