

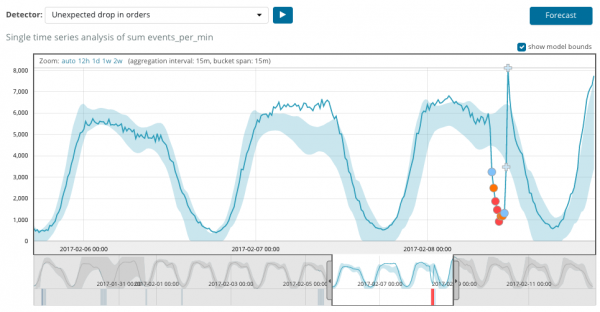
Recordemos que Elastic Stack se basa en la base de datos no relacional Elasticsearch, la interfaz web Kibana y los recolectores y procesadores de datos (el más conocido es Logstash, además de varias Beats, APM y otros). Uno de los agradables añadidos de todo este conjunto de productos es el análisis de datos mediante algoritmos de machine learning. En este artículo, exploramos qué son estos algoritmos. Les pedimos que sigan leyendo.
El machine learning es una función de pago de Elastic Stack, que es condicionalmente gratuita y forma parte del paquete X-Pack. Para comenzar a usarla, basta con activar el periodo de prueba de 30 días tras la instalación. Después del periodo de prueba, se puede solicitar apoyo para su prórroga o adquirir una suscripción. El coste de la suscripción no se calcula en función del volumen de datos, sino del número de nodos utilizados. No, el volumen de datos afecta, por supuesto, al número de nodos necesarios, pero en general, este enfoque de licencia es más humano respecto al presupuesto de la empresa. Si no se requiere un alto rendimiento, se puede economizar.
El ML en Elastic Stack está escrito en C++ y se ejecuta fuera de la JVM, donde se ejecuta el propio Elasticsearch. Es decir, el proceso (que, por cierto, se llama autodetect) consume todo lo que no absorbe la JVM. En un entorno de demostración esto no es tan crítico, pero en un entorno de producción es importante asignar nodos individuales para las tareas de ML.
Los algoritmos de machine learning se dividen en dos categorías — y . En Elastic Stack, el algoritmo pertenece a la categoría "sin supervisión". A través de se puede consultar el aparato matemático de los algoritmos de machine learning.
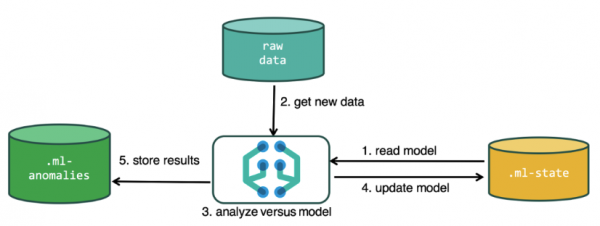
Para realizar análisis, el algoritmo de machine learning utiliza datos almacenados en los índices de Elasticsearch. Se pueden crear tareas de análisis tanto desde la interfaz de Kibana como a través de la API. Si se hace esto a través de Kibana, algunas cosas no son obligatorias de conocer. Por ejemplo, índices adicionales que el algoritmo utiliza en el proceso de trabajo.
Índices adicionales utilizados en el proceso de análisis.ml-state — información sobre modelos estadísticos (configuraciones de análisis);
.ml-anomalies-* — resultados del trabajo de los algoritmos de ML;
.ml-notifications — configuraciones de notificaciones sobre los resultados del análisis.
La estructura de datos en la base de Elasticsearch consiste en índices y los documentos que contienen. Si se compara con una base de datos relacional, el índice se puede comparar con el esquema de la base de datos, y el documento con un registro en una tabla. Esta comparación es aproximada y se presenta para facilitar la comprensión del material posterior para aquellos que solo han oído hablar de Elasticsearch.
A través de la API se accede a la misma funcionalidad que a través de la interfaz web, por lo que para mayor claridad y comprensión de los conceptos, mostraremos cómo configurar a través de Kibana. En el menú de la izquierda hay una sección de Machine Learning, en la que se puede crear una nueva tarea (Job). En la interfaz de Kibana, esto se ve como en la imagen de abajo. Ahora analizaremos cada tipo de tarea y mostraremos los tipos de análisis que se pueden construir aquí.
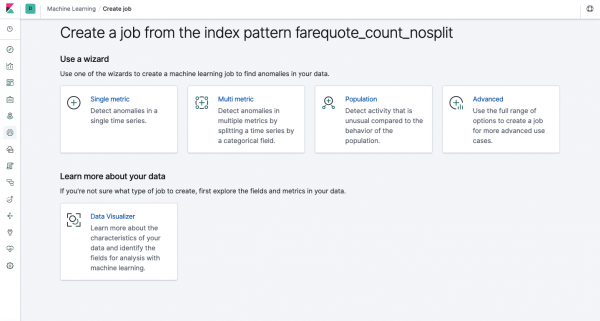
Single Metric — análisis de una métrica, Multi Metric — análisis de dos o más métricas. En ambos casos, cada métrica se analiza en un entorno aislado, es decir, el algoritmo no tiene en cuenta el comportamiento de las métricas analizadas simultáneamente como podría parecer en el caso de Multi Metric. Para realizar un cálculo teniendo en cuenta la correlación de diversas métricas, se puede aplicar análisis de Población. Y Advanced — es la configuración fina de los algoritmos con opciones adicionales para tareas específicas.
Single Metric
El análisis de los cambios de una única métrica es lo más simple que se puede hacer aquí. Después de hacer clic en Crear Job, el algoritmo buscará anomalías.
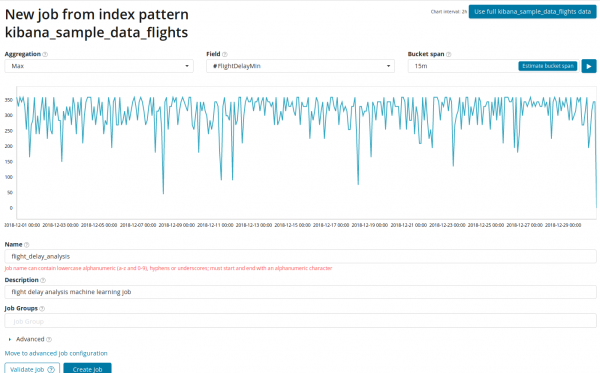
En el campo Aggregation se puede elegir el enfoque para buscar anomalías. Por ejemplo, en Min se considerarán como anómalos los valores por debajo de los típicos. Hay Max, High Mean, Low, Mean, Distinct y otros. La descripción de todas las funciones se puede ver .
En el campo Field se especifica el campo numérico en el documento sobre el que realizaremos el análisis.
En el campo es la granularidad de los intervalos en la línea de tiempo sobre los que se llevará a cabo el análisis. Se puede confiar en la automatización o elegir manualmente. En la imagen de abajo se muestra un ejemplo de granularidad demasiado baja: puedes perder una anomalía. Con esta configuración se puede modificar la sensibilidad del algoritmo a las anomalías.
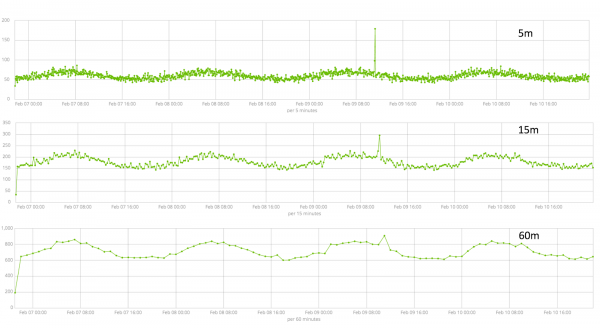
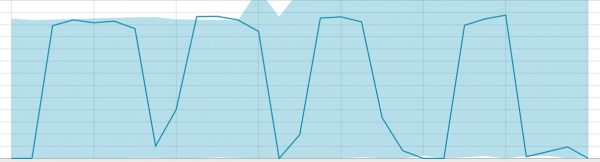
La duración de los datos recopilados es un aspecto clave que influye en la eficacia del análisis. Al analizar, el algoritmo identifica intervalos repetidos, calcula el intervalo de confianza (líneas base) y detecta anomalías: desviaciones inusuales del comportamiento normal de la métrica. Solo como ejemplo:
Líneas base con un pequeño conjunto de datos:
Cuando el algoritmo tiene algo de qué aprender, las líneas base lucen así:
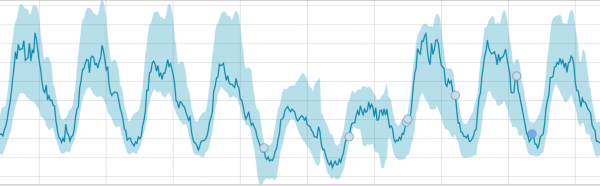
Después de iniciar la tarea, el algoritmo identifica desviaciones anómalas de la norma y las clasifica por probabilidad de anomalía (se indica el color correspondiente entre paréntesis):
Advertencia (azul): menos de 25
Menor (amarillo): 25-50
Mayor (naranja): 50-75
Crítico (rojo): 75-100
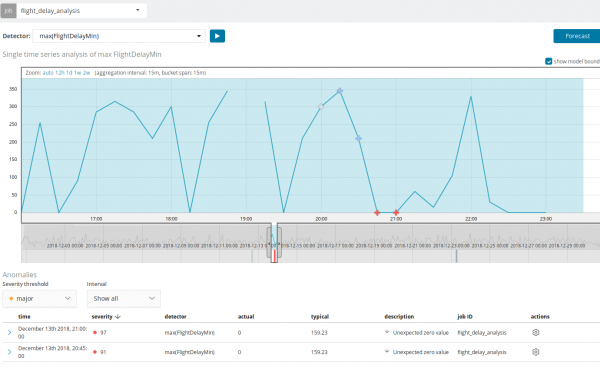
En el gráfico a continuación, un ejemplo con anomalías detectadas.
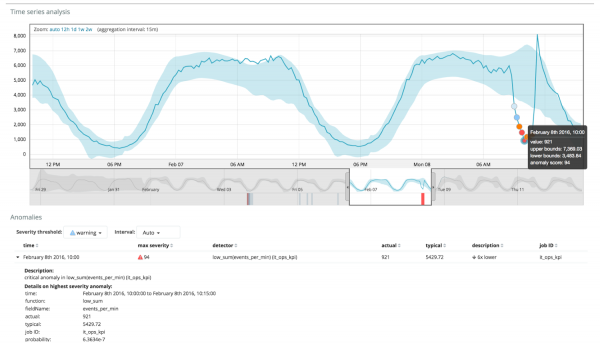
Aquí se muestra el número 94, que indica la probabilidad de anomalía. Es obvio que, dado que el valor está cerca de 100, esto representa una anomalía. En la columna debajo del gráfico se indica una probabilidad despectivamente baja de 0.000063634% de que aparezca ese valor métrico.
Además de buscar anomalías en Kibana, se puede iniciar la predicción. Esto se hace de manera sencilla desde la misma vista con anomalías — botón Prever en la esquina superior derecha.
La predicción se realiza con un máximo de 8 semanas hacia adelante. Incluso si se desea mucho, no se puede más por diseño.
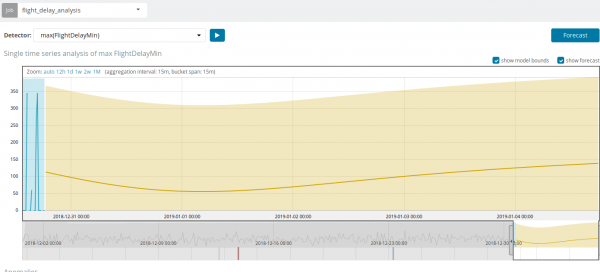
En algunas situaciones, la predicción será muy útil, por ejemplo, cuando se rastrea la carga de usuario en la infraestructura.
Multi Métrica
Pasamos a la siguiente posibilidad de ML en Elastic Stack: el análisis de múltiples métricas en una sola vez. Pero esto no significa que se analizará la dependencia de una métrica sobre la otra. Es lo mismo que Single Metric, solo que con múltiples métricas en una sola pantalla para facilitar la comparación de la influencia de una sobre la otra. Hablaremos sobre el análisis de la dependencia de una métrica sobre otra en la sección de Población.
Después de hacer clic en el cuadrado de Multi Métrica, aparecerá una ventana con la configuración. Nos detendremos en esto con más detalle.
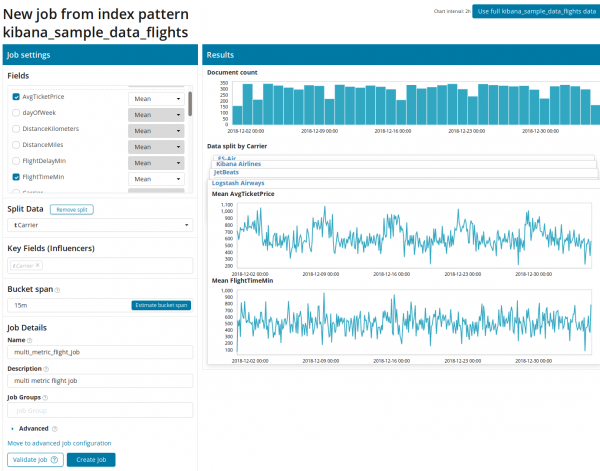
Primero, es necesario seleccionar los campos para el análisis y la agregación de datos por ellos. Las opciones de agregación aquí son las mismas que para Single Metric (Max, High Mean, Low, Mean, Distinct y otros). Luego, los datos se pueden dividir opcionalmente por uno de los campos (el campo Dividir Datos). En el ejemplo lo hicimos por el campo OriginAirportID. Tenga en cuenta que el gráfico de métricas a la derecha ahora se presenta como un conjunto de gráficos.
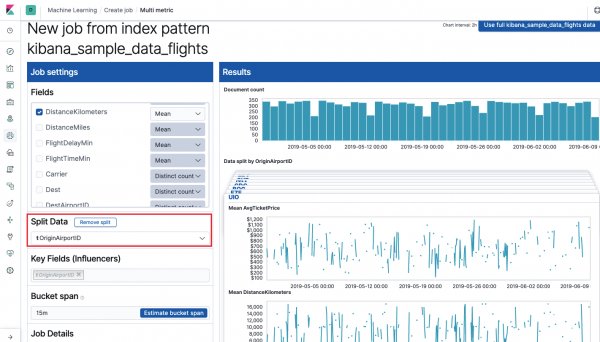
Campo Campos Clave (Influencers) influye directamente en las anomalías encontradas. Por defecto, siempre habrá al menos un valor aquí, y puedes añadir adicionales. El algoritmo tomará en cuenta la influencia de estos campos durante el análisis y mostrará los valores más "influyentes".
Después de iniciar, en la interfaz de Kibana aparecerá algo así.
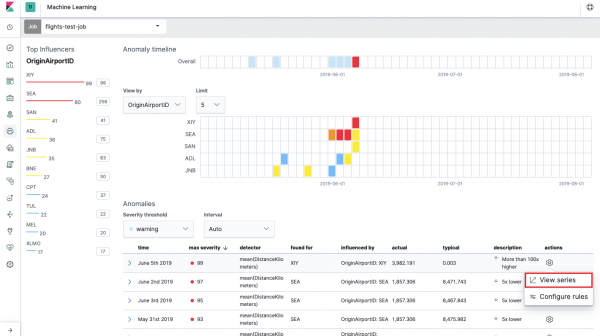
Esta es la llamada mapa térmico de anomalías para cada valor del campo OriginAirportID, que hemos indicado en Dividir Datos. Al igual que en el caso de Single Metric, el color representa el nivel de desviación anómala. Un análisis similar se puede realizar, por ejemplo, para estaciones de trabajo para rastrear aquellas con un número sospechosamente alto de autorizaciones, etc. Ya hemos escrito , que también se pueden recopilar y analizar aquí.
Debajo del mapa térmico hay una lista de anomalías, desde cada una se puede acceder a la vista de Single Metric para un análisis detallado.
Población
Para buscar anomalías entre correlaciones entre diferentes métricas en Elastic Stack, hay un análisis de Población especializado. Es precisamente con su ayuda que se pueden buscar valores anómalos en el rendimiento de un servidor en comparación con los demás al, por ejemplo, aumentar la cantidad de solicitudes al sistema objetivo.
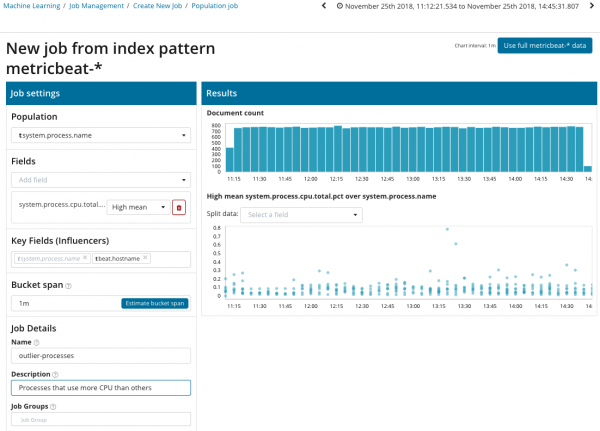
En esta ilustración, el campo de Población indica el valor al que se relacionarán las métricas analizadas. En este caso, es el nombre del proceso. Como resultado, veremos cómo la carga del CPU de cada uno de los procesos influyó entre sí.
Note que el gráfico de datos analizados es diferente en comparación con los casos de Single Metric y Multi Metric. Esto se ha diseñado en Kibana para mejorar la percepción de la distribución de los valores de los datos analizados.
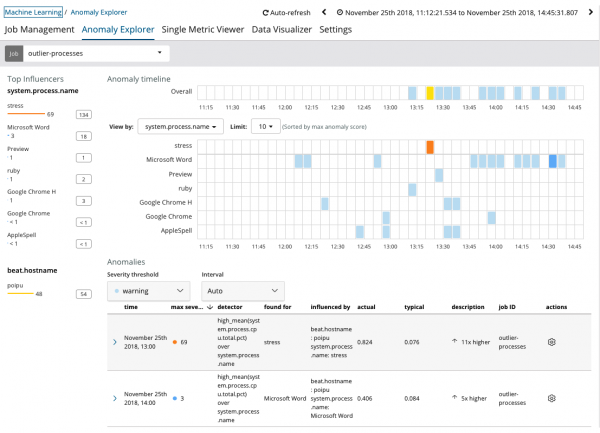
Del gráfico se puede ver que el proceso stress (por cierto, generado por una utilidad especial) en el servidor poipu, que influyó (o fue un influenciador) en la aparición de esta anomalía.
Avanzado
Análisis con ajustes finos. En el análisis Avanzado, aparecen configuraciones adicionales en Kibana. Después de hacer clic en el menú de creación en la opción Avanzado, aparece esta ventana con pestañas. La pestaña Detalles del trabajo se omitió intencionadamente, ya que contiene configuraciones básicas no relacionadas directamente con la configuración del análisis.
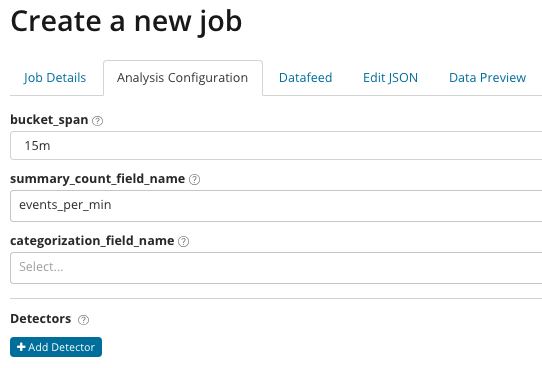
En summary_count_field_name se puede especificar opcionalmente el nombre del campo en los documentos que contiene valores agregados. En este ejemplo, es la cantidad de eventos por minuto. En se indica el nombre del campo del documento que contiene un valor variable. Con la máscara de este campo, se pueden dividir los datos analizados en subconjuntos. Tenga en cuenta el botón Añadir detector en la ilustración anterior. A continuación, el resultado de pulsar este botón.
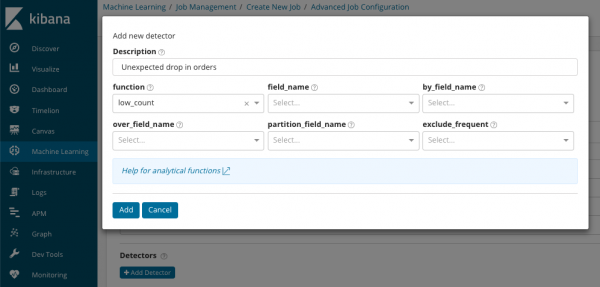
Aquí hay un bloque adicional de configuraciones para ajustar el detector de anomalías a una tarea específica. Los casos de uso concretos (especialmente en materia de seguridad) los abordaremos en artículos posteriores. Por ejemplo, uno de los casos analizados. Está relacionado con la búsqueda de valores raramente aparecidos y se implementa .
En el campo function se puede seleccionar una función específica para la búsqueda de anomalías. Además de rare, hay un par de funciones interesantes más — . Detectan anomalías en el comportamiento de las métricas a lo largo del día o la semana, respectivamente. Las otras funciones de análisis .
En field_name se indica el campo del documento por el cual se realizará el análisis. By_field_name puede usarse para separar los resultados del análisis por cada valor individual del campo del documento aquí indicado. Si se completa over_field_name se obtendrá un análisis de población, el cual discutimos anteriormente. Si se indica un valor en partition_field_name, se calcularán líneas de base separadas para cada valor de este campo del documento (como valores pueden actuar, por ejemplo, el nombre del servidor o del proceso en el servidor). En exclude_frequent se puede seleccionar todo o ninguno, lo que significará la exclusión (o inclusión) de los valores que aparecen con frecuencia en los campos de los documentos.
En este artículo, intentamos presentar de manera concisa las capacidades de aprendizaje automático en Elastic Stack, y han quedado muchos detalles fuera de la discusión. Cuéntenos en los comentarios qué casos han logrado resolver con Elastic Stack y para qué tareas lo utilizan. Para ponerse en contacto con nosotros, puede utilizar mensajes privados en Habr o .
Fuente: habr.com
