

Estas dos palabras de moda relacionadas con la Ciencia de Datos confunden a muchas personas. El Data Mining a menudo se malinterpreta como la extracción y obtención de datos, pero en realidad es mucho más complejo. En esta publicación, aclaremos el Mining y descubramos la diferencia entre Data Mining y Data Extraction.
¿Qué es el Data Mining?
El data mining, también llamado Descubrimiento de conocimiento en bases de datos (KDD), es un método utilizado frecuentemente para analizar grandes volúmenes de datos mediante métodos estadísticos y matemáticos para identificar patrones ocultos o tendencias y extraer valor de ellos.
¿Qué se puede hacer con el Data Mining?
Al automatizar el proceso, pueden examinar bases de datos y detectar patrones ocultos de manera efectiva. Para las empresas, el data mining se utiliza a menudo para identificar patrones y relaciones en los datos, ayudando a tomar decisiones empresariales óptimas.
Ejemplos de aplicación
Después de que el data mining se popularizara en los años 90, empresas de una amplia variedad de industrias, incluyendo comercio minorista, finanzas, salud, transporte, telecomunicaciones, comercio electrónico, etc., comenzaron a utilizar métodos de data mining para obtener información basada en datos. El data mining puede ayudar a segmentar clientes, detectar fraudes, prever ventas y mucho más.
- Segmentación de clientes
Al analizar los datos de los clientes y identificar las características de los clientes objetivo, las empresas pueden agrupados en segmentos separados y ofrecerles ofertas especiales que satisfagan sus necesidades. - Análisis de mercado de cestas
Esta metodología se basa en la teoría de que si compras un cierto grupo de productos, es probable que compres otro grupo de productos. Un ejemplo conocido es: cuando los padres compran pañales para sus bebés, tienden a comprar cerveza junto con los pañales. - Predicción de ventas
Esto puede parecerse al análisis de mercado de cestas, pero esta vez, el análisis de datos se utiliza para predecir cuándo un cliente comprará nuevamente un producto en el futuro. Por ejemplo, un entrenador compra un bote de proteína que debería durar 9 meses. La tienda que vende esta proteína planea lanzar una nueva en 9 meses para que el entrenador la compre nuevamente. - Detección de fraude
La minería de datos ayuda en la construcción de modelos para la detección de fraude. Al reunir muestras de informes fraudulentos y verídicos, las empresas obtienen el derecho a determinar qué operaciones son sospechosas. - Detectar patrones en la producción
En la industria manufacturera, la minería de datos se utiliza para ayudar en el diseño de sistemas, mediante la identificación de relaciones entre la arquitectura del producto, el perfil y las necesidades de los clientes. La minería de datos también puede predecir los plazos de desarrollo del producto y los costos.
Y estos son solo algunos casos de uso de la minería de datos.
Pasos de la minería de datos
La minería de datos es un proceso integral de recolección, selección, limpieza, transformación y extracción de datos para evaluar patrones y, en última instancia, extraer valor.
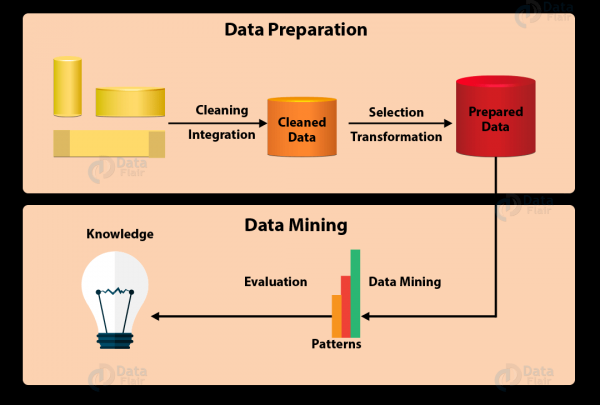
Por lo general, todo el proceso de minería de datos se puede resumir en 7 etapas:
- Limpieza de datos
En el mundo real, los datos no siempre están limpios y estructurados. A menudo son ruidosos, incompletos y pueden contener errores. Para asegurar que el resultado de la minería de datos sea preciso, primero es necesario limpiar los datos. Algunos métodos de limpieza incluyen rellenar valores faltantes, controles automáticos y manuales, etc. - Integración de datos
Esta es la etapa en la que los datos de diferentes fuentes son extraídos, combinados e integrados. Las fuentes pueden ser bases de datos, archivos de texto, hojas de cálculo, documentos, arreglos de datos multidimensionales, internet, etc. - Muestreo de datos
Normalmente, no todos los datos integrados son necesarios en la minería de datos. El muestreo de datos es la etapa en la que se seleccionan y extraen solo los datos útiles de una gran base de datos. - Transformación de datos.
Después de seleccionar los datos, se transforman a formas adecuadas para la minería. Este proceso incluye normalización, agregación, generalización, etc. - Análisis inteligente de datos
Aquí es donde llega la parte más importante de la minería de datos: el uso de métodos inteligentes para identificar patrones en ellos. El proceso incluye regresión, clasificación, pronóstico, agrupamiento, descubrimiento de asociaciones y mucho más. - Evaluación del modelo
Esta etapa tiene como objetivo identificar patrones potencialmente útiles, fáciles de entender, así como patrones que confirmen hipótesis. - Presentación de conocimientos
En la etapa final, la información obtenida se presenta de manera atractiva utilizando métodos de representación del conocimiento y visualización.
Desventajas de la minería de datos
- Grandes inversiones de tiempo y esfuerzo
Dado que la minería de datos es un proceso prolongado y complejo, requiere un gran trabajo de personas productivas y cualificadas. Los especialistas en análisis de datos pueden utilizar potentes herramientas de minería de datos, pero necesitan expertos para la preparación de datos y la comprensión de los resultados. Como resultado, procesar toda la información puede llevar un tiempo considerable. - Privacidad y seguridad de los datos
Dado que la minería de datos recopila información sobre los clientes mediante métodos de mercado, puede violar la confidencialidad de los usuarios. Además, los hackers pueden obtener datos almacenados en los sistemas de minería de datos. Esto representa una amenaza para la seguridad de los datos de los clientes. Si los datos robados se utilizan incorrectamente, pueden causar daño fácilmente a otros.
Lo anterior es una breve introducción a la minería de datos. Como mencioné, la minería de datos incluye el proceso de recopilación e integración de datos, que comprende el proceso de extracción de datos. En este caso, se puede afirmar con confianza que la extracción de datos puede ser parte de un proceso prolongado de minería de datos.
¿Qué es la Extracción de Datos?
También conocido como «extracción de datos web» y «web scraping», este proceso es el acto de extraer datos de fuentes de datos (generalmente no estructuradas o mal estructuradas) a ubicaciones centralizadas y centralizarlas en un solo lugar para su almacenamiento o procesamiento posterior. En particular, las fuentes de datos no estructuradas incluyen páginas web, correos electrónicos, documentos, archivos PDF, texto escaneado, informes de mainframe, archivos en cinta, anuncios, etc. Los almacenes centralizados pueden ser locales, en la nube o híbridos. Es importante recordar que la extracción de datos no incluye procesamiento o análisis adicional que pueda ocurrir posteriormente.
¿Qué se puede hacer con la Extracción de Datos?
En general, los objetivos de la extracción de datos se dividen en 3 categorías.
- Archivado
La extracción de datos puede transformar datos de formatos físicos: libros, periódicos, facturas, a formatos digitales, como bases de datos para almacenamiento o copias de seguridad. - Cambio de formato de datos
Cuando desea transferir datos de su sitio actual a uno nuevo en desarrollo, puede recopilar datos desde su propio sitio extrayéndolos. - Análisis de datos
A menudo se realiza un análisis adicional sobre los datos extraídos para obtener una visión de ellos. Esto puede parecerse al análisis de datos en data mining, pero tenga en cuenta que el análisis de datos es el objetivo de su extracción, no una parte de ella. Además, los datos se analizan de manera diferente. Un ejemplo: los propietarios de tiendas en línea extraen información sobre productos de sitios de comercio electrónico como Amazon para monitorear estrategias competitivas en tiempo real. Al igual que el data mining, la extracción de datos es un proceso automatizado que tiene múltiples ventajas. Antes, las personas copiaban y pegaban datos manualmente de un lugar a otro, lo que consumía mucho tiempo. La extracción de datos acelera la recopilación y aumenta significativamente la precisión de los datos extraídos.
Algunos ejemplos de aplicación de la extracción de datos
Al igual que el data mining, la extracción de datos se utiliza ampliamente en varias industrias. Aparte del monitoreo de precios en comercio electrónico, la extracción de datos puede ayudar en investigación propia, agregación de noticias, marketing, en el sector inmobiliario, viajes y turismo, en consultoría, finanzas y mucho más.
- Generación de leads
Las empresas pueden extraer datos de directorios: Yelp, Crunchbase, Yellowpages y generar leads para el desarrollo del negocio. Puede ver el video a continuación para aprender cómo extraer datos de Yellowpages utilizando . - Agregación de contenido y noticias
Los sitios web que agregan contenido pueden recibir flujos regulares de datos de múltiples fuentes y mantener sus sitios actualizados. - Análisis de sentimientos
Después de extraer reseñas, comentarios y opiniones de redes sociales como Instagram y Twitter, los especialistas pueden analizar las opiniones subyacentes y obtener información sobre cómo se percibe la marca, el producto o un fenómeno en particular.
Pasos de extracción de datos
La extracción de datos es la primera etapa de ETL (Extract, Transform, Load: extracción, transformación, carga) y ELT (extracción, carga y transformación). ETL y ELT son parte de una estrategia completa de integración de datos. En otras palabras, la extracción de datos puede ser parte de su extracción.
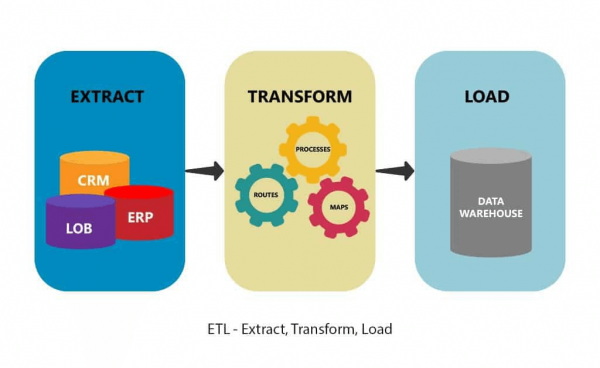
Extracción, transformación, carga
Mientras que el data mining se refiere a la obtención de información de grandes volúmenes de datos, la extracción de datos es un proceso mucho más corto y simple. Se puede resumir en tres etapas:
- Selección de la fuente de datos
Seleccione la fuente de la que desea extraer datos, por ejemplo, un sitio web. - Recopilación de datos
Envíe una solicitud ‘GET’ al sitio y analice el documento HTML recibido utilizando lenguajes de programación como Python, PHP, R, Ruby, entre otros. - Almacenamiento de datos
Guarde los datos en su base de datos local o en almacenamiento en la nube para uso futuro. Si usted es un programador experimentado que desea extraer datos, los pasos anteriores pueden parecerle simples. Sin embargo, si no programa, hay un camino más corto: utilizar herramientas de extracción de datos, como . Las herramientas de extracción de datos, al igual que las herramientas de data mining, están diseñadas para ahorrar esfuerzo y hacer que el procesamiento de datos sea sencillo para todos. Estas herramientas no solo son asequibles, sino que también son amigables para principiantes. Permiten a los usuarios recopilar datos en minutos, almacenarlos en la nube y exportarlos a muchos formatos: Excel, CSV, HTML, JSON o bases de datos en el sitio a través de API.
Desventajas de la extracción de datos
- Fallo del servidor
Cuando se extraen datos a gran escala, el servidor web del sitio objetivo puede estar sobrecargado, lo que puede llevar a la caída del servidor. Esto perjudica los intereses del propietario del sitio. - Bloqueo por IP
Cuando una persona recopila datos con demasiada frecuencia, los sitios web pueden bloquear su dirección IP. El recurso puede prohibir completamente la IP o limitar el acceso, haciendo que los datos sean incompletos. Para extraer datos y evitar el bloqueo, es necesario hacerlo a una velocidad moderada y aplicar algunos métodos de anti-bloqueo. - Problemas legales
La extracción de datos de la web entra en una zona gris en términos de legalidad. Sitios grandes como LinkedIn y Facebook dejan claro en sus términos de uso que cualquier extracción automática de datos está prohibida. Ha habido numerosas demandas entre empresas debido a las actividades de los bots.
Principales diferencias entre Data Mining y Data Extraction
- El data mining también se conoce como descubrimiento de conocimiento en bases de datos, extracción de conocimientos, análisis de datos/patrones, recopilación de información. La extracción de datos se usa de manera intercambiable con la extracción de datos web, el raspado de páginas web, la recopilación de datos, etc.
- Las investigaciones de data mining se basan principalmente en datos estructurados, mientras que la extracción de datos generalmente se realiza a partir de fuentes no estructuradas o mal estructuradas.
- El objetivo del data mining es hacer que los datos sean más útiles para el análisis. La extracción de datos es la recolección de datos en un solo lugar donde pueden ser almacenados o procesados.
- El análisis en el data mining se basa en métodos matemáticos para identificar patrones o tendencias. La extracción de datos se fundamenta en lenguajes de programación o herramientas de extracción de datos para navegar por las fuentes.
- El objetivo del data mining es encontrar hechos que anteriormente no eran conocidos o que fueron ignorados, mientras que la extracción de datos trata con información existente.
- El data mining es más complejo y requiere una mayor inversión en formación de personal. La extracción de datos, al utilizar la herramienta adecuada, puede ser extremadamente simple y económica.
Ayudamos a los principiantes a no confundirse con los Datos. Especialmente para los usuarios de Habr, hemos creado un código promocional HABR, que ofrece un 10% de descuento adicional sobre el descuento indicado en el banner.
Más cursos
Artículos recomendados
Fuente: habr.com
