

En el artículo anterior, hablé sobre los fundamentos de DATA VAULT, describí los elementos principales de DATA VAULT y su propósito. Sin embargo, no se puede considerar que el tema de DATA VAULT esté agotado; es necesario hablar sobre las siguientes etapas de la evolución de DATA VAULT.
En este artículo, me concentraré en el desarrollo de DATA VAULT y la transición a BUSINESS DATA VAULT o simplemente BUSINESS VAULT.
Causas de la aparición de BUSINESS DATA VAULT
Cabe destacar que, aunque DATA VAULT tiene ciertas fortalezas, también presenta desventajas. Una de esas desventajas es la complejidad en la redacción de consultas analíticas. Las consultas tienen un número significativo de JOINs, lo que hace que el código sea largo y engorroso. Además, los datos que ingresan a DATA VAULT no sufren ninguna transformación, por lo que desde el punto de vista empresarial, DATA VAULT en su forma pura no tiene un valor absoluto.
Precisamente para eliminar estas desventajas, la metodología DATA VAULT se ha ampliado con elementos como:
- tablas PIT (point in time);
- tablas BRIDGE;
- DERIVACIONES PREDEFINIDAS.
Analicemos más detalladamente el propósito de estos elementos.
Tablas PIT
Por lo general, un objeto de negocio (HUB) puede contener datos con diferentes frecuencias de actualización; por ejemplo, si hablamos de datos que caracterizan a una persona, podemos decir que la información sobre el número de teléfono, la dirección o el correo electrónico tiene una frecuencia de actualización más alta que, digamos, el nombre completo, los datos del pasaporte, el estado civil o el género.
Por lo tanto, al definir los satélites, es importante tener en cuenta su frecuencia de actualización. ¿Por qué es esto importante?
Si se almacenan atributos con diferentes frecuencias de actualización en una sola tabla, será necesario agregar una fila a la tabla cada vez que se actualice el atributo que cambia con mayor frecuencia. Como consecuencia, habrá un aumento en el volumen del espacio en disco y en el tiempo de ejecución de las consultas.
Ahora que hemos dividido los satélites según la frecuencia de actualización y podemos cargar datos en ellos de forma independiente, debemos garantizar la posibilidad de obtener datos actualizados. Mejor, sin el uso de JOINs innecesarios.
Por ejemplo, se necesita obtener información actual (de acuerdo con la fecha de la última actualización) de satélites que tienen diferentes frecuencias de actualización. Para esto, no solo será necesario hacer un JOIN, sino también crear varias subconsultas (para cada satélite que contenga información) seleccionando la fecha máxima de actualización MAX(Fecha de actualización). Con cada nuevo JOIN, este código crece y se vuelve rápidamente difícil de entender.
La tabla PIT tiene como objetivo simplificar tales consultas; las tablas PIT se llenan simultáneamente con el registro de nuevos datos en el DATA VAULT. Tabla PIT:
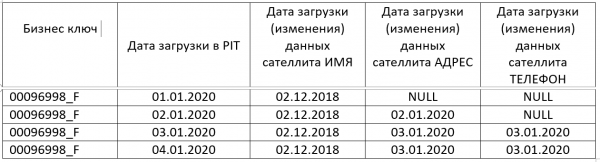
De este modo, tenemos información sobre la actualidad de los datos de todos los satélites en cada momento. Al utilizar JOINs a la tabla PIT, podemos eliminar por completo las subconsultas, siempre que la PIT se llene diariamente y sin omisiones. Incluso si hay omisiones en la PIT, se pueden obtener datos actuales utilizando solo una subconsulta a la propia PIT. Una subconsulta funcionará más rápido que las subconsultas a cada satélite.
BRIDGE
Las tablas tipo BRIDGE también se utilizan para simplificar consultas analíticas. Sin embargo, a diferencia de la PIT, su fin es simplificar y acelerar las consultas entre diferentes hubs, links y sus satélites.
La tabla contiene todas las claves necesarias para todos los satélites, que se utilizan frecuentemente en las consultas. Además, si es necesario, las claves de negocio hash pueden complementarse con claves en texto si se requieren los nombres de las claves para el análisis.
El hecho es que sin el uso de BRIDGE, al obtener datos de los satélites pertenecientes a diferentes hubs, será necesario realizar JOIN no solo entre los satélites, sino también entre los links que conectan los hubs.
La existencia o ausencia de BRIDGE se determina por la configuración del almacenamiento y la necesidad de optimizar la velocidad de ejecución de las consultas. Es difícil inventar un ejemplo universal de BRIDGE.
DERIVACIONES PREDEFINIDAS
Otro tipo de objetos que nos acerca al BUSINESS DATA VAULT son las tablas que contienen indicadores previamente calculados. Estas tablas son verdaderamente importantes para el negocio, ya que contienen información agregada según ciertas reglas y permiten acceder a ella de manera relativamente sencilla.
Las DERIVACIONES PREDEFINIDAS arquitectónicas son, nada menos, que otro satélite de un hub específico. Al igual que un satélite común, contiene la clave del negocio y la fecha en que se creó el registro en el satélite. Sin embargo, ahí es donde terminan las semejanzas. La composición adicional de los atributos de tal "satélite especializado" se determina por los usuarios empresariales en base a los indicadores más demandados y previamente calculados.
Por ejemplo, un hub que contiene información sobre un empleado puede incluir un satélite con indicadores como:
- Salario mínimo;
- Salario máximo;
- Salario medio;
- Total acumulado de salarios devengados, etc.
Es lógico incluir las DERIVACIONES PREDEFINIDAS en la tabla PIT de este mismo hub, ya que de este modo se pueden obtener fácilmente cortes de datos sobre el empleado en una fecha específica.
CONCLUSIONES
Como muestra la práctica, el uso de DATA VAULT por parte de los usuarios empresariales es algo complicado por varias razones:
- El código de las consultas es complejo y voluminoso;
- La abundancia de JOINs afecta al rendimiento de las consultas;
- Para redactar consultas analíticas se requiere un excelente conocimiento de la estructura del almacén de datos.
Para facilitar el acceso a los datos, el DATA VAULT se amplía con objetos adicionales:
- tablas PIT (point in time);
- tablas BRIDGE;
- DERIVACIONES PREDEFINIDAS.
En la siguiente tengo la intención de hablar sobre lo que considero más interesante para quienes trabajan con BI. Presentaré formas de crear tablas de hechos y tablas de dimensiones basadas en DATA VAULT.
Los materiales del artículo se basan en:
- En de Kenta Graziano, que además de una descripción detallada incluye diagramas del modelo;
- El libro: "Construyendo un Almacén de Datos Escalable con DATA VAULT 2.0";
- Artículo .
Fuente: habr.com
