

Teníamos 2 bolsas de hierba, 75 tabletas de mescalina, un entorno unix, un repositorio de docker y la tarea de implementar los comandos docker pull y docker push sin el cliente de docker.
UPD:
Pregunta: ¿Para qué todo esto?
Respuesta: Pruebas de carga del producto (NO a través de bash, los scripts se presentan con fines educativos). Se decidió no usar el cliente de docker para reducir las capas adicionales (dentro de lo razonable) y, por ende, emular una carga más alta. Como resultado, eliminamos todas las latencias sistémicas del cliente de docker. Obtuvimos una carga relativamente limpia directamente en el producto.
En el artículo se utilizaron herramientas de versiones de GNU.
Primero, vamos a entender qué hacen estos comandos.
Entonces, ¿para qué se usa docker pull? De acuerdo con :
"Tirar una imagen o un repositorio de un registro".
Allí también encontramos un enlace a .
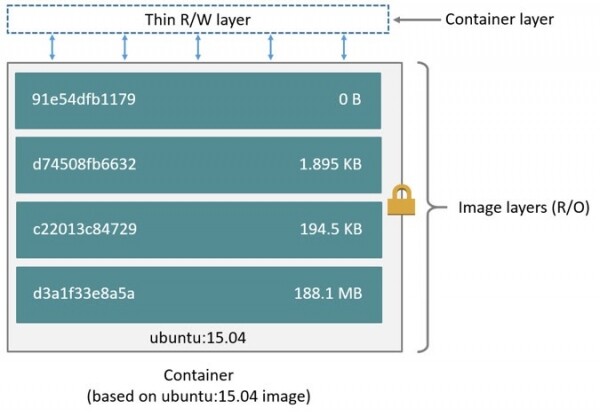
De aquí podemos entender que docker image es un conjunto de capas que contienen información sobre los últimos cambios en la imagen, que evidentemente necesitamos. Luego miramos en .
Aquí se dice lo siguiente:
"Una 'imagen' es una combinación de un manifiesto JSON y archivos de capa individuales. El proceso de tirar una imagen se centra en recuperar estos dos componentes."
Así que el primer paso según la documentación es “Tirando un Manifiesto de Imagen”.
No lo estaremos tirando, pero necesitamos los datos de él. A continuación se muestra un ejemplo de solicitud: GET /v2/{name}/manifests/{reference}
"El nombre y el parámetro de referencia identifican la imagen y son obligatorios. La referencia puede incluir una etiqueta o un digest."
Nuestro repositorio de docker está desplegado localmente, intentemos realizar la solicitud:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
Como respuesta, recibimos un json del cual nos interesan en este momento solo las capas, más exactamente sus hashes. Después de obtenerlos, podemos recorrer cada uno y hacer la siguiente solicitud: "GET /v2/{name}/blobs/{digest}"
“El acceso a una capa estará restringido por el nombre del repositorio, pero se identifica de manera única en el registro por digest.”
digest en este caso es el hash que obtuvimos.
Probamos
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
veamos qué archivo obtuvimos como primer layer.
file firstLayer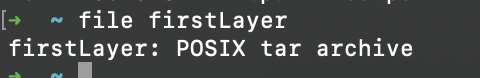
es decir, las capas son archivos tar, descomprimiéndolos en el orden correspondiente obtendremos el contenido de la imagen.
Escribamos un pequeño script en bash para automatizar todo esto.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Ahora podemos ejecutarlo con los parámetros deseados y obtener el contenido de la imagen necesaria.
.\/script.sh dirName "http:\/\/localhost:8081\/link\/to\/docker\/registry" myAwesomeImage 1.0Parte 2 — docker push
Aquí será un poco más complicado.
Comencemos de nuevo con . Así que necesitamos cargar cada capa, compilar el manifiesto correspondiente y cargarlo también. Suena sencillo.
Al revisar la documentación, podemos dividir el proceso de carga en varios pasos:
- Inicialización del proceso — "POST \/v2\/{repoName}\/blobs\/uploads\/"
- Carga de la capa (usaremos carga monolítica, es decir, enviamos cada capa en su totalidad) — "PUT \/v2\/{repoName}\/blobs\/uploads\/{uuid}?digest={digest}
Content-Length: {size of layer}
Content-Type: application\/octet-stream
Datos binarios de la capa". - Carga del manifiesto — "PUT \/v2\/{repoName}\/manifests\/{reference}".
Pero en la documentación se omitió un paso, sin el cual nada funcionará. Para la carga monolítica, así como para la carga parcial (chunked), antes de cargar la capa es necesario realizar una solicitud PATCH:
"PATCH \/v2\/{repoName}\/blobs\/uploads\/{uuid}
Content-Length: {size of chunk}
Content-Type: application\/octet-stream
{Layer Chunk Binary Data}".
De lo contrario, no podrás avanzar más allá del primer paso, ya que en lugar del código de respuesta esperado 202 recibirás 4xx.
Ahora el algoritmo se ve así:
- Inicialización
- Parchear la capa
- Cargar la capa
- Cargar el manifiesto
Los pasos 2 y 3 se repetirán tantas veces como capas sea necesario cargar.
Para empezar, necesitaremos cualquier imagen. Yo usaré archlinux:latest
docker pull archlinux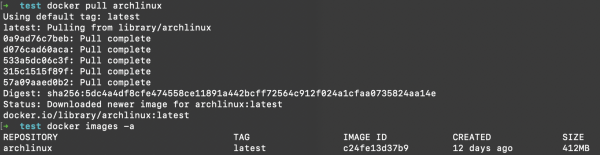
Ahora lo guardaremos localmente para su posterior análisis.
docker save c24fe13d37b9 -o savedArch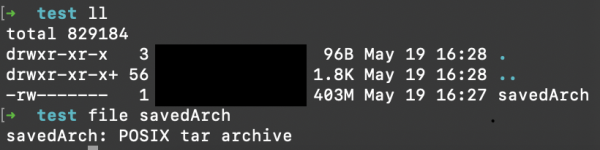
Descomprimimos el archivo obtenido en el directorio actual.
tar xvf savedArch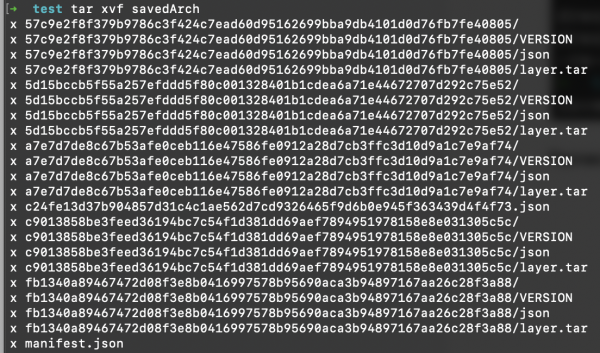
Como vemos, cada capa se encuentra en una carpeta separada. Ahora veamos la estructura del manifiesto que hemos obtenido.
cat manifest.json | json_pp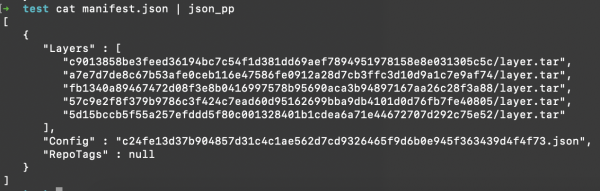
No es mucho. Veamos qué manifiesto se necesita para la carga, de acuerdo con .
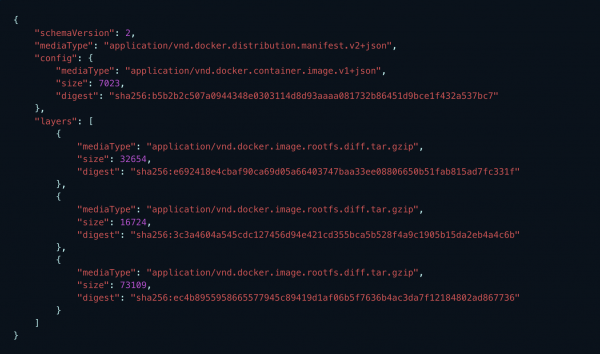
Obviamente, el manifiesto existente no nos sirve, así que haremos el nuestro con capas y configuraciones.
Siempre tendremos al menos un archivo de configuración y un array de capas. La versión del esquema es 2 (actual al momento de escribir este artículo), dejaremos mediaType sin cambios:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Después de crear el manifiesto base, es necesario llenarlo con datos válidos. Para ello, usamos la plantilla del objeto JSON de la capa:
{
         "mediaType": "application\/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      },
lo añadiremos al manifiesto para cada capa.
A continuación, necesitamos conocer el tamaño del archivo de configuración y reemplazar los marcadores en el manifiesto con los datos reales
sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFileAhora podemos iniciar el proceso de carga y guardar el uuid, que debe acompañar todas las solicitudes posteriores.
El script completo se ve aproximadamente así:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
podemos usar un script ya preparado:
./uploadImage.sh "~\/path\/to\/saved\/image" "http:\/\/localhost:8081\/link\/to\/docker\/registry" myRepoName 1.0UPD:
¿Qué hemos obtenido como resultado?
En primer lugar, datos reales para el análisis, ya que las pruebas se ejecutan en blazemeter y los datos de las solicitudes del cliente docker son bastante poco informativos en comparación con las solicitudes HTTP limpias.
En segundo lugar, la transición nos permitió aumentar la cantidad de usuarios virtuales para la carga de docker aproximadamente en un 150% y lograr un tiempo de respuesta promedio de un 20-25% más rápido. Para la descarga de docker, logramos aumentar la cantidad de usuarios en un 500%, y el tiempo de respuesta promedio se redujo aproximadamente en un 60%.
Gracias por su atención.
Fuente: habr.com
