

Hoy les contaré una historia. La historia de la evolución de la informática y la aparición de los espacios de trabajo remotos desde tiempos antiguos hasta nuestros días.
Desarrollo de TI
Lo principal que se puede aprender de la historia de TI es...
Por supuesto, que TI se desarrolla en espiral. Las mismas soluciones y conceptos que fueron desechados hace décadas adquieren un nuevo significado y comienzan a funcionar con éxito en nuevas condiciones, ante nuevos desafíos y con nuevas capacidades. En esto, TI no es diferente de ninguna otra área del conocimiento humano y de la historia de la Tierra en general.
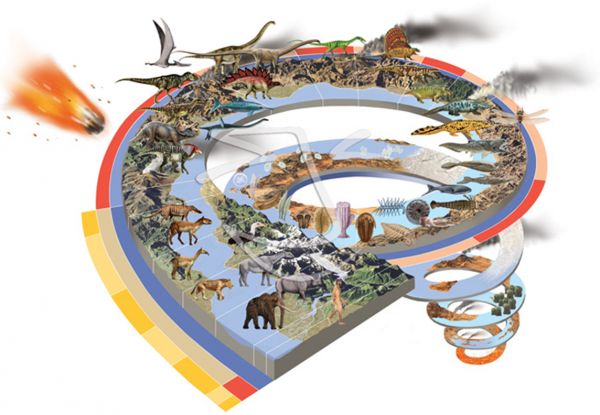
Hace mucho tiempo, cuando las computadoras eran grandes
"Creo que en el mundo hay mercado para unos cinco computadoras", dijo Thomas Watson, presidente de IBM, en 1943.
La tecnología informática temprana era grande. No, es incorrecto, la tecnología temprana era monstruosa, ciclópea. Una máquina computacional completa ocupaba un área comparable a la de un gimnasio y costaba sumas absolutamente irreales. Como ejemplo de componentes, se puede mencionar un módulo de memoria RAM en anillos de ferrita (1964).
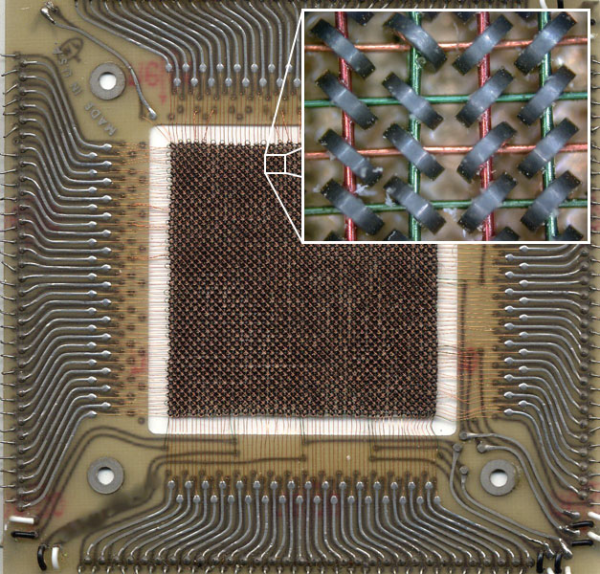
Este módulo tiene un tamaño de 11 cm x 11 cm y una capacidad de 512 bytes (4096 bits). Un armario completamente lleno de estos módulos apenas tenía la capacidad de un disquete de 3,5" (1.44 MB = 2950 módulos), consumía una cantidad considerable de electricidad y se calentaba como una locomotora.
El nombre en inglés para depurar código de programas — "debugging" — está relacionado con los enormes tamaños. Una de las primeras programadoras en la historia, Grace Hopper (sí, una mujer), oficial de la marina, hizo en 1945 una anotación en su diario después de investigar una falla en un programa.
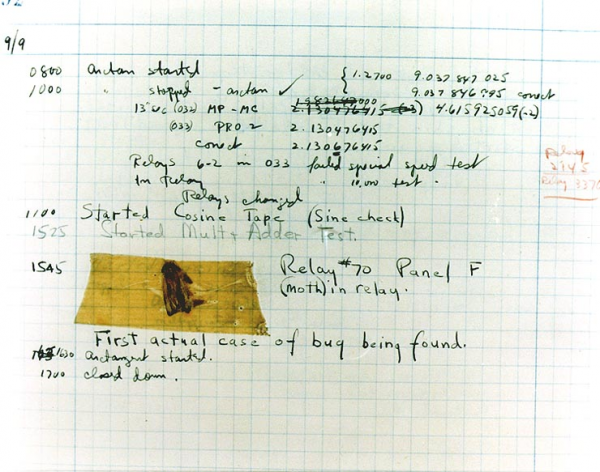
Dado que moth (polilla) en general es un bug (insecto), todos los problemas y acciones tomadas para su resolución fueron informados al personal como "debugging" (literalmente, desinsectación), de aquí que el fallo en el programa y el error en el código se afianzara con el nombre bug, y la depuración se convirtiera en debugging.
A medida que la electrónica y, en particular, la electrónica de semiconductores se desarrollaron, las dimensiones físicas de las máquinas comenzaron a disminuir, mientras que su potencia de cálculo aumentaba. Pero incluso en este caso no se podía asignar una computadora a cada persona.
"No hay razón para que alguien quisiera tener una computadora en casa" — Ken Olsen, fundador de DEC, 1977.
En los años 70 aparece el término miniordenador. Recuerdo que cuando leí por primera vez este término hace muchos años, me imaginé algo parecido a un netbook, prácticamente una computadora de mano. No podría haber estado más lejos de la verdad.
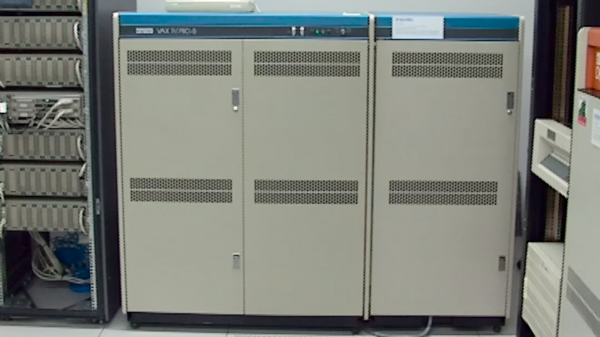
Mini — solo en comparación con las enormes salas de máquinas, pero aún así se trata de varios armarios con equipos que cuestan cientos de miles y millones de dólares. Sin embargo, la potencia de cálculo ya había aumentado lo suficiente como para que no siempre estuviera al 100% de carga, y al mismo tiempo, las computadoras comenzaron a estar disponibles para estudiantes y profesores universitarios.
¡Y aquí llegó ÉL!
Pocos reflexionan sobre las raíces latinas del idioma inglés, pero fue eso lo que nos trajo el acceso remoto tal como lo conocemos hoy en día. Terminus (latín) — fin, límite, objetivo. El objetivo del Terminator T800 era acabar con la vida de John Connor. También sabemos que las estaciones de transporte, donde se realiza el embarque y desembarque de pasajeros o la carga y descarga de mercancías, se llaman terminales — destinos finales de las rutas.
Así surgió el concepto de acceso terminal, y puedes ver el terminal más famoso del mundo, que todavía vive en nuestros corazones.
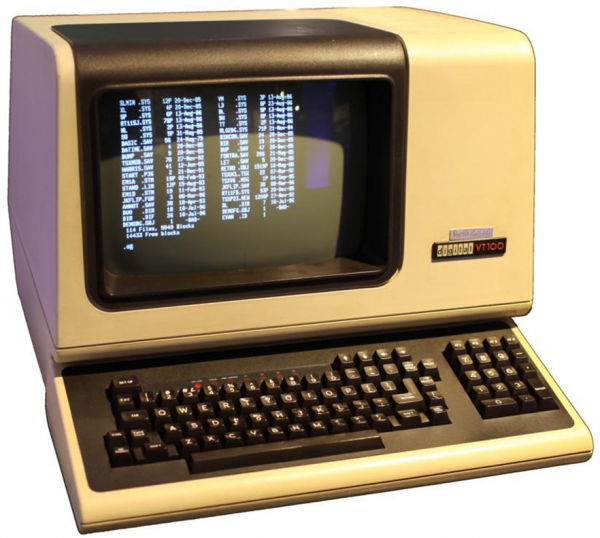
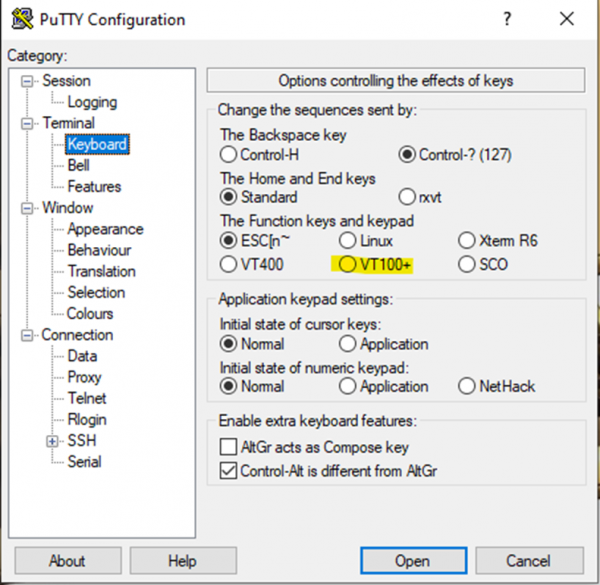
El DEC VT100 se llama terminal porque cierra la línea de información. Tiene prácticamente cero potencia de cálculo, y su única tarea es mostrar la información recibida de una gran máquina y transmitir la entrada del teclado a la máquina. Y aunque los VT100 físicamente han muerto hace mucho tiempo, aún los usamos en su totalidad.
Nuestros días
Yo empezaría a contar "nuestros días" desde principios de los años 80, con la aparición de los primeros procesadores accesibles al público con una potencia de cálculo significativa. Se considera tradicionalmente que el procesador principal de esta época fue el Intel 8088 (familia x86) como el precursor de la arquitectura triunfante. ¿Cuál es entonces la diferencia fundamental con el concepto de los años 70?
Por primera vez, aparece la tendencia de trasladar el procesamiento de información del centro a la periferia. No todas las tareas requieren las enormes capacidades de un mainframe o incluso de una mini computadora en comparación con un débil x86. Intel no se detiene, en los años 90 lanza la familia Pentium, que se convierte en la primera computadora personal de masas en Rusia. Estos procesadores ya son capaces de hacer mucho más que escribir una carta; también manejan multimedia y trabajan con pequeñas bases de datos. De hecho, para las pequeñas empresas, ya no es necesario tener servidores; todo se puede realizar en la periferia, en las máquinas de los clientes. Con cada año que pasa, los procesadores son más potentes, y la brecha entre servidores y computadoras personales se reduce cada vez más en términos de potencia de cálculo, a menudo diferenciándose solo en la reserva de energía, el soporte para el reemplazo en caliente y las estructuras especiales para montaje en racks.
Si comparamos los procesadores de cliente actuales, que parecen 'ridículos' para los administradores de servidores pesados de Intel en los años 90, con los supercomputadores del pasado, la sensación es un poco incómoda.
Vamos a echar un vistazo al anciano, que es prácticamente de mi generación. Cray X-MP/24 de 1984.
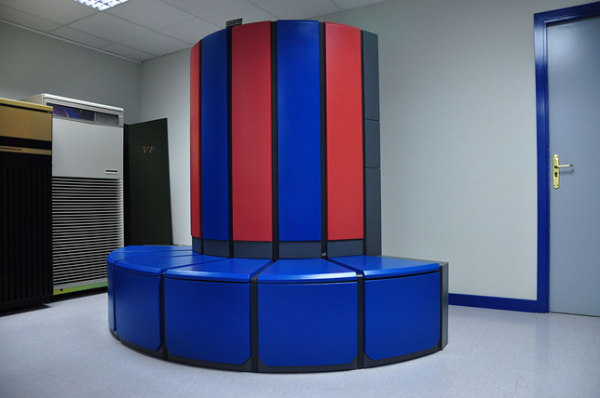
Esta máquina estaba en la parte superior de los supercomputadores de 1984, con 2 procesadores de 105 MHz y una potencia de cálculo máxima de 400 MFlops (millones de operaciones de punto flotante). La máquina que se muestra en la foto estaba en el laboratorio de criptografía de la NSA de EE. UU., y se dedicaba a romper códigos. Si convertimos 15 millones de dólares de 1984 a dólares de 2020, el costo sería de 37.4 millones, o 93,500 dólares por MFlops.
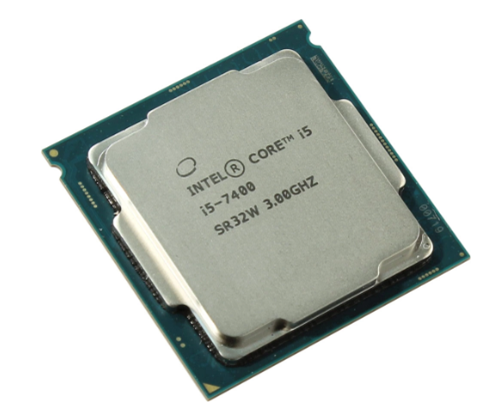
En la máquina en la que estoy escribiendo estas líneas, hay un procesador Core i5-7400 de 2017, que no es nuevo, y que en el año de su lanzamiento era el más joven de todos los procesadores de nivel medio de 4 núcleos. 4 núcleos a 3.0 GHz de frecuencia base (3.5 con Turbo Boost) y el doble de hilos con HyperThreading proporcionan entre 19 y 47 GFlops de potencia en diferentes pruebas a un precio de 16,000 rublos por procesador. Si se arma la máquina completa, su costo se puede considerar en 750 dólares (a precios y tipos de cambio del 1 de marzo de 2020).
Al final, obtenemos una superioridad de un procesador de escritorio bastante promedio de nuestros días de 50 a 120 veces sobre un supercomputador de la lista de los 10 mejores de un pasado relevante, y la caída del costo unitario de MFlops se vuelve verdaderamente monstruosa: 93,500 / 25 = 3,700 veces.
¡No entiendo por qué todavía necesitamos servidores y centralización de computación con tales capacidades en el extremo!
El retroceso: la espiral ha dado una vuelta
Estaciones sin disco
La primera señal de que la computación en la periferia no será definitiva fue la aparición de la tecnología de estaciones de trabajo sin disco. Con una gran distribución de estaciones de trabajo en el territorio de la empresa, y especialmente en ambientes contaminados, surge la cuestión de la gestión y el soporte de estas estaciones de manera muy contundente.
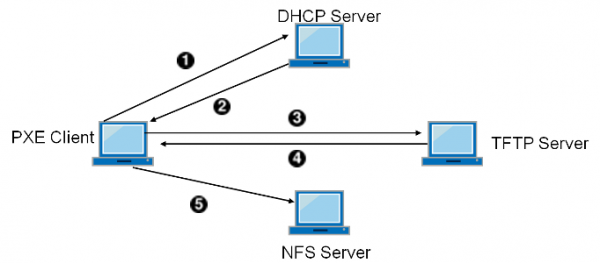
Aparece el concepto de “tiempo en el pasillo” — el porcentaje de tiempo que el empleado de soporte técnico pasa en el pasillo, de camino hacia el empleado que tiene un problema. Este tiempo se paga, pero es completamente improductivo. Un papel importante, especialmente en ambientes contaminados, lo desempeñan las fallas de los discos duros. Vamos a quitar el disco de la estación de trabajo y haremos todo a través de la red, incluida la carga. El adaptador de red recibe, además de la dirección de un servidor DHCP, información adicional: la dirección del servidor TFTP (un servicio de archivos simplificado) y el nombre de la imagen de arranque, la carga en la memoria y arranca la máquina.
Además de reducir el número de fallas y disminuir el tiempo en el pasillo, ahora no es necesario ajustar la máquina en el lugar, simplemente se puede llevar una nueva y recoger la antigua para su diagnóstico en un lugar de trabajo equipado. ¡Pero eso no es todo!
La estación sin disco se vuelve significativamente más segura: si alguien irrumpe en la sala y se lleva todos los ordenadores, solo se perderá el equipo. Ningún dato se almacena en las estaciones sin disco.
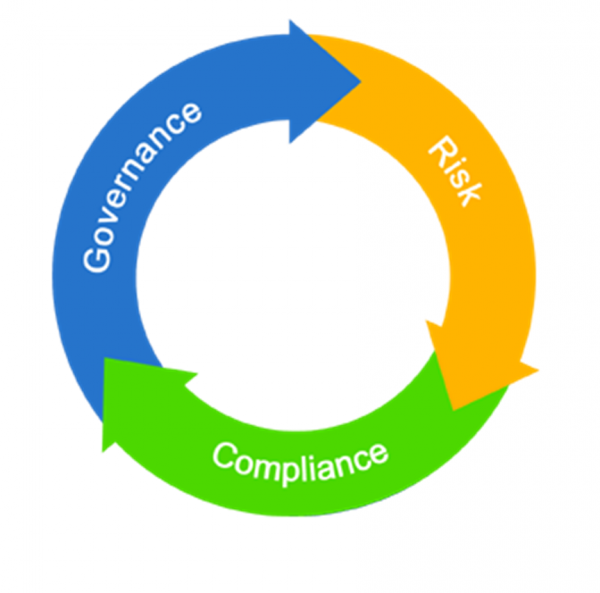
Recordemos este momento, la ciberseguridad comienza a jugar un papel cada vez más importante después de la "infancia descuidada" de las tecnologías de la información. Y en TI, cada vez más irrumpen las aterradoras e importantes 3 letras — GRC (Gobernanza, Riesgo, Cumplimiento), o en ruso, «Управляемость, Риск, Соответствие».
Servidores terminales
La proliferación de computadoras personales cada vez más potentes en la periferia ha superado significativamente el desarrollo de redes de acceso público. Las clásicas aplicaciones cliente-servidor de los años 90 y principios de los 2000 no funcionaban muy bien a través de canales delgados, especialmente cuando el intercambio de datos era de valores significativos. Esto fue particularmente difícil para las oficinas remotas conectadas a través de módems y líneas telefónicas, que además se caían o se bloqueaban periódicamente. Y...
La espiral ha dado una vuelta y ha vuelto al modo terminal con el concepto de servidores terminales.
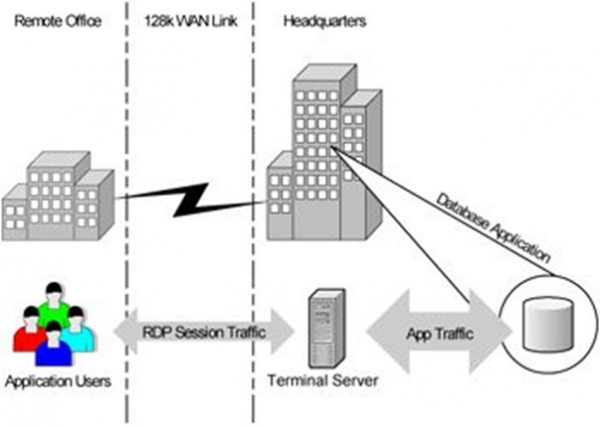
De hecho, hemos regresado a los años 70 con sus clientes ligeros y la centralización de la potencia de procesamiento. Se hizo evidente rápidamente que, además del trasfondo puramente económico de los canales, el acceso terminal ofrece enormes posibilidades para organizar el acceso seguro desde el exterior, incluyendo el trabajo desde casa para empleados o acceso extremadamente limitado y controlado para contratistas desde redes no confiables y dispositivos no controlados.
Sin embargo, los servidores terminales, a pesar de todas sus ventajas y progresismo, también tenían una serie de desventajas: baja flexibilidad, el problema del vecino ruidoso, la estricta versión de Windows del servidor, etc.
El nacimiento del proto VDI
Sin embargo, a principios y mediados de los 2000 ya comenzaba a surgir en escena la virtualización industrial de la plataforma x86. Y alguien planteó simplemente la idea que flotaba en el aire: ¿y si en lugar de centralizar todos los clientes en granjas de terminales servidores, le damos a cada uno su propia máquina virtual personal con Windows de cliente e incluso acceso de administrador?
La renuncia a los clientes gruesos
Paralelamente con la virtualización de sesiones y sistemas operativos, se desarrolló un enfoque relacionado con la reducción de la función del cliente a nivel de aplicación.
La lógica detrás de esto era bastante simple, ya que las computadoras portátiles personales aún no estaban en manos de todos, y el acceso a Internet no era ubiquo, muchos sólo podían conectarse desde cibercafés con derechos muy limitados, por decirlo de alguna manera. De hecho, lo único que se podía ejecutar era el navegador. El navegador se convirtió en un atributo indispensable del sistema operativo, y el internet se afianzaba en nuestra vida.
En otras palabras, paralelamente existía una tendencia hacia la transferencia de lógica del cliente al centro en forma de aplicaciones web, para las cuales solo se necesitaba el cliente más simple, internet y un navegador.
Y no solo volvimos al mismo punto desde el que empezamos: a tener cero clientes y servidores centrales. Llegamos allí por varios caminos independientes.
Infraestructura de Escritorio Virtual
Corredor
En 2007, el líder del mercado de virtualización industrial, VMware, lanzó la primera versión de su producto VDM (Virtual Desktop Manager), que se convirtió en el primero en el emergente mercado de escritorios virtuales. Por supuesto, no pasó mucho tiempo antes de que el líder en servidores de terminal, Citrix, respondiera, y en 2008, con la adquisición de XenSource, aparece XenDesktop. No hay duda de que había otros proveedores con sus propias ofertas, pero no profundizaremos demasiado en la historia, ya que nos alejamos de la concepción.
Y la concepción se mantiene hasta hoy. El componente clave de VDI es el corredor de conexiones.
Ese es el corazón de la infraestructura de escritorios virtuales.
El corredor se encarga de los procesos más importantes del funcionamiento de VDI:
- Determina los recursos disponibles para el cliente que se conecta (máquinas/sesiones);
- Equilibra, si es necesario, a los clientes entre grupos de máquinas/sesiones;
- Dirige al cliente al recurso seleccionado.
Hoy en día, el cliente (terminal) para VDI puede ser prácticamente cualquier dispositivo con pantalla: una laptop, un smartphone, una tableta, un quiosco, un cliente delgado o nulo. Y la parte responsable, la que realiza la carga productiva, es la sesión del servidor de terminal, una máquina física o una máquina virtual. Los productos VDI modernos y maduros están estrechamente integrados con la infraestructura virtual y la gestionan automáticamente, desplegando o, por el contrario, eliminando máquinas virtuales que ya no son necesarias.
Un poco al margen, pero para algunos clientes, una tecnología extremadamente importante de VDI es el soporte de aceleración de hardware de gráficos 3D para el trabajo de diseñadores o arquitectos.
Protocolo
Otra parte igualmente crucial de una solución VDI madura es el protocolo de acceso a los recursos virtuales. Si se trata de operar dentro de una red local corporativa con una red confiable de 1 Gbps hasta el lugar de trabajo y un retraso de 1 ms, se puede usar prácticamente cualquier protocolo y no hay necesidad de pensarlo mucho.
Hay que pensar cuando la conexión se realiza a través de una red incontrolada, cuya calidad puede variar, desde velocidades de decenas de kilobits hasta retrasos impredecibles. Este es el tipo de entorno adecuado para organizar un verdadero trabajo remoto, desde casas de campo, desde casa, desde aeropuertos y cafeterías.
Servidores terminales vs VMs cliente
Con la llegada de VDI, parecía que era hora de despedirse de los servidores terminales. ¿Para qué sirven, si cada uno tiene su propia VM personal?
Sin embargo, desde el punto de vista de la economía pura, resulta que para los puestos de trabajo masivos y estándar, que son idénticos hasta el cansancio, no hay nada más eficiente que los servidores terminales en relación calidad / sesión. A pesar de todas sus ventajas, el enfoque de "1 usuario = 1 VM" consume significativamente más recursos en hardware virtual y un sistema operativo completo, lo que empeora la economía en los puestos de trabajo típicos.
En el caso de los puestos de trabajo de top management, aquellos que son no estándar y están sobrecargados, donde se requiere tener altos privilegios (incluso hasta el nivel de administrador), tiene ventaja una VM dedicada por usuario. Dentro de esta VM, se pueden asignar recursos de forma individual, otorgar derechos de cualquier nivel y equilibrar la VM entre los hosts de virtualización bajo alta carga.
VDI y economía
Durante años he escuchado la misma pregunta: ¿cómo es que VDI es más barato que simplemente repartir laptops a todos? Y durante años he tenido que responder exactamente lo mismo: en el caso de empleados de oficina comunes, VDI no es más barato si consideramos los costos netos de proporcionar el equipo. Por mucho que lo intentemos, las laptops están bajando de precio, mientras que los servidores, el almacenamiento y el software del sistema costarán una suma considerable. Si es momento de actualizar tu parque y piensas que ahorrarás con VDI, no, no ahorrarás.
Ya mencioné las temidas tres letras GRC, así que, VDI se trata de GRC. Se trata de gestión de riesgos, se trata de seguridad y de la comodidad de un acceso controlado a los datos. Y todo esto generalmente implica un costo considerable para su implementación en una variedad de equipos heterogéneos. Con VDI, el control se simplifica, la seguridad se incrementa y el cabello se vuelve suave y sedoso.
Soluciones HPE para trabajo remoto
Gestión remota y en la nube
iLO
La compañía HPE no es una novata en la gestión remota de infraestructura de servidores; de hecho, en marzo se cumplió el 18.º aniversario del legendario iLO (Integrated Lights Out). Recordando mis días como administrador en los años 00, realmente disfruté de ello. La instalación inicial en racks y la conexión de cables era todo lo que necesitábamos hacer en un ruidoso y frío centro de datos. Todo el resto de la configuración, incluyendo la instalación del sistema operativo, podía hacerse desde el escritorio, con dos monitores y una taza de café caliente. ¡Y eso fue hace 13 años!
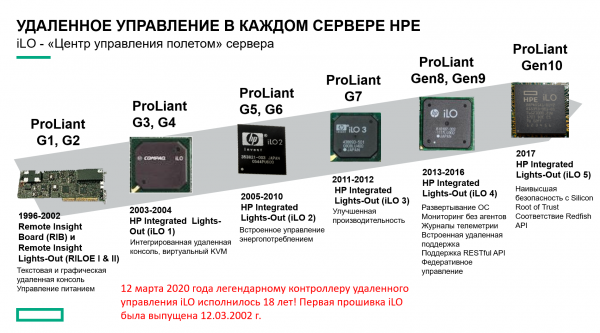
Hoy en día, los servidores HPE son indiscutiblemente un estándar de calidad durante muchos años, y el sistema de gestión remota, iLO, juega un papel fundamental en esto.
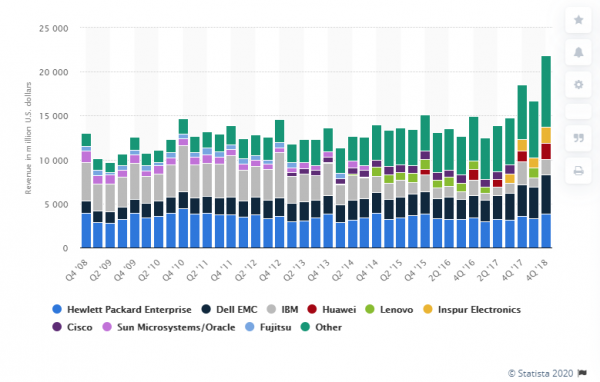
Quisiera destacar las acciones de HPE para mantener el control de la humanidad sobre el coronavirus. , que hasta finales de 2020 (como mínimo) la licencia de iLO Advanced está disponible de forma gratuita para todos.
Infosight
Si tienes más de 10 servidores en tu infraestructura y el administrador no se aburre, entonces sin duda, un gran complemento a las herramientas de monitoreo estándar sería el sistema en la nube HPE Infosight basado en inteligencia artificial. Este sistema no solo monitorea el estado y genera gráficos, sino que también recomienda acciones futuras basadas en la situación actual y tendencias.
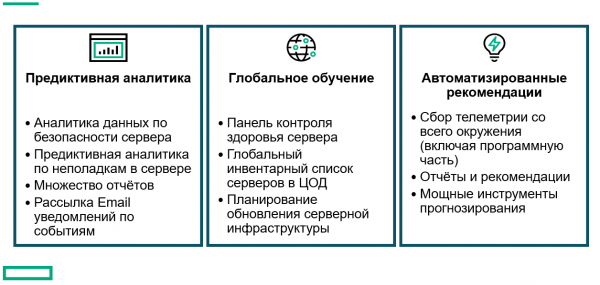
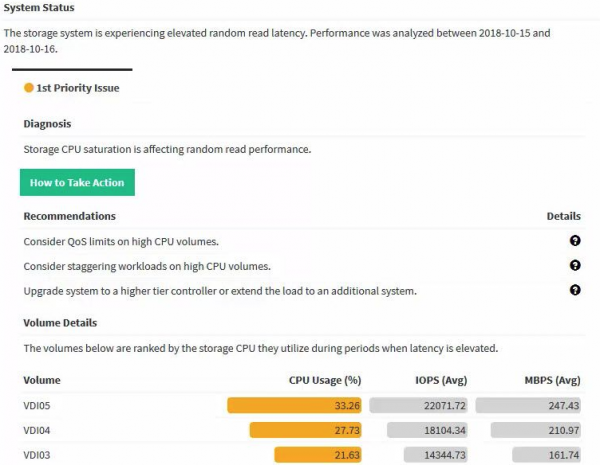
Sé inteligente, , ¡prueba Infosight!
OneView
Por último, pero no menos importante, quiero mencionar HPE OneView: un portafolio completo de productos con enormes capacidades para monitorear y gestionar toda la infraestructura. Y todo esto sin levantarte de tu escritorio, que en tu situación actual podría estar incluso en una casa de campo.
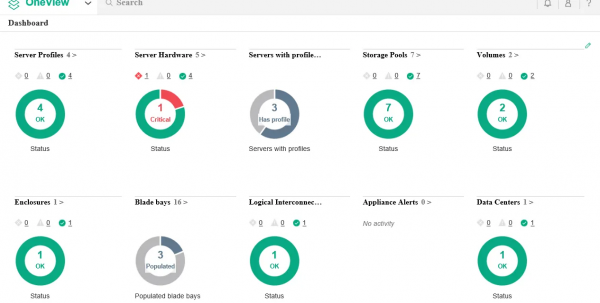
Los sistemas de almacenamiento también son excepcionales.
Por supuesto, todos los sistemas de almacenamiento se gestionan y monitorean de forma remota; esto ha sido así durante muchos años. Por lo tanto, hoy quiero hablar de otra cosa, específicamente sobre los metroclusters.
Los metroclusters no son una novedad en el mercado, pero precisamente por ello no son demasiado populares; la inercia del pensamiento y las primeras impresiones juegan en su contra. Por supuesto, ya existían hace 10 años, pero su costo era astronómico. Los años transcurridos desde los primeros metroclusters han cambiado la industria y la accesibilidad de la tecnología para el público en general.
Recuerdo proyectos donde se distribuían intencionadamente partes del sistema de almacenamiento — por separado para servicios ultra críticos en el metroclúster, y por separado para replicación sincrónica (mucho más barato).
De hecho, en 2020, un metroclúster no debería costarle nada, si puede organizar dos sitios y canales. Y los canales para la replicación sincrónica son exactamente los mismos que para los metroclústeres. Las licencias de software ya se ofrecen en paquetes — la replicación sincrónica viene de la mano con el metroclúster, y lo único que mantiene viva la replicación unidireccional es la necesidad de organizar una red L2 extendida. Y, aun así, L2 sobre L3 ya está avanzando por todo el país.
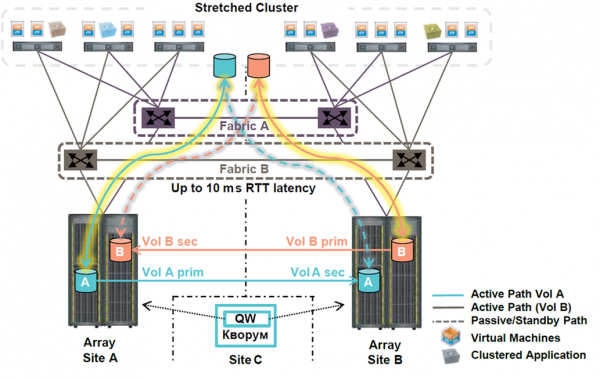
¿Entonces, cuál es la diferencia fundamental entre la replicación sincrónica y el metroclúster desde la perspectiva del trabajo remoto?
Es muy simple. El metroclúster funciona por sí mismo, automáticamente, siempre, prácticamente en tiempo real.
¿Cómo es el proceso de cambio de carga en la replicación sincrónica en una infraestructura con al menos unas cientos de VMs?
- Se recibe una señal de emergencia.
- El turno de guardia analiza la situación — se puede contar con al menos de 10 a 30 minutos solo para recibir la señal y tomar una decisión.
- En caso de que los ingenieros de guardia no tengan la autoridad para iniciar el cambio por sí mismos, se puede contar con otros 30 minutos para comunicarse con una persona autorizada y obtener confirmación formal para iniciar el cambio.
- Presionar el Gran Botón Rojo.
- De 10 a 15 minutos para los tiempos de espera y re-montaje de volúmenes, re-registro de VMs.
- 30 minutos para cambiar la direccionamiento IP — una estimación optimista.
- Y, por último, iniciar las VMs y poner en marcha los servicios productivos.
En total, el RTO (tiempo hasta la recuperación de los procesos empresariales) se puede estimar en 4 horas.
Comparémoslo con la situación en el metroclúster.
- El sistema de almacenamiento se da cuenta de que se ha perdido la conexión con el metroclúster — 15-30 segundos.
- Los hosts de virtualización se dan cuenta de que el primer centro de datos se ha perdido — 15-30 segundos (simultáneamente con el punto 1).
- Reinicio automático de la mitad a un tercio de las VMs en el segundo centro de datos — de 10 a 15 minutos hasta que los servicios carguen.
- Aproximadamente en ese momento, el turno de guardia comprende lo que ha sucedido.
En total: RTO = 0 para servicios individuales, 10-15 minutos en general.
¿Por qué el reinicio solo es de la mitad a un tercio de las VMs? Vea de qué se trata:
- Ustedes hacen todo de manera inteligente e incluyen el balanceo automático de máquinas virtuales. Como resultado, en promedio, solo la mitad de las máquinas virtuales funciona en uno de los centros de datos. La finalidad de un metroclúster es minimizar el tiempo de inactividad, y, por lo tanto, es de su interés reducir la cantidad de máquinas virtuales en riesgo.
- Parte de los servicios se puede agrupar a nivel de aplicación, distribuyéndolos en diferentes máquinas virtuales. En consecuencia, estas máquinas virtuales emparejadas se fijan con clavos o se sujetan con cinta a diferentes centros de datos, de modo que el servicio no tenga que esperar para reiniciar una máquina virtual en caso de una falla.
Con una infraestructura bien construida de metroclústeres, los usuarios comerciales trabajan con mínimas latencias desde cualquier lugar, incluso en caso de una falla a nivel de centro de datos. En el peor de los casos, la latencia será equivalente al tiempo que se tarda en tomar una taza de café.
Y, por supuesto, los metroclústeres funcionan excelentemente tanto con HPE 3Par, que se dirige hacia Valinor, como con los nuevos Primera!
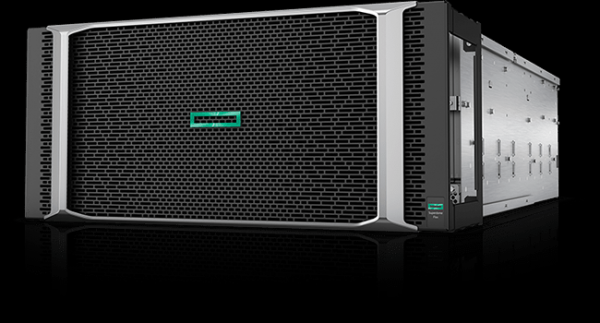
Infraestructura de lugares de trabajo remotos
Servidores terminales
No es necesario inventar nada nuevo para los servidores terminales, HPE ha suministrado durante muchos años algunos de los mejores servidores del mundo para ellos. Los clásicos que no pasan de moda son el DL360 (1U) o el DL380 (2U), o para los amantes de AMD, el DL385. Claro, también hay servidores Blade, tanto los clásicos C7000 como la nueva plataforma modular Synergy.
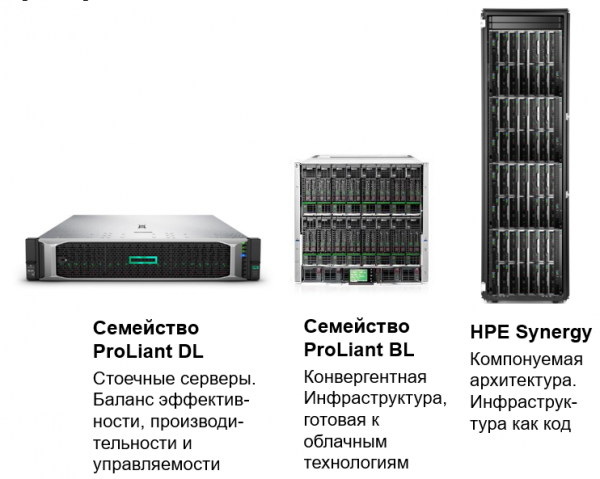
¡Para todos los gustos, para todos los colores, máximo de sesiones por servidor!
“VDI clásico” + HPE Simplivity
En este caso, al hablar de “VDI clásico”, me refiero al concepto de 1 usuario = 1 máquina virtual con Windows cliente. Y, por supuesto, no hay carga de VDI más cercana y familiar para sistemas hiperconvergentes, especialmente con deduplicación y compresión.
Aquí, HPE puede ofrecer su propia plataforma hiperconvergente Simplivity, así como servidores/nodos certificados para soluciones de socios, como por ejemplo, nodos listos para VSAN para construir VDI sobre la infraestructura de VMware VSAN.
Hablemos un poco más sobre la solución propia de Simplivity. En el centro, como su nombre lo sugiere, se coloca la simplicidad (en inglés, simple). Simplicidad en la implementación, simplicidad en la gestión, simplicidad en la escalabilidad.
Los sistemas hiperconvergentes son hoy en día uno de los temas más candentes en TI, y la cantidad de proveedores de diferentes niveles asciende a alrededor de 40. Según el cuadrante mágico de Gartner, la empresa HPE se encuentra en el Top 5 a nivel global y pertenece al cuadrante de líderes: aquellos que entienden hacia dónde se desarrolla la industria y son capaces de materializar esa comprensión en hardware.
Arquitectónicamente, Simplivity es un sistema hiperconvergente clásico con máquinas virtuales controladoras, lo que significa que puede soportar diversos hipervisores, a diferencia de los sistemas integrados en el hipervisor. De hecho, hasta abril de 2020, se soportan VMware vSphere y Microsoft Hyper-V, y se han anunciado planes para soportar KVM. La característica clave de Simplivity desde su llegada al mercado ha sido la aceleración de hardware para la compresión y deduplicación a través de una tarjeta aceleradora especial.
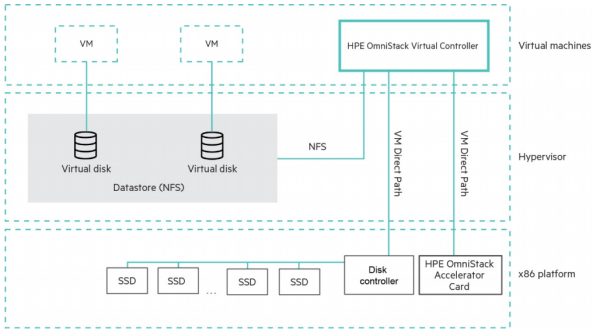
Es necesario señalar que la compresión con deduplicación son características globales y siempre activas, es decir, no son una función opcional, sino la arquitectura de la solución.
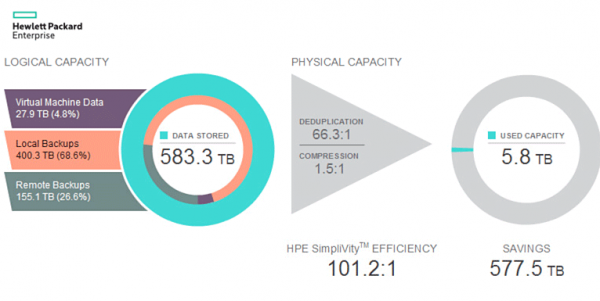
HPE, por supuesto, exagera un poco al afirmar una efectividad de 100:1, calculada de una manera especial, pero la eficiencia en el uso del espacio es realmente muy alta. Simplemente el número 100:1 es demasiado atractivo. Vamos a desglosar cómo se implementa técnicamente Simplivity para mostrar cómo se logran esos números.
Instantánea. Los snapshots (instantáneas) están 100% correctamente implementados como RoW (Redirect-on-Write), lo que significa que ocurren instantáneamente y no penalizan el rendimiento. Esto los diferencia, por ejemplo, de algunos otros sistemas. ¿Por qué necesitamos snapshots locales sin penalizaciones? Es muy simple, para reducir el RPO de 24 horas (el RPO promedio para copias de seguridad) a decenas o incluso minutos.
Copia de seguridad. Un snapshot se diferencia de una copia de seguridad solo en cómo lo percibe el sistema de gestión de máquinas virtuales. Si al eliminar una máquina se elimina todo lo demás, significa que era un snapshot. Si queda algo, significa que es una copia de seguridad. Así, cualquier snapshot puede considerarse como una copia de seguridad completa si se marca en el sistema y no se elimina.
Por supuesto, muchos pueden objetar: ¿cómo puede ser una copia de seguridad si se almacena en el mismo sistema? Aquí hay una respuesta muy simple en forma de una pregunta: ¿tiene un modelo formal de amenazas que establezca las reglas de almacenamiento de la copia de seguridad? Esta es una copia de seguridad absolutamente legítima contra la eliminación de archivos dentro de la VM, es una copia de seguridad contra la eliminación de la VM misma. Si se necesita almacenar una copia de seguridad únicamente en un sistema separado, hay opciones: replicar este snapshot en un segundo clúster Simplivity o en HPE StoreOnce.
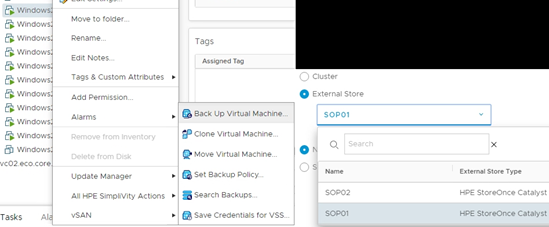
Y aquí es donde se demuestra que esta arquitectura se adapta perfectamente a cualquier tipo de VDI. Después de todo, VDI son cientos o incluso miles de máquinas extremadamente similares con el mismo sistema operativo, las mismas aplicaciones. La deduplicación global procesará y comprimirá todo esto no solo a 100:1, sino mucho mejor. ¿Desplegar 1000 VMs a partir de una plantilla? No es un problema, estas máquinas tardarán más en registrarse en vCenter que en clonarse.
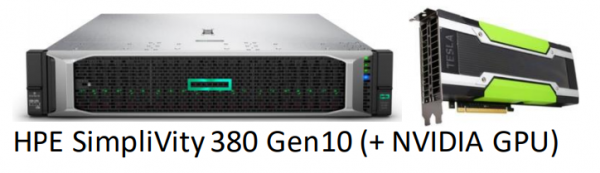
Se creó la línea Simplivity G especialmente para usuarios con requisitos de rendimiento especiales y para aquellos que necesitan aceleradores 3D.
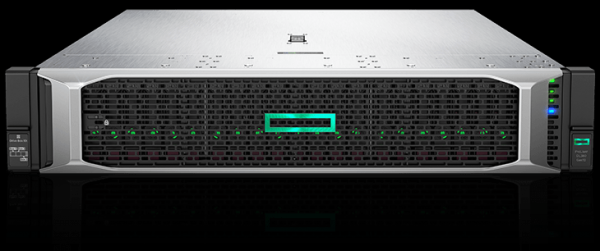
En esta serie no se utiliza un acelerador de deduplicación de hardware, por lo que se ha reducido el número de discos por nodo, para que el controlador funcione de manera programática. Esto libera espacios PCIe para cualquier otro acelerador. Asimismo, se ha duplicado la cantidad de memoria disponible por nodo a 3 TB para las cargas de trabajo más exigentes.
Simplivity es ideal para organizar infraestructuras VDI distribuidas geográficamente con replicación de datos en el CPD central.
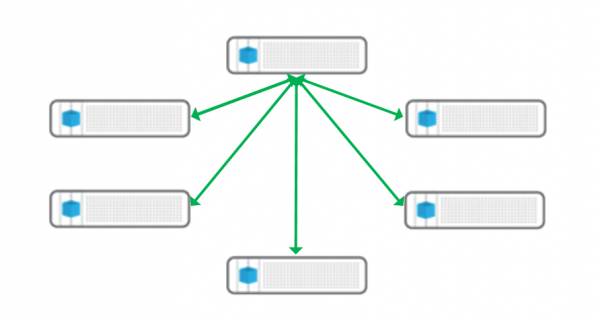
Esta arquitectura de VDI (y no solo VDI) es especialmente interesante en las realidades rusas: enormes distancias (y, por lo tanto, latencias) y canales de comunicación lejos de ser ideales. Se crean centros regionales (incluso simplemente 1-2 nodos Simplivity en una oficina muy remota), donde los usuarios locales se conectan a través de canales rápidos, manteniendo el control y la gestión desde el centro, y solo una cantidad insignificante de datos valiosos, y no datos basura, se replica al centro.
Por supuesto, Simplivity se integra completamente con OneView e InfoSight.
Clientes delgados y nulos
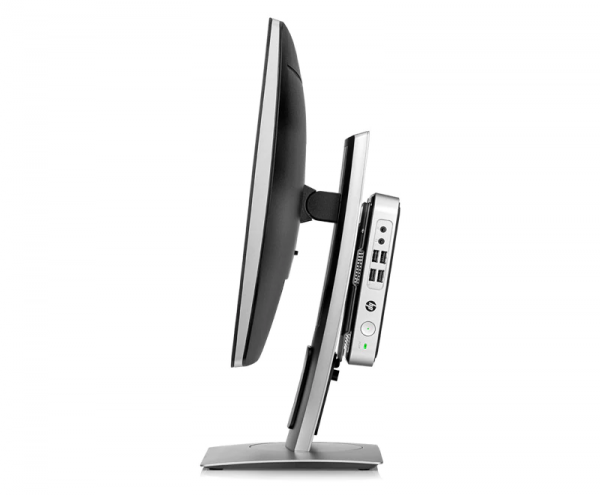
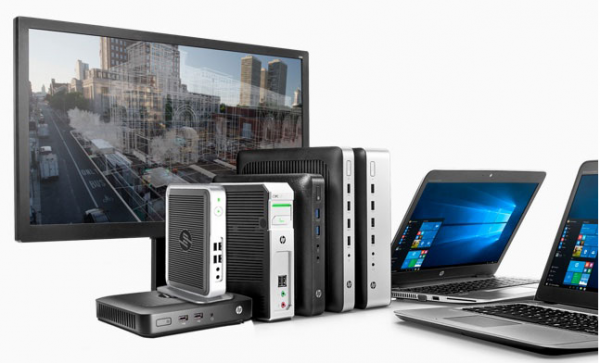
Los clientes ligeros son soluciones especializadas diseñadas exclusivamente para funcionar como terminales. Dado que en el cliente no hay carga más allá de mantener el canal y decodificar video, casi siempre lleva un procesador con refrigeración pasiva, un disco de arranque pequeño solo para iniciar un sistema operativo embebido específico, y eso es todo. No hay nada que pueda romperse y robar no tiene sentido. Su costo es bajo y no se guardan datos en ellos.
Hay una categoría especial de clientes ligeros, los llamados clientes cero. Su principal diferencia respecto a los clientes ligeros es la ausencia de un sistema operativo embebido de propósito general, funcionando exclusivamente con un microchip programado. A menudo, incluyen aceleradores de hardware específicos para decodificar flujos de video en protocolos terminales como PCoIP o HDX.
A pesar de la separación de la gran 'Hewlett Packard' en HPE y HP, no se puede dejar de mencionar los clientes ligeros fabricados por HP.
La oferta es amplia, para todos los gustos y necesidades, incluso para entornos de trabajo con múltiples monitores y aceleración de hardware del flujo de video.
Servicio HPE para tu trabajo remoto
Y por último, aunque no menos importante, quiero mencionar el servicio HPE. Sería demasiado largo enumerar todos los niveles y capacidades del servicio HPE, pero al menos hay una oferta extremadamente importante en términos de trabajo remoto. Es decir, un ingeniero de servicio de HPE/o un centro de servicio autorizado. Continuas trabajando de forma remota, desde tu querida casa de campo, escuchando a los abejorros, mientras un técnico de HPE llega al centro de datos para reemplazar los discos de tus servidores o la fuente de alimentación averiada.
HPE CallHome
En las condiciones actuales, con las restricciones de movimiento, la función Call Home es más relevante que nunca. Cualquier sistema HPE con esta función puede informar automáticamente sobre fallos de hardware o software al centro de soporte de HPE. Y es muy probable que la pieza de repuesto y/o un ingeniero de servicio lleguen a ti antes de que te des cuenta de las fallas y problemas con los servicios productivos.
Personalmente, recomiendo encarecidamente activar esta función.
Fuente: habr.com
