

Me llamo Sergey, soy de la empresa ITSumma, y quiero contarles cómo abordamos la redundancia en Kubernetes. Últimamente he estado trabajando mucho en consultoría, implementando diversas soluciones de DevOps para diferentes equipos, y, en particular, he estado trabajando intensamente en proyectos que utilizan K8s. En la conferencia Uptime Day 4, que se dedicó a la redundancia en arquitecturas complejas, di una charla sobre la redundancia de 'cubes', y aquí está su versión libre. Solo advierto de antemano que no es una guía directa de acción, sino más bien un resumen de reflexiones sobre el tema indicado.
En principio, la monitorización y la redundancia son dos herramientas clave para aumentar la resiliencia de cualquier proyecto. Pero, ¿no se equilibran las cosas solas en Kubernetes, dirán ustedes, se escalan solas, y si algo sucede, se levantan solas...? Es decir, tras una primera exploración superficial del tema, la Internet me respondió a la pregunta de cómo se aborda la redundancia en K8s con un '¿por qué?'. Muchos piensan que Kubernetes es una cosa mágica que elimina todos los problemas de infraestructura y asegura que un proyecto nunca caiga. Pero... el mundo no es lo que parece.
¿Cómo abordábamos el proceso de redundancia antes? Teníamos plataformas idénticas para el alojamiento, ya sea máquinas virtuales o físicas servidores, a las que aplicábamos tres prácticas básicas:
- sincronización de código y estáticos
- sincronización de configuraciones
- replicación de bases de datos
Y voilà: en cualquier momento cambiamos a la plataforma de respaldo, todos felices, nos levantamos y nos vamos.
¿Qué nos proponen para aumentar la disponibilidad constante de nuestra aplicación de Kubernetes? Lo primero que menciona la documentación no oficial es tener muchas máquinas, establecer muchos maestros — su número debe satisfacer las condiciones para alcanzar el quorum dentro del clúster, y que en cada uno de los maestros se levante etcd, api, MC, scheduler... Y, aparentemente, todo está maravilloso: si varias nodos de trabajo o maestros fallan, nuestro clúster se reequilibrará y la aplicación continuará funcionando. De nuevo, parece magia. Pero a menudo nuestro clúster se encuentra dentro de un único centro de datos, y esto puede plantear ciertas preguntas. ¿Qué pasa si llega un excavador y cava un cable, un rayo cae, o ocurre un diluvio universal? Todo se destruye, nuestro clúster ya no existe. ¿Cómo abordar la redundancia teniendo en cuenta este aspecto del problema?
En primer lugar, debe tener otro clúster en caliente, es decir, un clúster al que pueda conmutar en cualquier momento. Desde el punto de vista de Kubernetes, la infraestructura debe ser completamente idéntica. Es decir, si hay algunos complementos no estándar para el sistema de archivos, soluciones personalizadas para ingress, deben ser completamente idénticos en sus dos (o tres, o diez, aquí depende de cuánto dinero y esfuerzo tenga el personal administrativo) clústeres. Es necesario definir claramente dos conjuntos de aplicaciones (deployments, statefulsets, daemonsets, cronjobs, etc.): cuáles de ellas pueden funcionar en la reserva de forma constante y cuáles es mejor no ejecutar hasta el conmutación inmediata.
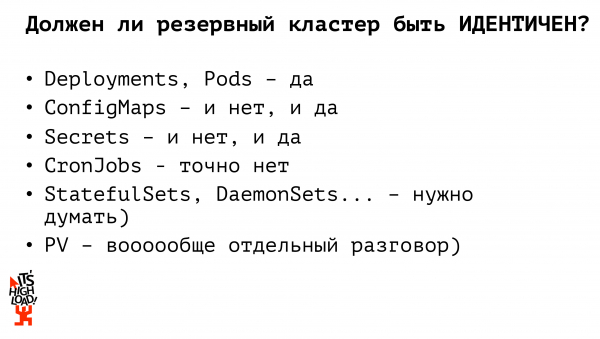
¿Debería nuestro clúster de respaldo ser completamente idéntico a nuestro clúster de producción? No. Si antes, al trabajar con proyectos monolíticos y con infraestructura física, manteníamos un entorno prácticamente idéntico, en el contexto de Kubernetes, creo que esto no debería ser así. Analicemos por qué.
Por ejemplo, comencemos con las entidades básicas de Kubernetes: los deployments, que deben ser idénticos. Deben estar en funcionamiento aplicaciones que en cualquier momento puedan captar el tráfico y permitir que nuestro proyecto continúe en funcionamiento. Si hablamos de archivos de configuración, aquí debemos considerar si deben ser idénticos o no. Es decir, si nosotros, personas sensatas, no consumimos sustancias prohibidas y no mantenemos la base de datos en K8s, entonces en nuestras configmaps deben estar las configuraciones de acceso a la base de datos en producción (el proceso de backup de la cual se gestiona por separado). Por lo tanto, para garantizar los accesos a la instancia de base de datos de respaldo, debemos tener un archivo de configuración (configmap) separado. De igual manera, trabajamos con secrets: contraseñas para acceder a la base de datos, API keys; en cualquier momento, solo puede estar activo el secret en producción o el de respaldo. En total, ya tenemos dos entidades de Kubernetes, cuyas versiones de respaldo no deben ser idénticas a las de producción. La siguiente entidad en la que vale la pena detenerse es el cronjob. Los cronjobs en el entorno de respaldo nunca deben ser idénticos al conjunto de cronjobs del clúster de producción. Si levantamos un clúster de respaldo y lo activamos completamente con todos los cronjobs habilitados, por ejemplo, los empleados recibirán dos correos electrónicos al mismo tiempo en lugar de uno. O alguna sincronización de datos con fuentes externas se realizará dos veces, lo que nos hará enfermar, llorar, gritar y quejarnos.
¿Y cómo nos proponen organizar el clúster de respaldo las personas de internet? La segunda respuesta más popular después de "¿y para qué?" es el uso de Kubernetes Federation.
¿Qué es esto? Es, digamos, un gran meta-clúster. Si imaginamos la arquitectura de Kubernetes, donde tenemos un maestro y varios nodos, desde el punto de vista de la federación también tenemos un maestro y varios nodos, solo que cada nodo es un clúster independiente. Es decir, trabajamos con las mismas entidades, con los mismos primitivos que con un solo Kubernetes, solo que en lugar de manejar nuestras máquinas físicas, manejamos clústeres completos. En el marco de la federación, tenemos una sincronización completa de los recursos federativos de los padres a los descendientes. Por ejemplo, si lanzamos un despliegue a través de la federación, se desplegará en cada uno de nuestros clústeres secundarios. Si tomamos algún configmap, secreto, y lo implementamos en la federación, se propagará a todos nuestros clústeres secundarios; además, la federación permite personalizar nuestros recursos en los hijos. Así que tomamos un configmap, lo desplegamos a través de la federación y luego, si necesitamos ajustar algo en clústeres específicos, vamos a corregirlo en un clúster separado, y ese cambio no se sincronizará en ningún otro lugar.
La Federación de Kubernetes es una herramienta relativamente nueva que no admite una amplia gama de recursos disponibles en K8s. En la primera versión de la documentación se mencionaba que solo se admitían configuraciones de mapas, despliegues a través de un conjunto de réplicas y ingress. Los secretos no eran compatibles y el trabajo con volúmenes tampoco estaba permitido. Es un conjunto de funcionalidades bastante limitado. Especialmente cuando nos gusta experimentar, por ejemplo, al pasar nuestros propios recursos a Kubernetes a través de definiciones de recursos personalizados, ya no podemos incluirlos en la federación. Es decir, es una solución que parece razonable, pero a menudo nos lleva a situaciones complicadas. Por otro lado, la federación permite gestionar nuestro conjunto de réplicas de manera flexible. Por ejemplo, si queremos que se ejecuten 10 réplicas de nuestra aplicación, la federación repartirá ese número proporcionalmente entre la cantidad de clústeres que tenemos. ¡Y esto se puede configurar! Podemos especificar que en el clúster de producción deben mantenerse 6 réplicas de nuestra aplicación y en el clúster de reserva, ya sea para ahorrar recursos o por diversión, solo 4 réplicas. Lo cual también es bastante conveniente. Pero con la federación, tenemos que usar nuevas soluciones, desplegar algo sobre la marcha y pensar un poco más.
¿Podemos abordar el proceso de reserva de Kubernetes de una manera más sencilla? ¿Qué herramientas tenemos disponibles?
En primer lugar, siempre tenemos algún sistema de CI/CD, es decir, no tenemos que ir manualmente a los servidores para crear o aplicar configuraciones. El sistema genera archivos YAML para nuestros contenedores.
En segundo lugar, tenemos varios clústeres; contamos con uno o más (si somos inteligentes) registros que también hemos reservado. Y hay una maravillosa utilidad llamada kubectl, que puede trabajar con varios clústeres simultáneamente.
Así que, en mi opinión, la solución más simple y correcta para construir un clúster de respaldo es un despliegue paralelo primitivo. Hay algún pipeline en el sistema ci/cd; primero construimos nuestros contenedores, los probamos y desplegamos las aplicaciones a través de kubectl en varios clústeres independientes. Podemos realizar despliegues simultáneos en varios clústeres. Por lo tanto, también resolvemos la entrega de configuraciones en esta etapa. Se puede definir de antemano un conjunto de configuraciones para nuestro clúster de producción, un conjunto de configuraciones para el clúster de respaldo y en el nivel del sistema ci/cd desplegar el entorno de producción en el clúster de producción y el entorno de respaldo en el clúster de respaldo. En comparación con la federación, no es necesario ir después de definir el recurso federado a cada clúster hijo y redefinir algo. Lo hemos hecho de antemano. ¡Qué bien lo hemos hecho!
Pero... hay... yo había escrito, hay 'una raíz de todos los males', pero en realidad hay dos. Primero, el sistema de archivos. Hay algún PV, o usamos almacenamiento externo. Si almacenamos archivos dentro del clúster, entonces hay que actuar según las viejas prácticas que han quedado desde la época de las infraestructuras físicas: por ejemplo, sincronizar con lsync. O cualquier otro mecanismo de su elección. Desplegamos todo en otras máquinas y seguimos adelante.
En segundo lugar, y de hecho, un punto de tropiezo incluso más importante es la base de datos. Si somos personas inteligentes y no mantenemos la base de datos en Kubernetes, entonces el proceso de respaldo de datos sigue el mismo esquema antiguo: replicación master-slave, luego el cambio y sincronizaremos la réplica y viviremos bien. Pero si mantenemos nuestra DB dentro del clúster, en principio hay muchas soluciones listas para organizar la misma réplica master-slave, muchas soluciones para levantar una DB dentro de Kubernetes.
Ya se han dado mil conferencias sobre la reserva de bases de datos, se han escrito mil artículos, aquí realmente no hay nada nuevo. En general, sigue tus sueños, vive como quieras, inventa también algunos mecanismos complicados, pero asegúrate de pensar en cómo vas a respaldar todo esto.
Ahora hablemos de cómo, en principio, se llevará a cabo el proceso de conmutación a un sitio de respaldo en caso de incendio. Primero, estamos desplegando aplicaciones sin estado en paralelo. Estas no afectan la lógica empresarial de nuestras aplicaciones, de nuestro proyecto; podemos mantener continuamente dos conjuntos de aplicaciones en funcionamiento, y pueden comenzar a recibir tráfico. Es muy importante en el proceso de conmutación al sitio de respaldo verificar si es necesario redefinir las configuraciones. Por ejemplo, tenemos un clúster de producción de Kubernetes, hay un clúster de respaldo de Kubernetes, hay una base de datos maestra externa y hay una base de datos maestra de respaldo. Tenemos cuatro opciones sobre cómo estas aplicaciones en producción pueden comenzar a interactuar entre sí. Puede que cambiemos la base de datos y resulta que necesitamos redirigir el tráfico en el clúster de producción a la nueva base, o puede que se caiga el clúster y hayamos cambiado a respaldo, pero seguimos trabajando con la base de producción. Y la tercera opción es que se nos caiga esto y aquello, y cambiamos ambas aplicaciones, redefiniendo nuestra configuración, para que las nuevas aplicaciones ya funcionen con la nueva base de datos.
Entonces, ¿qué conclusiones se pueden sacar de todo esto?
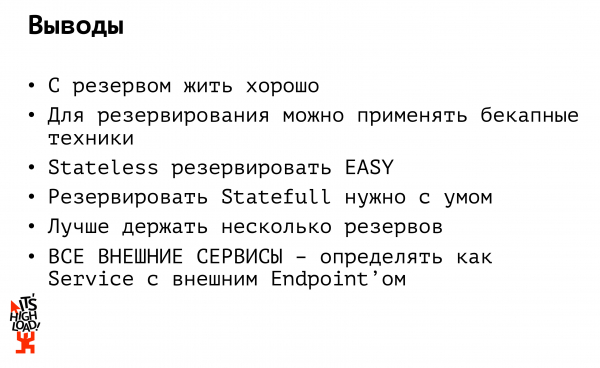
Primera conclusión: vivir con respaldo es bueno. Pero caro. Pero idealmente no deberías vivir con un solo respaldo. En ideal, deberías tener varios respaldos. Primero, el respaldo debe estar al menos en más de un centro de datos, y segundo, al menos con otro proveedor de hosting. A menudo ha pasado — y en mi experiencia ha sido así. No puedo nombrar proyectos, pero precisamente cuando ocurrió un incendio en el centro de datos... Yo decía: ¡cambiamos a respaldo! Y los servidores de respaldo estaban en el mismo rack...
O imagina que Amazon es prohibido en Rusia (y eso ha sucedido). Y ya está: ¿de qué sirve que nuestro respaldo esté en otro Amazon? También está fuera de servicio. Así que repito: mantén el respaldo, al menos en otro centro de datos, y preferiblemente con otro proveedor de hosting.
Segunda salida: si tienes una aplicación en Kubernetes que se comunica con fuentes externas (puede ser tanto una base de datos como una API externa), asegúrate de definirla como un servicio con un Endpoint externo, para que en el momento del cambio no tengas que redeplegar 15 de tus aplicaciones que están accediendo a la misma base. Define la base como un servicio separado, accede a ella como si estuviera dentro del clúster: si te falla la base, simplemente cambias la IP en un lugar y sigues viviendo felizmente.
Y por último: me encanta el "cubito", así como los experimentos con él. También disfruto compartir los resultados de estos experimentos y mi experiencia personal. Por eso, grabé una serie de seminarios web sobre K8s, bienvenidos a para más detalles.
Fuente: habr.com
