

¿Por qué es necesario hacer copias de seguridad? La verdad es que el hardware es bastante fiable y, además, existen "nubes" que son más seguras que los servidores físicos: si se configuran correctamente, un servidor "en la nube" puede superar a un servidor físico en caso de fallo de infraestructura, y desde el punto de vista de los usuarios de los servicios, la interrupción será mínima, casi imperceptible. Además, duplicar la información a menudo requiere pagar por el uso "extra" de CPU, carga de disco y tráfico de red.
El programa ideal funciona rápidamente, no consume memoria de manera innecesaria, no tiene fallas y no existe.
—Desconocido
Dado que los programas aún son desarrollados por programadores humanos, y el proceso de prueba a menudo falla, además de que la entrega de programas sucede raramente siguiendo las "mejores prácticas" (que son, en sí mismas, programas y, por lo tanto, imperfectas), los administradores de sistemas a menudo tienen que resolver problemas que suenan simples pero son profundos: "restaurar como estaba", "hacer que la base funcione normalmente", "funciona lento — revertir", así como mi favorito: "no sé qué, pero hay que arreglarlo".
Además de los errores lógicos que surgen como resultado del trabajo descuidado de los desarrolladores, o por circunstancias, así como por un conocimiento o comprensión insuficientes de los detalles menores de la construcción de programas — incluidos los conectores y sistemas, como sistemas operativos, controladores y firmware — existen otros errores. Por ejemplo, la mayoría de los desarrolladores confían en el entorno de ejecución, olvidándose por completo de las leyes físicas, que todavía no pueden ser evadidas mediante programas. Esto incluye la supuesta fiabilidad infinita del subsistema de disco y, en general, de cualquier subsistema de almacenamiento de datos (incluyendo la memoria RAM y la caché del procesador), y el tiempo de procesamiento nulo en el procesador, así como la ausencia de errores al transmitir a través de la red y al procesar en el procesador, y las latencias de red que son igual a 0. No se debe ignorar el famoso plazo, ya que si no se cumple — habrán problemas más serios que los matices del funcionamiento de la red y el disco.
¿Qué hacer con los problemas que surgen inesperadamente y amenazan con datos valiosos? No hay manera de reemplazar a los desarrolladores en vivo, y no es seguro que se pueda hacer en el corto plazo. Por otro lado, hasta ahora, solo unos pocos proyectos han logrado demostrar que sus programas funcionarán como se pensaba, y no es seguro que se puedan aplicar esas pruebas a otros proyectos similares. Además, tales demostraciones requieren mucho tiempo y habilidades especiales, lo que prácticamente minimiza la posibilidad de utilizarlas teniendo en cuenta los plazos. Además, todavía no hemos desarrollado una tecnología de almacenamiento, procesamiento y transmisión de información que sea rápida, económica y absolutamente confiable. Tales tecnologías, de existir, se encuentran generalmente en forma de conceptos, o, más a menudo, solo en libros y películas de ciencia ficción.
Los buenos artistas copian, los grandes artistas roban.
—Pablo Picasso.
Las soluciones más exitosas y las cosas sorprendentemente simples suelen ocurrir donde se encuentran conceptos, tecnologías, conocimientos y campos de ciencia que a primera vista son totalmente incompatibles.
Por ejemplo, tanto las aves como los aviones tienen alas, sin embargo, a pesar de la similitud funcional — en algunos modos, el principio de funcionamiento coincide, y los problemas técnicos se resuelven de manera similar: huesos huecos, uso de materiales resistentes y ligeros, etc. — los resultados son absolutamente diferentes, aunque muy parecidos. Los mejores ejemplos que observamos en nuestra técnica se han tomado, en su mayoría, de la naturaleza: los compartimentos herméticos en barcos y submarinos son una analogía directa con los anélidos; la construcción de arreglos RAID y la verificación de la integridad de los datos son una duplicación de la cadena de ADN; así como los órganos pares, la independencia del funcionamiento de diferentes órganos del sistema nervioso central (automatismo del trabajo del corazón) y los reflejos son sistemas autónomos en Internet. Por supuesto, tomar y aplicar soluciones listas de manera literal puede traer problemas, pero quién sabe, puede que no haya otras soluciones.
¡Si supiera dónde caer, habría puesto paja!
—Refrán popular bielorruso
Por lo tanto, las copias de seguridad son vitales para aquellos que desean:
- Tener la posibilidad de restaurar el funcionamiento de sus sistemas con el mínimo de tiempo de inactividad, o incluso sin él.
- Actúa con valentía, porque en caso de error siempre hay una posibilidad de reversión.
- Minimizar las consecuencias de la manipulación intencionada de datos.
Aquí hay un poco de teoría.
Cualquier clasificación es arbitraria. La naturaleza no clasifica. Clasificamos porque nos resulta más conveniente. Y clasificamos según datos que también tomamos de manera arbitraria.
—Jean Bruyère
Independientemente del método físico de almacenamiento, el almacenamiento lógico de datos se puede dividir, de manera condicional, en 2 formas de acceso a estos datos: por bloques y por archivos. Esta clasificación ha sido bastante difusa últimamente, ya que no existen almacenes lógicos que sean puramente de bloques o puramente de archivos. Sin embargo, para simplificar, consideraremos que sí los hay.
El almacenamiento de datos por bloques implica que hay un dispositivo físico donde se graban datos en porciones fijas, bloques. El acceso a los bloques se realiza mediante una dirección, y cada bloque tiene su propia dirección dentro del dispositivo.
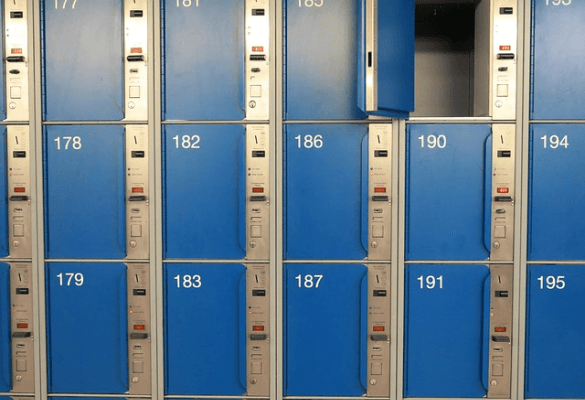
Una copia de seguridad generalmente se realiza copiando bloques de datos. Para asegurar la integridad de los datos en el momento de la copia, se detiene la escritura de nuevos bloques y también se suspenden las modificaciones de los existentes. Si tomamos una analogía del mundo real, lo más cercano sería un armario con compartimentos numerados idénticamente.
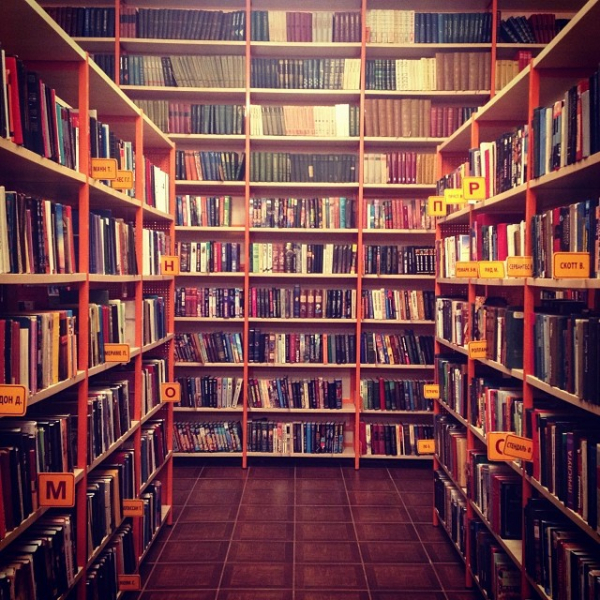
El almacenamiento de datos por archivos, según el principio del dispositivo lógico, se asemeja al almacenamiento por bloques y a menudo se organiza encima. Las diferencias importantes son la existencia de una jerarquía de almacenamiento y nombres comprensibles por humanos. Se destaca una abstracción en forma de archivo, que es un área de datos nombrada, así como un directorio, que es un archivo especial que contiene descripciones y accesos a otros archivos. Los archivos pueden incluir metadatos adicionales: fecha de creación, flags de acceso, etc. Generalmente, la reserva se realiza así: se buscan archivos modificados y luego se copian a otro almacenamiento de archivos de estructura idéntica. La integridad de los datos se realiza generalmente mediante la ausencia de archivos en los que se esté escribiendo. Los metadatos de los archivos se reservan de manera similar. La analogía más cercana sería una biblioteca, en la que hay secciones con diferentes libros, así como un catálogo con nombres comprensibles de los libros.
Recientemente, a veces se describe otra variante de la que, en principio, comenzó el almacenamiento de datos y que tiene las mismas características arcaicas: el almacenamiento de objetos.
Se diferencia del almacenamiento de archivos en que no tiene una jerarquía mayor a una (esquema plano), y aunque los nombres de archivos son legibles para los humanos, están más adaptados para el procesamiento por máquinas. En la copia de seguridad, los almacenes de objetos se manejan con mayor frecuencia de manera similar a los de archivos, aunque a veces existen otras opciones.
— Hay dos tipos de administradores de sistemas: los que no hacen copias de seguridad y los que YA hacen.
— En realidad, hay tres tipos: también están aquellos que verifican que las copias de seguridad se puedan restaurar.—Desconocido
También es importante entender que el propio proceso de copia de seguridad de datos se lleva a cabo mediante programas, por lo que presenta todas las mismas desventajas que cualquier otro programa. Para eliminar (no excluir) la dependencia del factor humano, así como de las particularidades —que por separado no influyen mucho, pero que juntas pueden tener un efecto notable—, se aplica la regla 3-2-1. Hay muchas formas de interpretarla, pero me gusta más la siguiente: se deben almacenar 3 copias de los mismos datos, 2 copias deben conservarse en diferentes formatos y 1 copia debe estar en un almacenamiento geográficamente remoto.
Por formato de almacenamiento se entiende lo siguiente:
- Si existe una dependencia del método físico de almacenamiento, cambiamos el método físico.
- Si existe una dependencia del método lógico de almacenamiento, cambiamos el método lógico.
Para lograr el máximo efecto de la regla 3-2-1, se recomienda modificar el formato de almacenamiento de ambos modos.
Desde el punto de vista de la disponibilidad de la copia de seguridad para su propósito directo — la restauración de la funcionalidad — se distinguen las copias de seguridad 'calientes' y 'frías'. Las copias calientes se diferencian de las frías solo en un aspecto: están listas para trabajar de inmediato, mientras que las frías requieren algunas acciones adicionales para su restauración: descifrado, extracción del archivo, etc.
No se deben confundir las copias calientes y frías con las copias en línea y fuera de línea, que implican la aislamiento físico de los datos y son, en esencia, otra forma de clasificar los métodos de respaldo. Así, una copia fuera de línea, que no está conectada directamente al sistema donde debe ser restaurada, puede ser tanto caliente como fría (en términos de estar lista para la recuperación). Una copia en línea puede estar disponible directamente donde necesita ser restaurada y, en la mayoría de los casos, es caliente, aunque también hay copias frías.
Además, no hay que olvidar que el proceso de creación de copias de seguridad generalmente no termina con la creación de una sola copia de seguridad, y puede haber un número considerable de copias. Por lo tanto, es necesario distinguir entre copias de seguridad completas, es decir, aquellas que son restaurables independientemente de otras copias de seguridad, y copias incrementales (diferenciales, decrecientes, etc.) —las cuales no pueden ser restauradas por sí solas y requieren la recuperación previa de una o varias otras copias de seguridad.
Las copias incrementales diferenciales son un intento de ahorrar espacio para el almacenamiento de copias de seguridad. Así, solo se escriben los datos modificados desde la última copia de seguridad.
Las copias decrecientes diferenciales se crean con el mismo propósito, pero de otra manera: se hace una copia de seguridad completa, pero en realidad solo se almacena la diferencia entre la copia reciente y la anterior.
Es importante considerar el proceso de respaldo sobre un almacenamiento que soporta la ausencia de almacenamiento duplicado. Así, si se escriben copias de seguridad completas sobre él, en realidad solo se registrará la diferencia entre las copias de seguridad, sin embargo, el proceso de recuperación de las copias de seguridad se realizará de manera similar a la recuperación desde una copia completa y será completamente transparente.
Quis custodiet ipsos custodes?
(¿Quién vigilará a los vigilantes? — lat.)
Es bastante desagradable no tener copias de seguridad, pero es mucho peor si parece que la copia de seguridad se ha realizado, pero al intentar la restauración se revela que no puede ser restaurada porque:
- La integridad de los datos originales ha sido comprometida.
- El almacenamiento de las copias de seguridad está dañado.
- La recuperación funciona de manera bastante lenta, no se pueden utilizar los datos que han sido parcialmente recuperados.
Un proceso de respaldo correctamente diseñado debe tener en cuenta observaciones como estas, especialmente las dos primeras.
La integridad de los datos originales se puede garantizar de varias maneras. Las más utilizadas son: a) creación de imágenes del sistema de archivos a nivel de bloque, b) "congelación" del estado del sistema de archivos, c) dispositivo de bloques especial con almacenamiento de versiones, d) grabación secuencial de archivos o bloques. También se utilizan sumas de verificación para asegurar la verificación de los datos durante la recuperación.
Los daños en el almacenamiento también se pueden detectar mediante sumas de verificación. Un método adicional es el uso de dispositivos especializados o sistemas de archivos en los que no se pueden modificar los datos ya escritos, pero se pueden agregar nuevos.
Para acelerar la recuperación, se utiliza la recuperación de datos con múltiples procesos de restauración, siempre que no haya un "cuello de botella" en forma de red lenta o un sistema de discos no rápido. Para evitar la situación de datos parcialmente recuperados, se puede dividir el proceso de respaldo en tareas más pequeñas, cada una ejecutada por separado. De esa manera, se puede restaurar la funcionalidad de manera secuencial con una previsión del tiempo de recuperación. Este problema a menudo se encuentra en el ámbito organizacional (SLA), por lo que no nos detendremos en ello en detalle.
Sabe de especias no quien las añade a cada plato, sino quien nunca pone nada innecesario en él.
—V. Sinyavsky
La práctica en cuanto al software utilizado por los administradores de sistemas puede variar, pero los principios generales siguen siendo los mismos, en particular:
- Se recomienda encarecidamente utilizar soluciones listas para usar.
- Los programas deben funcionar de manera predecible, es decir, no debe haber características no documentadas ni cuellos de botella.
- La configuración de cada programa debe ser lo suficientemente simple como para que no sea necesario leer el manual o la guía cada vez.
- La solución debe ser universal, ya que los servidores pueden diferir considerablemente en sus características de hardware.
Para realizar copias de seguridad de los dispositivos de bloques, hay los siguientes programas comunes:
- dd, conocido por los veteranos de la administración de sistemas, así como programas similares (por ejemplo, dd_rescue).
- Programas integrados en algunos sistemas de archivos que crean un volcado (dump) del sistema de archivos.
- Utilidades genéricas; por ejemplo, partclone.
- Soluciones a menudo privativas; por ejemplo, NortonGhost y versiones más recientes.
Para los sistemas de archivos, la tarea de hacer copias de seguridad se aborda parcialmente utilizando métodos aplicables a dispositivos de bloques, sin embargo, la tarea se puede resolver de manera más eficiente utilizando, por ejemplo:
- Rsync, un programa y protocolo versátil para sincronizar el estado de los sistemas de archivos.
- Herramientas integradas para la archivación (ZFS).
- Herramientas externas de archivación; el representante más popular es tar. También existen otras, como dar, un reemplazo de tar orientado a sistemas modernos.
Vale la pena mencionar las herramientas de software que garantizan la consistencia de los datos al crear copias de seguridad. A menudo se utilizan las siguientes opciones:
- Montar el sistema de archivos en modo solo lectura (ReadOnly), o congelar el sistema de archivos (freeze) — este método es aplicable de manera limitada.
- Crear instantáneas del estado de sistemas de archivos o dispositivos de bloques (LVM, ZFS).
- Uso de herramientas externas para organizar instantáneas, incluso en casos donde las opciones anteriores no puedan cumplirse por alguna razón (programas como hotcopy).
- La técnica de copia al modificar (CopyOnWrite), aunque a menudo está vinculada al sistema de archivos utilizado (BTRFS, ZFS).
Entonces, para un servidor pequeño, es necesario asegurarse de que exista un esquema de copia de seguridad que cumpla con los siguientes requisitos:
- Fácil de usar: no requiere acciones especiales adicionales durante el trabajo, mínimas acciones para crear y restaurar copias.
- Universal: funciona tanto en servidores grandes como pequeños; esto es importante a medida que crece el número servidores o al escalar.
- Se instala mediante un gestor de paquetes, o con uno o dos comandos como 'descargar y descomprimir'.
- Estable: se utiliza un formato de almacenamiento estándar o ya bien establecido.
- Rápido en su funcionamiento.
Los aspirantes son aquellos que más o menos cumplen con los requisitos:
- rdiff-backup
- rsnapshot
- burp
- duplicati
- duplicity
- deja dup
- dar
- zbackup
- restic
- borgbackup
Se utilizará una máquina virtual (basada en XenServer) como un banco de pruebas con las siguientes características:
- 4 núcleos a 2.5 GHz,
- 16 GB de memoria RAM,
- 50 GB de almacenamiento híbrido (almacenamiento con caché SSD del 20% del tamaño del disco virtual) en forma de un disco virtual separado sin particionar,
- canal de 200 Mbps a Internet.
El servidor que recibirá las copias de seguridad será una máquina prácticamente idéntica, pero con un disco duro de 500 GB.
Sistema operativo: CentOS 7 x64: la partición estándar, la partición adicional se utilizará como fuente de datos.
Tomaremos los datos de un sitio en WordPress, con archivos multimedia de 40 GB y una base de datos en MySQL. Dado que servidores virtuales varían bastante en especificaciones, y también para una mejor reproducibilidad, aquí hay
los resultados de las pruebas del servidor realizadas con sysbench.sysbench —threads=4 —time=30 —cpu-max-prime=20000 cpu run
sysbench 1.1.0-18a9f86 (utilizando LuaJIT 2.1.0-beta3 en forma integrada)
Ejecutando la prueba con las siguientes opciones:
Número de hilos: 4
Inicializando el generador de números aleatorios a partir del tiempo actual
Límite de números primos: 20000
Inicializando hilos de trabajo…
¡Hilos iniciados!
Velocidad del CPU:
eventos por segundo: 836.69
Rendimiento:
eventos/s (eps): 836.6908
tiempo transcurrido: 30.0039s
número total de eventos: 25104
Latencia (ms):
mín: 2.38
prom: 4.78
máx: 22.39
percentil 95: 10.46
suma: 119923.64
Equidad de hilos:
eventos (prom/ desviación estándar): 6276.0000 / 13.91
tiempo de ejecución (prom/ desviación estándar): 29.9809 / 0.01
sysbench —threads=4 —time=30 —memory-block-size=1K —memory-scope=global —memory-total-size=100G —memory-oper=read memory run
sysbench 1.1.0-18a9f86 (utilizando LuaJIT 2.1.0-beta3 en forma integrada)
Ejecutando la prueba con las siguientes opciones:
Número de hilos: 4
Inicializando el generador de números aleatorios a partir del tiempo actual
Ejecutando prueba de velocidad de memoria con las siguientes opciones:
tamaño de bloque: 1KiB
tamaño total: 102400MiB
operación: lectura
ámbito: global
Inicializando hilos de trabajo…
¡Hilos iniciados!
Total de operaciones: 50900446 (1696677.10 por segundo)
49707.47 MiB transferidos (1656.91 MiB/s)
Rendimiento:
eventos/s (eps): 1696677.1017
tiempo transcurrido: 30.0001s
número total de eventos: 50900446
Latencia (ms):
mín: 0.00
prom: 0.00
máx: 24.01
percentil 95: 0.00
suma: 39106.74
Equidad de hilos:
eventos (prom/ desviación estándar): 12725111.5000 / 137775.15
tiempo de ejecución (prom/ desviación estándar): 9.7767 / 0.10
sysbench —threads=4 —time=30 —memory-block-size=1K —memory-scope=global —memory-total-size=100G —memory-oper=write memory run
sysbench 1.1.0-18a9f86 (utilizando LuaJIT 2.1.0-beta3 en forma integrada)
Ejecutando la prueba con las siguientes opciones:
Número de hilos: 4
Inicializando el generador de números aleatorios a partir del tiempo actual
Ejecutando prueba de velocidad de memoria con las siguientes opciones:
tamaño de bloque: 1KiB
tamaño total: 102400MiB
operación: escritura
ámbito: global
Inicializando hilos de trabajo…
¡Hilos iniciados!
Total de operaciones: 35910413 (1197008.62 por segundo)
35068.76 MiB transferidos (1168.95 MiB/s)
Rendimiento:
eventos/s (eps): 1197008.6179
tiempo transcurrido: 30.0001s
número total de eventos: 35910413
Latencia (ms):
mín: 0.00
prom: 0.00
máx: 16.90
percentil 95: 0.00
suma: 43604.83
Equidad de hilos:
eventos (prom/ desviación estándar): 8977603.2500 / 233905.84
tiempo de ejecución (prom/ desviación estándar): 10.9012 / 0.41
sysbench —threads=4 —file-test-mode=rndrw —time=60 —file-block-size=4K —file-total-size=1G fileio run
sysbench 1.1.0-18a9f86 (utilizando LuaJIT 2.1.0-beta3 en forma integrada)
Ejecutando la prueba con las siguientes opciones:
Número de hilos: 4
Inicializando el generador de números aleatorios a partir del tiempo actual
Banderas de apertura de archivos adicionales: (ninguna)
128 archivos, 8MiB cada uno
1GiB tamaño total del archivo
Tamaño de bloque 4KiB
Número de solicitudes de IO: 0
Proporción de lectura/escritura para la prueba de IO aleatorio combinada: 1.50
FSYNC periódico habilitado, llamando a fsync() cada 100 solicitudes.
Llamando a fsync() al final de la prueba, habilitado.
Usando modo de E/S síncrono
Realizando prueba de r/w aleatorio
Inicializando hilos de trabajo…
¡Hilos iniciados!
Rendimiento:
lectura: IOPS=3868.21 15.11 MiB/s (15.84 MB/s)
escribir: IOPS=2578.83 10.07 MiB/s (10.56 MB/s)
fsync: IOPS=8226.98
Latencia (ms):
mín: 0.00
promedio: 0.27
máx: 18.01
percentil 95: 1.08
suma: 238469.45
Con esta nota comienza un gran
ciclo de artículos sobre copias de seguridad
- Copia de seguridad, parte 1: ¿Por qué se necesita una copia de seguridad? Revisión de métodos y tecnologías
- Copia de seguridad, parte 2: Revisión y pruebas de herramientas de copia de seguridad basadas en rsync
- Copia de seguridad, parte 3: Revisión y prueba de duplicity, duplicaty, deja dup
- Copia de seguridad, parte 4: Revisión y prueba de zbackup, restic, borgbackup
- Copia de seguridad, parte 5: Prueba de bacula y veeam backup for linux
- Copia de seguridad, parte 6: Comparación de herramientas de copia de seguridad
- Copia de seguridad, parte 7: Conclusiones
Fuente: habr.com
