

A principios de este mes, el 3 de mayo, se anunció un importante lanzamiento del «sistema de gestión para almacenes de datos distribuidos en Kubernetes» — . Hace más de un año, ya una visión general de Rook. En ese momento, se nos pidió contar sobre la experiencia de su uso práctico — y ahora, justo con este hito significativo en la historia del proyecto, nos complace compartir las impresiones acumuladas.
En resumen, Rook es un conjunto de para Kubernetes que se hacen cargo completamente del despliegue, gestión y recuperación automática de soluciones de almacenamiento de datos como Ceph, EdgeFS, Minio, Cassandra, CockroachDB.
En este momento, la solución más avanzada (y en en estado estable) es .
Nota: entre los cambios importantes en el lanzamiento de Rook 1.0.0 relacionados con Ceph, se destaca el soporte para Ceph Nautilus y la posibilidad de utilizar NFS para buckets de CephFS o RGW. Otros cambios relevantes incluyen la «maduración» del soporte para EdgeFS hasta nivel beta.
Así que, en este artículo:
- responderemos a la pregunta de qué beneficios vemos al usar Rook para desplegar Ceph en un clúster de Kubernetes;
- compartiremos experiencias e impresiones sobre el uso de Rook en producción;
- contaremos por qué decimos «¡Sí!» a Rook y sobre nuestros planes para él.
Comencemos con conceptos generales y teoría.
«¡Tengo una ventaja de una torre!» (jugador de ajedrez desconocido)
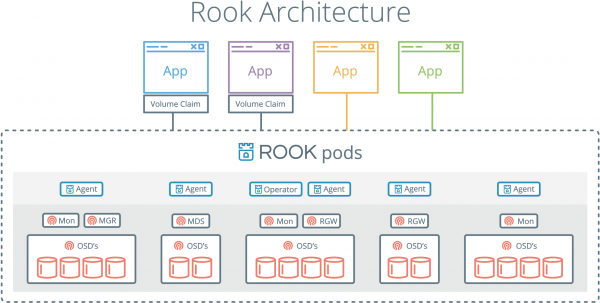
Una de las principales ventajas de Rook es que la interacción con los almacenes de datos se realiza a través de mecanismos de Kubernetes. Esto significa que ya no es necesario copiar comandos para configurar Ceph de un papel a la consola.
— ¿Quieres desplegar CephFS en el clúster? ¡Simplemente escribe un archivo YAML!
— ¿Qué? ¿Quieres desplegar también un almacén de objetos con la API S3? ¡Simplemente escribe un segundo archivo YAML!
Rook se creó según las reglas de un operador típico. La interacción con él se realiza mediante , en las que describimos las características necesarias de las entidades Ceph (dado que esta es la única implementación estable, en este artículo se hablará específicamente de Ceph, a menos que se indique lo contrario). Según los parámetros especificados, el operador ejecutará automáticamente los comandos necesarios para la configuración.
Veamos la especificidad usando el ejemplo de la creación de un Almacén de Objetos, o más exactamente — CephObjectStoreUser.
apiVersion: ceph.rook.io/v1
kind: CephObjectStore
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  metadataPool:
    failureDomain: host
    replicated:
      size: 3
  dataPool:
    failureDomain: host
    erasureCoded:
      dataChunks: 2
      codingChunks: 1
  gateway:
    type: s3
    sslCertificateRef:
    port: 80
    securePort:
    instances: 1
    allNodes: false
---
apiVersion: ceph.rook.io/v1
kind: CephObjectStoreUser
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  store: {{ .Values.s3.crdName }}
  displayName: {{ .Values.s3.username }}
Los parámetros especificados en el listado son bastante estándar y poco necesitan comentarios, sin embargo, se debe prestar especial atención a aquellos que están destacados como variables de plantillas.
El esquema general de funcionamiento se resume en que a través de un archivo YAML pedimos recursos, para lo cual el operador ejecuta los comandos necesarios y nos devuelve un 'secreto' que no es del todo real, con el que podemos trabajar más adelante. (ver más abajo). A partir de las variables mencionadas anteriormente, se formará el comando y el nombre del secreto.
¿Qué comando es este? Al crear un usuario para el almacenamiento de objetos, el operador Rook dentro del pod ejecutará lo siguiente:
radosgw-admin user create --uid="rook-user" --display-name="{{ .Values.s3.username }}"El resultado de la ejecución de este comando será una estructura JSON:
{
    "user_id": "rook-user",
    "display_name": "{{ .Values.s3.username }}",
    "keys": [
        {
           "user": "rook-user",
           "access_key": "NRWGT19TWMYOB1YDBV1Y",
           "secret_key": "gr1VEGIV7rxcP3xvXDFCo4UDwwl2YoNrmtRlIAty"
        }
    ],
    ...
}
Claves — lo que se necesitará en el futuro para que las aplicaciones accedan al almacenamiento de objetos a través de la API S3. El operador Rook amablemente las selecciona y las coloca en su namespace en forma de secreto con el nombre rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}.
Para usar los datos de este secreto, es suficiente con añadirlos al contenedor como variables de entorno. Como ejemplo, aquí hay una plantilla para un trabajo en el que creamos automáticamente buckets para cada entorno de usuario:
{{- range $bucket := $.Values.s3.bucketNames }}
apiVersion: batch/v1
kind: Job
metadata:
  name: create-{{ $bucket }}-bucket-job
  annotations:
    "helm.sh/hook": post-install
    "helm.sh/hook-weight": "2"
spec:
  template:
    metadata:
      name: create-{{ $bucket }}-bucket-job
    spec:
      restartPolicy: Never
      initContainers:
      - name: waitdns
        image: alpine:3.6
        command: ["/bin/sh", "-c", "while ! getent ahostsv4 rook-ceph-rgw-{{ $.Values.s3.crdName }}; do sleep 1; done" ]
      - name: config
        image: rook/ceph:v1.0.0
        command: ["/bin/sh", "-c"]
        args: ["s3cmd --configure --access_key=$(ACCESS-KEY) --secret_key=$(SECRET-KEY) -s --no-ssl --dump-config | tee /config/.s3cfg"]
        volumeMounts:
        - name: config
          mountPath: /config
        env:
        - name: ACCESS-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: AccessKey
        - name: SECRET-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: SecretKey
      containers:
      - name: create-bucket
        image: rook/ceph:v1.0.0
        command:
        - "s3cmd"
        - "mb"
        - "--host=rook-ceph-rgw-{{ $.Values.s3.crdName }}"
        - "--host-bucket= "
        - "s3://{{ $bucket }}"
        ports:
        - name: s3-no-sll
          containerPort: 80
        volumeMounts:
        - name: config
          mountPath: /root
      volumes:
      - name: config
        emptyDir: {}
---
{{- end }}
Todas las acciones enumeradas en este Job se llevaron a cabo sin salir de Kubernetes. Las estructuras descritas en los archivos YAML se almacenaron en un repositorio de Git y se reutilizaron múltiples veces. Vemos un gran beneficio para los ingenieros de DevOps y el proceso de CI/CD en su conjunto.
Con Rook y Rados es un placer
El uso de la combinación Ceph + RBD impone ciertas limitaciones en el montaje de volúmenes a los pods.
En particular, en el namespace debe haber un secreto para acceder a Ceph, para que las aplicaciones stateful puedan funcionar. Es normal si tienes 2-3 entornos en tus espacios de nombres: puedes ir y copiar el secreto manualmente. Pero, ¿qué hacer si se crea un entorno separado con su propio namespace para cada característica de los desarrolladores?
En nuestra situación, resolvimos este problema mediante , que copiaba automáticamente los secretos en nuevos namespaces (un ejemplo de tal gancho se describe en ).
#! /bin/bash

if [[ $1 == “--config” ]]; then
   cat <<EOF
{"onKubernetesEvent":[
 {"name": "OnNewNamespace",
  "kind": "namespace",
  "event": ["add"]
  }
]}
EOF
else
    NAMESPACE=$(kubectl get namespace -o json | jq '.items | max_by( .metadata.creationTimestamp ) | .metadata.name')
    kubectl -n ${CEPH_SECRET_NAMESPACE} get secret ${CEPH_SECRET_NAME} -o json | jq ".metadata.namespace="${NAMESPACE}"" | kubectl apply -f -
fi
Sin embargo, al usar Rook, este problema simplemente no existe. El proceso de montaje se lleva a cabo mediante controladores propios basados en o (actualmente en fase beta) y por lo tanto no requiere secretos.
Rook resuelve automáticamente muchos problemas, lo que nos impulsa a usarlo en nuevos proyectos.
Asedio de Rook
Finalizaremos la parte práctica desplegando Rook y Ceph para permitir la realización de nuestros propios experimentos. Para facilitar la toma de esta inaccesible torre, los desarrolladores han preparado un paquete Helm. Vamos a descargarlo:
$ helm fetch rook-master/rook-ceph --untar --version 1.0.0 En el archivo rook-ceph/values.yaml se pueden encontrar numerosas configuraciones diferentes. Lo más importante es especificar tolerancias para los agentes y la búsqueda. Para qué se puede usar el mecanismo de taints/tolerations, lo hemos explicado en .
En resumen, no queremos que los pods con la aplicación cliente se ubiquen en los mismos nodos donde están los discos para el almacenamiento de datos. La razón es sencilla: así, el funcionamiento de los agentes Rook no afectará a la propia aplicación.
Así que abrimos el archivo rook-ceph/values.yaml con nuestro editor favorito y añadimos el siguiente bloque al final:
discover:
  toleration: NoExecute
  tolerationKey: node-role/storage
agent:
  toleration: NoExecute
  tolerationKey: node-role/storage
  mountSecurityMode: Any
A cada nodo reservado para el almacenamiento de datos, le añadimos el taint correspondiente:
$ kubectl taint node ${NODE_NAME} node-role/storage="":NoExecuteDespués, instalamos el chart de Helm con el siguiente comando:
$ helm install --namespace ${ROOK_NAMESPACE} ./rook-cephAhora es necesario crear un clúster y especificar la ubicación de :
apiVersion: ceph.rook.io/v1
kind: CephCluster
metadata:
  clusterName: "ceph"
  finalizers:
  - cephcluster.ceph.rook.io
  generation: 1
  name: rook-ceph
spec:
  cephVersion:
    image: ceph/ceph:v13
  dashboard:
    enabled: true
  dataDirHostPath: /var/lib/rook/osd
  mon:
    allowMultiplePerNode: false
    count: 3
  network:
    hostNetwork: true
  rbdMirroring:
    workers: 1
  placement:
    all:
      tolerations:
      - key: node-role/storage
        operator: Exists
  storage:
    useAllNodes: false
    useAllDevices: false
    config:
      osdsPerDevice: "1"
      storeType: filestore
    resources:
      limits:
        memory: "1024Mi"
      requests:
        memory: "1024Mi"
    nodes:
    - name: host-1
      directories:
      - path: "\/mnt\/osd"
    - name: host-2
      directories:
      - path: "\/mnt\/osd"
    - name: host-3
      directories:
      - path: "\/mnt\/osd"
Verificamos el estado de Ceph; esperamos ver HEALTH_OK:
$ kubectl -n ${ROOK_NAMESPACE} exec $(kubectl -n ${ROOK_NAMESPACE} get pod -l app=rook-ceph-operator -o name -o jsonpath='{.items[0].metadata.name}') -- ceph -sAdemás, verificamos que los pods con la aplicación cliente no caigan en los nodos reservados para Ceph:
$ kubectl -n ${APPLICATION_NAMESPACE} get pods -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeNameA continuación, opcionalmente se configuran componentes adicionales. Más detalles sobre ellos se indican en . Para la administración, recomendamos encarecidamente instalar el dashboard y la toolbox.
¿Rook-a-hooks: es suficiente con lo que ofrece Rook?
Como se puede ver, el desarrollo de Rook avanza a buen ritmo. Sin embargo, todavía existen problemas que nos impiden abandonar por completo la configuración manual de Ceph:
- Ningún controlador de Rook exportar métricas sobre el uso de bloques montados, lo que nos priva de monitorear.
- Flexvolume y CSI cambiar el tamaño de los volúmenes (a diferencia de RBD), por lo que Rook se queda sin una herramienta útil (¡y a veces crítica!).
- Rook todavía no es tan flexible como Ceph convencional. Si queremos configurar el pool para los metadatos de CephFS en SSD y los propios datos en HDD, tendremos que especificar grupos de dispositivos en los mapas CRUSH manualmente.
- A pesar de que el operador rook-ceph se considera estable, actualmente existen ciertos problemas al actualizar Ceph de la versión 13 a la 14.
Conclusiones
«Actualmente, la Torre está cerrada al mundo exterior por los peones, pero creemos que algún día jugará un papel crucial en la partida!» (cita especialmente creada para este artículo)
El proyecto Rook, sin duda, ha conquistado nuestros corazones: pensamos que [con todos sus pros y contras] realmente merece su atención.
Nuestros planes futuros se centran en hacer que rook-ceph sea un módulo para , lo que hará que su uso en nuestros numerosos clústeres de Kubernetes sea aún más simple y conveniente.
P.D.
También puedes leer en nuestro blog:
- «»;
- «»;
- «»;
- «»;
- «».
Fuente: habr.com
