

Según , el ingeniero de datos es actualmente una de las profesiones de más rápido crecimiento. El ingeniero de datos desempeña un papel crítico en las organizaciones, creando y manteniendo pipelines y bases de datos que se utilizan para el procesamiento, transformación y almacenamiento de datos. ¿Qué habilidades son más necesarias para los representantes de esta profesión? ¿Es diferente la lista de lo que se requiere de los científicos de datos? Todo esto lo descubrirás en mi artículo.
He analizado las ofertas de trabajo para la posición de ingeniero de datos tal como están en enero de 2020, para entender qué habilidades tecnológicas son más buscadas. Luego comparé los resultados obtenidos con las estadísticas de ofertas de trabajo para la posición de científico de datos, revelando algunas diferencias interesantes.
Sin más preámbulos, aquí están las diez tecnologías que se mencionan con más frecuencia en los textos de las ofertas de trabajo:
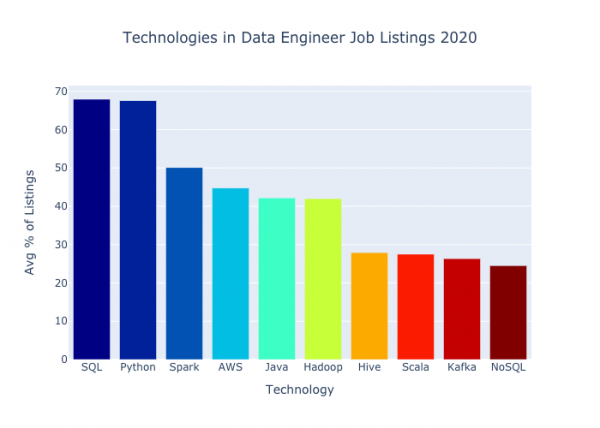
Menciones de tecnologías en ofertas de trabajo para ingeniero de datos en 2020
Vamos a analizarlo.
Responsabilidades del ingeniero de datos
Hoy en día, el trabajo que realizan los ingenieros de datos es de gran importancia para las organizaciones; estas personas son responsables del almacenamiento de información y la convierten en un formato que otros empleados pueden utilizar. Los ingenieros de datos construyen pipelines para facilitar la obtención de datos, ya sea en flujo o en lotes, de múltiples fuentes. Luego, los pipelines realizan operaciones de extracción, transformación y carga (es decir, procesos ETL), haciendo que los datos sean más útiles para su posterior uso. Después, los datos se entregan a analistas y científicos de datos para un procesamiento más profundo. Finalmente, los datos concluyen su viaje en tableros de información, informes y modelos para aprendizaje automático.
He buscado información que permita concluir cuáles son las tecnologías más demandadas en el trabajo del ingeniero de datos en la actualidad.
Los métodos
He recopilado información de tres sitios de búsqueda de empleo — , y y he observado qué palabras clave aparecen en combinación con «ingeniero de datos» en los textos de las ofertas de trabajo dirigidas a residentes de EE.UU. Para esta tarea, utilicé dos bibliotecas de Python — y . He incluido tanto las palabras clave que estaban en la lista anterior para el análisis de ofertas de trabajo para la posición de data scientist, como las que seleccioné manualmente al leer anuncios de empleo para data engineers. LinkedIn no fue una de las fuentes, ya que fui bloqueado después de mi intento anterior de recopilar datos.
Para cada palabra clave, conté el porcentaje de coincidencias del total de textos en cada uno de los sitios por separado y luego calculé el valor promedio de las tres fuentes.
Resultados
A continuación se presentan treinta términos técnicos del campo de la ingeniería de datos con los índices más altos en los tres sitios de ofertas de trabajo.
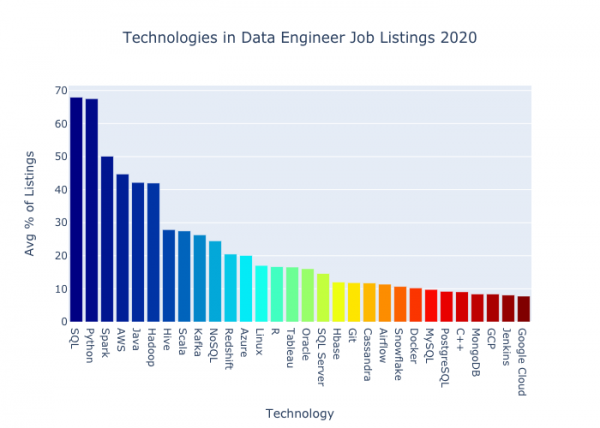
Aquí están los mismos números, pero presentados en forma de tabla:
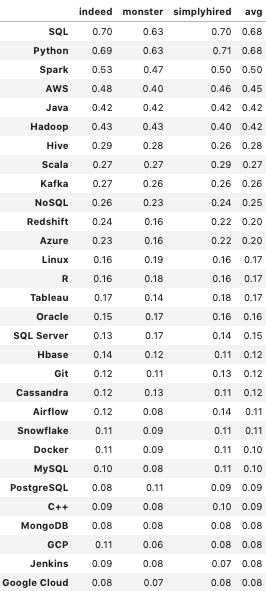
Sigamos en orden.
Resumen de resultados
Tanto SQL como Python aparecen en más de dos tercios de las ofertas analizadas. Estas dos tecnologías son las que tiene sentido estudiar primero. – es un lenguaje de programación muy popular, utilizado para trabajar con datos, crear sitios web y escribir scripts. significa Structured Query Language (lenguaje de consultas estructuradas); implica un estándar que es implementado por un grupo de lenguajes y se utiliza para extraer datos de bases de datos relacionales. Ha existido durante mucho tiempo y ha demostrado ser muy estable.
Spark se menciona en aproximadamente la mitad de las ofertas de trabajo. – es un "motor analítico unificado para procesar grandes datos con módulos integrados para transmisión de datos, SQL, aprendizaje automático y procesamiento de gráficos". Es especialmente popular entre quienes trabajan con bases de datos de gran tamaño.
AWS aparece en aproximadamente el 45% de los textos de las ofertas. Es una plataforma de computación en la nube de Amazon; tiene la mayor cuota de mercado entre todas las plataformas en la nube.
Le siguen Java y Hadoop, con poco más del 40% cada uno. – un lenguaje ampliamente utilizado, probado en batalla, que en ocupó el décimo lugar entre los lenguajes que causan terror a los programadores. En contraste, Python quedó en segundo lugar entre los lenguajes más queridos. Java es gestionado por Oracle, y todo lo que necesitas saber sobre él se puede entender a partir de esta captura de pantalla de la página oficial de enero de 2020.
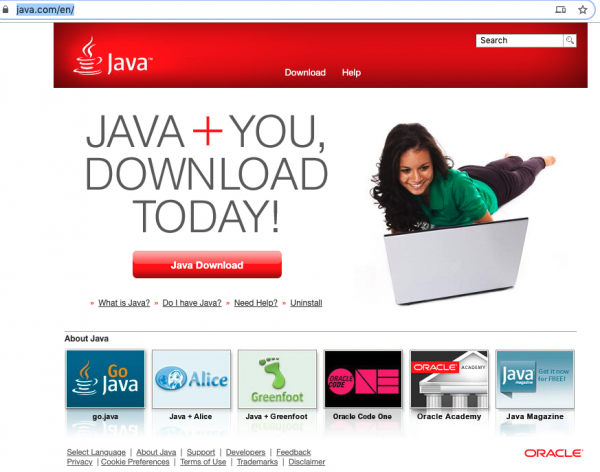
Como si hubiera viajado en una máquina del tiempo
utiliza el modelo de programación MapReduce con clústeres de servidores para grandes datos. Actualmente, este modelo está siendo cada vez más abandonado.
A continuación, vemos Hive, Scala, Kafka y NoSQL; cada una de estas tecnologías se menciona en una cuarta parte de las ofertas de trabajo presentadas. Apache Hive es un programa de almacenamiento de datos que "facilita la lectura, escritura y gestión de grandes conjuntos de datos ubicados en almacenes distribuidos mediante SQL". – es un lenguaje de programación que se utiliza activamente en el trabajo con grandes datos. En particular, Spark fue creado usando Scala. En el ya mencionado ranking de lenguajes temidos, Scala ocupa el undécimo lugar. – es una plataforma distribuida para el procesamiento de mensajes en tiempo real. Es muy popular como medio para la transmisión de datos.
se oponen a SQL. Se diferencian en que no son relacionales, no están estructurados y poseen escalabilidad horizontal. NoSQL ha ganado cierta popularidad, sin embargo, la frenética fascinación por este enfoque, hasta el punto de profecías de que sustituirá a SQL como la principal paradigma de almacenamiento, parece haber quedado atrás.
Comparación de términos en ofertas de trabajo de data scientist
Aquí hay treinta términos tecnológicos más comunes entre los empleadores en el ámbito de la ciencia de datos. Esta lista la obtuve mediante el mismo método que describí anteriormente para la ingeniería de datos.
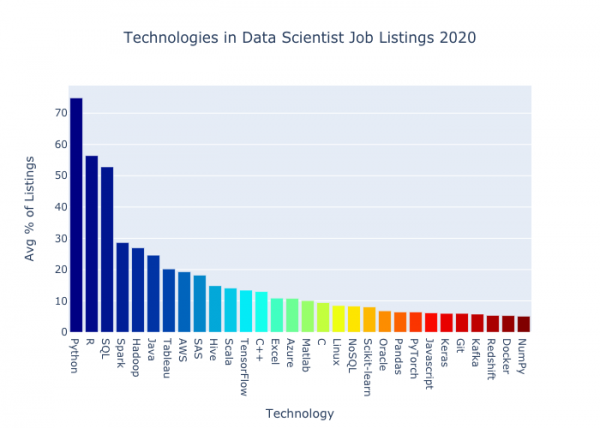
Menciones de tecnologías en ofertas de trabajo para la posición de data scientist en 2020
Hablando en términos generales, en comparación con el conjunto anterior, ha habido un 28% más de ofertas de trabajo (12,013 contra 9,396). Veamos qué tecnologías aparecen con menos frecuencia en las ofertas para data scientists en comparación con las de data engineers.
Más populares en ingeniería de datos
En el gráfico a continuación se muestran las palabras clave con una diferencia media en los valores superior al 10% o inferior al -10%.
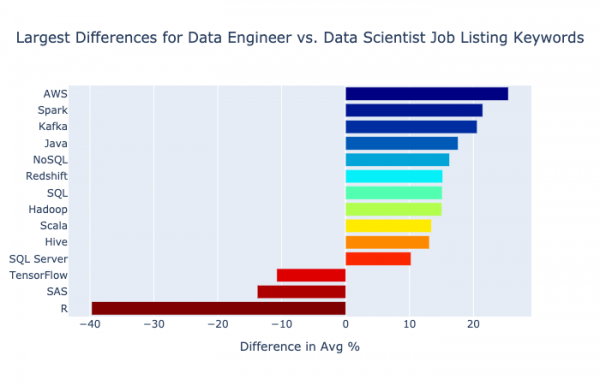
Las mayores diferencias en la frecuencia de palabras clave entre data engineers y data scientists
El mayor incremento se registra en AWS: en ingeniería de datos aparece un 25% más a menudo que en ciencia de datos (aproximadamente 45% y 20% del total de ofertas respectivamente). ¡La diferencia es notable!
Aquí están los mismos datos en una representación ligeramente diferente: en el gráfico, los resultados para la misma palabra clave en las ofertas de trabajo para la posición de data engineer y data scientist están uno al lado del otro.
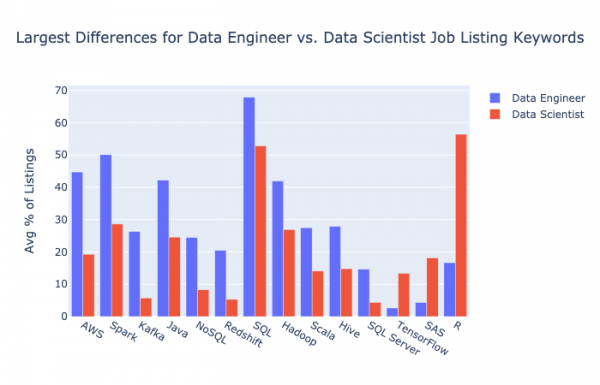
Las mayores diferencias en la frecuencia de palabras clave entre data engineers y data scientists
El siguiente gran salto lo observé en Spark: los ingenieros de datos a menudo trabajan con grandes volúmenes de datos. también aumentó un 20%, es decir, casi cuatro veces en comparación con el resultado de las vacantes para data scientist. La transmisión de datos es una de las responsabilidades clave del data engineer. Finalmente, el número de menciones fue un 15% mayor en el área de data engineering para Java, NoSQL, Redshift, SQL y Hadoop.
Menos populares en data engineering
Ahora veamos qué tecnologías son menos populares en las vacantes para data engineer.
La caída más pronunciada en comparación con el área de data science ocurrió en : allí figuraba en aproximadamente el 56% de las vacantes, aquí – solo en el 17%. Impresionante. R es un lenguaje de programación popular entre científicos y estadísticos, además ocupa el octavo lugar en el ranking de lenguajes temidos.
también aparece en las vacantes para el puesto de data engineer con bastante menos frecuencia: la diferencia es del 14%. SAS es un lenguaje patentado diseñado para trabajar con estadísticas y datos. Un dato interesante: según los resultados , últimamente ha perdido mucho terreno - más que cualquier otra tecnología.
Demandados tanto en data engineering como en data science
Cabe destacar que ocho de las diez primeras posiciones en ambos conjuntos coinciden. SQL, Python, Spark, AWS, Java, Hadoop, Hive y Scala están en el top diez tanto para la industria de data engineering como para data science. En el gráfico a continuación, puedes ver las quince tecnologías más populares entre los empleadores de data engineers, y al lado, su índice en las vacantes para data scientists.
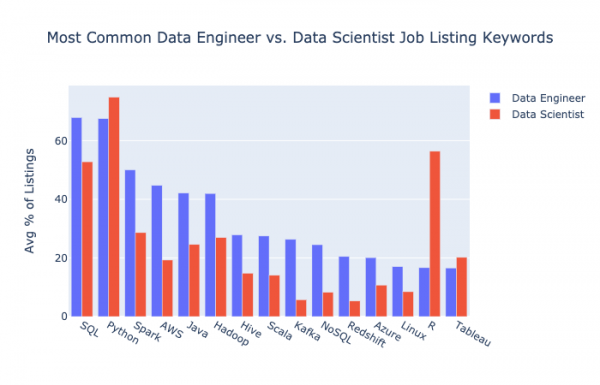
Recomendaciones
Si deseas trabajar en data engineering, te recomendaría dominar las siguientes tecnologías, las enumero en orden de prioridad aproximada.
Aprende SQL. Te sugiero PostgreSQL, porque es de código abierto, tiene una gran popularidad en la comunidad y está en fase de crecimiento. Puedes aprender a usar el lenguaje en el libro My Memorable SQL, cuya versión piloto está disponible .
Domina Python, aunque no a un nivel extremadamente avanzado. El libro My Memorable Python está diseñado para principiantes. Lo puedes comprar en , ya sea una copia electrónica o física, como prefieras, o descargar en formato pdf o epub .
Una vez que te familiarices con Python, pasa a pandas, la biblioteca de Python utilizada para la limpieza y el procesamiento de datos. Si tu objetivo es trabajar en una empresa que requiera habilidades en Python (y la mayoría lo hace), puedes estar seguro de que el conocimiento de pandas se asumirá por defecto. Estoy finalizando una guía introductoria para trabajar con pandas; puedes , para no perderte el lanzamiento.
Domina AWS. Si quieres convertirte en ingeniero de datos, necesitas tener una plataforma en la nube en tu arsenal, y AWS es la más popular. Los cursos de , me ayudaron mucho cuando estudiaba , creo que también tienen buenos materiales para AWS.
Si ya has dominado toda esta lista y quieres seguir creciendo a los ojos de los empleadores como ingeniero de datos, te sugiero que añadas Apache Spark para trabajar con grandes datos. Aunque mi investigación sobre ofertas de trabajo en ciencia de datos mostró una disminución de interés, entre los ingenieros de datos sigue apareciendo en casi cada segunda oferta.
Por último
, espero que este resumen de las tecnologías más demandadas para ingenieros de datos te haya parecido útil. Si tienes interés en cómo están las ofertas para analistas, lee . ¡Éxito en tu ingeniería!
Fuente: habr.com
