

Serverless no se trata de la ausencia física de servidores. No es un «asesino» de contenedores ni una moda pasajera. Es un nuevo enfoque para construir sistemas en la nube. En el artículo de hoy abordaremos la arquitectura de aplicaciones Serverless, veremos qué papel juega el proveedor de servicios Serverless y los proyectos de código abierto. Al final, discutiremos sobre las cuestiones de aplicación de Serverless.
Quiero escribir la parte del servidor de una aplicación (incluso una tienda en línea). Puede ser un chat, un servicio para publicar contenido o un balanceador de carga. De todos modos, habrá muchos dolores de cabeza: necesitaré preparar la infraestructura, definir las dependencias de la aplicación y pensar en el sistema operativo del host. Luego necesitaré actualizar pequeños componentes que no afecten al resto del monolito. Y no olvidemos el escalado bajo carga.
¿Y si tomamos contenedores efímeros, en los que ya están preinstaladas las dependencias necesarias, y los propios contenedores están aislados unos de otros y del sistema operativo del host? Dividiremos el monolito en microservicios, cada uno de los cuales se puede actualizar y escalar independientemente de los demás. Al colocar el código en un contenedor así, podré ejecutarlo en cualquier infraestructura. Ya es mejor.
¿Y si no quiero configurar contenedores? No quiero pensar en el escalado de la aplicación. No quiero pagar por la inactividad de los contenedores en ejecución cuando la carga en el servicio es mínima. Quiero escribir código. Concentrarme en la lógica del negocio y lanzar productos al mercado a la velocidad de la luz.
Estos pensamientos me llevaron a la computación sin servidor. Serverless en este caso significa no la ausencia física de servidores, sino la eliminación del dolor de cabeza por gestionar la infraestructura.
La idea es que la lógica de la aplicación se divide en funciones independientes. Tienen una estructura basada en eventos. Cada función ejecuta una «microtarea». Todo lo que se requiere del desarrollador es cargar las funciones en la consola proporcionada por el proveedor de la nube y asociarlas con las fuentes de eventos. El código se ejecutará a demanda en un contenedor preparado automáticamente, y solo pagaré por el tiempo de ejecución.
Veamos cómo lucirá ahora el proceso de desarrollo de una aplicación.
Desde la perspectiva del desarrollador
Anteriormente comenzamos a hablar sobre la aplicación para la tienda en línea. En el enfoque tradicional, la lógica principal del sistema es llevada a cabo por una aplicación monolítica. Y el servidor con la aplicación está constantemente en funcionamiento, incluso si no hay carga.
Para pasar a serverless, descomponemos la aplicación en microtareas. Para cada una de ellas escribimos nuestra función. Las funciones son independientes entre sí y no almacenan información sobre el estado (stateless). Incluso pueden estar escritas en diferentes lenguajes. Si una de ellas 'cae', la aplicación en su totalidad no se detendrá. La arquitectura de la aplicación se verá así:
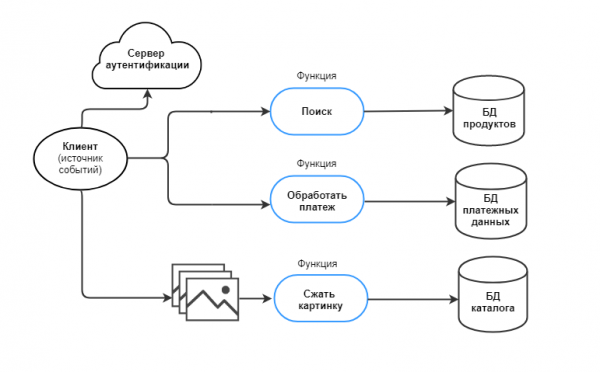
La división en funciones en Serverless es similar al trabajo con microservicios. Pero un microservicio puede realizar varias tareas, mientras que una función, en ideal, debe realizar una sola. Supongamos que hay una tarea de recopilar estadísticas y mostrarlas a solicitud del usuario. En el enfoque de microservicios, la tarea la lleva a cabo un servicio con dos puntos de entrada: para escritura y lectura. En los cálculos serverless, estas serán dos funciones diferentes, no conectadas entre sí. El desarrollador ahorra recursos computacionales si, por ejemplo, las estadísticas se actualizan con más frecuencia de la que se exportan.
Las funciones serverless deben ejecutarse en un corto período de tiempo (timeout), que determina el proveedor del servicio. Por ejemplo, para AWS, el timeout es de 15 minutos. Esto significa que las funciones de larga duración (long-lived) tendrán que modificarse de acuerdo a los requisitos, lo que diferencia a Serverless de otras tecnologías populares en la actualidad (contenedores y Platform as a Service).
Asignamos un evento a cada función. Un evento es un desencadenante para la acción:
Evento
La acción que realiza la función
Se ha cargado en el almacenamiento la imagen del producto
Comprimir la imagen y exportar al catálogo
La dirección de la tienda física se ha actualizado en la base de datos
Cargar en los mapas la nueva ubicación
El cliente paga por el producto
Iniciar el procesamiento del pago
Los eventos pueden ser solicitudes HTTP, datos en flujo, colas de mensajes, etc. Las fuentes de eventos son cambios o apariciones de datos. Además, se pueden ejecutar funciones según un temporizador.
Hemos trabajado en la arquitectura y la aplicación casi se ha vuelto serverless. Ahora avanzamos hacia el proveedor del servicio.
Desde el lado del proveedor
Normalmente, los cálculos serverless son ofrecidos por proveedores de servicios en la nube. Se les llama de diferentes maneras: Azure Functions, AWS Lambda, Google Cloud Functions, IBM Cloud Functions.
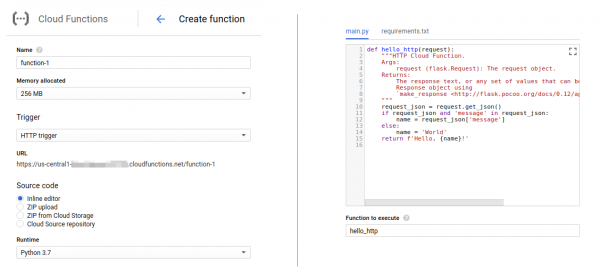
Usaremos el servicio a través de la consola o el panel del proveedor. El código de las funciones se puede cargar de una de las siguientes maneras:
- escribiendo el código en editores integrados a través de la consola web,
- cargando un archivo comprimido con el código,
- trabajando con repositorios git públicos o privados.
Aquí también configuramos los eventos que activan la función. Los conjuntos de eventos pueden variar entre diferentes proveedores.
El proveedor ha construido y automatizado un sistema de Function as a Service (FaaS) en su infraestructura:
- El código de las funciones se almacena en el lado del proveedor.
- Cuando ocurre un evento, se despliegan automáticamente contenedores en el servidor con un entorno preparado. Cada instancia de la función tiene su propio contenedor aislado.
- Desde el almacenamiento, la función se envía al contenedor, se calcula y devuelve el resultado.
- A medida que aumentan los eventos paralelos, también aumenta el número de contenedores. El sistema se escala automáticamente. Si los usuarios no acceden a la función, estará inactiva.
- El proveedor establece el tiempo de inactividad de los contenedores: si durante este tiempo no se invocan funciones en el contenedor, se destruye.
Así obtenemos Serverless «listo para usar». Pagaremos por el servicio bajo el modelo pay-as-you-go y solo por las funciones que se utilizan y solo por el tiempo que han sido utilizadas.
Para familiarizar a los desarrolladores con el servicio, los proveedores ofrecen hasta 12 meses de prueba gratuita, pero limitan el tiempo total de cálculos, el número de solicitudes al mes, los fondos o la potencia consumida.
La principal ventaja de trabajar con un proveedor es la posibilidad de no preocuparse por la infraestructura (servidores, máquinas virtuales, contenedores). Por su parte, el proveedor puede implementar FaaS tanto en sus propios desarrollos como con herramientas de código abierto. Hablaremos de ellas a continuación.
Desde el lado de open source
En los últimos dos años, la comunidad open-source ha trabajado activamente en herramientas Serverless. Incluyendo la contribución al desarrollo de plataformas sin servidor de los principales actores del mercado:
- Google ofrece a los desarrolladores su herramienta de código abierto ― . En su desarrollo participaron IBM, RedHat, Pivotal y SAP;
- IBM trabajaron en la plataforma Serverless , que luego se convirtió en un proyecto de Apache Foundation;
- Microsoft abrieron parcialmente el código de la plataforma .
El desarrollo también avanza en la dirección de los frameworks sin servidor. y que se despliegan dentro de clústeres de Kubernetes preparados de antemano, funciona tanto con Kubernetes como con Docker Swarm. El framework actúa como un controlador que, a petición, prepara un entorno de ejecución dentro del clúster y luego ejecuta la función allí.
Los frameworks permiten personalizar la herramienta para satisfacer las necesidades específicas. Por ejemplo, en Kubeless, el desarrollador puede configurar el tiempo de espera para la ejecución de la función (el valor predeterminado es de 180 segundos). Fission, en su intento de resolver el problema del inicio en frío, ofrece mantener algunos contenedores siempre encendidos (aunque esto conlleva costos por recursos inactivos). OpenFaaS, por su parte, ofrece un conjunto de activadores para todos los gustos: HTTP, Kafka, Redis, MQTT, Cron, AWS SQS, NATs y otros.
Las instrucciones para comenzar se pueden encontrar en la documentación oficial de los frameworks. Trabajar con ellos implica tener habilidades ligeramente superiores en comparación con trabajar con un proveedor, al menos saber cómo iniciar un clúster de Kubernetes a través de la CLI. En el mejor de los casos, incluir en el trabajo otras herramientas de código abierto (como un gestor de colas Kafka).
Independientemente del método que utilicemos para trabajar con Serverless, ya sea a través de un proveedor o utilizando herramientas de código abierto, obtendremos una serie de ventajas y desventajas del enfoque Serverless.
Desde la perspectiva de ventajas y desventajas,
Serverless desarrolla las ideas de la infraestructura de contenedores y el enfoque de microservicios, donde los equipos pueden trabajar en un modo multilingüe sin depender de una sola plataforma. La construcción del sistema se simplifica y es más fácil corregir errores. La arquitectura de microservicios permite agregar nuevas funcionalidades al sistema mucho más rápido que en el caso de una aplicación monolítica.
Serverless reduce aún más el tiempo de desarrollo, permitiendo al desarrollador centrarse exclusivamente en la lógica empresarial de la aplicación y en escribir código. Como resultado, el tiempo de lanzamiento al mercado se reduce.
Como ventaja adicional, obtenemos escalado automático bajo carga, y solo pagamos por los recursos utilizados y solo durante el tiempo en que son utilizados.
Como cualquier tecnología, Serverless tiene desventajas.
Por ejemplo, una de estas desventajas puede ser el tiempo de inicio en frío (en promedio hasta 1 segundo para lenguajes como JavaScript, Python, Go, Java, Ruby).
Por un lado, en la práctica, el tiempo de arranque en frío depende de muchas variables: el lenguaje en el que está escrita la función, la cantidad de bibliotecas, el volumen de código, la comunicación con recursos adicionales (como bases de datos o servidores de autenticación). Dado que el desarrollador gestiona estas variables, puede reducir el tiempo de arranque. Pero, por otro lado, el desarrollador no puede controlar el tiempo de inicio del contenedor; aquí todo depende del proveedor.
El arranque en frío puede convertirse en cálido cuando la función reutiliza un contenedor que fue iniciado por el evento anterior. Esta situación ocurrirá en tres casos:
- si los clientes utilizan el servicio con frecuencia y crece el número de solicitudes a la función;
- si el proveedor, la plataforma o el marco permiten mantener algunos contenedores en ejecución todo el tiempo;
- si el desarrollador inicia funciones mediante temporizadores (digamos, cada 3 minutos).
Para muchas aplicaciones, el arranque en frío no es un problema. Aquí se debe partir del tipo y las tareas del servicio. Un retraso en el arranque de un segundo no siempre es crítico para una aplicación empresarial, pero puede ser crítico para servicios médicos. Probablemente, en este caso, el enfoque sin servidor ya no sea adecuado.
La siguiente desventaja del Serverless se menciona como el corto tiempo de vida de la función (timeout, dentro del cual la función debe ejecutarse).
Pero, si se deben manejar tareas de larga duración, se puede utilizar una arquitectura híbrida, combinando Serverless con otra tecnología.
No todos los sistemas podrán trabajar con el esquema Serverless.
Algunas aplicaciones seguirán almacenando datos y estado durante la ejecución. Algunas arquitecturas permanecerán monolíticas, y algunas funciones serán de larga duración. Sin embargo, (como alguna vez lo fueron las tecnologías en la nube y luego los contenedores), Serverless es una tecnología con un gran futuro.
En este sentido, me gustaría pasar suavemente a la cuestión de la aplicación del enfoque Serverless.
Desde el punto de vista de la aplicación
Durante 2018, el porcentaje de uso de Serverless . Entre las empresas que ya han implementado la tecnología en sus servicios se encuentran gigantes del mercado como Twitter, PayPal, Netflix, T-Mobile y Coca-Cola. Al mismo tiempo, es necesario entender que Serverless no es una panacea, sino una herramienta para resolver un determinado conjunto de tareas:
- Reducir el tiempo de inactividad de los recursos. No es necesario mantener una máquina virtual para servicios que reciben pocas consultas.
- Procesar datos «sobre la marcha». Comprimir imágenes, eliminar fondos, cambiar la codificación de videos, trabajar con sensores IoT, realizar operaciones matemáticas.
- «Unir» otros servicios entre sí. Repositorio Git con programas internos, chatbot en Slack con Jira y con el calendario.
- Balancear la carga. Aquí nos detendremos en más detalle.
Supongamos que hay un servicio que recibe 50 personas. Detrás hay una máquina virtual con hardware limitado. De vez en cuando, la carga del servicio aumenta drásticamente. En ese caso, el hardware débil no puede manejarlo.
Se puede incluir en el sistema un balanceador que distribuya la carga, digamos, entre tres máquinas virtuales. En esta etapa, no podemos predecir con precisión la carga, por lo que mantenemos encendido un cierto número de recursos «de reserva». Y pagamos de más por inactividad.
En tal situación, podemos optimizar el sistema a través de un enfoque híbrido: dejamos una máquina virtual detrás del balanceador de carga y colocamos un enlace a un Endpoint Serverless con funciones. Si la carga supera el umbral, el balanceador inicia instancias de funciones que se encargan de parte del procesamiento de las solicitudes.
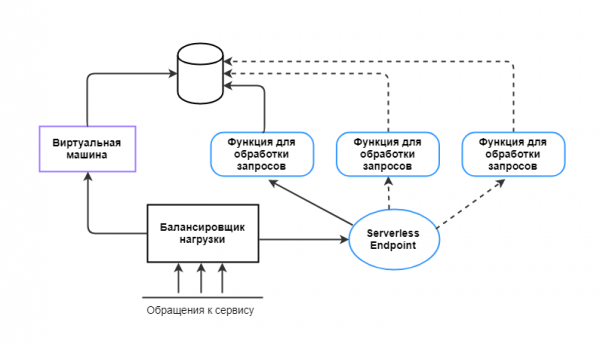
De este modo, Serverless se puede usar en situaciones donde se necesitan manejar grandes volúmenes de solicitudes de manera intensa, aunque no muy frecuentemente. En este caso, es más rentable ejecutar varias funciones durante 15 minutos que mantener una máquina virtual o servidor siempre activo.
A pesar de todas las ventajas de la computación sin servidor, antes de su implementación, es fundamental evaluar la lógica de la aplicación y entender qué tareas puede resolver Serverless en cada caso específico.
Serverless y Selectel
En Selectel ya hemos a través de nuestro panel de control. Ahora estamos construyendo nuestra propia plataforma FaaS. Queremos que los desarrolladores puedan resolver sus tareas mediante Serverless a través de una interfaz práctica y flexible.
Si tienes ideas sobre cómo debería ser la plataforma FaaS ideal y cómo te gustaría usar Serverless en tus proyectos, compártelas en los comentarios. Tendremos en cuenta tus sugerencias al desarrollar la plataforma.
Materiales utilizados en el artículo:
Fuente: habr.com
