

El director de operaciones del portal Banki.ru, Andrey Nikolsky, habló en la conferencia del año pasado. sobre los servicios huérfanos: cómo identificar un huérfano en la infraestructura, cuáles son los problemas de los servicios huérfanos, qué hacer con ellos, y cómo proceder si nada ayuda.
A continuación, la versión textual de la presentación.
¡Hola, colegas! Mi nombre es Andrey, y dirijo las operaciones en la empresa Banki.ru.
Tenemos grandes servicios, como los monolitos, hay servicios en un sentido más clásico, y hay algunos muy pequeños. En mi jerga, digo que si un servicio es simple y pequeño, es un microservicio; y si no es tan simple y no es pequeño, simplemente es un servicio.
Ventajas de los servicios
Voy a repasar rápidamente las ventajas de los servicios.
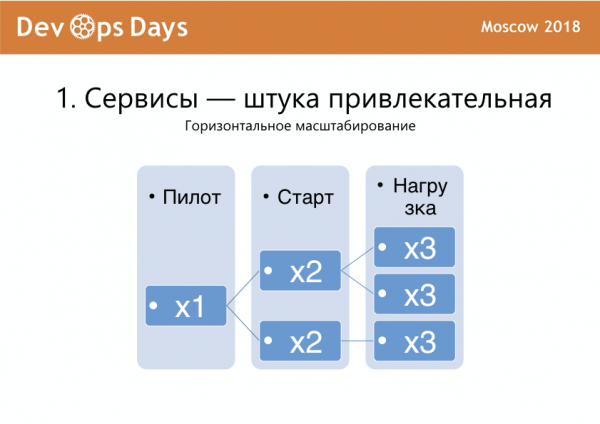
La primera es la escalabilidad. Puedes hacer algo rápidamente en el servicio y lanzarlo a producción. Si llega tráfico, clonas el servicio. Si llega más tráfico, lo vuelves a clonar y así continúas. Esta es una buena ventaja y, de hecho, cuando comenzamos, era lo más importante para nosotros, la razón por la que estábamos haciendo todo esto.
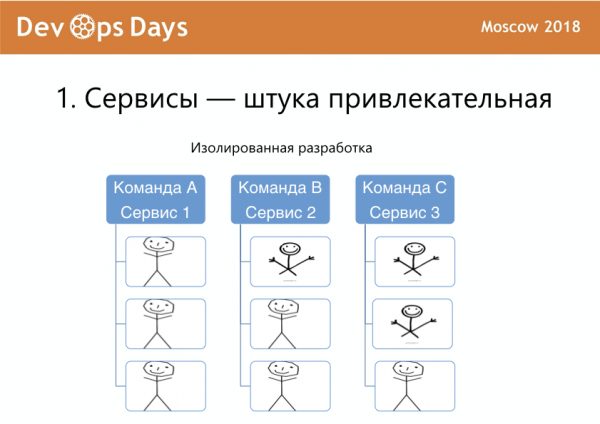
En segundo lugar, el desarrollo aislado, cuando tienes varios equipos de desarrollo, diferentes desarrolladores en cada equipo, y cada equipo trabaja en su propio servicio.
Surge un matiz con los equipos. Los desarrolladores son diferentes. Y, por ejemplo, . Lo vi por primera vez con Maxim Dorofeev. A veces hay personas ‘copos de nieve’ en algunos equipos, y en otros no. Esto hace que los diferentes servicios utilizados en la empresa sean un poco desiguales.
Mira la imagen: este es un buen desarrollador, tiene grandes manos, puede hacer muchas cosas. El problema principal es de dónde provienen esas manos.
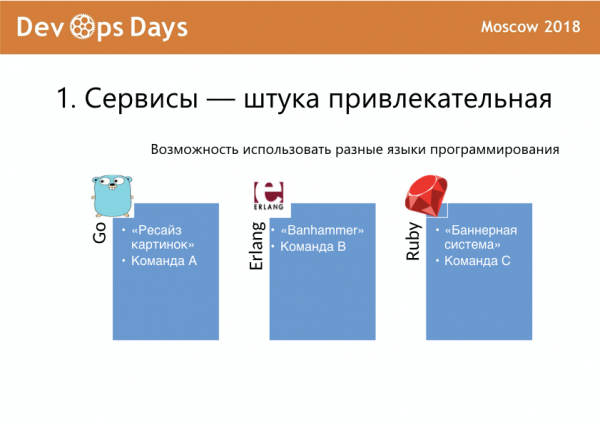
Los servicios permiten utilizar diferentes lenguajes de programación, más apropiados para diferentes tareas. Un servicio puede estar en Go, otro en Erlang, otro en Ruby, uno en PHP, otro en Python. En general, se puede ampliar mucho. También hay matices aquí.
La arquitectura orientada a servicios se trata, ante todo, de devops. Es decir, si no tienes automatización, no hay un proceso de despliegue, si lo configuras manualmente, tu configuración puede cambiar de una instancia de servicio a otra, y tienes que ir allí a hacer algo, entonces estás en el infierno.
Por ejemplo, si tienes 20 servicios y necesitas desplegarlos manualmente, tendrás 20 consolas y presionarás "enter" al mismo tiempo, como un ninja. Eso no es lo ideal.
Si tienes un servicio después de pruebas (si, por supuesto, se hicieron pruebas), y tienes que ajustarlo para que funcione en producción, tengo también malas noticias para ti.
Si dependes de servicios específicos de Amazon y trabajas en Rusia, hace dos meses también estabas pensando "Todo arde a mi alrededor, estoy bien, todo está genial".
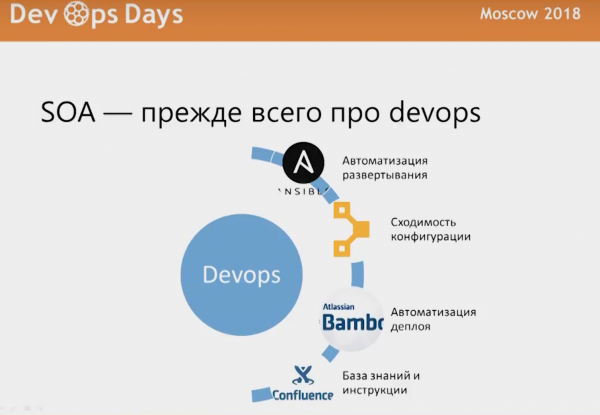
Utilizamos Ansible para automatizar el despliegue, Puppet para la convergencia, Bamboo para la automatización del despliegue y Confluence para documentar todo esto de alguna manera.
No profundizaré en esto, porque la charla se centra más en las prácticas de interacción que en la implementación técnica.
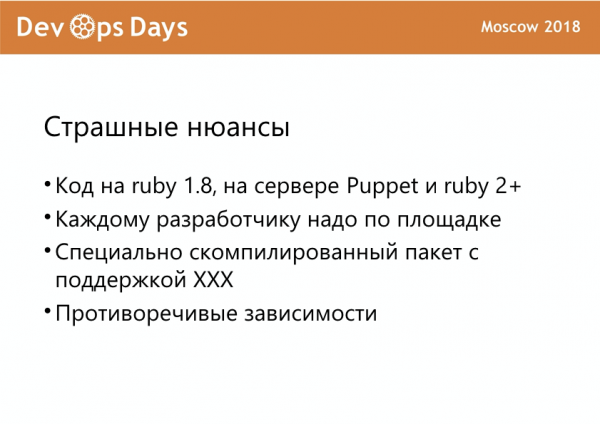
Hemos tenido problemas en los que Puppet en el servidor trabaja con Ruby 2, mientras que alguna aplicación está escrita para Ruby 1.8, y juntos no funcionan. Sucede algún tipo de error. Y cuando necesitas mantener varias versiones de Ruby en una sola máquina, generalmente comienzan los problemas.
Por ejemplo, a cada desarrollador le proporcionamos un entorno donde tiene casi todo lo que tenemos, todos los servicios que se pueden desarrollar, para que tenga un entorno aislado donde pueda romper y construir a su antojo.
A veces, se necesita un paquete especialmente compilado con soporte para algo. Eso es bastante estricto. Escuché una presentación donde la imagen de Docker pesaba 45 GB. En Linux, por supuesto, es más sencillo, allí todo es más pequeño, pero de todos modos, no habrá suficiente espacio.
Y también hay dependencias conflictivas, cuando una parte del proyecto depende de una versión de biblioteca, otra parte del proyecto de otra versión, y las bibliotecas no se pueden instalar juntas en absoluto.
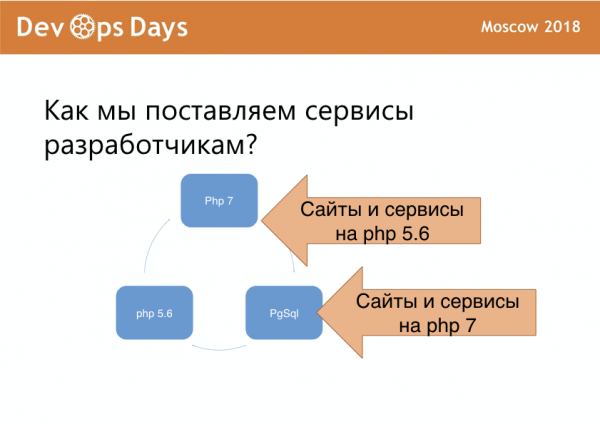
Tenemos sitios y servicios en PHP 5.6, de los cuales nos avergonzamos, pero ¿qué podemos hacer? Esa es nuestra única plataforma. Hay sitios y servicios en PHP 7, son más numerosos, de los cuales no nos avergonzamos. Y cada desarrollador tiene su propia base donde se divierte programando.
Si en la empresa se programa en un solo lenguaje, tres máquinas virtuales por desarrollador suena normal. Si tienes diferentes lenguajes de programación, la situación se complica.
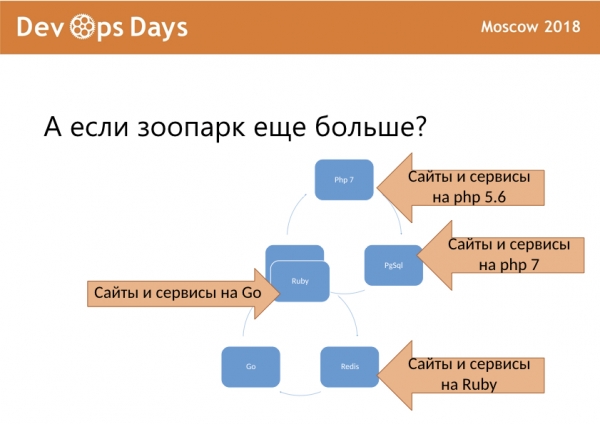
Tienes sitios y servicios aquí, aquí, luego otra plataforma para Go, una plataforma para Ruby, y algún Redis adicional. Al final, todo esto se convierte en un gran campo de soporte, y siempre hay algo que puede romperse.
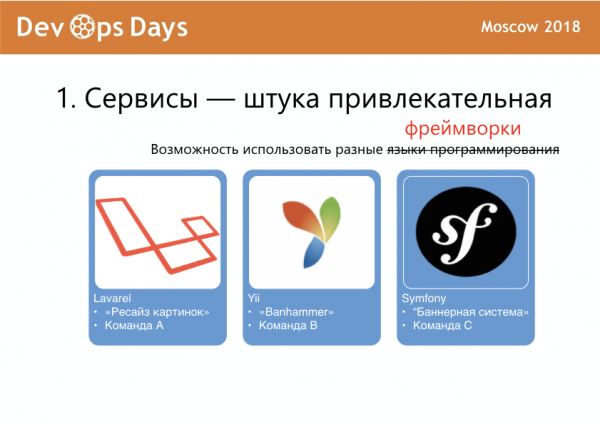
Por eso reemplazamos las características del lenguaje de programación por el uso de diferentes frameworks, ya que los frameworks en PHP son bastante diversos, tienen diferentes capacidades, diferentes comunidades, y diferente soporte. Se puede desarrollar un servicio de manera que ya tengas algo disponible para él.
Cada servicio tiene su propio equipo.
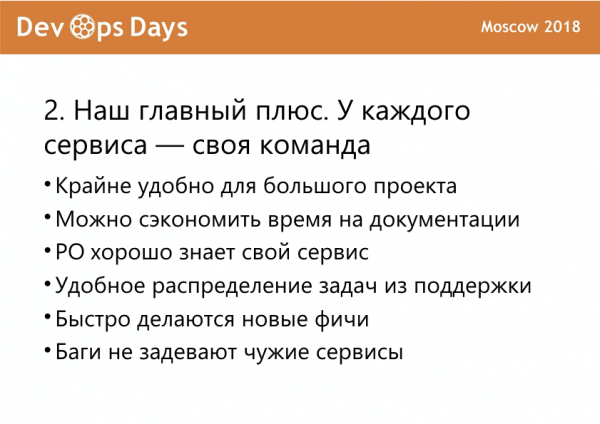
Nuestra principal ventaja, que se ha cristalizado a lo largo de los años, es que cada servicio tiene su propio equipo. Esto es conveniente para un gran proyecto, ya que se puede ahorrar tiempo en documentación, y los gestores conocen bien su proyecto.
Se pueden asignar tareas de soporte de manera efectiva. Por ejemplo, si se rompe el servicio de seguros, el equipo que se encarga de los seguros inmediatamente va a repararlo.
Se desarrollan nuevas funciones rápidamente, porque cuando tienes un servicio atómico, se le puede añadir algo de forma ágil.
Y cuando rompes tu propio servicio, lo cual es inevitable, no afectas a otros servicios, y no vienen desarrolladores de otros equipos con palos a decirte: «Ay-ay, no hagas eso».
Como siempre, hay matices. Tenemos equipos estables, los gestores están firmemente compenetrados con el equipo. Existen documentos claros, los gestores están muy pendientes de todo. Cada equipo tiene varios servicios y hay un punto concreto de competencia.
Si los equipos son fluidos (lo cual también es algo que usamos a veces), hay un buen método llamado «mapa estelar».
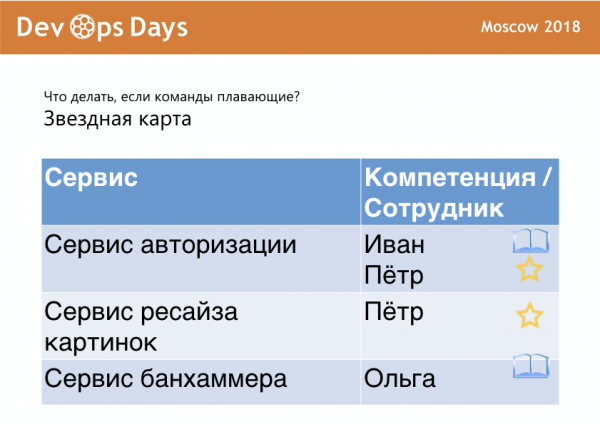
Tienes una lista de servicios y personas. Una estrella indica que la persona es experta en ese servicio, un libro indica que la persona está estudiando ese servicio. La tarea de la persona es cambiar el libro por una estrella. Y si no hay nada escrito frente al servicio, comienzan los problemas, de los cuales hablaré más adelante.
¿Cómo aparecen los servicios huérfanos?
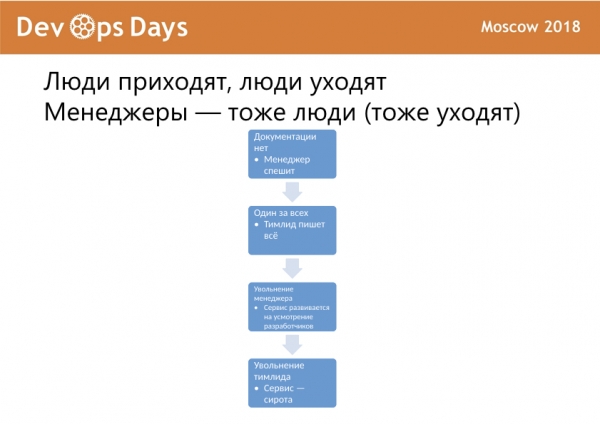
El primer problema, la primera forma de tener un servicio huérfano en tu infraestructura, es la despedida de personas. ¿Alguien ha experimentado alguna vez que llegan plazos del negocio antes de haber evaluado las tareas? A veces, los plazos son estrictos y simplemente no hay tiempo para la documentación. "Hay que entregar el servicio a producción, luego lo escribiremos".
Si el equipo es pequeño, puede que haya un solo desarrollador que escribe todo, mientras que los demás están para ayudar. "He escrito la arquitectura principal, tú encárgate de los interfaces". Luego, en algún momento, el gerente, por ejemplo, se va. Y durante ese periodo, cuando el gerente se ha ido y no se ha nombrado uno nuevo, los desarrolladores deciden por sí mismos hacia dónde va el servicio, qué está sucediendo. Y como sabemos (regresando unas diapositivas atrás), en algunos equipos hay personas 'copos de nieve', a veces un copo de nieve es el líder de equipo. Luego se va y tenemos un servicio huérfano.
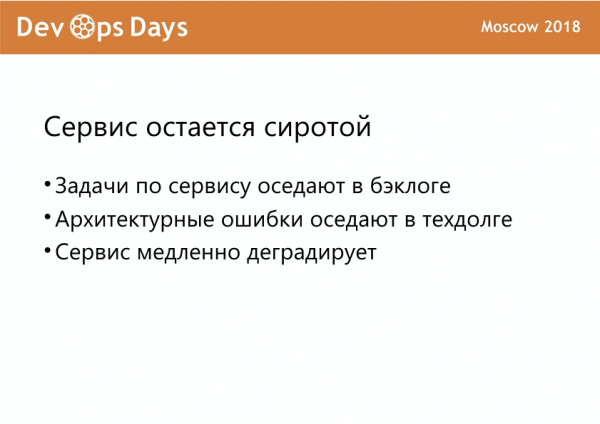
Sin embargo, las tareas del soporte y del negocio no desaparecen, se acumulan en el backlog. Si durante el desarrollo del servicio hubo errores arquitectónicos, también se acumulan en el backlog. El servicio se degrada lentamente.
¿Cómo identificar un huérfano?
Esta lista describe bien la situación. ¿Quién se ha identificado con algo en su infraestructura?
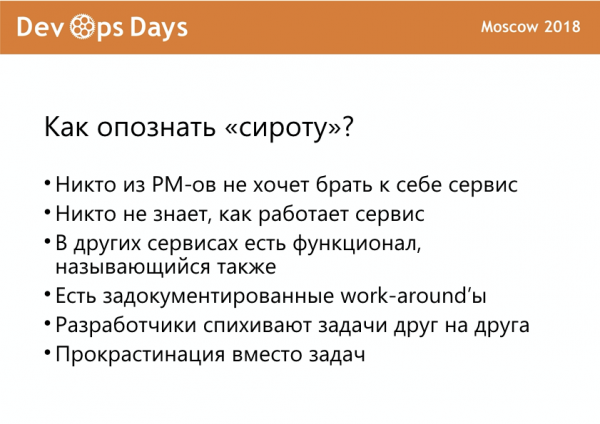
Sobre los workarounds documentados: hay un servicio que, en general, funciona, tiene un manual de dos páginas sobre cómo trabajar con él, pero nadie sabe cómo funciona internamente.
O, por ejemplo, hay un acortador de enlaces. En nuestro caso, actualmente estamos utilizando tres acortadores de enlaces para diferentes objetivos en diferentes servicios. Estas son las consecuencias.
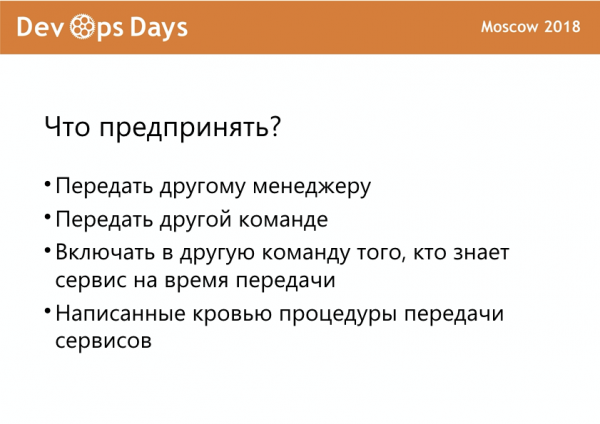
Ahora voy a ser el capitán obvio. ¿Qué se debe hacer? Primero, hay que transferir el servicio a otro gerente, a otro equipo. Si tu líder de equipo aún no se ha ido, en este otro equipo, cuando entiendes que el servicio se asemeja a un huérfano, debes incluir a alguien que entienda algo sobre él.
Lo más importante: deben tener procedimientos de transferencia escritos a conciencia. En nuestro caso, generalmente soy yo quien se encarga de esto, porque necesito que todo funcione. A los gerentes les interesa que se entregue rápido, y lo que sucederá después ya no les importa tanto.
La siguiente forma de hacer una 'sorpresa' es: 'Lo haremos en outsourcing, así será más rápido y luego lo pasaremos al equipo'. Es obvio que todos tienen ciertos planes en el equipo, hay una fila. A menudo, el cliente de negocios piensa que en el proveedor externalizado harán las cosas igual que el departamento técnico de la empresa. Aunque sus motivaciones son diferentes. En el outsourcing a veces hay soluciones tecnológicas extrañas y soluciones algorítmicas inusuales.
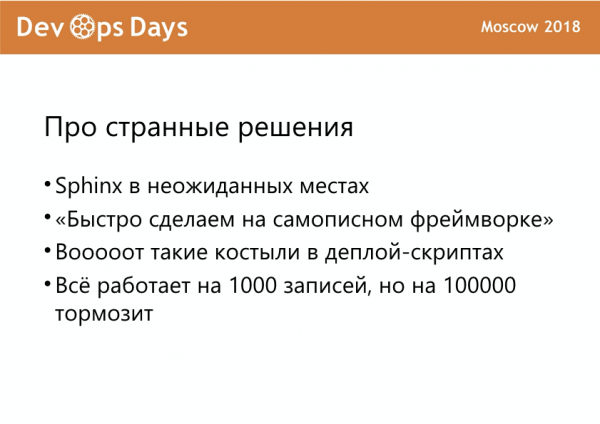
Por ejemplo, tuvimos un servicio en el que había Sphinx en diferentes lugares inesperados. Más adelante contaré qué tuvimos que hacer.
En el caso de los outsourcers puede haber frameworks hechos a medida. Es simplemente PHP puro con copias y pegados de un proyecto anterior, donde se puede encontrar de todo. Grandes trucos en los scripts de despliegue, cuando necesitas cambiar algunas líneas en algún archivo usando complejos scripts Bash, mientras que estos scripts de despliegue son llamados por algún tercer script. Al final, cambias el sistema de despliegue, eliges otra cosa y, de repente, tu servicio no funciona. Porque había que poner otras 8 enlaces entre diferentes carpetas. O a veces, mil registros funcionan, pero cien mil ya no.
Continuaré al mando. La aceptación del servicio del outsourcing es un procedimiento que es obligatorio. ¿A quién le ha pasado que un servicio del outsourcing llega y no es aceptado en ningún lado? No es tan común como el servicio huérfano, pero aún así.
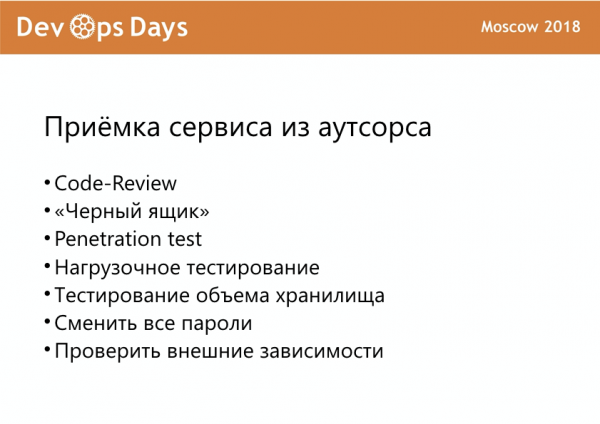
Es necesario revisar el servicio, es necesario hacer una revisión, y hay que cambiar las contraseñas. Tuvimos un caso en el que nos entregaron un servicio con un panel de administración que decía 'if login == ‘admin’ && password == ‘admin’…', escrito directamente en el código. Nos quedamos pensando, ¿y esto lo escriben personas en 2018?
Las pruebas del volumen de almacenamiento también son importantes. Hay que ver qué sucederá con cien mil registros, antes de lanzar este servicio a producción.
No debería dar vergüenza enviar el servicio para mejoras. Cuando dices: 'No aceptaremos este servicio, tenemos 20 tareas, háganlas, luego aceptaremos', está bien. La conciencia no debe doler porque pongas en apuros al gerente o porque el negocio gaste dinero. Después, el negocio gastará más.
Tuvimos un caso en el que decidimos hacer un proyecto piloto en outsourcing.
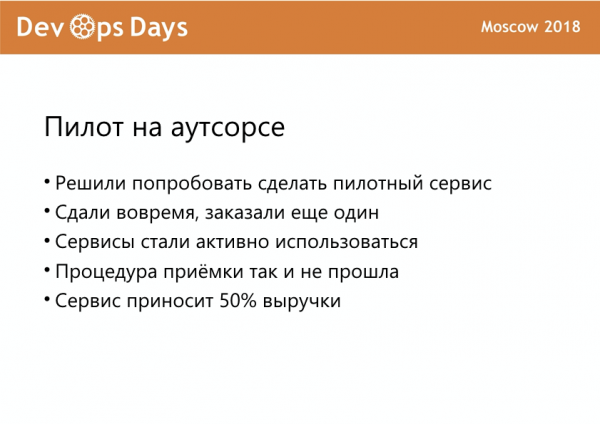
Se entregó a tiempo, y ese fue el único criterio de calidad. Por eso se hizo otro proyecto piloto, que ya ni siquiera era del todo piloto. Estos servicios fueron aceptados, dijeron administrativamente, aquí está su código, aquí está el equipo, aquí está su gerente. Los servicios ya empezaron a generar ganancias. Sin embargo, de hecho, siguen siendo huérfanos, nadie entiende cómo funcionan, y los gerentes se desentienden de sus tareas.
Hay otro concepto excelente: desarrollo guerrillero. Cuando algún departamento, generalmente el de marketing, quiere probar una hipótesis, y encarga el servicio completamente externamente. Comienza a recibir tráfico, cierran documentos, firman actas con el contratista, entran en operación y dicen: 'Chicos, aquí tenemos un servicio, ya tiene tráfico, nos genera dinero, vamos a aceptarlo'. Nosotros decimos: 'Vaya, ¿cómo es posible?'.
Y otra forma de obtener un servicio huérfano: cuando algún equipo se ve de repente sobrecargado, la dirección dice: 'Vamos a pasar este servicio de este equipo a otro equipo, que tenga menos carga'. Luego pasamos a un tercer equipo y cambiamos al gerente. Y al final, nuevamente tenemos un huérfano.
¿Cuál es el problema con los huérfanos?
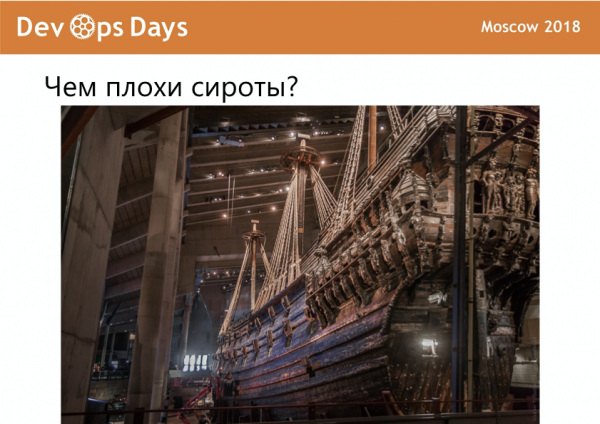
Quien no lo sepa, es el barco de línea Wasa, levantado en Suecia, famoso por haberse hundido cinco minutos después de ser botado al agua. Y el rey de Suecia, por cierto, no mandó ejecutar a nadie por esto. Fue construido por dos generaciones de ingenieros que no sabían construir tales barcos. Efecto inevitable.
El barco podría haberse hundido, por cierto, mucho peor, por ejemplo, cuando ya estuviera llevando al rey a algún lugar en una tormenta. Así fue, se hundió de inmediato, en términos ágiles esto es bueno: fallar temprano.
Si fallamos temprano, generalmente no hay problemas. Por ejemplo, durante la aceptación se envió para mejorar. Pero si fallamos ya en producción, cuando se han invertido dinero, podrían surgir problemas. Consecuencias, como se les llama en los negocios.
¿Cuáles son los peligros de los servicios huérfanos?
- El servicio puede romperse de repente.
- El servicio tarda mucho en repararse o no se repara en absoluto.
- Problemas de seguridad.
- Problemas con mejoras y actualizaciones.
- Si un servicio importante se rompe, la reputación de la empresa sufre.
¿Qué hacer con los servicios huérfanos?
Una vez más, repito lo que se debe hacer. En primer lugar, debe haber documentación. Siete años en Banki.ru me enseñaron que los testers no deben creer en la palabra de los desarrolladores, y la explotación no debe confiar en la palabra de nadie. Es necesario verificar.
En segundo lugar, hay que escribir esquemas de interacción, porque a veces los servicios que no son aceptados correctamente contienen dependencias que nadie mencionó. Por ejemplo, los desarrolladores han vinculado el servicio a su clave de algún Yandex.Maps o a Dadata. Si se acaba el límite gratuito, todo se rompe y no sabes qué ha pasado. Todas esas trampas deben ser descritas: se utiliza Dadata, Sms, entre otras.
En tercer lugar, trabajar con la deuda técnica. Cuando haces ciertos parches o acepta un servicio y dices que hay que hacer algo, debes asegurarte de que realmente se haga. Porque luego puede suceder que un pequeño bache no sea tan pequeño y termines cayendo en él.
Con respecto a las tareas de arquitectura, tuvimos una historia relacionada con Sphinx. En uno de los servicios, Sphinx se utilizaba para introducir listas. Simplemente una lista con paginación, pero al mismo tiempo se reindexaba cada noche. Estaba formado por dos índices: uno grande que se indexaba cada noche y otro pequeño que se adjuntaba a este. Cada día, con un 50% de probabilidad, al desplegar, el índice fallaba y las noticias dejaban de actualizarse en la página principal. Al principio, esto tomaba 5 minutos, mientras el índice se reindexaba, luego el índice creció y en algún momento comenzó a tardar 40 minutos en reindexarse. Cuando lo eliminamos, suspiramos aliviados, porque quedó claro que pasaría un poco de tiempo y nuestro índice estaría reindexándose durante toda la jornada laboral. Esto sería un fallo para nuestro portal, ocho horas sin noticias — eso significaría que el negocio se detendría.
Plan de trabajo con el servicio huérfano
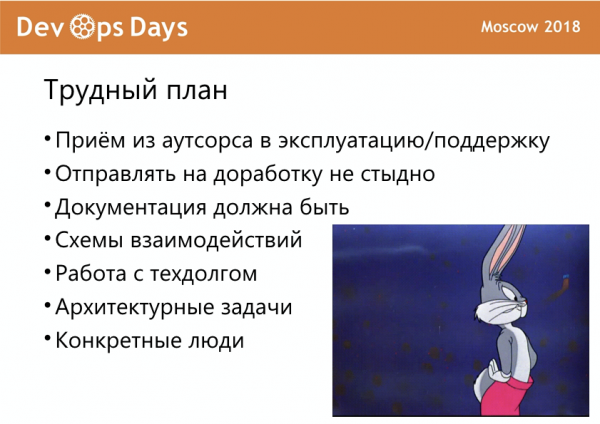
En realidad, es muy difícil hacerlo porque DevOps se trata de comunicación. Quieres tener buenas relaciones con tus colegas, pero cuando golpeas a tus colaboradores y gerentes con regulaciones, pueden sentir emociones contradictorias hacia quienes hacen esto.
Además de todos estos puntos, hay algo más importante: para cada servicio específico, cada parte del proceso de despliegue, deben haber personas específicas responsables. Cuando no hay personas y se necesitan involucrar a otros, estudiando todo esto, se vuelve complicado.
Si todo esto no ha ayudado y el servicio huérfano sigue siendo huérfano, nadie lo quiere, no se escribe la documentación, el equipo que fue convocado para este servicio se niega a hacer algo, hay una forma sencilla: rehacerlo todo.
Es decir, tomas los requisitos del servicio de nuevo y escribes un nuevo servicio, mejor, en una mejor plataforma, sin soluciones tecnológicas extrañas. Y migras a él en producción.
Tuvimos una situación en la que tomamos un servicio en Yii 1 y nos dimos cuenta de que no podíamos continuar desarrollándolo, porque se nos acabaron los desarrolladores que saben escribir bien en Yii 1. Todos los desarrolladores saben escribir bien en Symfony 3. ¿Qué hacer? Asignamos tiempo, asignamos un equipo, asignamos un gerente, reescribimos el proyecto y lentamente redirigimos el tráfico a él.
Después de esto, se puede eliminar el antiguo servicio. Este es mi procedimiento favorito, cuando en el sistema de gestión de configuraciones hay que eliminar algún servicio y luego revisar para asegurarse de que todas las instancias en producción estén apagadas, para que no queden rastros para los desarrolladores. El repositorio en git permanece.
Esto es todo lo que quería contar, estoy listo para discutir, es un tema polémico, muchos han navegado en él.
En las diapositivas se habló de que unificaron los lenguajes. Como ejemplo se mencionó el redimensionamiento de imágenes. ¿Es realmente necesario ser rígido con un solo lenguaje? Porque redimensionar imágenes en PHP, bueno, realmente se podría haber hecho también en Golang.
En realidad, esto no es obligatorio, como ocurre con todas las prácticas. En algunos casos puede incluso ser indeseable. Pero hay que entender que si en su empresa hay 50 personas en el departamento técnico, de las cuales 45 son programadores PHP, 3 son DevOps que manejan Python, Ansible, Puppet y cosas así, y solo uno de ellos escribe un servicio en Go para redimensionar imágenes, entonces cuando él se va, la experiencia se va con él. Y además, necesitarán buscar un desarrollador específico en el mercado que conozca ese lenguaje, especialmente si es raro. Desde un punto de vista organizativo, esto es problemático. Desde la perspectiva de DevOps, no solo necesitarán clonar un conjunto preparado de playbooks que usan para desplegar servicios, sino que tendrán que escribirlos desde cero.
Actualmente estamos desarrollando un servicio en Node.js, y este será un espacio separado para cada desarrollador con su propio lenguaje. Pero nos sentamos a pensar que vale la pena. Es decir, aquí la cuestión es sentarse y reflexionar.
¿Cómo monitorean sus servicios? ¿Cómo recolectan y rastrean los logs?
Recolectamos los logs en Elasticsearch y los almacenamos en Kibana, y dependiendo de si es un entorno de producción o de pruebas, se utilizan diferentes recopiladores. En algunos casos usamos Lumberjack, en otros algo más, ya no lo recuerdo. También hay algunos lugares en ciertos servicios donde instalamos Telegraf y lo enviamos a otro lugar por separado.
¿Cómo conviven Puppet y Ansible en un mismo entorno?
En realidad, ahora tenemos dos entornos, uno es Puppet, el otro Ansible. Estamos trabajando para hibridarlos. Ansible es un buen entorno para la configuración inicial, Puppet es algo malo para la configuración inicial porque requiere trabajo manual directamente en el entorno, y Puppet asegura la convergencia de la configuración. Esto significa que el entorno se mantiene a sí mismo actualizado, mientras que una máquina gestionada por Ansible necesita que se ejecuten playbooks con cierta periodicidad para mantenerse actualizada. Esa es la diferencia.
¿Cómo mantienen la compatibilidad? ¿Tienen configuraciones tanto en Ansible como en Puppet?
Este es nuestro gran dolor, mantenemos la compatibilidad a mano y pensamos en cómo podríamos pasar todo esto a otro lugar. Lo que conseguimos es que Puppet aplica paquetes y mantiene algunas referencias, mientras que Ansible, por ejemplo, aplica código y ajusta las configuraciones recientes de las aplicaciones.
En la presentación se habló de diferentes versiones de Ruby. ¿Cuál es la solución?
Nos encontramos con esto en un solo lugar y tenemos que mantenerlo en mente todo el tiempo. Simplemente desactivamos la parte que trabajaba con esa versión de Ruby que no era compatible con las aplicaciones y la mantuvimos separada.
Este año la conferencia se llevará a cabo el 7 de diciembre en 'Technopolis'. Aceptamos propuestas para conferencias hasta el 11 de noviembre. si desea dar una charla.
¡La inscripción para los participantes está abierta, únase!
Fuente: habr.com
