

Propósito del sistema
Soporte para el acceso remoto a archivos en computadoras dentro de una red. El sistema «virtual» apoya todas las operaciones básicas de archivos (creación, eliminación, lectura, escritura, etc.) mediante el intercambio de transacciones (mensajes) a través del protocolo TCP.
Áreas de aplicación
La funcionalidad del sistema es efectiva en los siguientes casos:
- en aplicaciones nativas para dispositivos móviles y embebidos (smartphones, sistemas de control a bordo, etc.), que requieren acceso rápido a archivos en servidores remotos en condiciones de posibles interrupciones temporales en la conexión (al salir de línea);
- en bases de datos altamente cargadas, si el procesamiento de las solicitudes se realiza en servidores distintos a los que almacenan los datos;
- en redes corporativas distribuidas para la recolección y procesamiento de información, que requieren alta velocidad en el intercambio de datos, redundancia y confiabilidad;
- en sistemas complejos con arquitectura de microservicios, donde los retrasos en el intercambio de información entre módulos son de vital importancia.
Estructura
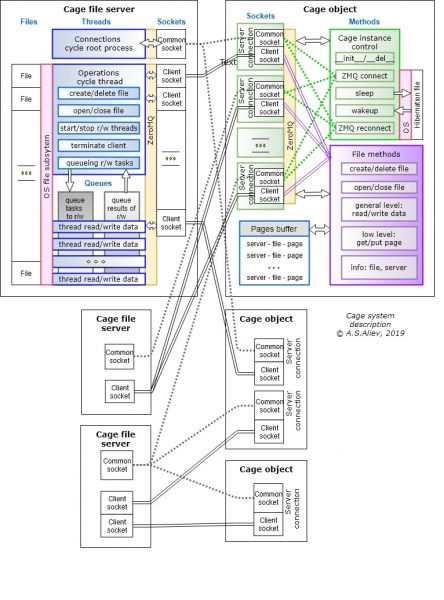
El sistema Cage (hay una implementación — versión beta en Python 3.7 en Windows) incluye dos partes principales:
- Cageserver — un programa servidor de archivos (paquete de funciones), que se ejecuta en computadoras dentro de la red, a los archivos a los cuales se necesita acceso remoto;
- clase Cage con una biblioteca de métodos para el software cliente, que simplifica la codificación de la interacción con los servidores.
Uso del sistema en el lado de los clientes
Los métodos de la clase Cage reemplazan las operaciones «rutinarias» normales del sistema de archivos: creación, apertura, cierre, eliminación de archivos, así como lectura/escritura de datos en formato binario (especificando la posición y el tamaño de los datos). Conceptualmente, estos métodos se asemejan a las funciones de archivos del lenguaje C, donde la apertura/cierre de archivos se realiza «por canales» de entrada-salida.
En otras palabras, el programador no trabaja con los métodos de objetos «de archivo» (de la clase _io en Python), sino con los métodos de la clase Cage.
Al crear una instancia del objeto Cage, se establece una conexión inicial con el servidor (o varios servidores), se pasa la autorización mediante el Id del cliente y se recibe una confirmación con el número de puerto asignado para realizar todas las operaciones de archivo. Al eliminar el objeto Cage, se envía al servidor un comando para finalizar la conexión y cerrar los archivos. La finalización de la conexión también puede ser iniciada por los propios servidores.
El sistema mejora el rendimiento de lectura/escritura mediante el almacenamiento en caché de fragmentos de archivos utilizados con frecuencia por los programas cliente en la memoria RAM.
El software cliente puede utilizar cualquier número de objetos Cage con diversas configuraciones (tamaño de caché, tamaño de bloques al intercambiar datos con el servidor, etc.).
Un objeto Cage puede intercambiar datos con múltiples archivos en varios servidores. Los parámetros de conexión (dirección IP o DNS del servidor, puerto principal para autenticación, ruta y nombre del archivo) se establecen al crear el objeto.
Dado que cada objeto Cage puede trabajar simultáneamente con múltiples archivos, se utiliza un espacio de memoria compartido para la caché. El tamaño de la caché, que es la cantidad de páginas y su tamaño, se determina dinámicamente al crear el objeto Cage. Por ejemplo, una caché de 1 GB son 1000 páginas de 1 MB, o 10,000 páginas de 100 KB, o 1 millón de páginas de 1 KB. La elección del tamaño y la cantidad de páginas es una tarea específica para cada caso de uso.
Se pueden utilizar múltiples objetos Cage simultáneamente para establecer diferentes configuraciones de caché según las características de acceso a la información en distintos archivos. Como base, se aplica el algoritmo de almacenamiento en caché más simple: después de agotar el volumen de memoria establecido, las nuevas páginas desplazan a las antiguas según el principio de expulsión con el mínimo de accesos. El almacenamiento en caché es especialmente efectivo en caso de acceso conjunto no uniforme (en el sentido estadístico), tanto a diferentes archivos como a fragmentos de cada archivo.
La clase Cage admite entrada/salida no solo por direcciones de datos (especificando la posición y longitud del arreglo, «sustituyendo» las operaciones del sistema de archivos), sino también a un nivel más bajo, «físico», por los números de página en la memoria caché.
Para los objetos Cage se admite la función original «hibernación» («sueño») – se pueden «reducir» (por ejemplo, en caso de una desconexión con los servidores, o al detener la aplicación, etc.) a un archivo de volcado local en el lado del cliente y recuperarlo rápidamente desde ese archivo (después de restablecer la conexión, al reiniciar la aplicación). Esto permite una reducción significativa del tráfico al activar el trabajo del programa cliente después de una desconexión temporal «offline», ya que los fragmentos de archivos utilizados frecuentemente ya estarán en caché.
Cage es aproximadamente 3600 líneas de código.
Principios de construcción de servidores
Los servidores de archivos Cageserver se pueden ejecutar con un número arbitrario de puertos, uno de los cuales («principal») se utiliza únicamente para la autorización de todos los clientes, mientras que los demás son para el intercambio de datos. La única necesidad para el programa del servidor Cage es Python. Paralelamente, la computadora con el servidor de archivos puede realizar cualquier otro trabajo.
El servidor se inicia inicialmente como una combinación de dos procesos principales:
- «Conexiones» – proceso para llevar a cabo operaciones de establecimiento de conexión con los clientes y su terminación a iniciativa del servidor;
- «Operaciones» – proceso para ejecutar tareas (operaciones) de los clientes relacionadas con archivos, así como para cerrar sesiones de conexión por órdenes de los clientes.
Ambos procesos no están sincronizados y están organizados como ciclos infinitos de recepción y envío de mensajes basados en colas multiprocesadas, objetos proxy, bloqueos y sockets.
El proceso «Conexiones» asigna a cada cliente un puerto para la transmisión de datos. El número de puertos se establece al iniciar el servidor. La correspondencia entre puertos y clientes se almacena en memoria proxy compartida entre procesos.
El proceso «Operaciones» mantiene la separación de recursos de archivos, permitiendo que varios clientes diferentes puedan leer datos de un único archivo de forma conjunta (cuasi-paralela, ya que el acceso es gestionado por bloqueos) si esto fue permitido en su apertura inicial por el «primer» cliente.
El procesamiento de comandos para crear/eliminar/abrir/cerrar archivos en servidor se lleva a cabo en el propio proceso «Operaciones» de manera estrictamente secuencial utilizando el subsistema de archivos del OS del servidor.
Para acelerar en general las operaciones de lectura/escritura, estas se llevan a cabo en hilos (threads) generados por el proceso "Operaciones". El número de hilos suele ser igual al número de archivos abiertos. Las tareas de lectura/escritura de los clientes se envían a una cola común, y el primer hilo libre toma la tarea del frente de la cola. Una lógica especial permite excluir las operaciones de sobreescritura de datos en la memoria RAM del servidor.
El proceso "Operaciones" supervisa la actividad de los clientes y detiene su atención tanto por sus comandos como al exceder el tiempo de espera por inactividad.
Para garantizar la fiabilidad, Cageserver mantiene registros de todas las transacciones. Un registro común contiene copias de los mensajes de los clientes con tareas para crear/abrir/renombrar/eliminar archivos. Para cada archivo de trabajo se crea un registro separado, en el que se escriben copias de mensajes con tareas de lectura y escritura de datos en ese archivo de trabajo, así como matrices de datos escritos (nuevos) y matrices de datos que se destruyeron al sobrescribir (escribir nuevos datos "encima" de los antiguos).
Estos registros permiten tanto recuperar nuevos cambios en las copias de seguridad como revertir el contenido actual a un momento deseado en el pasado.
Cageserver tiene aproximadamente 3100 líneas de código.
Inicio del programa del servidor de archivos Cageserver
Al iniciar, se debe definir en el diálogo:
— el puerto principal para la autorización;
— el número de puertos para el intercambio de transacciones con clientes autorizados (de 1 en adelante, el grupo de números comienza con el siguiente al número del puerto principal).
Uso de la clase Cage
class cage.Cage( cage_name=»», pagesize=0, numpages=0, maxstrlen=0, server_ip={}, wait=0, awake=False, cache_file=»» )
De esta clase se crean objetos que realizan la interacción con los servidores de archivos y contienen memoria caché.
Parámetros
- cage_name(str) — nombre condicional del objeto que se utiliza para la identificación de clientes en el lado del servidor
- pagesize(int) — tamaño de una página de memoria caché (en bytes)
- numpages(int) — número de páginas de memoria caché
- maxstrlen(int) — longitud máxima de la cadena en bytes en las operaciones de lectura y escritura
- server_ip(dict) — diccionario con las direcciones utilizadas servidores, donde la clave es el nombre condicional del servidor (ID del servidor dentro de la aplicación), y el valor es una cadena con la dirección: “ip address:port” o “DNS:port” (la correspondencia entre nombres y direcciones reales es temporal y se puede cambiar)
- esperar(int) — tiempo de espera para obtener la respuesta del servidor al recibir los puertos (en seg.)
- despertar(boolean) — indicador del método de creación del objeto (False — si se crea un nuevo objeto, Verdadero — si el objeto se crea a partir de uno previamente “suspendido” — usando la operación de “hibernación”, por defecto Falso)
- archivo_cache(str) — nombre del archivo para hibernación
Los métodos
Cage.crear_archivo( servidor, ruta ) – crear un nuevo archivo
Cage.renombrar_archivo( servidor, ruta, nuevo_nombre ) – renombrar el archivo
Cage.eliminar_archivo( servidor, ruta) – eliminar el archivo
Cage.open( servidor, ruta, mod ) – abrir el archivo
Devuelve fchannel número de canal. El parámetro mod — es el modo de apertura del archivo: «wm» — monopolio (lectura/escritura), «rs» — solo lectura, y compartido solo para lectura por otros clientes, «ws» — lectura/escritura, y compartido solo para lectura por otros clientes.
Cage.close (fchannel) – cerrar el archivo
Cage.write (fchannel, inicio, datos ) – escribir una cadena de bytes en el archivo
Cage.read (fchannel, inicio, len_data ) – leer una cadena de bytes del archivo
Cage.enviar_paginas ( fchannel ) – “empuja” del búfer al servidor todas las páginas del canal especificado que han sido modificadas. Se utiliza en aquellos puntos del algoritmo donde se debe asegurar que todas las operaciones en el canal se han guardado físicamente en el archivo en el servidor.
Cage.empujar_todas () – “empuja” del búfer al servidor todas las páginas de todos los canales para la instancia de la clase Cage que han sido modificadas. Se utiliza cuando se debe asegurar que todas las operaciones en todos los canales se guardan en el servidor.
Fuente: habr.com
