

TL;DR: Descripción de la arquitectura cliente-servidor de nuestro sistema interno de gestión de la configuración de la red, QControl. En su base se encuentra un protocolo de transporte de dos niveles, que trabaja con mensajes comprimidos en gzip sin descompresión entre los endpoints. Los enrutadores distribuidos y los endpoints reciben actualizaciones de configuración, y el protocolo permite la instalación de relais intermedios localizados. El sistema se construye con el principio de ('recent-stable', que se explica a continuación) y utiliza el lenguaje de consultas JMESpath junto con el motor de plantillas Jinja para renderizar archivos de configuración.
Qrator Labs gestiona una red globalmente distribuida de neutralización de ataques. Nuestra red opera bajo el principio de anycast, y las subredes se anuncian a través de BGP. Al ser una red BGP anycast, ubicada físicamente en varias regiones del mundo, podemos procesar y filtrar tráfico no legítimo más cerca del núcleo de internet — operadores Tier-1.
Por otro lado, ser una red geográficamente distribuida no es fácil. La comunicación entre los puntos de presencia de la red es crucial para un proveedor de servicios de seguridad, para tener una configuración coherente de todos los nodos de la red, actualizándolos de manera oportuna. Por lo tanto, para proporcionar el nivel más alto posible del servicio esencial al consumidor, necesitábamos encontrar una manera de sincronizar de manera confiable los datos de configuración entre continentes.
En el principio era la Palabra. Rápidamente se convirtió en un protocolo de comunicación que necesitaba una actualización.
La piedra angular de la existencia de QControl y al mismo tiempo la razón principal de la considerable inversión de tiempo y recursos en la construcción de este tipo de protocolo es la necesidad de obtener una fuente única y autorizada de configuración y, en última instancia, sincronizar nuestros puntos de presencia con ella. El propio almacenamiento fue solo uno de los varios requisitos durante el desarrollo de QControl. Además de esto, también necesitábamos integraciones con los servicios existentes y planificados en los puntos de presencia (TP), maneras inteligentes (y personalizables) de validar datos, así como la delimitación del acceso. Además, también queríamos gestionar dicho sistema mediante comandos, en lugar de realizar modificaciones en archivos. Antes de QControl, los datos se enviaban a los puntos de presencia prácticamente de forma manual. Si uno de los puntos de presencia no estaba disponible, y olvidábamos actualizarlo más tarde, la configuración se desincronizaba, lo que requería tiempo para restaurarla.
Como resultado, ideamos el siguiente esquema:
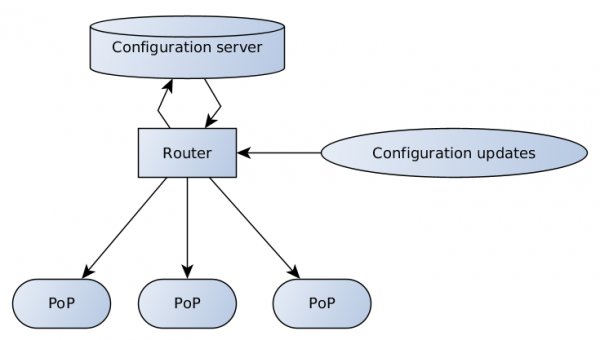
El servidor de configuración es responsable de la validación de datos y el almacenamiento, el enrutador tiene varios endpoints que reciben y transmiten las actualizaciones de configuración desde los clientes y el equipo de soporte al servidor, y del servidor a los puntos de presencia.
La calidad de la conexión a Internet todavía varía significativamente en diferentes rincones del planeta; para ilustrar este argumento, echemos un vistazo a un simple MTR desde Praga, República Checa, hacia Singapur y Hong Kong.
MTR desde Praga a Singapur
Lo mismo hacia Hong Kong
Las altas latencias significan menor velocidad. Además, hay pérdida de paquetes. El ancho de banda no compensa este problema, que siempre debe tenerse en cuenta al construir sistemas descentralizados.
La configuración completa de un punto de presencia es un volumen considerable de datos que debe ser enviado a muchos receptores a través de conexiones poco fiables. Afortunadamente, aunque la configuración cambia constantemente, esto ocurre en pequeñas porciones.
Diseño recent-stable
Se puede decir que construir una red distribuida basada en actualizaciones incrementales es una solución bastante obvia. Pero hay muchos problemas asociados con los diffs. Necesitamos mantener todos los diffs entre los puntos de referencia, y también ser capaces de enviarlos si alguien perdió parte de los datos. Cada punto de destino debe aplicarlos en un orden estricto. Normalmente, en el caso de varios puntos de destino, esta operación puede llevar un tiempo prolongado. El receptor también debe ser capaz de solicitar las partes que faltan y, por supuesto, la parte central debe responder a dicha solicitud de manera correcta, enviando solo los datos perdidos.
Al final, llegamos a una solución bastante interesante: solo tenemos una capa de referencia, fija, llamémosla stable, y solo un diff para ella: recent. Cada recent se basa en el último stable generado y es suficiente para reconstruir los datos de configuración. En cuanto un reciente nuevo llega a su destino, el viejo ya no es necesario.
Solo queda enviar de vez en cuando la configuración stable reciente, por ejemplo, porque el recent se ha vuelto demasiado grande. También es importante que enviamos todas estas actualizaciones en modo broadcast/multicast, sin preocuparnos por los receptores individuales y su capacidad para reunir fragmentos de datos. Tan pronto como nos aseguramos de que todos tienen el stable correcto, enviamos solo los nuevos recent. ¿Vale la pena aclarar que esto funciona? Funciona. El stable se almacena en caché en el servidor de configuración y en los receptores, y el recent se crea según sea necesario.
Arquitectura de transporte de dos niveles
¿Por qué construimos nuestro transporte en dos niveles? La respuesta es bastante simple: queríamos separar el enrutamiento de la lógica de alto nivel, inspirándonos en el modelo OSI con su nivel de transporte y nivel de aplicaciones. Para el protocolo de transporte elegimos Thrift, y para el formato de alto nivel de los mensajes de control, el formato de serialización msgpack. Es por eso que el router (que realiza multicast/broadcast/relay) no mira dentro de msgpack, no descomprime ni comprime el contenido de nuevo, y solo realiza el reenvío de los datos.
Thrift (del inglés "economía", se pronuncia como [θrift]) es un lenguaje de descripción de interfaces utilizado para definir y crear servicios en diferentes lenguajes de programación. Es un marco para la invocación remota de procedimientos (RPC). Combina un canal de programación con un motor de generación de código para el desarrollo de servicios que funcionan, de alguna manera, de manera efectiva y fácil entre diferentes lenguajes.
Elegimos el marco Thrift debido a RPC y el soporte para muchos lenguajes. Como suele ser el caso, los componentes más simples fueron el cliente y el servidor. Sin embargo, el enrutador resultó ser un duro desafío, en parte debido a la falta de una solución lista durante nuestro desarrollo.
 Existen otras opciones, como protobuf / gRPC, sin embargo, cuando comenzamos nuestro proyecto, gRPC era bastante nuevo y no nos atrevimos a incorporarlo.
Por supuesto, podríamos (y de hecho, deberíamos haberlo hecho) crear nuestra propia solución. Habría sido más fácil crear un protocolo para lo que necesitábamos, ya que la arquitectura cliente-servidor es relativamente directa de implementar en comparación con construir un enrutador en Thrift. De una forma u otra, hay una tendencia tradicional a desestimar los protocolos y las implementaciones caseras (y con razón), además, siempre surge la pregunta: "¿Cómo trasladaremos esto a otros lenguajes?". Por lo tanto, descartamos de inmediato la idea de la solución propia.
Msgpack es análogo a JSON, pero más rápido y más pequeño. Es un formato binario de serialización de datos que permite el intercambio de datos entre muchos lenguajes.
En el primer nivel tenemos Thrift con la mínima información necesaria para que el enrutador envíe el mensaje. En el segundo nivel están las estructuras empaquetadas en msgpack.
Elegimos msgpack porque es más rápido y compacto en comparación con JSON. Pero lo que es aún más importante, admite tipos de datos personalizados, lo que nos permite utilizar funciones interesantes como la transmisión de binarios en bruto o objetos especiales que representan la ausencia de datos, lo cual era importante para nuestro esquema de "recent-stable".
JMESPath
JMESPath es un lenguaje de consultas para JSON.
Así es como se ve la descripción que obtenemos de la documentación oficial de JMESPath, pero en realidad, ofrece mucho más. JMESPath permite buscar y filtrar subárboles en estructuras de árbol arbitrarias, así como aplicar cambios a los datos en tiempo real. También permite agregar filtros especiales y procedimientos de transformación de datos. Aunque, por supuesto, requiere un esfuerzo mental para entenderlo.
Jinja
Para algunos consumidores, necesitamos convertir la configuración en un archivo, por lo que utilizamos un motor de plantillas y Jinja es la opción obvia. Con él generamos el archivo de configuración a partir de la plantilla y los datos obtenidos en el destino.
Para generar el archivo de configuración necesitamos una consulta JMESPath, una plantilla para la ubicación del archivo en el sistema de archivos, y una plantilla para el propio archivo de configuración. También en esta etapa es conveniente establecer los permisos de acceso al archivo. Todo esto se ha logrado combinar satisfactoriamente en un solo archivo: antes de comenzar la plantilla de configuración, añadimos un encabezado en formato YAML que describe lo demás.
Por ejemplo:
---
 selector: "[@][?@.fft._meta.version == `42`] | items([0].fft_config || `{}`)"
 destination_filename: "fft/{{ match[0] }}.json"
 file_mode: 0644
 reload_daemons: [fft]
 ...
 {{ dict(match[1]) | json(indent=2, sort_keys=True) }}
Para crear un archivo de configuración para un nuevo servicio, solo necesitamos añadir un nuevo archivo de plantilla. No se requieren cambios en el código fuente o en el software en los puntos de presencia.
¿Qué ha cambiado desde que se introdujo QControl en las operaciones? Lo primero y más importante es la entrega coherente y confiable de actualizaciones de configuración a todos los nodos de la red. Lo segundo es contar con una potente herramienta para verificar la configuración y realizar cambios en ella por parte de nuestro equipo de soporte, así como por los consumidores del servicio.
Todo esto se ha logrado utilizando el esquema de actualizaciones recent-stable para simplificar la comunicación entre el servidor de configuración y los receptores de configuración. Utilizando un protocolo de dos niveles para soportar un método de enrutamiento de datos independiente del contenido. Integrando con éxito un motor de generación de configuraciones basado en Jinja en una red distribuida de filtrado. Este sistema soporta una amplia gama de métodos de configuración para nuestra periferia distribuida y variada.
Gracias por la ayuda en la redacción del material. , , .
del post.
Fuente: habr.com
