

Este artículo es el segundo sobre el tema de la compresión rápida de datos. En el primer artículo, se describió un compresor que opera a una velocidad de 10 GB/s por núcleo de procesador (compresión mínima, RTT-Min).
Este compresor ya ha sido implementado en equipos de duplicadores forenses para la compresión rápida de volúmenes de información y para mejorar la resistencia de la criptografía. También puede aplicarse a la compresión de imágenes de máquinas virtuales y archivos de intercambio de memoria al almacenarlos en unidades SSD de alto rendimiento.
En el primer artículo también se anunció el desarrollo de un algoritmo de compresión para comprimir copias de seguridad de discos HDD y SSD (compresión media, RTT-Mid) con parámetros de compresión de datos sustancialmente mejorados. A día de hoy, este compresor está completamente listo y este artículo es precisamente sobre él.
El compresor que implementa el algoritmo RTT-Mid proporciona un grado de compresión comparable con los archivadores estándar como WinRar y 7-Zip, que funcionan en modo rápido. A su vez, su velocidad de operación es al menos un orden de magnitud superior.
La velocidad de empaquetado/desempaquetado de datos es un parámetro crítico que determina el ámbito de aplicación de las tecnologías de compresión. Es poco probable que a alguien se le ocurra comprimir un terabyte de datos a una velocidad de 10-15 MB por segundo (exactamente esa es la velocidad de los archivadores en modo de compresión estándar), ya que eso tomaría casi veinte horas con la CPU completamente cargada.
Por otro lado, el mismo terabyte se puede copiar a velocidades de alrededor de 2-3 GB por segundo en unos diez minutos.
Por lo tanto, la compresión de información de gran volumen es relevante si se realiza a una velocidad no inferior a la velocidad de entrada/salida real. Para los sistemas modernos, esto es al menos 100 MB por segundo.
Tales velocidades solo pueden ser alcanzadas por los compresores modernos en modo 'rápido'. Es en este modo actual que compararemos el algoritmo RTT-Mid con compresores tradicionales.
Pruebas comparativas del nuevo algoritmo de compresión
El compresor RTT-Mid funcionó como parte de un programa de prueba. En una aplicación real, trabaja significativamente más rápido, ya que utiliza adecuadamente el multihilo y aplica un compilador 'normal', no C#.
Dado que los compresores utilizados en la prueba comparativa se basan en diferentes principios y diferentes tipos de datos se comprimen de manera distinta, para objetividad de la prueba se utilizó el método de medición de 'la temperatura media del hospital'...
Se creó un archivo de volcado sectorial del disco lógico con el sistema operativo Windows 10, esta es la mezcla más natural de diversas estructuras de datos que realmente se encuentra en cada computadora. La compresión de este archivo permitirá realizar una comparación de la velocidad y el grado de compresión del nuevo algoritmo con los compresores más avanzados utilizados en los archivadores modernos.
Aquí está este archivo de volcado:
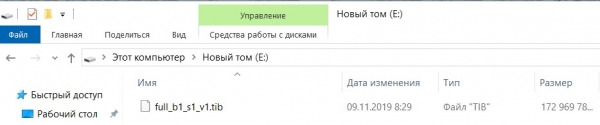
El archivo de volcado fue comprimido por los compresores RTT-Mid, 7-zip, WinRar. Los compresores WinRar y 7-zip fueron configurados para la máxima velocidad de operación.
El compresor está funcionando 7-zip:
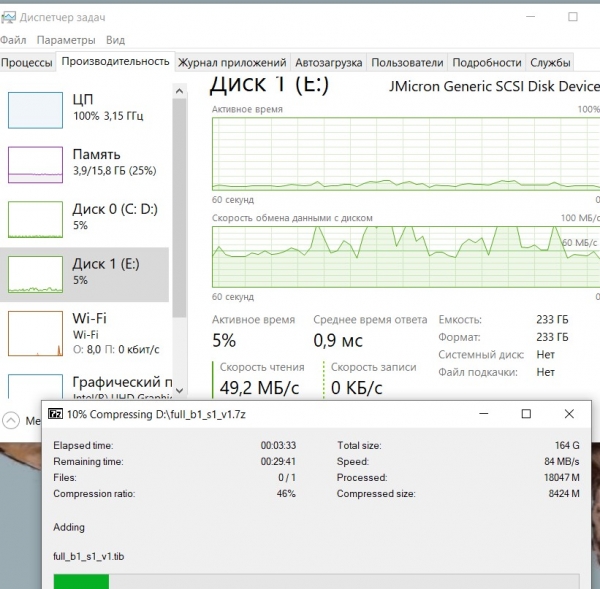
Está cargando el procesador al 100%, mientras que la velocidad media de lectura del volcado original es de alrededor de 60 Megabytes/segundo.
El compresor está funcionando WinRar:
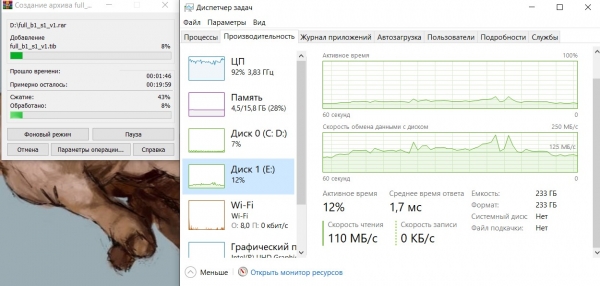
La situación es similar, la carga del procesador es prácticamente del 100%, la velocidad media de lectura del volcado es de alrededor de 125 Megabytes/segundo.
Al igual que en el caso anterior, la velocidad de operación del archivador está limitada por las capacidades del procesador.
Ahora está funcionando el programa de prueba del compresor RTT-Mid:
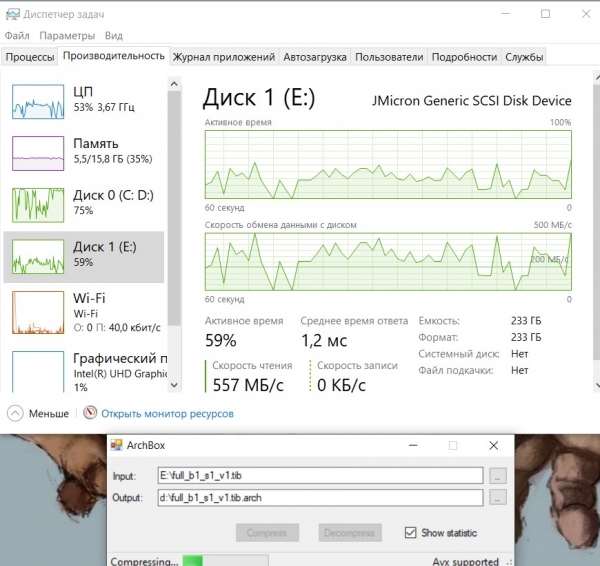
La captura de pantalla muestra que el procesador está cargado al 50% y se encuentra inactivo el resto del tiempo, porque no hay lugar para descargar los datos comprimidos. El disco de descarga de datos (Disco 0) está prácticamente completamente cargado. La velocidad de lectura de datos (Disco 1) fluctúa considerablemente, pero en promedio supera los 200 Megabytes/segundo.
La velocidad de operación del compresor está limitada en este caso por la posibilidad de escribir los datos comprimidos en el Disco 0.
Ahora el grado de compresión de los archivos resultantes:
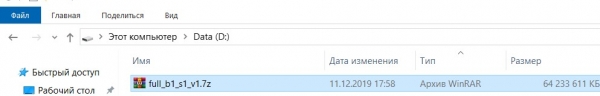
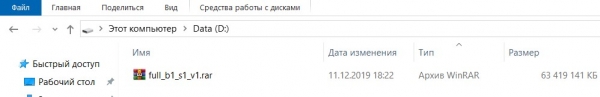
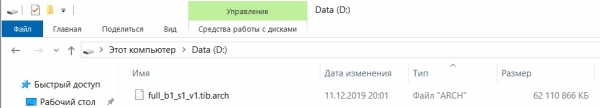
Se observa que el compresor RTT-Mid se desempeñó mejor en la compresión, el archivo creado por él es 1.3 Gigabytes más pequeño que el archivo de WinRar y 2.1 Gigabytes más pequeño que el archivo de 7z.
Tiempo gastado en crear el archivo:
- 7-zip – 26 minutos 10 segundos;
- WinRar – 17 minutos 40 segundos;
- RTT-Mid – 7 minutos 30 segundos.
Así, incluso un programa de prueba no optimizado, utilizando el algoritmo RTT-Mid, pudo crear un archivo más de dos veces y media más rápido, y además el archivo resultó ser significativamente más pequeño que el de la competencia...
Aquellos que no creen en las capturas de pantalla pueden verificar su validez por sí mismos. El programa de prueba está disponible en , descárgalo y compruébalo.
Pero solo en procesadores que soportan AVX-2, sin soporte para estas instrucciones el compresor no funciona, y no pruebe el algoritmo en procesadores AMD antiguos, son lentos en la ejecución de comandos AVX...
Método de compresión utilizado
El algoritmo utiliza un método de indexación de fragmentos de texto repetidos en granularidad de bytes. Este método de compresión es conocido desde hace tiempo, pero no se había utilizado, ya que la operación de búsqueda de coincidencias era muy costosa en recursos y requería mucho más tiempo que la construcción de un diccionario. Por lo tanto, el algoritmo RTT-Mid es un clásico ejemplo del movimiento 'hacia atrás en el futuro'...
El compresor RTT utiliza un escáner de búsqueda de coincidencias único y rápido, que ha permitido acelerar el proceso de compresión. El escáner es de fabricación propia, es 'mi tesoro...', 'costoso, ya que es completamente hecho a mano' (escrito en ensamblador).
El escáner de búsqueda de coincidencias está diseñado según un esquema probabilístico de dos niveles, primero se escanea la presencia de un 'signo' de coincidencia, y solo después de identificar el 'signo' en ese lugar se inicia el procedimiento de detección de la coincidencia real.
La ventana de búsqueda de coincidencias tiene un tamaño impredecible, que depende del grado de entropía en el bloque de datos procesado. Para datos completamente aleatorios (no comprimibles) tiene un tamaño de megabytes, mientras que para datos que contienen repeticiones siempre tiene un tamaño mayor a un megabyte.
Pero muchos formatos de datos modernos son no comprimibles y 'hacer trabajar' un escáner que consume muchos recursos es inútil y desperdiciado, por lo tanto, el escáner utiliza dos modos de operación. Primero se buscan secciones del texto original con posibles repeticiones, esta operación también se lleva a cabo por un método probabilístico y se ejecuta muy rápido (a una velocidad de 4-6 gigabytes/segundo). Luego, las secciones con posibles coincidencias son procesadas por el escáner principal.
La compresión indexada no es muy eficiente, se tiene que reemplazar los fragmentos repetidos por índices, y el array de índices reduce significativamente el coeficiente de compresión.
Para aumentar el grado de compresión, se indexan no solo las coincidencias completas de cadenas de bytes, sino también las parciales, cuando en la cadena hay bytes coincidentes y no coincidentes. Para ello, se ha incluido en el formato del índice un campo de máscara de coincidencias que indica los bytes coincidentes de dos bloques. Para una compresión aún mayor, se utiliza la indexación superpuesta de varios bloques parcialmente coincidentes sobre el bloque actual.
Todo esto ha permitido que el compresor RTT-Mid alcance un grado de compresión comparable a los compresores que utilizan métodos de diccionario, pero funcionando a una velocidad mucho mayor.
La velocidad de trabajo del nuevo algoritmo de compresión
Si el compresor trabaja con uso exclusivo de la caché de memoria (se requieren 4 Megabytes por hilo), la velocidad oscila entre 700 y 2000 Megabytes/seg. por núcleo de procesador, dependiendo del tipo de datos comprimidos y depende poco de la frecuencia de trabajo del procesador.
En una implementación multihilo del compresor, la escalabilidad efectiva se determina por el volumen de la caché de nivel tres. Por ejemplo, con 9 Megabytes de caché, no tiene sentido iniciar más de dos hilos de compresión, ya que la velocidad no aumentará. Pero con 20 Megabytes de caché, ya se pueden iniciar cinco hilos de compresión.
Un parámetro importante que también determina la velocidad de trabajo del compresor es la latencia de la memoria RAM. El algoritmo utiliza accesos aleatorios a la RAM, parte de los cuales no entran en la caché (alrededor del 10%) y se ve obligado a esperar datos de la RAM, lo que reduce la velocidad de trabajo.
La velocidad del compresor también se ve significativamente afectada por el funcionamiento del sistema de entrada/salida de datos. Las solicitudes a la RAM desde la entrada/salida bloquean los accesos a los datos por parte de la CPU, lo que también reduce la velocidad de compresión. Este problema es notable para laptops y desktops, para servidores es menos significativo gracias a un bloque de control de acceso más avanzado al bus del sistema y a la memoria RAM multicanal.
En todo el texto del artículo se habla de compresión, dejando la descompresión fuera del alcance de este artículo, ya que allí "todo está bien". La descompresión se lleva a cabo significativamente más rápida y está limitada por la velocidad de entrada/salida. Un núcleo físico en un solo hilo puede fácilmente proporcionar velocidades de descompresión de 3-4 gigabytes/segundo.
Esto se debe a la ausencia de la operación de búsqueda de coincidencias en el proceso de descompresión, que "consume" los recursos principales del procesador y de la memoria caché durante la compresión.
Confiabilidad del almacenamiento de datos comprimidos
Como sugiere el nombre de toda la clase de herramientas de software que utilizan compresión de datos (archivadores), están destinadas al almacenamiento prolongado de información, no por años, sino por siglos y milenios...
Con el tiempo, los medios de información pierden parte de los datos, aquí hay un ejemplo:
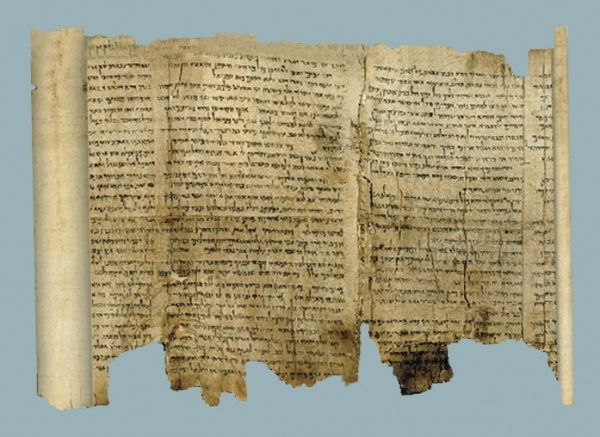
Este soporte de información "analógico" tiene mil años, algunos fragmentos se han perdido, pero en general la información es "legible"...
Ninguno de los fabricantes responsables de los sistemas modernos de almacenamiento de datos digitales y de los medios digitales asociados ofrece garantías de integridad de los datos por más de 75 años.
Y este es un problema, pero un problema diferido, resolverán esto nuestros descendientes...
Los sistemas de almacenamiento de datos digitales pueden perder datos no solo después de 75 años; los errores en los datos pueden aparecer en cualquier momento, incluso durante su escritura. Estos errores intentan minimizarse mediante redundancia y corrigiéndose con sistemas de corrección de errores. La redundancia y los sistemas de corrección pueden recuperar información perdida, aunque no siempre, y si lo hacen, no hay garantías de que la operación de recuperación se haya realizado correctamente.
Y este también es un gran problema, pero no diferido, sino actual.
Los compresores modernos utilizados para archivar datos digitales están construidos sobre varias modificaciones del método de diccionario y para tales archivos, la pérdida de un fragmento de información sería un evento fatal; incluso existe un término comúnmente aceptado para tal situación: "archivo dañado"...
La baja confiabilidad del almacenamiento de información en archivos con compresión de diccionario se relaciona con la estructura de los datos comprimidos. La información en dicho archivo no contiene el texto original, sino que almacena números de registro en el diccionario, el cual se modifica dinámicamente con el texto que se está comprimiendo. Ante la pérdida o distorsión de un fragmento del archivo, no es posible identificar todos los registros subsiguientes ni por su contenido ni por la longitud del registro en el diccionario, ya que no se sabe a qué corresponde el número del registro del diccionario.
Es imposible recuperar información de un archivo "dañado" como este.
El algoritmo RTT se basa en un método más confiable para el almacenamiento de datos comprimidos. Utiliza un método de índice para registrar fragmentos repetidos. Este enfoque de compresión permite minimizar las consecuencias de distorsiones en la información almacenada y, en muchos casos, corregir automáticamente las distorsiones que ocurren al almacenar información.
Esto se debe a que el archivo comprimido, en el caso de la compresión por índice, contiene dos campos:
- un campo con el texto original del cual se han eliminado las secciones repetidas;
- un campo de índices.
El campo de índices, que es crítico para la recuperación de información, no es grande y puede ser duplicado para mayor seguridad en el almacenamiento de datos. Por lo tanto, incluso si se pierde un fragmento del texto original o del arreglo de índices, toda la información restante se puede recuperar sin problemas, como en la imagen con un medio de información "analógico".
Desventajas del algoritmo
No hay ventajas sin desventajas. El método de compresión por índice no comprime secuencias repetidas pequeñas. Esto se debe a las limitaciones del método de índice. Los índices tienen un tamaño mínimo de 3 bytes y pueden ser de hasta 12 bytes. Si aparece una repetición de menor tamaño que el índice que la describe, no se toma en cuenta, sin importar cuán frecuentes sean esas repeticiones en el archivo comprimido.
El método de compresión tradicional y basado en diccionario comprime eficazmente múltiples repeticiones de corta longitud y, por lo tanto, alcanza un mayor coeficiente de compresión que la compresión indexada. Sin embargo, esto se logra a costa de una alta carga en la CPU, ya que para que el método de diccionario comience a comprimir los datos de manera más eficiente que el método indexado, debe reducir la velocidad de procesamiento de datos a 10-20 megabytes por segundo en instalaciones computacionales reales con la CPU completamente cargada.
Estas bajas velocidades son inaceptables para los sistemas de almacenamiento de datos modernos y representan más un interés 'académico' que práctico.
El grado de compresión de la información se incrementará significativamente en la próxima modificación del algoritmo RTT (RTT-Max), que ya está en desarrollo.
Así que, como siempre, esto continuará…
Fuente: habr.com
