

Hola a todos. Amigos, compartimos con ustedes la traducción de un artículo, preparado especialmente para los estudiantes del curso . ¡Vamos!
Apache Beam y DataFlow para tuberías de tiempo real
La publicación de hoy se basa en una tarea en la que estuve trabajando recientemente. Me emocioné mucho al llevarla a cabo y describir el trabajo realizado en forma de entrada de blog, ya que me dio la oportunidad de practicar ingeniería de datos y hacer algo que sería muy útil para mi equipo. No hace mucho, descubrí que teníamos un registro de usuarios bastante grande en nuestros sistemas, relacionado con uno de nuestros productos de manipulación de datos. Resultó que nadie estaba utilizando esos datos, así que inmediatamente me interesé en lo que podríamos aprender si comenzáramos a analizarlos regularmente. Sin embargo, había algunos problemas en el camino. El primer problema era que los datos estaban almacenados en muchos archivos de texto diferentes, que no estaban disponibles para un análisis instantáneo. El segundo problema era que estaban guardados en un sistema cerrado, por lo que no podría usar ninguna de mis herramientas favoritas para el análisis de datos.
Tenía que decidir cómo facilitar el acceso para nosotros y aportar algún valor al integrar esta fuente de datos en algunas de nuestras soluciones de interacción con los usuarios. Tras pensar un tiempo, decidí construir un pipeline para transferir estos datos a una base de datos en la nube, para que mi equipo y yo pudiéramos acceder a ellos y empezar a generar algunas conclusiones. Después de completar mi especialización en Ingeniería de Datos en Coursera hace un tiempo, estaba ansioso por usar algunas herramientas del curso en el proyecto.
Así que colocar los datos en una base de datos en la nube parecía una forma sensata de resolver mi primer problema, pero ¿qué podía hacer con el problema número 2? Afortunadamente, había una forma de mover estos datos a un entorno donde pudiera acceder a herramientas como Python y Google Cloud Platform (GCP). Sin embargo, fue un proceso largo, así que necesitaba hacer algo que me permitiera seguir desarrollando mientras esperaba que se completara la transferencia de datos. La solución a la que llegué fue crear datos falsos utilizando la biblioteca Faker en Python. Nunca antes había utilizado esta biblioteca, pero rápidamente entendí cuán útil es. Utilizar este enfoque me permitió comenzar a escribir código y probar el flujo de trabajo sin datos reales.
Teniendo en cuenta lo anterior, en esta publicación contaré cómo construí el flujo de trabajo descrito anteriormente utilizando algunas de las tecnologías disponibles en GCP. En particular, utilizaré Apache Beam (la versión para Python), Dataflow, Pub/Sub y BigQuery para recopilar registros de usuarios, transformar datos y enviarlos a la base de datos para su análisis posterior. En mi caso, solo necesitaba la funcionalidad por lotes de Beam, ya que mis datos no llegaban en tiempo real, por lo que Pub/Sub no era necesario. Sin embargo, me detendré en la versión de streaming, ya que es algo con lo que puedes encontrarte en la práctica.
Introducción a GCP y Apache Beam
Google Cloud Platform proporciona un conjunto de herramientas realmente útiles para el procesamiento de grandes datos. Aquí hay algunas de las herramientas que utilizaré:
- es un servicio de mensajería que utiliza el patrón Publicador-Suscriptor, que nos permite recibir datos en tiempo real.
- es un servicio que simplifica la creación de flujos de datos y resuelve automáticamente tareas como el escalado de infraestructura, lo que significa que podemos centrarnos únicamente en escribir código para nuestro flujo.
- es un almacenamiento de datos en la nube. Si estás familiarizado con otras bases de datos SQL, no tendrás problemas para entender BigQuery.
- Y finalmente, utilizaremos Apache Beam, centrándonos en la versión de Python para crear nuestro flujo de trabajo. Esta herramienta nos permitirá crear un flujo para procesamiento en lotes o streaming, que se integra con GCP. Es especialmente útil para procesamiento paralelo y adecuado para tareas de extracción, transformación y carga (ETL), por lo que si necesitamos mover datos de un lugar a otro realizando transformaciones o cálculos, Beam es una buena opción.
Hay una amplia variedad de herramientas disponibles en GCP, por lo que puede ser difícil llevar un control de todas ellas y de su propósito, pero aquí hay un resumen de referencia.
En GCP hay una gran cantidad de herramientas, por lo que puede resultar complicado abarcar todas, incluyendo su propósito, pero aun así resumen para referencia.
Visualización de nuestra canalización
Visualicemos los componentes de nuestra canalización en la figura 1. A un alto nivel, queremos recopilar datos de usuarios en tiempo real, procesarlos y enviarlos a BigQuery. Se generan registros cuando los usuarios interactúan con el producto, enviando solicitudes al servidor, que luego son registradas. Estos datos pueden ser especialmente útiles para entender cómo los usuarios interactúan con nuestro producto y si están funcionando correctamente. En general, la canalización contendrá los siguientes pasos:
Beam hace que este proceso sea muy simple, ya sea que tengamos una fuente de datos en streaming o un archivo CSV y queramos realizar un procesamiento por lotes. Más adelante verás que en el código solo hay cambios mínimos necesarios para alternar entre ellos. Esta es una de las ventajas de usar Beam.
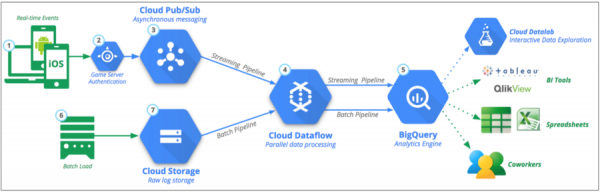
Figura 1: Canalización de datos principal: Fuente:
Generación de datos ficticios con Faker
Como mencioné anteriormente, debido al acceso limitado a los datos, decidí crear datos ficticios en el mismo formato que los reales. Fue un ejercicio realmente útil, ya que pude escribir código y probar la canalización mientras esperaba los datos. Te sugiero echar un vistazo a Faker, si quieres saber qué más puede ofrecerte esta biblioteca. Nuestros datos de usuario serán en general similares al ejemplo a continuación. Basándonos en este formato, podemos generar datos línea por línea para simular datos en tiempo real. Estos registros nos dan información como la fecha, el tipo de solicitud, la respuesta del servidor, la dirección IP, etc.
192.52.197.161 - - [30/Abr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, como Gecko) Chrome/34.0.855.0 Safari/5312"
Basándonos en la línea anterior, queremos crear nuestra variable LINE, utilizando 7 variables en las llaves a continuación. También las usaremos como nombres de variables en nuestro esquema de tablas un poco más tarde.
LÍNEA = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Si estuviéramos haciendo procesamiento en lote, el código se parecería mucho, aunque tendríamos que crear un conjunto de muestras en un cierto rango de tiempo. Para usar Faker, simplemente creamos un objeto y llamamos a los métodos que necesitamos. En particular, Faker fue útil para generar direcciones IP, así como sitios web. Utilicé los siguientes métodos:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "\/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Fin de la primera parte.
En los próximos días compartiremos con ustedes la continuación del artículo, pero por ahora, esperamos sus comentarios ;-).
Fuente: habr.com
