

Durante aproximadamente los últimos seis meses, he estado trabajando en la creación de un sistema para combatir el fraude (actividad fraudulenta, fraude, etc.) sin ninguna infraestructura inicial para ello. Las ideas que hemos encontrado y realizado en nuestro sistema nos ayudan a detectar múltiples acciones fraudulentas y analizarlas. En este artículo, me gustaría hablar sobre los principios que seguimos y lo que hicimos para alcanzar el estado actual de nuestro sistema, sin profundizar en la parte técnica.
Principios de nuestro sistema
Cuando escuchas términos como "automático" y "fraude", es probable que empieces a pensar en aprendizaje automático, Apache Spark, Hadoop, Python, Airflow y otras tecnologías del ecosistema de Apache Foundation y del ámbito de Data Science. Creo que hay un aspecto del uso de estas herramientas que generalmente no se menciona: requieren ciertos prerrequisitos en tu sistema corporativo antes de comenzar a utilizarlas. En resumen, necesitas una plataforma de datos corporativa que incluya un lago de datos y un almacenamiento. Pero, ¿qué pasa si no tienes tal plataforma y aún necesitas desarrollar esta práctica? Los siguientes principios de los que hablo a continuación nos ayudaron a alcanzar un momento en el que podemos enfocarnos en mejorar nuestras ideas, en lugar de buscar algo que funcione. Sin embargo, esto no es un “plato” en el proyecto. Aún hay muchas cosas por hacer desde el punto de vista tecnológico y de producto.
Principio 1: valor para el negocio primero
En el centro de todos nuestros esfuerzos hemos puesto el "valor para el negocio". En general, cualquier sistema de análisis automático pertenece a un grupo de sistemas complejos con un alto nivel de automatización y complejidad técnica. Crear una solución completa tomará mucho tiempo si la construyes desde cero. Decidimos priorizar el valor del negocio sobre la completitud tecnológica. En la vida real, esto significa que no aceptamos las tecnologías avanzadas como dogma. Elegimos la tecnología que mejor funcione para nosotros en este momento. Con el tiempo, puede parecer que tendremos que volver a implementar algunos módulos. Este es el compromiso que hemos asumido.
Principio 2: Inteligencia aumentada
Apuesto a que la mayoría de las personas que no están profundamente involucradas en el desarrollo de soluciones de aprendizaje automático pueden pensar que reemplazar a las personas es el objetivo. En realidad, las soluciones de aprendizaje automático están lejos de ser perfectas y solo en ciertas áreas es posible el reemplazo. Desde el principio, nos alejamos de esta idea por varias razones: datos desequilibrados sobre actividades fraudulentas e imposibilidad de proporcionar una lista exhaustiva de características para los modelos de aprendizaje automático. En cambio, elegimos la opción de inteligencia aumentada. Esta es una concepción alternativa de la inteligencia artificial que se centra en el papel de apoyo de la IA, subrayando el hecho de que las tecnologías cognitivas están destinadas a mejorar la inteligencia humana, no a reemplazarla. [1]
Teniendo esto en cuenta, desarrollar una solución completa de aprendizaje automático desde cero requeriría un esfuerzo enorme, lo que retrasaría la creación de valor para nuestro negocio. Decidimos construir un sistema con un aspecto de aprendizaje automático en crecimiento iterativo bajo la dirección de nuestros expertos en el tema. La parte complicada del desarrollo de un sistema así es que debe proporcionar a nuestros analistas casos no solo en términos de si se trata de una actividad fraudulenta o no. En general, cualquier anomalía en el comportamiento de los clientes es un caso sospechoso que los especialistas deben investigar y a los que deben responder de alguna manera. Solo una parte de estos casos registrados realmente puede clasificarse como fraude.
Principio 3: plataforma de análisis de datos extensivos
La parte más complicada de nuestro sistema es la verificación continua del flujo de trabajo del sistema. Los analistas y desarrolladores deben poder acceder fácilmente a conjuntos de datos de períodos pasados con todas las métricas utilizadas para el análisis. Además, la plataforma de datos debe proporcionar una forma simple de complementar el conjunto existente de indicadores con nuevos. Los procesos que creamos, que no son solo procesos de software, deben permitir recalcular fácilmente períodos anteriores, agregar nuevas métricas y modificar las previsiones de datos. Podríamos lograr esto acumulando todos los datos generados por nuestro sistema de producción. En tal caso, los datos se convertirían gradualmente en una carga. Tendríamos que almacenar un volumen creciente de datos que no estamos utilizando y protegerlos. En este escenario, con el tiempo, los datos se volverían cada vez más irrelevantes, pero todavía requerirían nuestro esfuerzo para gestionarlos. Para nosotros, la acumulación de datos no tenía sentido, y decidimos usar un enfoque diferente. Decidimos organizar almacenes de datos en tiempo real en torno a las entidades objetivo que queremos clasificar y almacenar solo los datos que permiten verificar los períodos más recientes y relevantes. La complejidad de estos esfuerzos radica en que nuestro sistema es heterogéneo con varios almacenes de datos y módulos de software que requieren una planificación cuidadosa para funcionar de manera coherente.
Conceptos constructivos de nuestro sistema
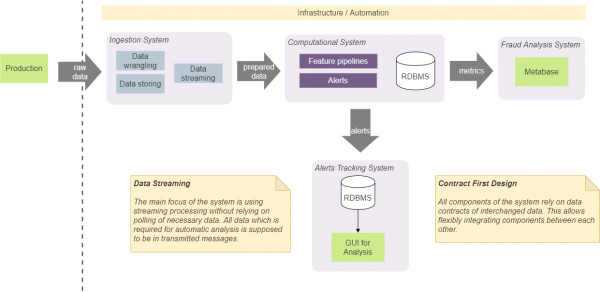
Tenemos cuatro componentes principales en nuestro sistema: el sistema de ingesta (ingestion system), computación (computational), análisis (BI analysis) y el sistema de seguimiento (tracking system). Sirven para objetivos aislados concretos, y los mantenemos separados siguiendo ciertos enfoques en el desarrollo.
Diseño basado en contratos
Ante todo, acordamos que los componentes deben depender únicamente de ciertas estructuras de datos (contratos) que se transmiten entre ellos. Esto permite una fácil integración entre ellos y evita imponer una composición específica (y un orden) de los componentes. Por ejemplo, en algunos casos, esto nos permite integrar directamente el sistema de recepción con el sistema de seguimiento de alertas. En ese caso, se realizará de acuerdo con el contrato de alertas acordado. Esto significa que ambos componentes estarán integrados utilizando un contrato que puede ser utilizado por cualquier otro componente. No vamos a añadir un contrato adicional para agregar alertas en el sistema de seguimiento desde el sistema de entrada. Este enfoque requiere el uso de un número mínimo de contratos predefinidos y simplifica el sistema y la comunicación. En esencia, estamos utilizando un enfoque que se llama 'Diseño Primero de Contratos' y lo aplicamos a los contratos de transmisión de datos. [2]
Streaming en todas partes
La conservación y gestión del estado en un sistema inevitablemente conducirá a complicaciones en su implementación. En general, el estado debe ser accesible desde cualquier componente, debe ser consistente y proporcionar el valor más actual para todos los componentes, y debe ser confiable con valores correctos. Además, la presencia de llamadas a un almacenamiento persistente para obtener el último estado aumentará la cantidad de operaciones de entrada-salida y la complejidad de los algoritmos utilizados en nuestros pipelines en tiempo real. Debido a esto, decidimos eliminar el almacenamiento de estado, tanto como sea posible, de nuestro sistema. Este enfoque requiere incluir todos los datos necesarios en el bloque de datos transmitido (mensaje). Por ejemplo, si necesitamos calcular el total de ciertas observaciones (el número de operaciones o casos con características específicas), lo calculamos en memoria y generamos una secuencia de tales valores. Los módulos dependientes utilizarán la partición y el batch para dividir la secuencia por entidades y operar con los valores más recientes. Este enfoque eliminó la necesidad de tener un almacenamiento en disco persistente para estos datos. Nuestro sistema utiliza Kafka como corredor de mensajes, y se puede usar como base de datos con KSQL. [3] Pero su uso vincularía fuertemente nuestra solución a Kafka, y decidimos no utilizarlo. El enfoque que elegimos permite reemplazar Kafka con otro corredor de mensajes sin cambios internos importantes en el sistema.
Este concepto no implica que no usemos almacenamiento en disco y bases de datos. Para verificar y analizar el rendimiento del sistema, necesitamos almacenar en disco una parte significativa de los datos que representan diversas métricas y estados. Un punto importante aquí es que los algoritmos en tiempo real no dependen de esos datos. En la mayoría de los casos, usamos datos almacenados para análisis autónomos, depuración y seguimiento de casos y resultados específicos que proporciona el sistema.
Problemas de nuestro sistema
Existen ciertos problemas que hemos resuelto hasta cierto nivel, pero requieren soluciones más elaboradas. Ahora simplemente me gustaría mencionarlos aquí, porque cada punto merecería un artículo por separado.
- Aún necesitamos definir procesos y políticas que contribuyan a la acumulación de datos significativos y relevantes para nuestro análisis automatizado, detección e investigación de datos.
- La implementación de los resultados del análisis humano en el proceso de ajuste automático del sistema para actualizarlo con los datos más recientes. Esto no solo actualiza nuestro modelo, sino también los procesos y mejora nuestra comprensión de los datos.
- Encontrar un equilibrio entre el enfoque determinista IF-ELSE y el aprendizaje automático (ML). Alguien dijo: "ML es una herramienta para los desesperados". Esto significa que querrás usar ML cuando ya no entiendas cómo optimizar y mejorar tus algoritmos. Por otro lado, el enfoque determinista no permite la detección de anomalías que no fueron previstas.
- Necesitamos una manera simple de verificar nuestras hipótesis o correlaciones entre métricas en los datos.
- El sistema debe tener varios niveles de resultados verdaderamente positivos (true positive). Los casos de fraude son solo una parte de todos los casos que pueden considerarse positivos para el sistema. Por ejemplo, los analistas quieren recibir todos los casos sospechosos para su verificación, y solo una pequeña parte de ellos es fraude. El sistema debe proporcionar a los analistas todos los casos de manera efectiva, independientemente de si se trata de un fraude real o simplemente de un comportamiento sospechoso.
- La plataforma de datos debe permitir la obtención de conjuntos de datos de períodos anteriores con cálculos generados y calculados sobre la marcha.
- Despliegue simple y automático de cualquiera de los componentes del sistema en al menos tres entornos diferentes: producción, experimental (beta) y para desarrolladores.
- Y por último, pero no menos importante. Necesitamos crear una amplia plataforma de evaluación del rendimiento, donde podamos analizar nuestros modelos. [4]
Enlaces
Fuente: habr.com
