

¡Hola! Quiero hablar de manera sencilla sobre la mecánica de la aparición del steal dentro de las máquinas virtuales y sobre algunos artefactos poco evidentes que hemos logrado descubrir en nuestra investigación, en la que me vi involucrado como director técnico de la plataforma en la nube. . La plataforma funciona en KVM.
El tiempo de CPU steal es el tiempo durante el cual la máquina virtual no recibe recursos de CPU para su ejecución. Este tiempo se considera solo en sistemas operativos invitados en entornos de virtualización. Las razones por las cuales estos recursos asignados desaparecen son, al igual que en la vida, bastante nebulosas. Pero decidimos investigar, incluso realizamos toda una serie de experimentos. No es que ahora sepamos todo sobre el steal, pero vamos a contar algunas cosas interesantes.
1. ¿Qué es el steal?
Entonces, el steal es una métrica que indica la falta de tiempo de CPU para los procesos dentro de la máquina virtual. Como se describe , el steal es el tiempo durante el cual el hipervisor ejecuta otros procesos en el sistema operativo host, aunque ha puesto el proceso de la máquina virtual en cola para su ejecución. Es decir, el steal se calcula como la diferencia entre el tiempo en que el proceso está listo para ejecutarse y el tiempo en que se le asigna tiempo de CPU.
La métrica de steal la obtiene el núcleo de la máquina virtual del hipervisor. Sin embargo, el hipervisor no especifica qué otros procesos está ejecutando, simplemente dice: ‘mientras estoy ocupado, no puedo dedicarte tiempo’. En KVM, el soporte para el conteo del steal se añadió en Aquí hay dos aspectos clave:
- La máquina virtual se entera del steal por parte del hipervisor. Es decir, desde el punto de vista de las pérdidas, para los procesos en la propia máquina virtual es una medida indirecta, que puede estar sujeta a diversas distorsiones.
- El hipervisor no comparte con la máquina virtual información sobre en qué más está ocupado, lo importante es que no le dedica tiempo. Debido a esto, la propia máquina virtual no puede identificar distorsiones en la métrica de steal que podrían evaluarse por la naturaleza de los procesos en competencia.
2. ¿Qué influye en el steal?
2.1. Cálculo del steal
En esencia, el steal se calcula de manera similar al tiempo de utilización normal de la CPU. Hay poca información sobre cómo se calcula la utilización, probablemente porque la mayoría considera que esta cuestión es obvia. Pero también hay trampas en este aspecto. Para familiarizarse con este proceso, se puede leer. : aprenderás sobre una serie de matices al calcular la utilización y sobre las situaciones en las que este cálculo puede ser erróneo por las siguientes razones:
- Sobrecalentamiento del procesador, donde se omiten ciclos.
- Activación/desactivación del turbo boost, lo que altera la frecuencia del reloj del procesador.
- Cambio en la duración del quantum de tiempo, que ocurre al usar tecnologías de ahorro de energía del procesador, como SpeedStep.
- Problema del cálculo medio: estimar la utilización durante un minuto al 80 % puede ocultar un pico temporal del 100 %.
- El bloqueo cíclico (spin lock) provoca que el procesador esté utilizado, pero el proceso del usuario no avanza en su ejecución. Como resultado, la utilización calculada del procesador por el proceso será del cien por ciento, aunque físicamente el tiempo del procesador no se esté consumiendo.
No encontré artículos que describieran un cálculo similar para el steal (si lo conocen — compártanlo en los comentarios). Sin embargo, según el código fuente, el mecanismo de cálculo es el mismo que para la utilización. Simplemente, en el núcleo se añade otro contador, directamente para el proceso KVM (proceso de la máquina virtual), que cuenta la duración de la espera del proceso KVM por tiempo de procesador. El contador obtiene información sobre el procesador de sus especificaciones y verifica si todos sus ciclos están siendo utilizados por el proceso de la máquina virtual. Si todos, consideramos que el procesador solo estaba dedicado al proceso de la máquina virtual. De lo contrario, informamos que el procesador estaba ocupado con algo más, apareció el steal.
El proceso de cálculo del steal está sujeto a los mismos problemas que el cálculo normal de utilización. No se puede decir que estos problemas ocurran con frecuencia, pero son desalentadores.
2.2. Tipos de virtualización en KVM
En general, hay tres tipos de virtualización, y todos son compatibles con KVM. El tipo de virtualización puede afectar el mecanismo de aparición del steal.
Traducción. En este caso, el funcionamiento del sistema operativo de la máquina virtual con los dispositivos físicos del hipervisor se realiza de la siguiente manera:
- El sistema operativo invitado envía un comando a su dispositivo invitado.
- El controlador del dispositivo invitado recibe el comando, genera una solicitud para la BIOS del dispositivo y la envía al hipervisor.
- El proceso del hipervisor traduce el comando en un comando para el dispositivo físico, haciéndolo, entre otras cosas, más seguro.
- El controlador del dispositivo físico recibe el comando modificado y lo envía al propio dispositivo físico.
- Los resultados de la ejecución de los comandos regresan por el mismo camino.
La ventaja de la traducción es que permite emular cualquier dispositivo y no requiere una preparación especial del núcleo del sistema operativo. Pero esto tiene un costo, principalmente en términos de velocidad.
Virtualización hardware. En este caso, el dispositivo a nivel de hardware entiende los comandos del sistema operativo. Este es el método más rápido y eficaz. Sin embargo, desafortunadamente, no es compatible con todos los dispositivos físicos, hipervisores y sistemas operativos invitados. En la actualidad, los principales dispositivos que soportan la virtualización de hardware son los procesadores.
Paravirtualización. Es la variante más utilizada de virtualización de dispositivos en KVM y, en general, el modo más común de virtualización para sistemas operativos invitados. Su característica es que la interacción con algunos subsistemas del hipervisor (por ejemplo, con el stack de red o de disco) o la asignación de páginas de memoria se realiza utilizando la API del hipervisor, sin la traducción de comandos de bajo nivel. La desventaja de este método de virtualización es la necesidad de modificar el núcleo del sistema operativo invitado para que pueda interactuar con el hipervisor a través de esta API. Pero normalmente esto se resuelve instalando controladores especiales en el sistema operativo invitado. En KVM, esta API se llama .
Con la paravirtualización, en comparación con la traducción, el camino hacia el dispositivo físico se acorta significativamente al enviar comandos directamente desde la máquina virtual al proceso del hipervisor en el host. Esto permite acelerar la ejecución de todas las instrucciones dentro de la máquina virtual. En KVM, esto es responsabilidad de la API de virtio, que solo funciona para ciertos dispositivos, como adaptadores de red o de disco. Es por eso que dentro de las máquinas virtuales se instalan controladores virtio.
El lado negativo de tal aceleración es que no todos los procesos que se ejecutan dentro de la máquina virtual permanecen dentro de ella. Esto crea ciertos efectos especiales que pueden resultar en la aparición en steal. Recomiendo comenzar un estudio detallado de esta cuestión con .
2.3. Programación «justa»
Una máquina virtual en un hipervisor es, de hecho, un proceso habitual que se rige por las leyes de programación (distribución de recursos entre procesos) en el núcleo de Linux, por lo que lo examinaremos más a fondo.
En Linux se utiliza el llamado CFS, Completely Fair Scheduler, que a partir del núcleo 2.6.23 se convirtió en el planificador por defecto. Para entender este algoritmo, se puede leer Linux Kernel Architecture o los fuentes. La esencia del CFS reside en distribuir el tiempo de CPU entre los procesos en función de la duración de su ejecución. Cuanto más tiempo de CPU requiera un proceso, menos tiempo recibirá. Esto garantiza la ejecución «justa» de todos los procesos, evitando que un proceso monopolice constantemente todos los procesadores y permitiendo que otros también puedan ejecutarse.
A veces, esta parábola conduce a artefactos interesantes. Los antiguos usuarios de Linux seguramente recordarán el congelamiento de editores de texto comunes en el escritorio durante el lanzamiento de aplicaciones que consumen muchos recursos, como compiladores. Esto ocurría porque las tareas no intensivas en recursos de las aplicaciones de escritorio competían con tareas que consumían activamente recursos, como el compilador. El CFS considera que esto es injusto, por lo que detiene periódicamente el editor de texto y permite que la CPU procese las tareas del compilador. Esto se corrigió mediante el mecanismo , pero aún quedan muchas otras particularidades en la distribución del tiempo de CPU entre las tareas. En realidad, esta no es una historia sobre lo mal que está el CFS, sino un intento de llamar la atención sobre que la distribución «justa» del tiempo de CPU no es una tarea trivial.
Otro punto importante en el planificador es la preemption. Esto es necesario para expulsar un proceso que ha consumido demasiado tiempo de CPU y permitir que otros procesos trabajen. El proceso de expulsión se llama cambio de contexto, o context switching. Durante este proceso, se guarda todo el contexto de la tarea: el estado de la pila, los registros y otros, después de lo cual el proceso es enviado a esperar y otro ocupa su lugar. Esta es una operación costosa para el sistema operativo y se utiliza raramente, pero en esencia no es algo negativo. Un cambio frecuente de contexto puede indicar un problema en el sistema operativo, pero normalmente ocurre de manera continua sin señalar nada en particular.
Este extenso relato es necesario para explicar un hecho: cuanto más recursos de CPU intenta consumir un proceso en un planificador honesto de Linux, más rápido será detenido para que otros procesos también puedan trabajar. Si esto es correcto o no es una pregunta complicada que se responde de diferentes maneras según la carga. Hasta hace poco, el planificador en Windows estaba orientado a dar prioridad al procesamiento de aplicaciones de escritorio, lo que podía hacer que los procesos en segundo plano se congelaran. En Sun Solaris había cinco clases de planificadores diferentes. Cuando se introdujo la virtualización, se agregó una sexta, , porque los cinco anteriores no funcionaban adecuadamente con la virtualización de Solaris Zones. Recomiendo comenzar un estudio detallado sobre este tema con libros como o .
2.4. ¿Cómo monitorear el steal?
Monitorear el steal dentro de una máquina virtual, al igual que cualquier otra métrica del procesador, es sencillo: se puede utilizar cualquier herramienta de recolección de métricas de CPU. Lo principal es que la máquina virtual esté en Linux. Windows, por alguna razón, no proporciona esta información a sus usuarios. 🙁
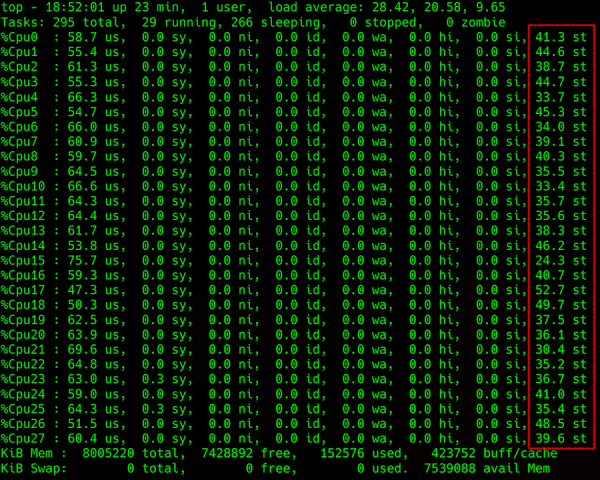
Salida del comando top: detalle de la carga de la CPU, en la columna más a la derecha — steal
La dificultad surge al intentar obtener esta información desde el hipervisor. Se puede tratar de predecir el steal en la máquina host, por ejemplo, según el parámetro Load Average (LA) — el valor promedio de procesos esperando en cola para ser ejecutados. La metodología para calcular este parámetro no es sencilla, pero en general, si el LA normalizado por la cantidad de hilos del procesador es mayor a 1, esto indica que el servidor con Linux está sobrecargado por alguna razón.
¿Qué están esperando todos estos procesos? La respuesta obvia es el procesador. Pero la respuesta no es del todo correcta, porque a veces el procesador está libre y la LA está disparada. Recuerden, . Algo similar puede ocurrir con el disco y con otros dispositivos de entrada/salida. Pero en realidad, los procesos pueden esperar el final de cualquier bloqueo, ya sea físico, relacionado con el dispositivo de entrada/salida, o lógico, por ejemplo, un mutex. Esto incluye bloqueos a nivel de hardware (la misma respuesta del disco), o de lógica (los llamados primitivos de bloqueo, que incluyen una multitud de entidades, mutex adaptativos y de giro, semáforos, variables de condición, bloqueos rw, bloqueos ipc…).
Otra peculiaridad de la LA es que se considera como un valor promedio por el sistema operativo. Por ejemplo, 100 procesos compiten por un archivo, y entonces LA=50. Un valor tan alto parecería indicar que el sistema operativo está en problemas. Pero para un código mal escrito puede ser un estado normal, donde solo él tiene problemas, mientras que otros procesos en el sistema operativo no sufren.
Debido a este promediado (que ocurre en un período de no menos de un minuto), determinar algo a partir del indicador LA no es una tarea agradecida, con resultados bastante indefinidos en casos concretos. Si intentan investigar, notarán que en los artículos de Wikipedia y otros recursos disponibles solo se describen los casos más simples, sin una explicación profunda del proceso. A todos los interesados los remito, nuevamente, — a través de los enlaces. Para quienes no quieren leer en inglés — .
3. Efectos especiales
Ahora nos detendremos en los casos principales de aparición de steal, con los que nos hemos encontrado. Les contaré cómo se derivan de todo lo anterior y cómo se relacionan con los indicadores en el hipervisor.
Reutilización. Lo más simple y común: el hipervisor está sobreutilizado. De hecho, hay muchas máquinas virtuales en ejecución, un alto consumo de CPU dentro de ellas, una gran competencia, reutilización por LA superior a 1 (en relación a los hilos de CPU). Dentro de todas las máquinas virtuales, todo se ralentiza. El steal, transmitido desde el hipervisor, también aumenta, se debe redistribuir la carga o apagar a alguien. En general, tiene sentido y es entendible.
Paravirtualización contra instancias solitarias. En el hipervisor hay una única máquina virtual, que consume una pequeña parte de su capacidad, pero genera una gran carga de entrada/salida, por ejemplo, en disco. Y de alguna manera, aparece un pequeño steal, hasta el 10% (como muestran varios experimentos realizados).
Es un caso interesante. El steal aparece aquí precisamente debido a bloqueos a nivel de controladores paravirtualizados. Dentro de la máquina virtual se genera una interrupción, que es procesada por el controlador y enviada al hipervisor. Debido al procesamiento de la interrupción en el hipervisor, para la máquina virtual esto parece una solicitud enviada, está lista para ejecutar y espera el procesador, pero no se le proporciona tiempo de CPU. La máquina virtual piensa que ese tiempo ha sido robado.
Esto ocurre en el momento de enviar el búfer, que se envía al espacio del kernel del hipervisor, y comenzamos a esperarlo. Sin embargo, desde el punto de vista de la máquina virtual, debería regresar de inmediato. Por lo tanto, de acuerdo con el algoritmo de cálculo del steal, este tiempo se considera robado. Probablemente, en esta situación pueden existir otros mecanismos (como el procesamiento de algunas llamadas al sistema), pero no deberían diferir mucho.
El programador contra las máquinas virtuales de alta carga. Cuando una máquina virtual sufre más steal que otras, está relacionado precisamente con el programador. Cuanto más intensa sea la carga del procesador, más rápido el programador la expulsará para que las demás también puedan trabajar. Si la máquina virtual consume poco, casi no notará steal: su proceso está honestamente sentado y esperando, hay que darle más tiempo. Si la máquina virtual produce una carga máxima en todos sus núcleos, con mayor frecuencia es expulsada del procesador y se intenta no darle mucho tiempo.
Es aún peor cuando los procesos dentro de la máquina virtual intentan obtener más CPU porque no pueden manejar el procesamiento de datos. Entonces, el sistema operativo en el hipervisor, a través de una optimización honesta, comenzará a dar cada vez menos tiempo de CPU. Este proceso ocurre de manera avalancha, y el steal se dispara por las nubes, aunque las otras máquinas virtuales pueden no notarlo casi en absoluto. Y cuanto más núcleos, peor será para la máquina que está sufriendo. En resumen, las máquinas virtuales de alta carga con muchos núcleos son las que más sufren.
Bajo LA, pero hay steal. Si LA es aproximadamente 0,7 (es decir, el hipervisor parece estar subutilizado), pero dentro de algunas máquinas virtuales se observa steal:
- La opción que ya se ha descrito anteriormente con para-virtualización. La máquina virtual puede recibir métricas que indican el steal, aunque el hipervisor esté funcionando bien. Según los resultados de nuestros experimentos, dicho steal no supera el 10 % y no debería afectar significativamente el rendimiento de las aplicaciones dentro de la máquina virtual.
- Se considera incorrectamente el parámetro LA. Más precisamente, en cada momento específico se calcula correctamente, pero al promediar durante un minuto el resultado queda subestimado. Por ejemplo, si una máquina virtual utiliza todos sus procesadores durante exactamente medio minuto, el LA durante un minuto en el hipervisor será 0.15; cuatro máquinas virtuales, funcionando al mismo tiempo, darán 0.6. Y el hecho de que durante medio minuto cada una de ellas experimentó un alto steal de hasta el 25 % en el indicador LA ya no se puede rescatar.
- De nuevo, debido al planificador, que decidió que alguien está consumiendo demasiado, y que esa persona espere. Mientras tanto, cambio de contexto, manejo interrupciones y me ocupo de otras cosas importantes del sistema. Como resultado, algunas máquinas virtuales no ven problemas, mientras que otras experimentan una grave degradación del rendimiento.
4. Otras distorsiones
Hay millones de razones más para las distorsiones en la entrega justa del tiempo de CPU en una máquina virtual. Por ejemplo, las complicaciones en los cálculos son causadas por el hyper-threading y NUMA. Estos complican finalmente la elección del núcleo para la ejecución del proceso, porque el planificador utiliza coeficientes: pesos que al cambiar de contexto hacen que el conteo sea aún más complicado.
Puede haber distorsiones debido a tecnologías como el turbo-boost o, por el contrario, el modo de ahorro de energía, que al contabilizar la utilización pueden aumentar o disminuir artificialmente la frecuencia o incluso el cuántum de tiempo en el servidor. La activación del turbo-boost reduce el rendimiento de un hilo de procesador debido al aumento del rendimiento de otro. En ese momento, la información sobre la frecuencia actual del procesador no se transmite a la máquina virtual, y ella cree que su tiempo está siendo robado (por ejemplo, solicitó 2 GHz, pero recibió la mitad).
En general, pueden haber muchas razones para las distorsiones. En un sistema específico puedes descubrir algo más. Es mejor empezar con los libros a los que he enlazado anteriormente y la recopilación de estadísticas del hipervisor con utilidades como perf, sysdig, systemtap, de las cuales hay .
5. Conclusiones
- Una cierta cantidad de steal puede surgir debido a la paravirtualización, y se puede considerar normal. En internet se menciona que este valor puede ser del 5-10%. Depende de las aplicaciones dentro de la máquina virtual y de la carga que estas generen en sus dispositivos físicos. Aquí es importante prestar atención a cómo se comportan las aplicaciones dentro de las máquinas virtuales.
- La relación entre la carga en el hipervisor y el steal dentro de la máquina virtual no siempre está claramente interrelacionada; ambas estimaciones de steal pueden ser erróneas en situaciones específicas bajo diferentes cargas.
- El planificador tiene una mala disposición hacia los procesos que piden mucho. Intenta dar menos a quienes piden más. Las grandes máquinas virtuales son un problema.
- Un pequeño steal puede ser normal incluso sin paravirtualización (teniendo en cuenta la carga dentro de la máquina virtual, las características de la carga de los vecinos, la distribución de la carga entre hilos y otros factores).
- Si quieres averiguar el steal en un sistema específico, debes investigar varias opciones, recopilar métricas, analizarlas cuidadosamente y pensar en cómo distribuir la carga de manera uniforme. De cualquier caso pueden surgir variaciones que es necesario confirmar experimentalmente o ver en el depurador del núcleo.
Fuente: habr.com
