

En el anterior Hemos analizado los fundamentos teóricos de la arquitectura reactiva. Es hora de hablar sobre los flujos de datos, las formas de implementar sistemas reactivos de Erlang/Elixir y los patrones de intercambio de mensajes en ellos:
- Solicitud-respuesta
- Respuesta de solicitud en fragmentos
- Respuesta con solicitud
- Publicar-suscribirse
- Publicar-suscribirse invertido
- Distribución de tareas
SOA, MSA y el intercambio de mensajes
SOA y MSA son arquitecturas de sistemas que definen las reglas para construir sistemas, mientras que el mensajería proporciona los primitivos para su implementación.
No quiero promover una arquitectura de sistemas sobre otra. Estoy a favor de aplicar las prácticas más eficaces y útiles para un proyecto y negocio específicos. Cualquiera que sea el paradigma que elijamos, es mejor crear bloques de sistema teniendo en cuenta el estilo Unix: componentes con baja cohesión, responsables de entidades individuales. Los métodos de API llevan a cabo las acciones más simples sobre estas entidades.
El mensajería, como se entiende por su nombre, es un corredor de mensajes. Su objetivo principal es recibir y entregar mensajes. Se encarga de las interfaces para enviar información, crear canales lógicos de transmisión dentro del sistema, la enrutación y el equilibrio, así como el manejo de fallos a nivel de sistema.
El mensajería que se desarrolla no intenta competir con rabbitmq ni reemplazarlo. Sus características principales son:
- Distribución.
Los puntos de intercambio se pueden crear en todos los nodos del clúster, lo más cerca posible del código que los utiliza. - Simplicidad.
Enfoque en minimizar el código repetitivo y la facilidad de uso. - Mejor rendimiento.
No intentamos duplicar la funcionalidad de rabbitmq, sino que destacamos solo la capa arquitectónica y de transporte, que se integra fácilmente en OTP, minimizando costos. - Flexibilidad.
Cada servicio puede combinar múltiples patrones de intercambio. - Resiliencia, integrada en el diseño.
- Escalabilidad.
El mensajería crece junto con la aplicación. A medida que aumenta la carga, se pueden mover los puntos de intercambio a máquinas separadas.
Observación. Desde el punto de vista de la organización del código, los meta-proyectos son ideales para sistemas complejos en Erlang/Elixir. Todo el código del proyecto se encuentra en un solo repositorio: el proyecto paraguas. Al mismo tiempo, los microservicios están lo más aislados posible y realizan operaciones simples, encargándose de una entidad específica. Con este enfoque, es fácil mantener la API de todo el sistema, realizar cambios y escribir pruebas unitarias e integradas de manera cómoda.
Los componentes del sistema interactúan directamente o a través de un broker. Desde la perspectiva de la mensajería, cada servicio tiene varias fases de vida:
- Inicialización del servicio.
En esta etapa se lleva a cabo la configuración y la ejecución del proceso del servicio y sus dependencias. - Creación de un punto de intercambio.
El servicio puede utilizar un punto de intercambio estático, definido en la configuración del nodo, o crear puntos de intercambio dinámicamente. - Registro del servicio.
Para que el servicio pueda atender solicitudes, debe registrarse en el punto de intercambio. - Funcionamiento normal.
El servicio realiza un trabajo útil. - Finalización del trabajo.
Pueden haber 2 tipos de finalización del trabajo: normal y anómala. En el caso normal, el servicio se desconecta del punto de intercambio y se detiene. En situaciones anómalas, la mensajería ejecuta uno de los escenarios de manejo de fallas.
Parece bastante complicado, pero en el código no es tan aterrador. Se presentarán ejemplos de código con comentarios posteriormente en el análisis de plantillas.
Intercambios
Un punto de intercambio es un proceso de mensajería que implementa la lógica de interacción con los componentes dentro de una plantilla de intercambio de mensajes. En todos los ejemplos que se presentan a continuación, los componentes interactúan a través de puntos de intercambio, cuyas combinaciones forman la mensajería.
Patrones de intercambio de mensajes (MEPs)
Globalmente, los patrones de intercambio se pueden dividir en bidireccionales y unidireccionales. Los primeros implican una respuesta al mensaje recibido, los segundos no. Un ejemplo clásico de un patrón bidireccional en una arquitectura cliente-servidor es el patrón de solicitud-respuesta. Revisemos este patrón y sus modificaciones.
Solicitud-respuesta o RPC
RPC se utiliza cuando necesitamos obtener una respuesta de otro proceso. Este proceso puede estar ejecutándose en el mismo nodo o estar ubicado en otro continente. A continuación se muestra un esquema de interacción entre el cliente y servidores a través de mensajería.
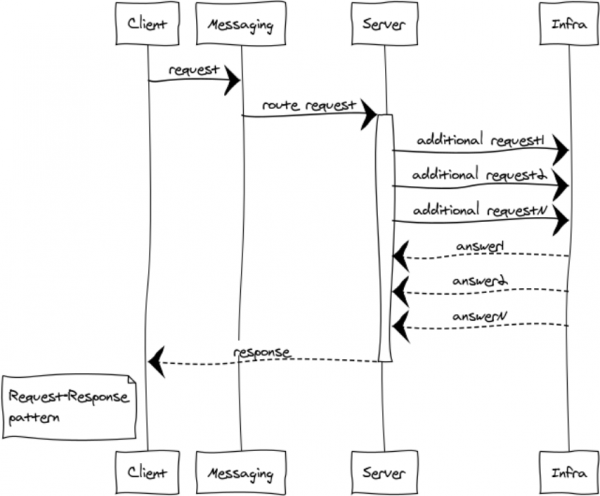
Dado que la mensajería es completamente asíncrona, para el cliente el intercambio se divide en 2 fases:
Envío de solicitud
mensajería:solicitud(Intercambio, EtiquetaDeCoincidenciaDeRespuesta, DefiniciónDeSolicitud, ProcesoDeManejador).Intercambio ‒ nombre único del punto de intercambio
EtiquetaDeCoincidenciaDeRespuesta ‒ etiqueta local para el procesamiento de la respuesta. Por ejemplo, en el caso de enviar varias solicitudes idénticas pertenecientes a diferentes usuarios.
DefiniciónDeSolicitud ‒ cuerpo de la solicitud
ProcesoDeManejador ‒ PID del manejador. A este proceso le llegará la respuesta del servidor.Procesamiento de la respuesta
manejar_info(#'$msg'{intercambio = INTERCAMBIO, etiqueta = EtiquetaDeCoincidenciaDeRespuesta,mensaje = CargaDeRespuesta}, Estado)CargaDeRespuesta ‒ respuesta del servidor.
Para el servidor, el proceso también consta de 2 fases:
- Inicialización del punto de intercambio
- Procesamiento de las solicitudes recibidas
Ilustremos este patrón con código. Supongamos que necesitamos implementar un servicio simple que proporcione un único método para obtener la hora exacta.
Código del servidor
Extraigamos la definición de la API del servicio en api.hrl:
%% =====================================================
%% entidades
%% =====================================================
-registro(hora, {
  tiempo_unix :: entero_no_negativo(),
  fecha_hora :: binario()
}).

-registro(error_hora, {
  código :: entero_no_negativo(),
  error :: término()
}).

%% =====================================================
%% métodos
%% =====================================================
-registro(solicitud_hora, {
  opciones :: término()
}).
-registro(respuesta_hora, {
  resultado :: #hora{} | #error_hora{}
}).
Definamos el controlador del servicio en time_controller.erl
%% En el ejemplo solo se muestra el código significativo. Al insertarlo en la plantilla gen_server, se puede obtener un servicio funcional.

%% inicialización del gen_server
init(Args) ->
  %% conexión con el punto de intercambio
  mensajería:monitorear_intercambio(req_resp, ?INTERCAMBIO, por_defecto, self())
  {ok, #{}}.

%% manejo del evento de pérdida de conexión con el punto de intercambio. Este mismo evento llega si el punto de intercambio aún no se ha iniciado.
handle_info(#intercambio_muerto{intercambio = ?INTERCAMBIO}, Estado) ->
  erlang:enviar(self(), monitorear_intercambio),
  {noreply, Estado};

%% manejo de la API
handle_info(#solicitud_hora{opciones = _Opciones}, Estado) ->
  mensajería:respuesta_una_vez(Cliente, #respuesta_hora{
resultado = #hora{ tiempo_unix = time_utils:tiempo_unix(now()), fecha_hora = time_utils:iso8601_fmt(now())}
  });
  {noreply, Estado};

%% finalización del gen_server
terminar(_Razón, _Estado) ->
  mensajería:demonitorar_intercambio(req_resp, ?INTERCAMBIO, por_defecto, self()),
  ok.
Código del cliente
Para enviar una solicitud al servicio, se puede llamar a la API de solicitud de mensajería en cualquier parte del cliente:
caso mensajería:solicitud(?INTERCAMBIO, etiqueta, #solicitud_hora{opciones = #{}}, self()) de
    ok -> ok;
    _ -> %% lógica de repetición o fallo
fin
En un sistema distribuido, la configuración de los componentes puede ser muy variada y en el momento de la solicitud, la mensajería puede no haberse iniciado aún, o el controlador del servicio no estará preparado para atender la solicitud. Por lo tanto, necesitamos verificar la respuesta de la mensajería y manejar el caso de fallo.
Tras el envío exitoso, el cliente recibirá una respuesta o un error del servicio.
Manejemos ambos casos en handle_info:
handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time{unixtime = Utime}}}, State) ->
  ?debugVal(Utime),
  {noreply, State};

handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time_error{code = ErrorCode}}}, State) ->
  ?debugVal({error, ErrorCode}),
  {noreply, State};
Respuesta de solicitud en fragmentos
Es mejor evitar enviar mensajes grandes. Esto afecta la capacidad de respuesta y el funcionamiento estable de todo el sistema. Si la respuesta a la solicitud ocupa mucha memoria, entonces la fragmentación es obligatoria.
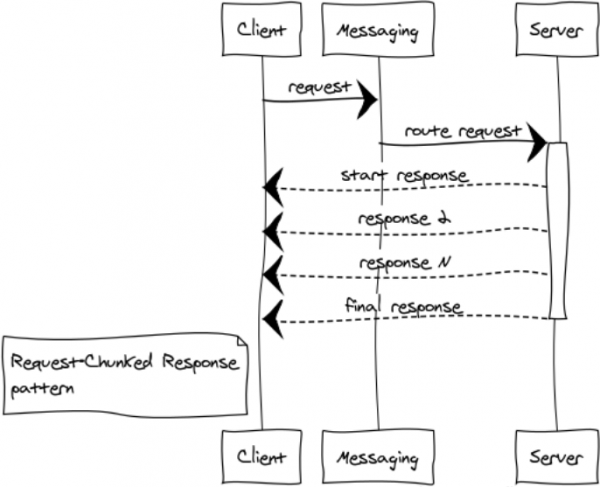
Aquí hay un par de ejemplos de tales casos:
- Los componentes intercambian datos binarios, por ejemplo, archivos. Dividir la respuesta en partes pequeñas ayuda a trabajar eficazmente con archivos de cualquier tamaño y a evitar el desbordamiento de memoria.
- Listados. Por ejemplo, necesitamos seleccionar todos los registros de una tabla muy grande en la base de datos y enviarlos a otro componente.
Yo llamo a tales respuestas 'un tren de carga'. En cualquier caso, 1024 mensajes de 1 MB son mejores que un solo mensaje de 1 GB.
En un clúster de Erlang, obtenemos una ventaja adicional: reducción de la carga en el punto de intercambio y la red, ya que las respuestas se envían directamente al destinatario, omitiendo el punto de intercambio.
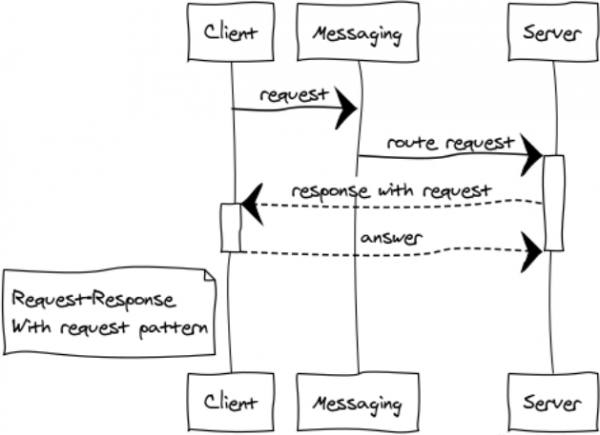
Respuesta con solicitud
Esta es una modificación bastante rara del patrón RPC para construir sistemas de diálogo.
Publicar-suscribirse (árbol de distribución de datos)
Los sistemas orientados a eventos entregan datos a los consumidores a medida que estos están listos. Así, los sistemas tienden más a un modelo de push que a pull o poll. Esta característica evita desperdiciar recursos solicitando constantemente y esperando datos.
En la figura se muestra el proceso de distribución de mensajes a los consumidores suscritos a un tema específico.
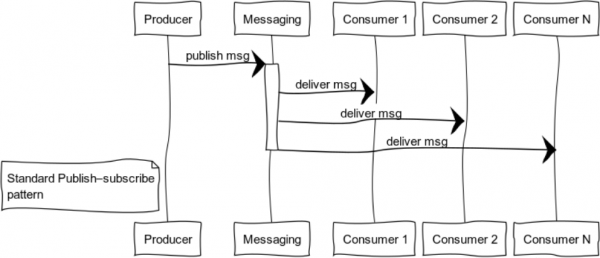
Ejemplos clásicos de uso de este patrón incluyen la propagación de estados: del mundo del juego en videojuegos, datos de mercado en bolsas, información útil en feeds de datos.
Veamos el código del suscriptor:
init(_Args) ->
  %% nos suscribimos al intercambiador, clave = key
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {ok, #{}}.

handle_info(#exchange_die{exchange = ?SUBSCRIPTION}, State) ->
  %% si el punto de intercambio no está disponible, intentamos reconectarnos
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {noreply, State};

%% procesamos los mensajes recibidos
handle_info(#'$msg'{exchange = ?SUBSCRIPTION, message = Msg}, State) ->
  ?debugVal(Msg),
  {noreply, State};

%% al detener al consumidor, nos desconectamos del punto de intercambio
terminate(_Reason, _State) ->
  messaging:unsubscribe(?SUBSCRIPTION, key, tag, self()),
  ok.
La fuente puede invocar la función de publicación de mensajes en cualquier lugar conveniente:
messaging:publish_message(Exchange, Key, Message).Intercambio ‒ nombre del punto de intercambio,
Clave ‒ clave de enrutamiento,
Mensaje ‒ carga útil.
Publicar-suscribirse invertido
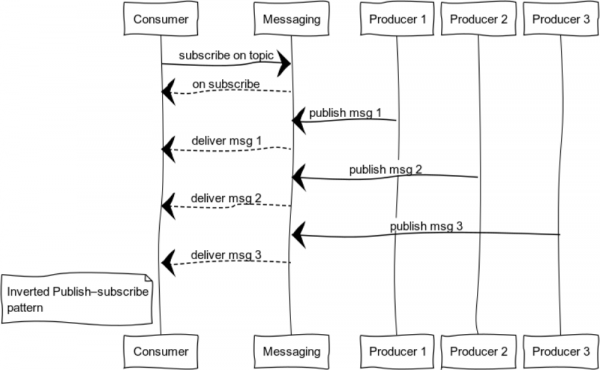
Al implementar pub-sub, se puede obtener un patrón conveniente para el registro. El conjunto de fuentes y consumidores puede ser muy diverso. La imagen ilustra un caso con un solo consumidor y múltiples fuentes.
Patrón de distribución de tareas
Casi todos los proyectos enfrentan tareas de procesamiento diferido, como la generación de informes, la entrega de notificaciones y la obtención de datos de sistemas externos. La capacidad del sistema que ejecuta estas tareas se puede escalar fácilmente agregando manejadores. Todo lo que nos queda es formar un clúster de manejadores y distribuir las tareas de manera uniforme entre ellos.
Analicemos escenarios surgiendo con 3 manejadores. Desde la etapa de distribución de tareas surge la cuestión de la justicia en la distribución y el desbordamiento de los manejadores. La justicia será garantizada por la distribución round-robin, y para evitar situaciones de desbordamiento de los manejadores, introduciremos un límite prefetch_limit. En modos transitorios, prefetch_limit no permitirá que un solo manejador reciba todas las tareas.
Messaging gestiona colas y la prioridad de procesamiento. Los manejadores reciben tareas a medida que llegan. La ejecución de una tarea puede finalizar con éxito o fracasar:
messaging:ack(Tack)‒ se llama en caso de procesamiento exitoso del mensaje,messaging:nack(Tack)‒ se llama en todas las situaciones anómalas. Después de devolver la tarea, messaging la transferirá a otro manejador.
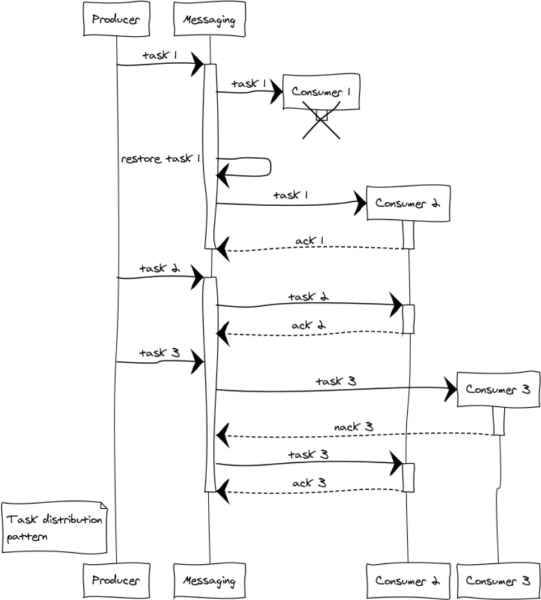
Supongamos que, al procesar tres tareas, ocurrió un fallo complejo: el manejador 1 se cayó después de recibir la tarea, sin poder notificar nada al punto de intercambio. En este caso, el punto de intercambio, tras expirar el tiempo de espera de ack, transferirá la tarea a otro manejador. El manejador 3, por alguna razón, rechazó la tarea y envió nack; en consecuencia, la tarea también pasó a otro manejador que la completó con éxito.
Conclusiones preliminares
Hemos analizado los bloques básicos de sistemas distribuidos y obtenido una comprensión básica de su aplicación en Erlang/Elixir.
Al combinar patrones básicos, se pueden construir paradigmas complejos para resolver las tareas que surgen.
En la parte final del ciclo, abordaremos cuestiones generales sobre la organización de servicios, enrutamiento y balanceo de carga, así como hablaremos sobre la parte práctica de la escalabilidad y la tolerancia a fallos de los sistemas.
Fin de la segunda parte.
Foto
Las ilustraciones fueron preparadas con websequencediagrams.com
Fuente: habr.com
