

Anuncio
Colegas, a mediados del verano planeo lanzar otro ciclo de artículos sobre el diseño de sistemas de servicio masivo: “Experimento VTrade” — un intento de escribir un marco para sistemas comerciales. En el ciclo se abordará la teoría y la práctica de la construcción de bolsas, subastas y tiendas. Al final del artículo, propongo votar por los temas que les parezcan más interesantes.
Este es el artículo final del ciclo sobre aplicaciones reactivas distribuidas en Erlang/Elixir. En se pueden encontrar los fundamentos teóricos de la arquitectura reactiva. ilustra los principales patrones y mecanismos para construir tales sistemas.
Hoy abordaremos cuestiones sobre el desarrollo de la base de código y los proyectos en general.
Organización de servicios
En la vida real, al desarrollar un servicio, a menudo es necesario combinar varios patrones de interacción en un solo controlador. Por ejemplo, el servicio de usuarios, que se encarga de gestionar los perfiles de los usuarios del proyecto, debe responder a solicitudes req-resp y comunicar actualizaciones de los perfiles a través de pub-sub. Este caso es bastante simple: un controlador gestiona la lógica del servicio y publica las actualizaciones.
La situación se complica cuando necesitamos implementar un servicio distribuido tolerante a fallos. Supongamos que los requisitos para los usuarios han cambiado:
- ahora el servicio debe manejar solicitudes en 5 nodos del clúster,
- tener la capacidad de ejecutar tareas en segundo plano,
- y también ser capaz de gestionar dinámicamente las listas de suscripción a las actualizaciones de los perfiles.
Nota: No abordamos la cuestión del almacenamiento consistente y la replicación de datos. Supongamos que estas cuestiones ya se han resuelto y que en el sistema ya existe una capa de almacenamiento confiable y escalable, y que los controladores tienen mecanismos para interactuar con ella.
La descripción formal del servicio de usuarios se ha complicado. Desde el punto de vista del programador, gracias al uso de mensajería, los cambios son mínimos. Para satisfacer el primer requisito, necesitamos configurar la balanceo en el punto de intercambio req-resp.
La necesidad de procesar tareas en segundo plano es común. En los usuarios, esto puede incluir verificaciones de documentos de los usuarios, procesamiento de multimedia cargada o sincronización de datos con redes sociales. Estas tareas deben ser distribuidas de alguna manera dentro del clúster y controlarse su progreso. Por ello, tenemos dos opciones: usar la plantilla de distribución de tareas del artículo anterior, o, si no es adecuada, escribir un programador de tareas personalizado que gestione el grupo de manejadores de la manera que necesitamos.
El punto 3 requiere ampliar la plantilla pub-sub. Y para implementarlo, tras la creación del punto de intercambio pub-sub, necesitamos iniciar adicionalmente el controlador de este punto dentro de nuestro servicio. Así, parece que estamos separando la lógica de procesamiento de las suscripciones y desuscripciones de la capa de mensajería a la implementación de usuarios.
Como resultado, la descomposición de la tarea mostró que para satisfacer los requisitos necesitamos lanzar 5 instancias del servicio en diferentes nodos y crear una entidad adicional: un controlador pub-sub, responsable de las suscripciones.
Para lanzar 5 manejadores no se requiere cambiar el código del servicio. La única acción adicional es la configuración de las reglas de balanceo en el punto de intercambio, de lo que hablaremos más adelante.
Además, surgió una complejidad adicional: el controlador pub-sub y el planificador de tareas personalizado deben funcionar en una única instancia. Nuevamente, el servicio de mensajería, como fundamental, debe proporcionar un mecanismo para elegir un líder.
Elección del líder
En sistemas distribuidos, la elección del líder es el procedimiento de designación de un único proceso encargado de planificar el procesamiento distribuido de alguna carga.
En sistemas que no tienden a la centralización, se utilizan algoritmos universales y algoritmos basados en consenso, como paxos o raft.
Dado que la mensajería es un corredor y un elemento central, conoce a todos los controladores del servicio que son candidatos a líderes. La mensajería puede designar un líder sin la necesidad de una votación.
Todos los servicios, tras su inicio y conexión al punto de intercambio, reciben un mensaje del sistema #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. En caso de que LeaderPid coincida con pid del proceso actual, se le designa como líder, y la lista Servers incluye todos los nodos y sus parámetros.
En el momento de la aparición de un nuevo nodo y la desconexión de un nodo en funcionamiento del clúster, todos los controladores del servicio reciben #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} y #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} correspondientemente.
De este modo, todos los componentes son conscientes de todos los cambios, y en el clúster hay garantizado un líder en cada momento.
Intermediarios
Para implementar procesos complejos de procesamiento distribuido, así como en tareas de optimización de arquitecturas existentes, es conveniente utilizar intermediarios.
Para no modificar el código de los servicios y resolver, por ejemplo, tareas de procesamiento adicional, enrutamiento o registro de mensajes, se puede incluir un manejador proxy delante del servicio, que realizará todo el trabajo adicional.
Un ejemplo clásico de optimización pub-sub es una aplicación distribuida con un núcleo comercial que genera eventos de actualización, como cambios en los precios del mercado, y una capa de acceso: N servidores que proporcionan API websocket para clientes web.
Si se aborda de manera directa, el servicio al cliente se ve de la siguiente manera:
- el cliente establece conexiones con la plataforma. En el lado del servidor, que termina el tráfico, se inicia el proceso que atiende esta conexión.
- en el contexto del proceso de atención se realiza la autorización y suscripción a actualizaciones. El proceso llama al método subscribe para los temas.
- después de que se genera un evento en el núcleo, se entrega a los procesos que atienden las conexiones.
Imaginemos que tenemos 50000 suscriptores para el tema "noticias". Los suscriptores están distribuidos uniformemente en 5 servidores. Como resultado, cada actualización, al llegar al punto de intercambio, será replicada 50000 veces: 10000 veces en cada servidor, según la cantidad de suscriptores en él. ¿No es una esquema algo ineficiente?
Para mejorar la situación, introduciremos un proxy que tenga el mismo nombre que el punto de intercambio. El registrador de nombres globales debe poder devolver el proceso más cercano por nombre, esto es importante.
Ejecutaremos este proxy en los servidores de la capa de acceso, y todos nuestros procesos que atienden la API websocket se suscribirán a él, y no al punto de intercambio pub-sub original en el núcleo. El proxy se suscribe al núcleo solo en caso de una suscripción única y replica el mensaje recibido a todos sus suscriptores.
Como resultado, entre el núcleo y los servidores de acceso se enviarán 5 mensajes, en lugar de 50000.
Enrutamiento y balanceo
Req-Resp
En la implementación actual de mensajería existen 7 estrategias de distribución de solicitudes:
default. La solicitud se envía a todos los controladores.round-robin. Se realiza un recorrido y distribución cíclica de las solicitudes entre los controladores.consenso. Los controladores que manejan el servicio se dividen en líder y seguidores. Las solicitudes se envían solo al líder.consenso & round-robin. En el grupo hay un líder, pero las solicitudes se distribuyen entre todos los miembros.sticky. Se calcula una función hash y se asocia a un manejador específico. Las solicitudes posteriores con esta firma se envían a este mismo manejador.sticky-fun. Al iniciar el punto de intercambio, se pasa adicionalmente una función para calcular el hash parastickybalanceo.fun. Es similar a sticky-fun, pero se pueden redirigir, rechazar o preprocesar adicionalmente.
La estrategia de distribución se establece al inicializar el punto de intercambio.
Además del balanceo, el messaging permite etiquetar entidades. Analicemos los tipos de etiquetas en el sistema:
- Etiqueta de conexión. Permite entender a través de qué conexión llegaron los eventos. Se utiliza cuando el proceso del controlador se conecta a un punto de intercambio, pero con diferentes claves de enrutamiento.
- Etiqueta de servicio. Permite agrupar manejadores para un único servicio y ampliar las capacidades de enrutamiento y balanceo. Para el patrón req-resp, el enrutamiento es lineal. Enviamos una solicitud al punto de intercambio, luego lo transmite al servicio. Pero si necesitamos dividir los manejadores en grupos lógicos, la división se realiza mediante etiquetas. Al especificar una etiqueta, la solicitud se dirigirá a un grupo específico de controladores.
- Etiqueta de solicitud. Permite distinguir las respuestas. Dado que nuestro sistema es asincrónico, para procesar las respuestas del servicio necesitamos la capacidad de especificar el RequestTag al enviar la solicitud. Por ello, podremos identificar a qué solicitud corresponde la respuesta que hemos recibido.
Pub-sub
Para pub-sub es un poco más simple. Tenemos un punto de intercambio al que se publican mensajes. El punto de intercambio distribuye mensajes entre los suscriptores que se han suscrito a las claves de enrutamiento que les interesan (se puede decir que es análogo a los temas).
Escalabilidad y tolerancia a fallos
La escalabilidad del sistema en su conjunto depende del grado de escalabilidad de las capas y componentes del sistema:
- Los servicios se escalan añadiendo nodos adicionales con manejadores de este servicio al clúster. Durante la operación práctica, se puede elegir la política de balanceo óptima.
- El propio servicio de mensajería, en el contexto de un clúster separado, generalmente se escala ya sea trasladando puntos de intercambio con alta carga a nodos separados del clúster, o añadiendo procesos proxy en zonas especialmente sobrecargadas del clúster.
- La escalabilidad de todo el sistema como característica depende de la flexibilidad de la arquitectura y de la capacidad de integrar clústeres individuales en una entidad lógica común.
La simplicidad y rapidez de escalado a menudo determina el éxito del proyecto. La mensajería en la implementación actual crece junto con la aplicación. Incluso si no contamos con un clúster de 50-60 máquinas, se puede recurrir a la federación. Desafortunadamente, el tema de la federación está más allá del alcance de este artículo.
Redundancia
Al analizar el balanceo de carga, ya discutimos la redundancia de los controladores de servicios. Sin embargo, la mensajería también debe estar reservada. En caso de caída de un nodo o máquina, la mensajería debe recuperarse automáticamente en el menor tiempo posible.
En mis proyectos, utilizo nodos adicionales que asumen la carga en caso de caída. En Erlang, existe una implementación estándar de modo distribuido para aplicaciones OTP. El modo distribuido se encarga de la recuperación en caso de falla iniciando la aplicación caída en otro nodo previamente en funcionamiento. El proceso es transparente; tras el fallo, la aplicación se traslada automáticamente al nodo de failover. Puedes leer más sobre esta funcionalidad. .
Rendimiento
Intentemos comparar al menos de manera aproximada el rendimiento de rabbitmq y nuestro sistema de mensajería personalizado.
He encontrado de pruebas de rabbitmq del equipo de openstack.
En el apartado 6.14.1.2.1.2.2. del documento original se presenta el resultado de RPC CAST:
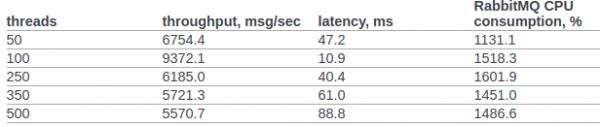
Previamente, no realizaremos ninguna configuración adicional en el núcleo del sistema operativo o en la máquina virtual de Erlang. Las condiciones para las pruebas son:
- erl opts: +A1 +sbtu.
- La prueba en el ámbito de un solo nodo de Erlang se ejecuta en un portátil con un viejo i7 en una configuración móvil.
- Las pruebas de clúster se realizan en servidores con red de 10G.
- El código funciona en contenedores Docker. La red está en modo NAT.
Código de la prueba:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Escenario 1: La prueba se ejecuta en un portátil con un viejo i7 de móvil. La prueba, el mensajería y el servicio se ejecutan en un solo nodo dentro de un contenedor Docker:
Ciclos secuenciales de 10000 en ~0 segundos (26987 ciclos/s)
Ciclos secuenciales de 20000 en ~1 segundos (26915 ciclos/s)
Ciclos secuenciales de 100000 en ~4 segundos (26957 ciclos/s)
Paralelo 2 ciclos de 100000 en ~2 segundos (44240 ciclos/s)
Paralelo 4 ciclos de 100000 en ~2 segundos (53459 ciclos/s)
Paralelo 10 ciclos de 100000 en ~2 segundos (52283 ciclos/s)
Paralelo 100 ciclos de 100000 en ~3 segundos (49317 ciclos/s)
Escenario 2: 3 nodos ejecutándose en diferentes máquinas bajo Docker (NAT).
Ciclos secuenciales de 10000 en ~1 segundos (8684 ciclos/s)
Ciclos secuenciales de 20000 en ~2 segundos (8424 ciclos/s)
Ciclos secuenciales de 100000 en ~12 segundos (8655 ciclos/s)
Paralelo 2 ciclos de 100000 en ~7 segundos (15160 ciclos/s)
Paralelo 4 ciclos de 100000 en ~5 segundos (19133 ciclos/s)
Paralelo 10 ciclos de 100000 en ~4 segundos (24399 ciclos/s)
Paralelo 100 ciclos de 100000 en ~3 segundos (34517 ciclos/s)
En todos los casos, la utilización de CPU no superó el 250%
Resultados
Espero que este ciclo no se parezca a un volcado de conciencia y que mi experiencia brinde un verdadero beneficio tanto a los investigadores de sistemas distribuidos como a los profesionales que se encuentran al inicio de la construcción de arquitecturas distribuidas para sus sistemas empresariales y que observan con interés a Erlang/Elixir, pero se preguntan si vale la pena...
Foto
Solo los usuarios registrados pueden participar en la encuesta. , por favor.
¿Qué temas debería abordar con más detalle en el ciclo "Experimento VTrade"?
Teoría: Mercados, órdenes y su vigencia: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Libro de órdenes. Teoría y práctica de la implementación del libro con agrupaciones
Visualización de operaciones: Ticks, barras, resoluciones. Cómo almacenar y cómo unir
Backoffice. Planificación y desarrollo. Control de empleados e investigación de incidentes
API. Analizamos qué interfaces son necesarias y cómo implementarlas
Almacenamiento de información: PostgreSQL, Timescale, Tarantool en sistemas de comercio
Reactividad en sistemas de comercio
Otro. Escribiré en los comentarios
Votaron 6 usuarios. 4 usuarios se abstuvieron.
Fuente: habr.com
