

Introducción
En este artículo, hablaré sobre el conocido algoritmo de Huffman y su aplicación en la compresión de datos.
Como resultado, escribiremos un archivador simple. Ya se ha escrito pero sin implementación práctica. El material teórico de este post proviene de las clases de informática en la escuela y del libro de Robert Lafore «Estructuras de Datos y Algoritmos en Java». ¡Así que vamos al grano!
Unas reflexiones
En un archivo de texto normal, un carácter se codifica en 8 bits (codificación ASCII) o 16 (codificación Unicode). A continuación, consideraremos la codificación ASCII. Por ejemplo, tomemos la cadena s1 = «SUSIE SAYS IT IS EASYn». Hay un total de 22 caracteres en la cadena, incluyendo espacios y el salto de línea — ‘n’. Un archivo que contenga esta cadena pesará 22*8 = 176 bits. Inmediatamente surge la pregunta: ¿es racional utilizar todos los 8 bits para codificar 1 carácter? Porque no usamos todos los caracteres de la codificación ASCII. Incluso si lo hiciéramos, sería más racional dar el código más corto posible al carácter más frecuente — S — y un código más largo al carácter menos frecuente — T (o U, o ‘n’). Y eso es precisamente lo que hace el algoritmo de Huffman: encontrar la opción óptima de codificación que minimice el peso del archivo. Es completamente normal que diferentes caracteres tengan longitudes de código distintas — y sobre eso se basa el algoritmo.
Codificación
¿Por qué no darle al carácter ‘S’ un código, por ejemplo, de 1 bit: 0 o 1? Supongamos que sea 1. Entonces le daríamos 0 al segundo carácter más frecuente — ‘ ‘ (espacio). Imagínese que comienza a decodificar su mensaje — la cadena codificada s1 — y ve que el código comienza con 1. Entonces, ¿qué debe hacer: es el carácter S, o es algún otro carácter, como A? Por lo tanto, surge una regla importante:
Ningún código debe ser un prefijo de otro.
Esta regla es clave en el algoritmo. Por lo tanto, la creación de código comienza con una tabla de frecuencias, que indica la frecuencia (número de ocurrencias) de cada carácter:
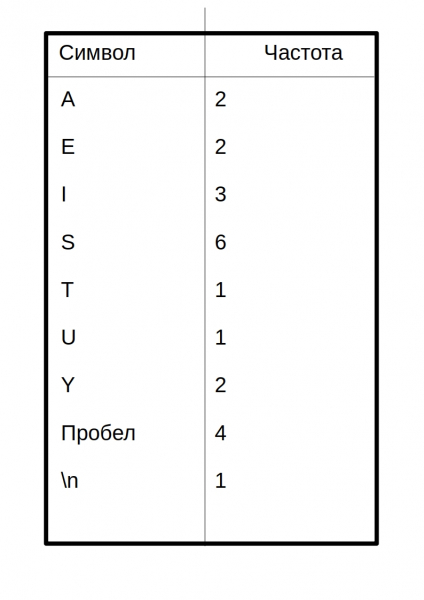 Los caracteres con el mayor número de ocurrencias deben ser codificados con la menor cantidad posible de bits. Permítame presentar un ejemplo de una posible tabla de códigos:
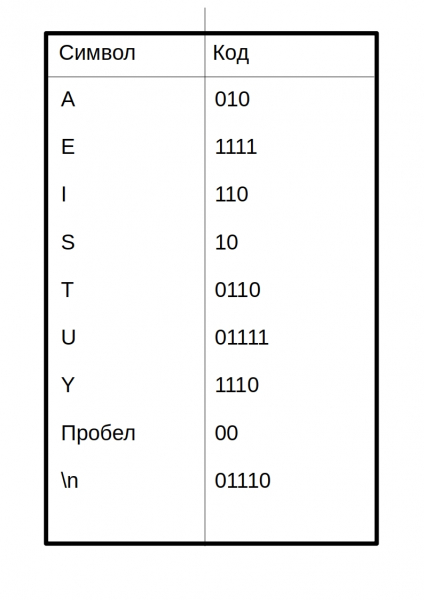 Así, el mensaje codificado se verá así:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 El código de cada carácter lo he separado con un espacio. En un archivo comprimido real, esto no estará así.
Surge la pregunta: ¿cómo este novato ideó el código para crear una tabla de códigos? De esto se hablará a continuación.
Construcción del árbol de Huffman
Aquí es donde los árboles de búsqueda binarios entran en juego. No se preocupen, no se necesitarán métodos de búsqueda, inserción y eliminación. Aquí está la estructura del árbol en Java:
public class Node {
    private int frequence;
    private char letter;
    private Node leftChild;
    private Node rightChild;
    ...
}
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }
    public BinaryTree(Node root) {
        this.root = root;
    }
    ...
}
Este no es el código completo, el código completo estará más abajo.
Aquí está el algoritmo para construir el árbol:
- Crear un objeto Node para cada símbolo del mensaje (cadena s1). En nuestro caso habrá 9 nodos (objetos Node). Cada nodo consta de dos campos de datos: símbolo y frecuencia.
- Crear un objeto de Árbol (BinaryTree) para cada uno de los nodos Node. El nodo se convierte en la raíz del árbol.
- Insertar estos árboles en una cola de prioridad. Cuanto menor sea la frecuencia, mayor será la prioridad. Así, al extraer, siempre se elige el árbol de menor frecuencia.
A continuación, se debe hacer lo siguiente de forma cíclica:
- Extraer dos árboles de la cola de prioridad y hacerlos hijos de un nuevo nodo (el nuevo nodo recién creado sin letra). La frecuencia del nuevo nodo es la suma de las frecuencias de los dos árboles hijos.
- Para este nodo crear un árbol con raíz en este nodo. Insertar este árbol de nuevo en la cola de prioridad. (Dado que el árbol tiene una nueva frecuencia, es probable que ocupe un nuevo lugar en la cola).
- Continuar llevando a cabo los pasos 1 y 2, hasta que no quede más que un árbol en la cola: el árbol de Huffman.
Examinemos este algoritmo en la cadena s1:
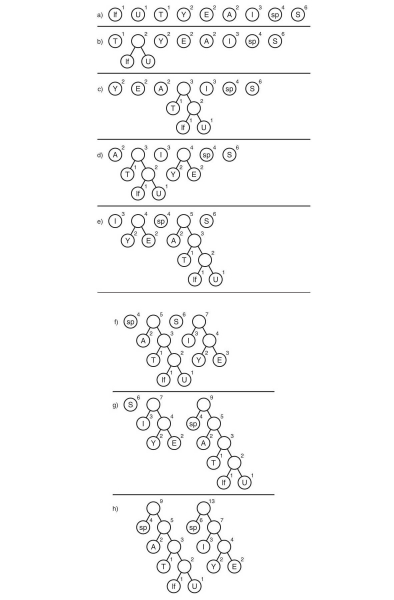
Aquí el símbolo 'lf' (linefeed) indica un salto de línea, mientras que 'sp' (space) es un espacio.
¿Y ahora qué?
Hemos obtenido el árbol de Huffman. Bueno, está bien. ¿Y qué hacemos con él? Ni siquiera lo quieren gratis. A continuación, necesitamos rastrear todos los posibles caminos desde la raíz hasta las hojas del árbol. Convengamos en denominar un borde como 0, si lleva al hijo izquierdo, y 1 — si lleva al derecho. Estrictamente hablando, en estas denotaciones, el código del símbolo es el camino desde la raíz del árbol hasta la hoja que contiene dicho símbolo.
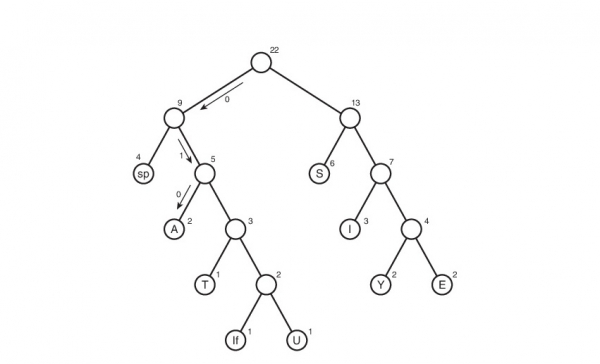
De esta manera, tenemos la tabla de códigos. Notemos que si examinamos esta tabla, podemos concluir sobre el "peso" de cada símbolo: es la longitud de su código. Así, en forma comprimida, el archivo original pesará: 2 * 3 + 2 * 4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bits. Al principio pesaba 176 bits. Por lo tanto, lo hemos reducido a 176/65 = 2.7 veces. ¡Pero esto es utopía! Es poco probable que se obtenga tal coeficiente. ¿Por qué? De esto hablaré más adelante.
Decodificación
Bueno, lo que queda es lo más sencillo: la decodificación. Creo que muchos de ustedes ya han deducido que no se puede simplemente crear un archivo comprimido sin pistas sobre cómo fue codificado; ¡no podremos decodificarlo! Sí, me costó asumirlo, pero tendré que crear un archivo de texto llamado table.txt con la tabla de compresión:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Escribimos la tabla en forma de 'símbolo'«código del símbolo». ¿Por qué 01110 sin símbolo? En realidad, lo tiene; simplemente, las herramientas de Java que estoy usando para escribir en el archivo convierten el carácter de nueva línea 'n' en un salto de línea (por más absurdo que suene). Por lo tanto, la línea vacía en la parte superior es el símbolo para el código 01110. Para el código 00, el símbolo es un espacio al principio de la línea. De inmediato diré que este método de almacenamiento de la tabla puede ser el menos racional. Pero es fácil de entender y de implementar. Estoy encantado de escuchar sus recomendaciones en los comentarios sobre la optimización.
Con esta tabla, es muy sencillo decodificar. Recordemos la regla que seguimos al crear la codificación:
Ningún código debe ser un prefijo de otro
Aquí es donde juega un papel facilitador. Leemos secuencialmente bit a bit y, tan pronto como la cadena d, compuesta por los bits leídos, coincide con la codificación correspondiente al símbolo character, sabemos de inmediato que se ha codificado el símbolo character (y solo él). Luego escribimos character en la cadena de decodificación (la cadena que contiene el mensaje decodificado), reiniciamos la cadena d y seguimos leyendo el archivo codificado.
Implementación
Ha llegado el momento de humillar mi código escribiendo un compresor. Lo llamaremos Compressor.
Empezaremos desde el principio. Primero, escribiremos la clase Node:
clase pública Node {
    privado int frecuencia; // frecuencia
    privado char letra; // letra
    privado Node hijoIzquierdo; // hijo izquierdo
    privado Node hijoDerecho; // hijo derecho


    public Node(char letra, int frecuencia) { // en realidad, constructor
        this.letra = letra;
        this.frecuencia = frecuencia;
    }

    public Node() {} // sobrecarga del constructor para nodos sin nombre (ver arriba en la sección sobre la construcción del árbol de Huffman)
    public void addChild(Node nuevoNodo) { // agregar hijo
        if (hijoIzquierdo == null) // si el izquierdo está vacío => derecho también => agregar al izquierdo
            hijoIzquierdo = nuevoNodo;
        else {
            if (hijoIzquierdo.getFrequence() <= nuevoNodo.getFrequence()) // en general, hijo izquierdo
                hijoDerecho = nuevoNodo; // se convertirá en el que tenga menor frecuencia
            else {
                hijoDerecho = hijoIzquierdo;
                hijoIzquierdo = nuevoNodo;
            }
        }

        frecuencia += nuevoNodo.getFrequence(); // frecuencia total
    }

    public Node getLeftChild() {
        return hijoIzquierdo;
    }

    public Node getRightChild() {
        return hijoDerecho;
    }

    public int getFrequence() {
        return frecuencia;
    }

    public char getLetter() {
        return letra;
    }

    public boolean isLeaf() { // comprobación de hoja
        return hijoIzquierdo == null && hijoDerecho == null;
    }
}
Ahora el árbol:
clase BinaryTree {
    privado Node raiz;

    public BinaryTree() {
        raiz = new Node();
    }

    public BinaryTree(Node raiz) {
        this.raiz = raiz;
    }

    public int getFrequence() {
        return raiz.getFrequence();
    }

    public Node getRoot() {
        return raiz;
    }
}
Cola de prioridad:
importar java.util.ArrayList; // sí, sí, la cola será basada en una lista

clase PriorityQueue {
    privado ArrayList datos; // lista de cola
    privado int nElems; // cantidad de elementos en la cola

    public PriorityQueue() {
        datos = new ArrayList();
        nElems = 0;
    }

    public void insert(BinaryTree nuevoArbol) { // inserción
        if (nElems == 0)
            datos.add(nuevoArbol);
        else {
            for (int i = 0; i  nuevoArbol.getFrequence()) { // si la frecuencia del árbol insertado es menor
                    datos.add(i, nuevoArbol); // que la del actual, desplazamos todos los árboles en posiciones a la derecha una celda
                    break; // luego colocamos el nuevo árbol en la posición del actual
                }
                if (i == nElems - 1)
                    datos.add(nuevoArbol);
            }
        }
        nElems++; // incrementamos la cantidad de elementos en 1
    }

    public BinaryTree remove() { // eliminación de la cola
        BinaryTree tmp = datos.get(0); // copiamos el elemento a eliminar
        datos.remove(0); // en realidad, eliminamos
        nElems--; // reducimos la cantidad de elementos en 1
        return tmp; // devolvemos el elemento eliminado (el elemento con menor frecuencia)
    }
}
Clase que crea el árbol de Huffman:
public class HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127; // longitud de la tabla de codificación
    private String myString; // mensaje
    private BinaryTree huffmanTree; // árbol de Huffman
    private int[] freqArray; // tabla de frecuencias
    private String[] encodingArray; // tabla de codificación


    //----------------constructor----------------------
    public HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    //--------------------frequence array------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    //------------------------huffman tree creation------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // algoritmo descrito arriba
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) { // si el símbolo existe en la cadena
                Node newNode = new Node((char) i, freqArray[i]); // entonces crear un Node para él
                BinaryTree newTree = new BinaryTree(newNode); // y para el Node crear un BinaryTree
                pq.insert(newTree); // insertar en la cola
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove(); // extraer el primer árbol de la cola.

            try {
                BinaryTree tree2 = pq.remove(); // extraer el segundo árbol de la cola

                Node newNode = new Node(); // crear un nuevo Node
                newNode.addChild(tree1.getRoot()); // hacer que los dos árboles extraídos sean sus hijos
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode);
            } catch (IndexOutOfBoundsException e) { // queda un árbol en la cola
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    //-------------------encoding array------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // llenar la tabla de codificación
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() { // para depuración
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Tabla de codificación====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    //-----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
Clase que contiene la que codifica/decodifica:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; // longitud de la tabla
    private HuffmanTree mainHuffmanTree; // árbol de Huffman (utilizado solo para compresión)
    private String myString; // mensaje original
    private int[] freqArray; // tabla de frecuencias
    private String[] encodingArray; // tabla de codificación
    private double ratio; // relación de compresión


    public HuffmanOperator(HuffmanTree MainHuffmanTree) { // para comprimir
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} // para extraer;

    //---------------------------------------compresión-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; // cadena intermedia (sin ceros adicionales)
        // System.out.println("=============================Compresión=======================");
        // displayEncodingArray();
        for (int i = 0; i
        // necesitamos agregar ceros al final (se puede agregar 1, no hay diferencia)
        byte counter = 0; // cantidad de ceros añadidos al final (1 byte es suficiente: 0 <= counter < 8 < 127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
                counter < delta ; counter++) { // delta - cantidad de ceros añadidos
            intermidiate += "0";
        }

        // concatenar la cantidad de ceros adicionales en representación binaria y la cadena intermedia
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        // relación idealizada
        setCompressionRatio();
        // System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { // calcular la relación idealizada
        double sumA = 0, sumB = 0; // A - la suma original
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { // compresión final
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    //---------------------------------------fin de la compresión----------------------------------------------------------------
    //------------------------------------------------------------extraer-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        // displayEncodingArray();
        // obtener la cantidad de ceros añadidos
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            // i = 8, ya que el primer byte contiene la cantidad de ceros añadidos
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { // si coincide
                    decompressed += (char)j; // entonces agregamos el elemento
                    current = ""; // y reiniciamos la cadena actual
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char)i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { // para depuración
        System.out.println("======================Tabla de codificación====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            // if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            // }
        }
        System.out.println("========================================================");
    }
}
Clase que facilita la escritura en un archivo:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("¡Ruta incorrecta o el archivo no existe!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Clase que facilita la lectura desde un archivo:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) // si el archivo ha terminado
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
Y la clase principal:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { // Especificamos la instrucción a través de los argumentos de la línea de comandos
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Formato de entrada de argumentos no válido ");
            System.out.println("Lea Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Ruta no válida o el archivo no existe!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("La codificación actual del archivo no es compatible");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        // Crear archivo con la tabla de codificación:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Ruta al archivo comprimido: " + compressedFile.getAbsolutePath());
        System.out.println("Ruta a la tabla de codificación " + table.getAbsolutePath());
        System.out.println("¡Sin la tabla, no se podrá extraer el archivo!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; // Coeficiente idealizado
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; // Coeficiente real

        System.out.println("El coeficiente idealizado de compresión es " + idealRatio);
        System.out.println("El coeficiente de compresión teniendo en cuenta la tabla de codificación " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        // Leer archivo comprimido
        // !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! Verifique aquí:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); // el método devuelve EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        // --------------------

        // Leer tabla de codificación:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); // saltar la primera cadena vacía
        	encodingArray[(byte)'n'] = fi.readLine(); // leer el código para 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        // Extracción:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Ruta al archivo descomprimido " + extractedFile.getAbsolutePath());
    }
}
Usted deberá escribir el archivo de instrucciones readme.txt usted mismo 🙂
Conclusión
Probablemente, eso es todo lo que quería decir. Si tiene algo que comentar sobre mi falta de competencia en las mejoras del código, el algoritmo o cualquier optimización, no dude en escribir. Si hay algo que no expliqué lo suficiente, también hágamelo saber. ¡Estaré encantado de escucharlo en los comentarios!
P.D.
Sí, sí, todavía estoy aquí, porque no me olvidé del coeficiente. Para la cadena s1, la tabla de codificación pesa 48 bytes, mucho más que el archivo original, y tampoco olvidamos los ceros adicionales (la cantidad de ceros añadidos es 7) ⇒ el coeficiente de compresión será menor que uno: 176/(65 + 48*8 + 7)=0.38. Si usted también notó esto, bien hecho, no se lo tomó a mal. Sí, esta implementación será extremadamente ineficiente para archivos pequeños. Pero, ¿qué sucede con archivos grandes? ¡Los tamaños de los archivos superan con creces el tamaño de la tabla de codificación! ¡Aquí es donde el algoritmo realmente funciona bien! Por ejemplo, para el compresor da un coeficiente real (no idealizado) igual a 1.46, ¡casi una vez y media más! Y sí, se suponía que el archivo estaría en inglés.
Fuente: habr.com
