

¡Buenos días! Me llamo Danil Lipovoy y nuestro equipo en Sbertech ha comenzado a utilizar HBase como almacén de datos en tiempo real. A lo largo de su estudio, hemos acumulado experiencia que nos gustaría sistematizar y describir (esperamos que sea útil para muchos). Todos los experimentos mencionados a continuación se realizaron con las versiones HBase 1.2.0-cdh5.14.2 y 2.0.0-cdh6.0.0-beta1.
- Arquitectura general
- Escritura de datos en HBASE
- Lectura de datos de HBASE
- Caché de datos
- Procesamiento por lotes de datos MultiGet/MultiPut
- Estrategia de partición de tablas en regiones (splitting)
- Tolerancia a fallos, compactación y localización de datos
- Configuraciones y rendimiento
- Pruebas de carga
- Conclusiones
1. Arquitectura general
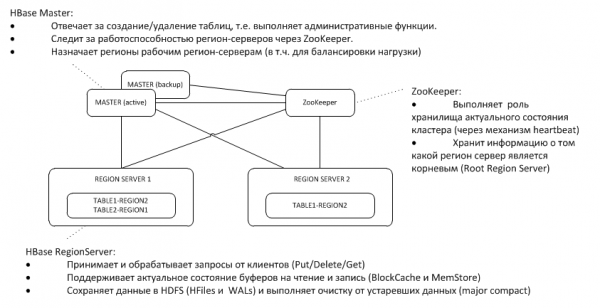
El Master de respaldo escucha el heartbeat del activo en el nodo de ZooKeeper y, en caso de que el activo desaparezca, toma las funciones del maestro.
2. Escritura de datos en HBASE
Primero, consideremos el caso más simple: escribir un objeto clave-valor en una tabla utilizando put(rowkey). El cliente debe averiguar primero dónde se encuentra el servidor de región raíz (Root Region Server — RRS), que almacena la tabla hbase:meta. Esta información la obtiene de ZooKeeper. Luego, se dirige a RRS y lee la tabla hbase:meta, de la cual extrae información sobre qué RegionServer (RS) es responsable de almacenar los datos para la clave rowkey en la tabla de interés. Para un uso posterior, el cliente almacena en caché la meta-tabla y, por lo tanto, las solicitudes subsecuentes son más rápidas, y van directamente a RS.
Luego, el RS, al recibir la solicitud, primero la escribe en el WriteAheadLog (WAL), lo que es necesario para la recuperación en caso de fallo. Luego guarda los datos en MemStore. Este es un búfer en memoria que contiene un conjunto ordenado de claves de esa región. La tabla puede estar dividida en regiones (particiones), cada una de las cuales contiene un conjunto de claves no superpuestas. Esto permite, al ubicar las regiones en diferentes servidores, obtener un mayor rendimiento. Sin embargo, a pesar de la obviedad de esta afirmación, más adelante veremos que esto no funciona en todos los casos.
Después de colocar el registro en MemStore, el cliente recibe una respuesta indicando que el registro se ha guardado correctamente. Sin embargo, en realidad, solo se almacena en el búfer y se almacenará en el disco solo después de que haya transcurrido un cierto intervalo de tiempo o al llenarlo con nuevos datos.
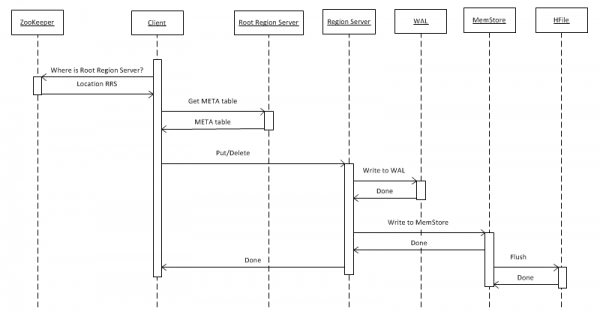
Al realizar la operación «Eliminar», no se produce la eliminación física de los datos. Simplemente se marcan como eliminados, y la destrucción real ocurre en el momento en que se llama a la función major compact, sobre la cual se detalla más en el punto 7.
Los archivos en formato HFile se acumulan en HDFS y de vez en cuando se inicia el proceso minor compact, que simplemente une archivos pequeños en uno más grande, sin eliminar nada. Con el tiempo, esto se convierte en un problema que se manifiesta solo al leer los datos (volveremos a esto más adelante).
Además del proceso de carga descrito anteriormente, hay un procedimiento mucho más eficiente, que representa quizás la mayor fortaleza de esta base de datos: BulkLoad. Consiste en que nosotros mismos formamos HFiles y los colocamos en el disco, lo que permite una excelente escalabilidad y alcanzar velocidades bastante razonables. De hecho, aquí la limitación no es HBase, sino la capacidad del hardware. A continuación, se presentan los resultados de carga en un clúster compuesto por 16 RegionServers y 16 NodeManager YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 hilos), versión HBase 1.2.0-cdh5.14.2.
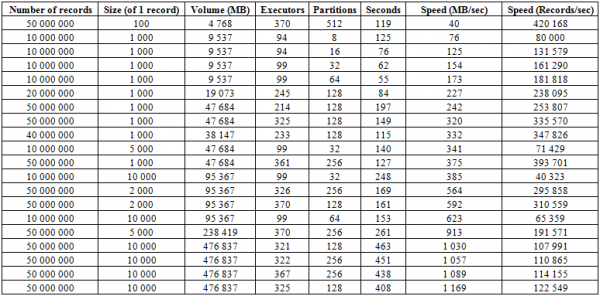
Aquí se observa que al aumentar la cantidad de particiones (regiones) en la tabla, así como los ejecutores de Spark, se obtiene un incremento en la velocidad de carga. Además, la velocidad depende del volumen de las escrituras. Los bloques grandes dan un aumento en la medida de MB/s, mientras que los pequeños aumentan el número de registros insertados por unidad de tiempo, manteniendo todo lo demás constante.
También se puede iniciar la carga en dos tablas simultáneamente y obtener el doble de velocidad. A continuación se muestra que la escritura de bloques de 10 KB simultáneamente en dos tablas se realiza a una velocidad de alrededor de 600 MB/s en cada una (un total de 1275 MB/s), lo que coincide con la velocidad de escritura en una tabla de 623 MB/s (ver nº 11 arriba).
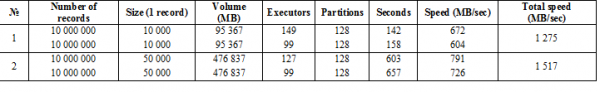
Por otro lado, el segundo lanzamiento con escrituras de 50 KB muestra que la velocidad de carga ya no crece significativamente, lo que indica que se está acercando a los valores limites. Sin embargo, es importante tener en cuenta que la carga de trabajo en HBASE es prácticamente nula, todo lo que se requiere es que primero entregue los datos de hbase:meta, y después, al colocar los HFiles, vacíe los datos de BlockCache y guarde el buffer MemStore en disco, si no está vacío.
3. Lectura de datos desde HBASE
Si se considera que toda la información de hbase:meta ya está en posesión del cliente (ver p.2), la solicitud se envía inmediatamente al RS que almacena la clave necesaria. Primero, la búsqueda se lleva a cabo en MemCache. Independientemente de si hay datos allí o no, la búsqueda también se realiza en el búfer BlockCache y, si es necesario, en HFiles. Si los datos se encuentran en el archivo, se colocan en BlockCache y en la siguiente solicitud se devolverán más rápido. La búsqueda en HFile se realiza relativamente rápido gracias al uso del filtro de Bloom, es decir, al leer un pequeño volumen de datos, se determina de inmediato si este archivo contiene la clave necesaria y, si no, se pasa al siguiente.
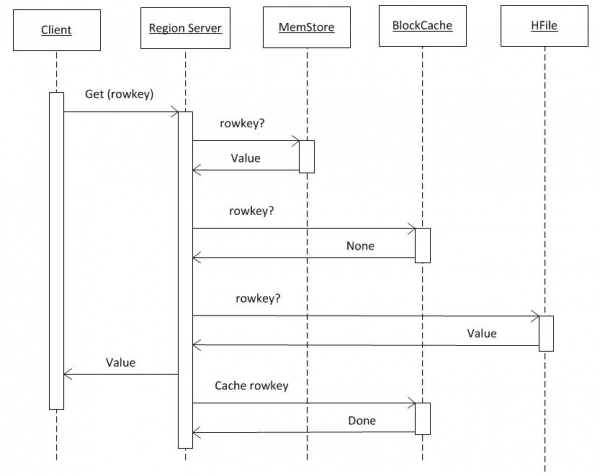
Al recibir datos de estas tres fuentes, el RS forma la respuesta. En particular, puede enviar varias versiones encontradas del objeto si el cliente solicita versionado.
4. Cacheo de datos
Los búferes MemStore y BlockCache ocupan hasta el 80% de la memoria on-heap asignada al RS (el resto se reserva para tareas de servicio del RS). Si el modo típico de uso es tal que los procesos escriben y luego leen esos mismos datos, tiene sentido reducir BlockCache y aumentar MemStore, ya que al escribir los datos no entran en el caché de lectura, lo que hará que el uso de BlockCache sea menos frecuente. El búfer BlockCache consta de dos partes: LruBlockCache (siempre on-heap) y BucketCache (generalmente off-heap o en SSD). Se debe utilizar BucketCache cuando hay muchas solicitudes de lectura que no caben en LruBlockCache, lo que lleva a una actividad intensa del Garbage Collector. Sin embargo, no se debe esperar un aumento radical en el rendimiento por el uso del caché de lectura, aunque volveremos a esto en la p. 8.
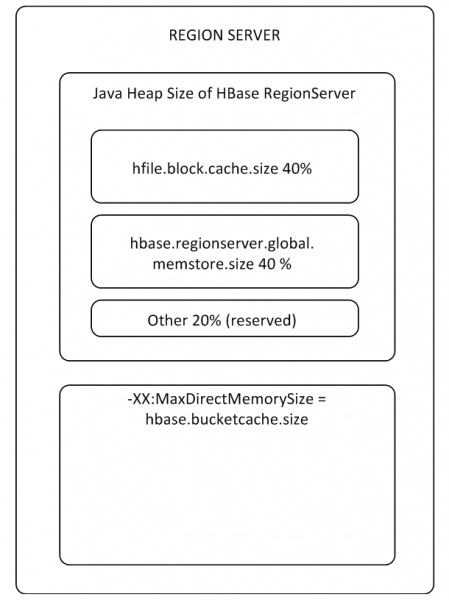
BlockCache es único para todo el RS, mientras que MemStore es único para cada tabla (uno por cada Family de Columnas).
¿Cómo en teoría, al escribir, los datos no van al caché y de hecho, estos parámetros CACHE_DATA_ON_WRITE para la tabla y 'Cache DATA on Write' para el RS están configurados en false. Sin embargo, en la práctica, si se escriben datos en MemStore, luego se vacía en disco (limpiándolo de esta manera), luego se elimina el archivo resultante, al ejecutar una solicitud get obtendremos los datos con éxito. Y lo que es más, incluso si se desactiva completamente BlockCache y se llena la tabla con nuevos datos, luego se logra el vaciado de MemStore en disco, al eliminarlos y solicitarlos desde otra sesión, aún se extraerán de alguna parte. Así que HBase almacena no solo datos, sino también misterios intrigantes.
hbase(main):001:0> crear 'ns:magic', 'cf'
Tabla ns:magic creada
Tardó 1.1533 segundos
hbase(main):002:0> poner 'ns:magic', 'key1', 'cf:c', 'intenta_borrarme'
Tardó 0.2610 segundos
hbase(main):003:0> vaciar 'ns:magic'
Tardó 0.6161 segundos
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> obtener 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, valor=intenta_borrarme
El parámetro «Cache DATA on Read» está configurado en falso. Si tienes ideas, bienvenido a discutirlo en los comentarios.
5. Procesamiento en lote de datos MultiGet/MultiPut
El procesamiento de solicitudes individuales (Get/Put/Delete) es una operación bastante costosa, por lo que se deben agrupar siempre que sea posible en List o List, lo que permite obtener un aumento significativo en el rendimiento. Especialmente se refiere a la operación de escritura, mientras que en la lectura existe una trampa. En el gráfico a continuación se muestra el tiempo de lectura de 50,000 registros desde MemStore. La lectura se realizó en un solo hilo y en el eje horizontal se muestra la cantidad de claves en la solicitud. Se observa que al aumentar hasta mil claves en una solicitud, el tiempo de ejecución disminuye, es decir, la velocidad aumenta. Sin embargo, con el modo MSLAB habilitado por defecto, después de este umbral se produce un drástico descenso en el rendimiento, y cuanto mayor sea el volumen de datos en el registro, mayor será el tiempo de ejecución.
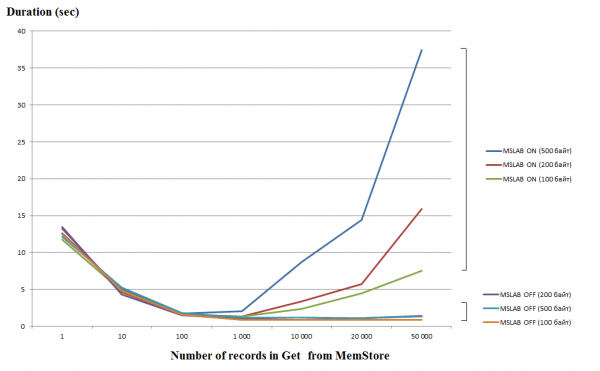
Las pruebas se realizaron en una máquina virtual, 8 núcleos, versión HBase 2.0.0-cdh6.0.0-beta1.
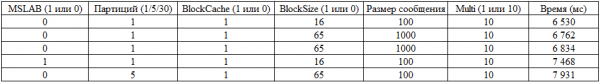
El modo MSLAB está diseñado para reducir la fragmentación del heap, que ocurre debido a la mezcla de datos de generaciones nuevas y viejas. Como solución al problema, al habilitar MSLAB, los datos se colocan en celdas (chunks) relativamente pequeñas y se procesan en lotes. Como resultado, cuando el volumen en el paquete de datos solicitado supera el tamaño asignado, la rendimiento disminuye drásticamente. Por otro lado, desactivar este modo también es indeseable, ya que conducirá a interrupciones debido a GC en momentos de intensa actividad con datos. Una buena salida es aumentar el tamaño de la celda, en caso de escritura activa a través de put al mismo tiempo que la lectura. Cabe señalar que el problema no surge si después de escribir se ejecuta el comando flush que vacía MemStore en el disco o si se realiza la carga mediante BulkLoad. En la tabla a continuación se muestra que las solicitudes desde MemStore de datos de mayor volumen (y igual cantidad) conducen a un descenso en la velocidad. Sin embargo, al aumentar el chunksize, se devuelve el tiempo de procesamiento a la normalidad.
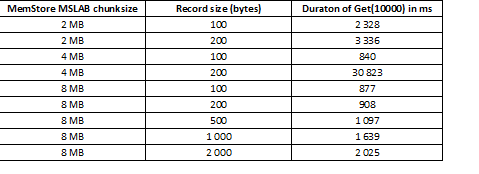
Además de aumentar el chunksize, ayuda dividir los datos por regiones, es decir, hacer el spliteo de tablas. Esto hace que para cada región lleguen menos solicitudes y, si se colocan en una celda, la respuesta se mantiene buena.
6. Estrategia de división de tablas por regiones (spliteo)
Dado que HBase es un almacenamiento de clave-valor y la partición se realiza por clave, es crucial distribuir los datos de manera uniforme entre todas las regiones. Por ejemplo, la partición de una tabla de este tipo en tres partes dará lugar a que los datos se dividan en tres regiones:
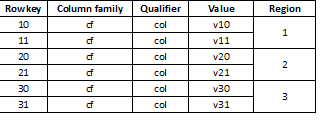
A veces, esto puede llevar a una ralentización drástica si los datos futuros cargados son, por ejemplo, valores long que en su mayoría comienzan con el mismo dígito, por ejemplo:
1000001
1000002
…
1100003
Dado que las claves se almacenan como un array de bytes, todas comenzarán igual y pertenecerán a una región #1 que almacena este rango de claves. Existen varias estrategias de división:
HexStringSplit – Convierte la clave en una cadena con codificación hexadecimal en el rango «00000000» => «FFFFFFFF» y rellenando a la izquierda con ceros.
UniformSplit – Convierte la clave en un array de bytes con codificación hexadecimal en el rango «00» => «FF» y rellenando a la derecha con ceros.
Además, se puede especificar cualquier rango o conjunto de claves para la división y configurar el auto-spliteo. Sin embargo, uno de los enfoques más simples y efectivos es UniformSplit y la concatenación del hash, por ejemplo, el par de bytes más significativos de ejecutar la clave a través de la función CRC32(rowkey) y, efectivamente, la rowkey:
hash + rowkey
Entonces todos los datos se distribuirán uniformemente entre las regiones. Al leer, simplemente se desechan los primeros dos bytes y queda la clave original. Además, el RS controla la cantidad de datos y claves en la región y, al superar los límites, automáticamente lo divide en partes.
7. Tolerancia a fallos y localización de datos
Dado que cada conjunto de claves solo está a cargo de una región, la solución a los problemas relacionados con las caídas de RS o el desmantelamiento es almacenar todos los datos necesarios en HDFS. Cuando un RS cae, el maestro lo detecta a través de la falta de latidos en el nodo de ZooKeeper. Luego, asigna la región afectada a otro RS y, dado que los HFiles se almacenan en un sistema de archivos distribuido, el nuevo propietario los lee y continúa administrando los datos. Sin embargo, dado que parte de los datos puede estar en MemStore y no ha tenido tiempo de ser grabada en HFiles, se utiliza el WAL para recuperar el historial de operaciones, que también se almacena en HDFS. Después de aplicar los cambios, el RS puede responder a las solicitudes, sin embargo, el traslado implica que parte de los datos y los procesos que los gestionan se encuentran en diferentes nodos, es decir, se reduce la localización.
La solución al problema es la compactación mayor: este procedimiento mueve los archivos a los nodos que están a cargo de ellos (donde se encuentran sus regiones), lo que provoca un aumento brusco de la carga en la red y en los discos durante esta operación. Sin embargo, el acceso a los datos se acelera notablemente posteriormente. Además, la major_compaction combina todos los HFiles en un solo archivo dentro de la región, y también limpia los datos según la configuración de la tabla. Por ejemplo, se puede especificar la cantidad de versiones de un objeto que se deben conservar o el tiempo de vida, después del cual el objeto se elimina físicamente.
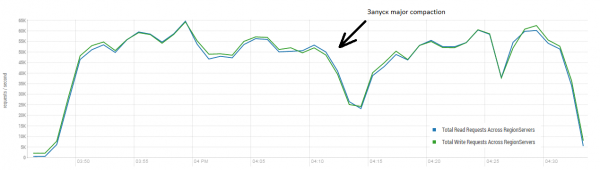
Este procedimiento puede tener un impacto muy positivo en el funcionamiento de HBase. En la imagen a continuación se puede ver cómo ha disminuido el rendimiento debido a la actividad intensa de escritura de datos. Se observa cómo 40 hilos estaban escribiendo en una tabla y 40 hilos leían datos al mismo tiempo. Los hilos de escritura generan cada vez más HFiles, que son leídos por otros hilos. Como resultado, se necesita eliminar cada vez más datos de la memoria y, al final, se activa el GC, que prácticamente paraliza todo el trabajo. La ejecución de una compactación mayor condujo a la limpieza de los atascos formados y a la recuperación del rendimiento.
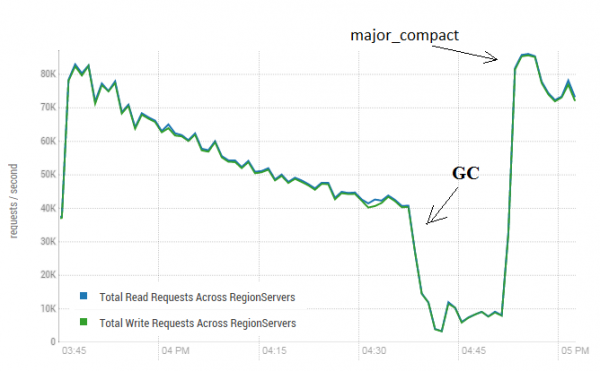
La prueba se realizó en 3 DataNodes y 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 hilos). Versión de HBase 1.2.0-cdh5.14.2
Es importante destacar que la ejecución de la compactación mayor se realizó en una tabla "viva", en la que se estaban escribiendo y leyendo datos activamente. En la red aparecía la afirmación de que esto podría conducir a una respuesta incorrecta al leer datos. Para comprobarlo, se inició un proceso que generaba nuevos datos y los escribía en la tabla. Después, inmediatamente leía y verificaba si el valor obtenido coincidía con el que se había registrado. Durante el funcionamiento de este proceso, se ejecutó la compactación mayor aproximadamente 200 veces y no se registró ningún fallo. Es posible que el problema se manifieste raramente y solo durante una alta carga, por lo que es más seguro detener programadamente los procesos de escritura y lectura y realizar la limpieza evitando tales caídas del GC.
Además, la compactación mayor no afecta al estado de MemStore; para vaciarlo en disco y compactarlo, se debe utilizar flush (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Configuración y rendimiento
Como se mencionó anteriormente, HBase muestra el mayor éxito donde no necesita hacer nada, durante la ejecución de BulkLoad. Sin embargo, esto se aplica a la mayoría de los sistemas y personas. Este instrumento es más adecuado para la inserción masiva de datos en bloques grandes, mientras que si el proceso requiere realizar muchas solicitudes concurrentes de lectura y escritura, se utilizan los comandos descritos anteriormente, Get y Put. Para determinar los parámetros óptimos, se realizaron ejecuciones con diversas combinaciones de parámetros de tablas y configuraciones:
- Se lanzaron 10 hilos simultáneamente 3 veces consecutivas (llamaremos a esto un bloque de hilos).
- El tiempo de trabajo de todos los hilos en el bloque se promedió y fue el resultado final del trabajo del bloque.
- Todos los hilos trabajaron con la misma tabla.
- Antes de cada ejecución del bloque de hilos, se realizó una compactación mayor.
- Cada bloque realizó solo una de las siguientes operaciones:
— Put
— Get
— Get+Put
- Cada bloque realizó 50,000 repeticiones de su operación.
- El tamaño de la escritura en el bloque fue de 100 bytes, 1000 bytes o 10000 bytes (aleatorio).
- Los bloques se lanzaron con diferentes cantidades de claves solicitadas (ya sea una clave o 10).
- Los bloques se lanzaron con diversas configuraciones de tabla. Se modificaron los parámetros:
— BlockCache = activado o desactivado
— BlockSize = 65 KB o 16 KB
— Particiones = 1, 5 o 30
— MSLAB = activado o desactivado
Así es como se ve el bloque:
a. Se activaba/desactivaba el modo MSLAB.
b. Se creó una tabla, para la cual se establecieron los siguientes parámetros: BlockCache = true/none, BlockSize = 65/16 Kb, Particiones = 1/5/30.
c. Se estableció la compresión GZ.
d. Se lanzaron 10 hilos simultáneamente realizando 1/10 operaciones put/get/get+put en esta tabla con registros de 100/1000/10000 bytes, ejecutando 50,000 solicitudes consecutivas (las claves son aleatorias).
e. El punto d se repitió tres veces.
f. Se promedió el tiempo de trabajo de todos los hilos.
Se verificaron todas las combinaciones posibles. Era predecible que al aumentar el tamaño del registro la velocidad disminuiría o que desactivar la caché llevaría a una desaceleración. Sin embargo, el objetivo era entender el grado y la importancia de la influencia de cada parámetro, por lo que los datos recopilados se ingresaron en una función de regresión lineal, lo que permite evaluar la validez mediante la estadística t. A continuación se presentan los resultados de los bloques que realizan operaciones Put. El conjunto completo de combinaciones 2*2*3*2*3 = 144 variantes + 72, ya que algunas se realizaron dos veces. Por lo tanto, en total hubo 216 ejecuciones:
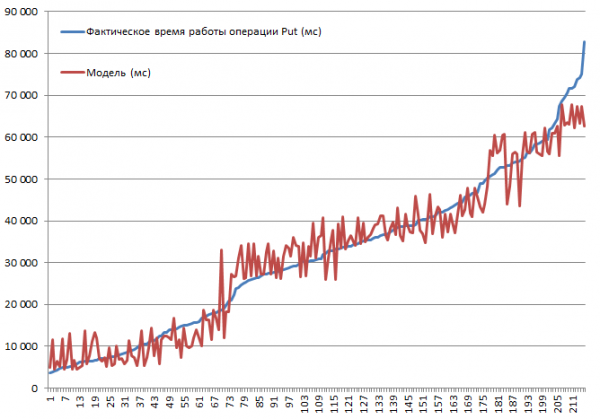
Las pruebas se realizaron en un mini-clúster compuesto por 3 DataNodes y 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 hilos). Versión HBase 1.2.0-cdh5.14.2.
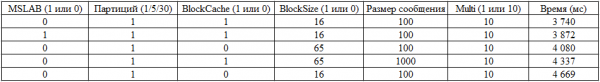
La mayor velocidad de inserción de 3.7 segundos se obtuvo con el modo MSLAB desactivado, en una tabla con una partición, con BlockCache activado, BlockSize = 16, registros de 100 bytes en grupos de 10.
La menor velocidad de inserción 82.8 segundos se obtuvo con el modo MSLAB activado, en una tabla con una partición, con BlockCache activado, BlockSize = 16, registros de 10000 bytes uno por uno.
Ahora veamos el modelo. Vemos una buena calidad del modelo por R2, pero está claro que la extrapolación aquí es contraproducente. El comportamiento real del sistema al cambiar los parámetros no será lineal; este modelo no es para pronósticos, sino para comprender qué ocurrió dentro de los parámetros establecidos. Por ejemplo, aquí vemos por el criterio de Student que para la operación Put, los parámetros BlockSize y BlockCache no tienen relevancia (lo cual es bastante predecible):
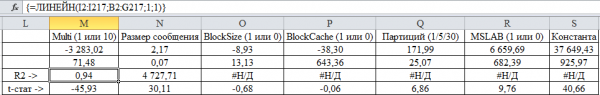
Sorprendentemente, el aumento en el número de particiones lleva a una disminución del rendimiento (ya hemos visto un impacto positivo al aumentar el número de particiones en BulkLoad), aunque es explicable. En primer lugar, para procesar se deben formar consultas para 30 regiones en lugar de una, y el volumen de datos no es tal que esto traiga beneficios. En segundo lugar, el tiempo total de trabajo se determina por el RS más lento, y dado que el número de DataNode es menor que el de RS, algunas regiones tienen una localidad nula. Veamos a los cinco líderes:
Ahora evaluemos los resultados de la ejecución de los bloques Get:
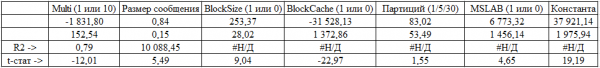
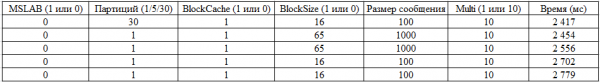
El número de particiones ha perdido relevancia, lo que probablemente se explica por el hecho de que los datos se almacenan en caché de forma efectiva, y la caché para lectura es el parámetro más significativo (estadísticamente). Por supuesto, aumentar la cantidad de mensajes en la consulta también es muy beneficioso para el rendimiento. Mejores resultados:
Y finalmente, veamos el modelo del bloque que realizó primero el get y luego el put:
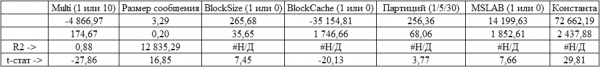
Aquí todos los parámetros son significativos. Y los resultados de los líderes:
9. Pruebas de carga
Y por último, ejecutaremos una carga más o menos decente, pero siempre es más interesante cuando hay con qué comparar. En el sitio web de DataStax, el desarrollador clave de Cassandra, hay de una serie de almacenes NoSQL, incluyendo HBase versión 0.98.6-1. La carga se realizó con 40 hilos, tamaño de datos 100 bytes, discos SSD. El resultado de las pruebas de las operaciones Read-Modify-Write mostró estos resultados.
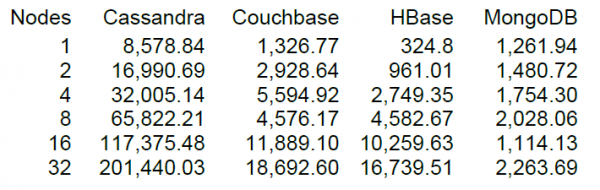
Según entendí, la lectura se realizó en bloques de 100 registros y para 16 nodos, la prueba de DataStax para HBase mostró un rendimiento de 10,000 operaciones por segundo.
Es afortunado que en nuestro clúster también haya 16 nodos, pero no tan "afortunado" que cada uno tenga 64 núcleos (hilos), mientras que en la prueba de DataStax solo hay 4. Por otro lado, ellos tienen discos SSD, mientras que nosotros tenemos HDD y una versión más nueva de HBase, y la utilización de CPU durante la carga prácticamente no aumentó significativamente (visualmente entre un 5-10 por ciento). Sin embargo, intentaremos iniciar con esta configuración. Los ajustes de las tablas son predeterminados, la lectura se realiza en un rango de claves de 0 a 50 millones de forma aleatoria (es decir, cada vez un nuevo). La tabla tiene 50 millones de registros, dividida en 64 particiones. Las claves están hasheadas por crc32. Los ajustes de tablas son por defecto, MSLAB está habilitado. Se lanzan 40 hilos, cada hilo lee un conjunto de 100 claves aleatorias y escribe inmediatamente 100 bytes generados en esas claves de nuevo.
Stand: 16 DataNodes y 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 hilos). Versión de HBase 1.2.0-cdh5.14.2.
El resultado promedio está más cerca de 40 mil operaciones por segundo, lo que es significativamente mejor que en la prueba de DataStax. Sin embargo, en aras del experimento, se pueden modificar un poco las condiciones. Es bastante poco probable que todo el trabajo se realice exclusivamente con una tabla y solo con claves únicas. Supongamos que hay un conjunto "caliente" de claves que genera la carga principal. Por lo tanto, intentamos crear carga con registros más grandes (10 KB), en lotes de 100, en 4 tablas diferentes y limitando el rango de claves solicitadas a 50 mil. En el gráfico a continuación se muestra el lanzamiento de 40 hilos, cada hilo lee un conjunto de 100 claves y escribe inmediatamente 10 KB aleatorios en esas claves de vuelta.
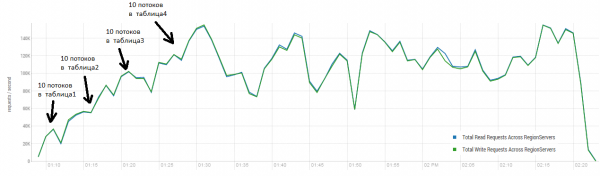
Stand: 16 DataNodes y 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 hilos). Versión de HBase 1.2.0-cdh5.14.2.
Durante la carga, se ejecutó varias veces la compactación mayor, como se mostró anteriormente, sin este procedimiento, el rendimiento comenzará a degradarse gradualmente; sin embargo, también se genera carga adicional durante la ejecución. Las caídas se deben a diversas razones. A veces, los hilos terminaban su trabajo y mientras se reiniciaban, surgía una pausa; a veces, las aplicaciones externas generaban carga en el clúster.
La lectura y escritura simultáneas es uno de los escenarios de trabajo más difíciles para HBase. Si se realizan solo solicitudes de tipo put de tamaño pequeño, por ejemplo, de 100 bytes, agrupándolas en lotes de 10 a 50 mil, se pueden lograr cientos de miles de operaciones por segundo, y lo mismo ocurre con las solicitudes solo de lectura. Es importante señalar que los resultados son radicalmente mejores que los obtenidos por DataStax, en gran medida gracias a las solicitudes en bloques de 50 mil.
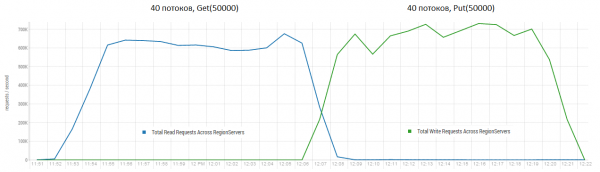
Stand: 16 DataNodes y 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 hilos). Versión de HBase 1.2.0-cdh5.14.2.
10. Conclusiones
Este sistema es bastante flexible en su configuración, sin embargo, el impacto de una gran cantidad de parámetros sigue siendo desconocido. Algunos de ellos han sido probados, pero no se incluyeron en el conjunto de pruebas final. Por ejemplo, experimentos preliminares mostraron que el parámetro DATA_BLOCK_ENCODING, que codifica información utilizando valores de celdas adyacentes, tiene una importancia mínima, lo cual es bastante explicable para datos generados aleatoriamente. En el caso de usar una gran cantidad de objetos repetidos, las ganancias pueden ser significativas. En general, se puede decir que HBase parece una base de datos bastante seria y bien diseñada, que puede ser bastante eficiente en operaciones con grandes bloques de datos, especialmente si hay posibilidad de desfasar en el tiempo los procesos de lectura y escritura.
Si sientes que algo no se ha explicado lo suficiente, estoy dispuesto a dar más detalles. Te invitamos a compartir tu experiencia o discutir si no estás de acuerdo con algo.
Fuente: habr.com
