

El canario es un pequeño pájaro que canta constantemente. Estas aves son sensibles al metano y al monóxido de carbono. Incluso con una pequeña concentración de gases adicionales en el aire, pierden el conocimiento o mueren. Los buscadores de oro y los mineros llevaban canarios a trabajar: mientras los canarios cantan, se puede trabajar; si se callan, hay gas en la mina y es hora de irse. Los mineros sacrificaban a las pequeñas aves para salir vivos de las minas.
Esta práctica también se ha encontrado en el área de TI. Por ejemplo, en la tarea estándar de desplegar una nueva versión de un servicio o aplicación en producción, con pruebas previas. El entorno de prueba puede ser demasiado costoso, las pruebas automatizadas no cubren todo lo que desearíamos, y no probar y sacrificar calidad es arriesgado. En tales casos, ayuda el enfoque de Canary Deployment, donde un pequeño porcentaje del tráfico de producción se dirige a la nueva versión. Este enfoque ayuda a verificar la nueva versión en producción, sacrificando poco por un gran objetivo. Más detalles sobre cómo funciona el enfoque, sus beneficios y cómo implementarlo, serán explicados por Andrey Markelov Andrey_V_Markelov (es un ingeniero programador líder en Infobip, que ha estado trabajando en el desarrollo de aplicaciones en Java en el área de finanzas y telecomunicaciones durante 11 años. Desarrolla productos de código abierto, participa activamente en la comunidad de Atlassian y escribe complementos para productos de Atlassian. Es un evangelista de Prometheus, Docker y Redis.
Andrey_V_Markelov Sobre la empresa Infobip
Es una plataforma de telecomunicaciones global que permite a bancos, minoristas, tiendas en línea y empresas de transporte enviar mensajes a sus clientes a través de SMS, notificaciones push, correos electrónicos y mensajes de voz. En este negocio, la estabilidad y la confiabilidad son esenciales para que los clientes reciban sus mensajes a tiempo.
La infraestructura de TI de Infobip en cifras:
15 centros de datos en todo el mundo;
- 500 servicios únicos en funcionamiento;
- 2500 instancias de servicios, mucho más que el número de equipos;
- 4,5 TB de tráfico mensual;
- 4,5 mil millones de números de teléfono;
- El negocio crece, y con él la cantidad de lanzamientos. Realizamos aproximadamente
60 lanzamientos al día , porque los clientes desean más funciones y capacidades. Pero esto es complicado: hay muchos servicios y pocos equipos. Es necesario escribir código rápidamente, que debe funcionar en producción sin errores., потому что клиенты хотят больше возможностей и мощностей. Но это сложно — сервисов много, а команд мало. Приходится быстро писать код, который должен работать в продакшн без ошибок.
Versiones
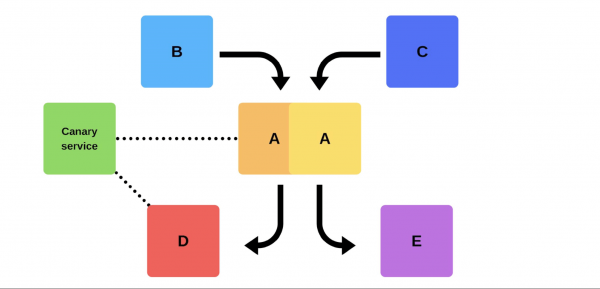
Una versión típica de nuestro proceso es la siguiente. Por ejemplo, tenemos los servicios A, B, C, D y E, cada uno desarrollado por un equipo diferente.
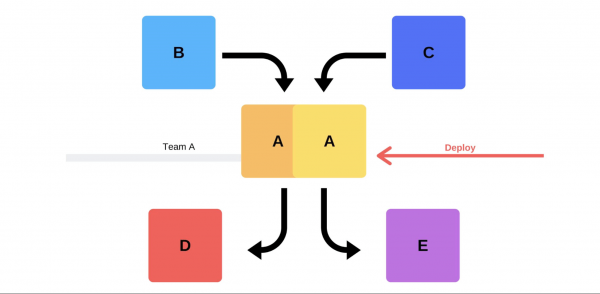
En algún momento, el equipo del servicio A decide desplegar una nueva versión, pero los equipos de los servicios B, C, D y E no están informados. Hay dos opciones para lo que hará el equipo del servicio A.
Realizará un lanzamiento incremental: primero reemplazará una versión y luego la otra.
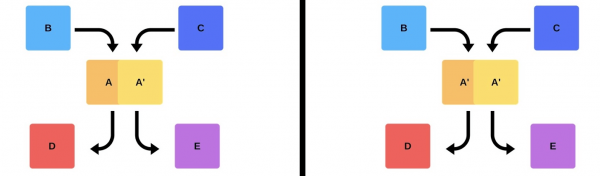
Pero hay una segunda opción: el equipo encontrará recursos adicionales y máquinas, desplegará la nueva versión y luego cambiará el enrutador, y la versión comenzará a funcionar en producción.
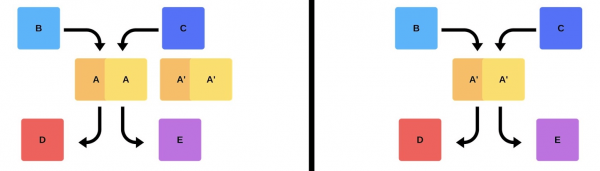
En cualquier caso, después del despliegue casi siempre surgen problemas, incluso si la versión ha sido probada. Se puede probar manualmente, se puede automatizar, o no probar en absoluto — los problemas surgirán de cualquier manera. La manera más simple y correcta de solucionarlos es volver a la versión que estaba funcionando. Después, se puede investigar el daño, las causas y corregirlas.
Entonces, ¿qué queremos?
No queremos problemas. Si los clientes los descubren más rápido que nosotros, eso afectará nuestra reputación. Por lo tanto, debemos encontrar problemas más rápido que los clientes. Trabajando proactivamente, minimizamos el daño.
Al mismo tiempo, queremos acelerar el despliegue, para que ocurra de manera rápida, fácil, natural y sin estrés por parte del equipo. Debemos cuidar a los ingenieros, DevOps y programadores — lanzar una nueva versión es estresante. El equipo no es un recurso desechable, buscamos utilizar racionalmente los recursos humanos.
Problemas de despliegue
El tráfico de los clientes es impredecible.. No se puede predecir cuándo será mínimo el tráfico de los clientes. No sabemos dónde y cuándo comenzarán sus campañas — podría ser esta noche en India, y mañana en Hong Kong. Teniendo en cuenta la gran diferencia horaria, desplegar incluso a las 2 de la mañana no garantiza que los clientes no se vean afectados.
Problemas de proveedores. Los mensajeros y proveedores son nuestros socios. A veces tienen fallos que causan errores durante el despliegue de nuevas versiones.
Equipos distribuidos. Los equipos que desarrollan la parte del cliente y el backend están en diferentes zonas horarias. Debido a esto, a menudo no pueden llegar a acuerdos.
No se pueden replicar los centros de datos en staging. En un centro de datos hay 200 racks — replicar esto en un entorno de pruebas ni siquiera es aproximado.
Los tiempos de inactividad¡no son aceptables! Tenemos un nivel de disponibilidad permitido (Error Budget) en el que trabajamos el 99,99% del tiempo, por ejemplo, y los porcentajes restantes son nuestro "derecho al error". Alcanzar el 100% de fiabilidad es imposible, pero es importante monitorear constantemente las caídas y los tiempos muertos.
Opciones clásicas de solución
Escribir código sin errores. Cuando era un joven desarrollador, los gerentes se acercaban a mí pidiendo un lanzamiento sin errores, pero eso no siempre es posible.
Escribir pruebas. Las pruebas funcionan, pero a veces no de la manera que desea el negocio. Ganar dinero no es una tarea de las pruebas.
Probar en etapa. En mis 3,5 años de trabajo en Infobip, nunca he visto que el estado de la etapa coincida, aunque sea parcialmente, con producción.
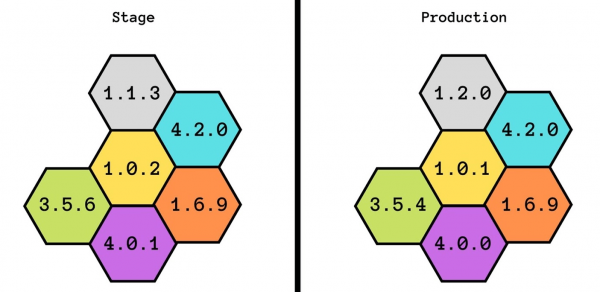
Incluso intentamos desarrollar esta idea: primero teníamos una etapa, luego preproducción, y después preproducción de la preproducción. Pero eso tampoco ayudó: no coincidían ni en capacidad. Con la etapa podemos garantizar una funcionalidad básica, pero no sabemos cómo funcionará bajo carga.
El lanzamiento lo hace quien lo desarrolló. Es una buena práctica: incluso si alguien cambia el nombre de un comentario, lo añade a producción de inmediato. Esto ayuda a fomentar la responsabilidad y a no olvidar los cambios realizados.
También hay complicaciones adicionales. Para el desarrollador, es estresante pasar mucho tiempo para verificar todo manualmente.
Lanzamientos acordados. Esta opción generalmente la ofrece la gestión: "Acordemos que cada día probarán y añadirán nuevas versiones". No funciona: siempre hay un equipo que espera a los demás o viceversa.
Pruebas de humo
Otra forma de resolver nuestros problemas con el despliegue. Consideremos cómo funcionan las pruebas de humo en el ejemplo anterior, cuando el equipo A quiere desplegar una nueva versión.
Primero, el equipo despliega una instancia en producción. Mensajes en la instancia de los mocks simulan tráfico real, para que coincida con el tráfico diario normal. Si todo va bien, el equipo cambia la nueva versión al tráfico de usuarios.
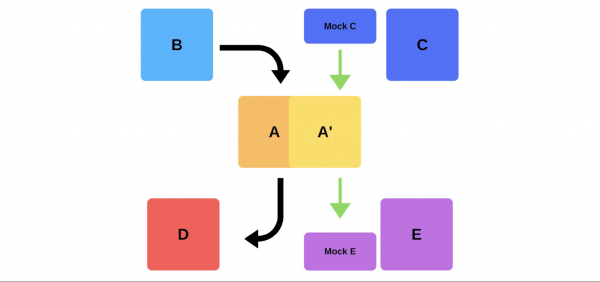
La segunda opción es desplegar con hardware adicional. El equipo lo prueba en producción, luego cambia, y todo funciona.
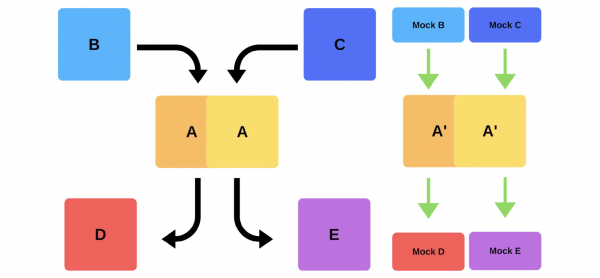
Desventajas de las pruebas de humo:
- No se puede confiar en las pruebas. ¿Dónde conseguir el mismo tráfico que en producción? Se puede utilizar tráfico de ayer o de hace una semana, pero no siempre coincide con el tráfico actual.
- Es difícil de mantener. Tendrás que gestionar cuentas de prueba, reiniciándolas constantemente antes de cada despliegue, cuando se envían registros activos al almacenamiento. Esto es más complicado que escribir una prueba en tu propio entorno de pruebas.
El único beneficio aquí es que se puede verificar el rendimiento.
Despliegues Canary
Debido a las desventajas de las pruebas de humo, comenzamos a utilizar despliegues canary.
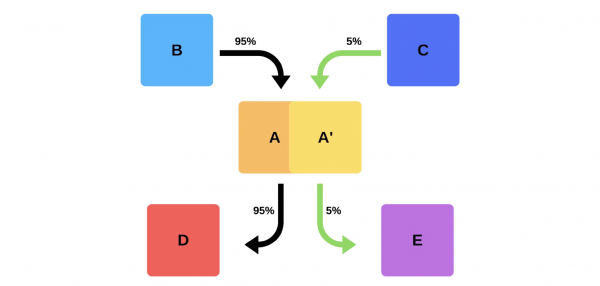
La práctica, similar a cómo los mineros utilizaban canarios para indicar los niveles de gases, también se ha implementado en TI. Permiten que pasemos un poco de tráfico real de producción a la nueva versión, intentando cumplir con el Acuerdo de Nivel de Servicio (SLA). El SLA es nuestro "derecho al error" que podemos utilizar una vez al año (o en algún otro intervalo de tiempo). Si todo va bien, aumentaremos el tráfico. Si no, revertimos a la versión anterior.
Implementación y detalles
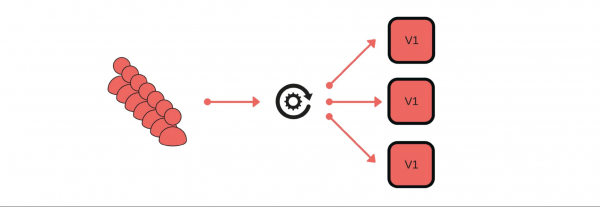
¿Cómo implementamos los despliegues canary? Por ejemplo, un grupo de clientes envía mensajes a través de nuestro servicio.
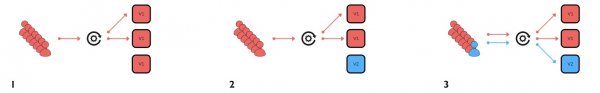
El despliegue ocurre así: retiramos un nodo del balanceador (1), cambiamos la versión (2) y por separado introducimos un poco de tráfico (3).
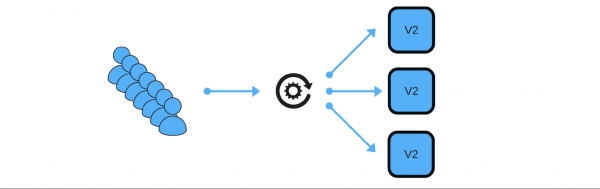
En general, en el grupo todos estarán contentos, incluso si un usuario está descontento. Si todo va bien, actualizamos todas las versiones.
Voy a mostrar de forma esquemática cómo se ve esto para microservicios en la mayoría de los casos.
Hay un Descubrimiento de Servicios y otros dos servicios: S1N1 y S2. El primer servicio (S1N1) avisa al Descubrimiento de Servicios cuando se inicia, y este lo registra. El segundo servicio con dos nodos (S2N1 y S2N2) también notifica al Descubrimiento de Servicios al ser iniciado.
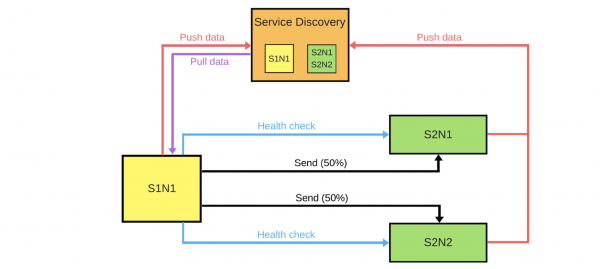
El segundo servicio actúa como un servidor para el primero. Este solicita al Descubrimiento de Servicios información sobre sus servidores y, al obtenerla, los busca y los verifica ("health check"). Cuando los verifica, les envía mensajes.
Cuando alguien quiere desplegar una nueva versión del segundo servicio, notifica al Descubrimiento de Servicios que la segunda nodo será un nodo canary: recibirá menos tráfico porque estará en medio del despliegue. Retiramos el nodo canary del balanceador y el primer servicio no le envía tráfico.
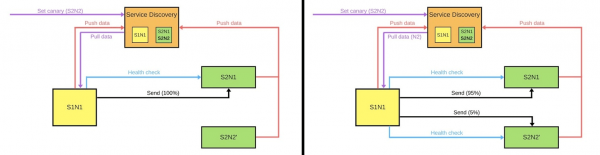
Cambiamos la versión y el Service Discovery sabe que el segundo nodo ahora es canario; se le puede dar menos carga (5%). Si todo va bien, cambiamos la versión, restauramos las cargas y seguimos trabajando.
Para implementar todo esto, necesitamos:
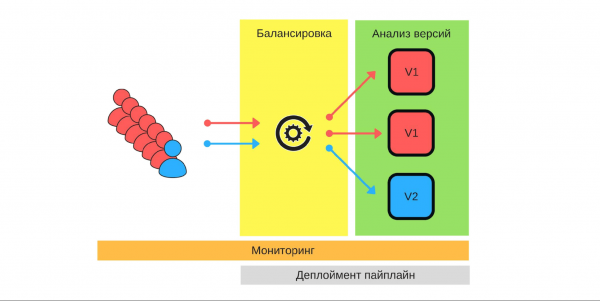
- balanceo;
- monitoreo, ya que es importante saber qué espera cada usuario y en qué detalle funcionan nuestros servicios;
- análisis de versiones, para entender qué tan bien funcionará la nueva versión en producción;
- automatización — escribimos la secuencia de despliegue (pipeline de despliegue).
Balanceo
Esto es lo primero en lo que debemos pensar. Existen dos estrategias de balanceo.
La opción más sencilla, cuando un nodo siempre es canario. Este nodo siempre recibe menos tráfico y comenzamos el despliegue con él. En caso de problemas, compararemos su desempeño antes y durante el despliegue. Por ejemplo, si los errores se duplicaron, significa que el daño también ha aumentado al doble.
El nodo canario se determina durante el despliegue. Cuando el despliegue haya terminado y le quitemos el estado de nodo canario, el balanceo de tráfico se restablecerá. Con menos máquinas obtendremos una distribución justa.
Monitoreo
Piedra angular de los lanzamientos canarios. Debemos entender claramente por qué lo hacemos y qué métricas queremos recolectar.
Ejemplos de métricas que recolectamos de nuestros servicios.
- Cantidad de errores, que se registran en los logs. Este es un indicador obvio de que todo está funcionando como debería. En general, es una buena métrica.
- Tiempo de ejecución de solicitudes (latencia). Esta métrica es monitoreada por todos, porque todos quieren trabajar rápidamente.
- Tamaño de la cola (throughput).
- Número de respuestas exitosas por segundo.
- Tiempo de ejecución del 95% de todas las solicitudes.
- Métricas de negocio: cuánto dinero genera el negocio en un tiempo determinado o la tasa de deserción de usuarios. Estas métricas pueden ser más importantes para nuestra nueva versión que las que aportan los ingenieros.
Ejemplos de métricas en la mayoría de los sistemas de monitoreo populares.
Contador. Es un valor creciente, por ejemplo, el número de errores. Esta métrica se puede interpolar fácilmente y estudiar el gráfico: ayer hubo 2 errores y hoy 500, lo que indica que algo salió mal.
Número de errores por minuto o por segundo, este es un indicador clave que se puede calcular utilizando el Contador. Estos datos brindan una clara representación del funcionamiento del sistema a lo largo del tiempo. Observemos el gráfico del número de errores por segundo para dos versiones del sistema de producción.
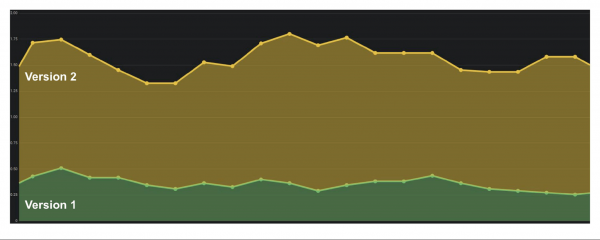
En la primera versión hubo pocos errores, es posible que la auditoría no funcionara. En la segunda versión, todo es mucho peor. Se puede decir con certeza que hay problemas, por lo que debemos retroceder esta versión.
Gauge. Las métricas son similares a Counter, pero registramos valores que pueden tanto aumentar como disminuir. Por ejemplo, el tiempo de ejecución de las solicitudes o el tamaño de la cola.
En el gráfico, un ejemplo del tiempo de respuesta (latencia). En el gráfico se puede ver que las versiones son similares, y se pueden utilizar. Pero si se observa detenidamente, es evidente cómo cambia la magnitud. Si el tiempo de ejecución de las solicitudes aumenta al añadir usuarios, queda claro que hay problemas; antes no era así.
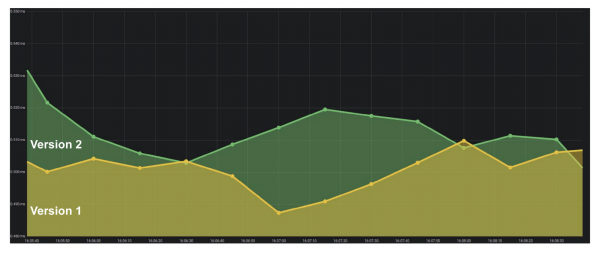
Resumen. Uno de los indicadores más importantes para el negocio son los percentiles. La métrica muestra que en el 95% de los casos nuestro sistema funciona como queremos. Podemos aceptar que haya problemas en algunos lugares, porque entendemos la tendencia general, cuán bien o mal está todo.
Herramientas
ELK Stack. Se puede implementar canary utilizando Elasticsearch: registramos en él los errores cuando ocurren eventos. Con una simple llamada a la API se puede obtener el número de errores en cualquier momento y comparar con períodos anteriores: GET /applg/_cunt?q=level:errr.
Prometheus. Se ha desempeñado bien en Infobip. Permite implementar métricas multidimensionales, porque se utilizan etiquetas.
Podemos usar level, instance, el servicio, combinándolas en un solo sistema. Con offset se puede ver, por ejemplo, el valor de la magnitud hace una semana con un solo comando GET /api/v1/query?query={query}, donde {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Análisis de versiones
Existen varias estrategias para analizar versiones.
Ver métricas solo de la nodo canary. Una de las opciones más simples: desplegar una nueva versión y estudiar solo su funcionamiento. Pero si el ingeniero comienza a estudiar los registros en ese momento, recargando páginas nerviosamente, esta solución no se diferencia de las demás.
La nodo canary se compara con cualquier otra nodo. Esta comparación se hace con otros instancias que trabajan con tráfico completo. Por ejemplo, si con tráfico pequeño las cosas van peor, o no mejor que en las instancias reales, entonces algo no está bien.
La nodo canary se compara consigo misma en el pasado. Los nodos asignados para canary se pueden comparar con datos históricos. Por ejemplo, si todo estaba bien hace una semana, podemos basarnos en esos datos para entender la situación actual.
Automatización
Queremos liberar a los ingenieros de la comparación manual, por lo que es importante implementar la automatización. El proceso de despliegue (deployment pipeline) generalmente se ve así:
- comenzamos;
- retiramos el nodo del balanceador;
- instalamos el nodo canary;
- activamos el balanceador ya con una cantidad limitada de tráfico;
- comparamos.
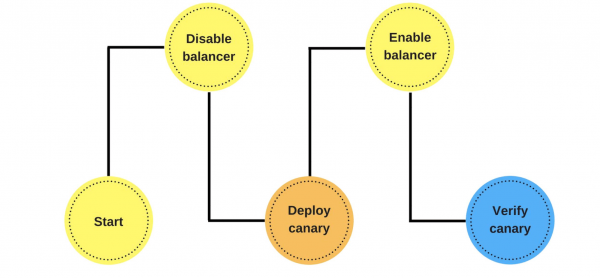
En esta etapa implementamos la comparación automática. Cómo puede lucir y por qué es mejor que la verificación después del despliegue, lo рассмотрamos con un ejemplo de Jenkins.
Este es un pipeline en Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary falló, es necesario revertir"
        return false
    }
}
Aquí en el ciclo establecemos que vamos a comparar el nuevo nodo durante una hora. Si el proceso canary aún no ha terminado — llamamos a la función. Esta informa si todo está bien o no: def isOk = compare(srv, canary, time, base, offset, metrics).
Si todo está bien — sleep DEFAULT SLEEP, por ejemplo, un segundo, y continuamos. Si no, salimos — el despliegue falló.
Descripción de la métrica. Veamos cómo puede lucir la función compare con un ejemplo de DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Supongamos que estamos comparando el número de errores y queremos saber el número de errores por segundo en los últimos 5 minutos.
Tenemos dos valores: el base y el del nodo canary. El valor en el nodo canary — es el actual. El base es baseValue — este es el valor de cualquier otro nodo que no sea canary. Comparamos los valores entre sí según la fórmula, que establecemos basándonos en nuestra experiencia y observaciones. Si el valor canaryValue es malo, entonces el despliegue ha fallado, y revertimos.
¿Para qué es todo esto?
Un humano no puede verificar cientos y miles de métricas, mucho menos hacerlo rápido. La comparación automática ayuda a verificar todas las métricas y notificar rápidamente sobre problemas. El tiempo de notificación es crítico: si algo sucedió en los últimos 2 segundos, el daño no será tan grande como si hubiera sucedido hace 15 minutos. Mientras alguien nota el problema, lo reporta al soporte, y el soporte nos avisa para revertir, podemos perder clientes.
Si el proceso se completó correctamente, desplegamos automáticamente todos los demás nodos. Durante este tiempo, los ingenieros no hacen nada. Solo cuando inician el canario, deciden qué métricas tomar, cuánto tiempo comparar y qué estrategia usar.
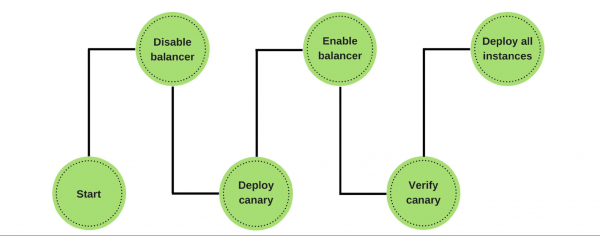
Si surgen problemas, revertimos automáticamente el nodo canario, trabajamos con versiones anteriores y corregimos los errores encontrados. Con las métricas, es fácil localizar y ver el daño de la nueva versión.
Obstáculos
Implementar esto, por supuesto, no es fácil. Primero se necesita un sistema de monitoreo común. Los ingenieros tienen sus propias métricas, el soporte y los analistas otras, y el negocio terceras. Un sistema común es el idioma común que hablan el negocio y el desarrollo.
Es necesario comprobar en la práctica la estabilidad de las métricas. La verificación ayuda a entender qué conjunto mínimo de métricas es necesario para asegurar la calidad..
¿Cómo lograrlo? Utilizar el servicio canario no en el momento del despliegue. Añadimos un servicio a la versión anterior que en cualquier momento puede tomar cualquier nodo dedicado, disminuyendo el tráfico sin desplegar. Luego comparamos: estudiamos los errores y buscamos el punto en el que alcanzamos la calidad.
¿Qué beneficios hemos obtenido de los lanzamientos canarios?
Minimizamos el porcentaje de daños por errores. La mayoría de los errores de despliegue ocurren debido a la inconsistencia de algunos datos o prioridades. Estos errores se han reducido considerablemente porque podemos resolver el problema en los primeros segundos.
Optimizamos el trabajo de los equipos. Los principiantes tienen el 'derecho al error': pueden desplegar en producción sin temor a equivocarse, lo que genera una iniciativa adicional y un incentivo para trabajar. Si rompen algo, no será crítico y no serán despedidos por error.
Automatizamos el despliegue. Ya no es un proceso manual como antes, sino un verdadero proceso automatizado. Pero toma más tiempo.
Destacamos métricas importantes. Toda la empresa, desde el negocio y los ingenieros, entiende lo que realmente es importante en nuestro producto, qué métricas, por ejemplo, la retención y entrada de usuarios. Controlamos el proceso: probamos métricas, introducimos nuevas y observamos cómo funcionan las antiguas para construir un sistema que genere ingresos de manera más eficiente.
Tenemos muchas prácticas y sistemas geniales que nos ayudan. A pesar de esto, nos esforzamos por ser profesionales y hacer nuestro trabajo de manera efectiva, independientemente de si tenemos un sistema que nos ayude o no.
Enfoques y prácticas de ingeniería — . Si has logrado avances en tu camino hacia la excelencia técnica y estás listo para compartir lo que te ha ayudado, — .
Planeamos llevar a cabo el 8 de junio. Entendemos que ahora es difícil tomar decisiones sobre la participación en la conferencia. Pero al mismo tiempo creemos que la cuarentena no es motivo para detener la comunicación y el desarrollo profesional. Así que encontraremos una manera de discutir los desafíos del líder técnico y los enfoques para resolverlos; si es necesario, nos moveremos en línea y organizaremos el networking allí.
Fuente: habr.com
