

Le ofrezco revisar la transcripción del informe a principios de 2016 de Andrey Sal'nikov "Errores habituales en aplicaciones que conducen al bloat en PostgreSQL"
En este informe, analizaré los errores principales en las aplicaciones que surgen en la etapa de diseño y escritura del código de la aplicación. Me centraré solo en aquellos errores que conducen al bloat en PostgreSQL. Por lo general, esto marca el inicio del fin del rendimiento de su sistema en general, aunque inicialmente no se veían señales de ello.
¡Saludos a todos! Este informe no es tan técnico como el anterior de mi colega. Está orientado principalmente a desarrolladores de sistemas backend, porque tenemos una cantidad considerable de clientes. Y todos cometen los mismos errores. De eso les hablaré. Explicaré las consecuencias fatales y negativas de estos errores.
¿Por qué se cometen errores? Se cometen por dos razones: por casualidad, pensando que puede funcionar, y por desconocimiento de ciertos mecanismos que ocurren a nivel entre la base de datos y la aplicación, así como dentro de la propia base de datos.
Les daré tres ejemplos con imágenes horribles de cómo todo se ha vuelto malo. Resumiré el mecanismo que ocurre allí. Y cómo combatirlos cuando ocurren, así como qué métodos preventivos utilizar para evitar errores. Hablaremos de herramientas auxiliares y proporcionaré enlaces útiles.
Utilicé una base de datos de prueba, donde tenía dos tablas. Una tabla con las cuentas de los clientes, y la otra con las operaciones en estas cuentas. Y con cierta periodicidad, actualizamos los saldos en estas cuentas.
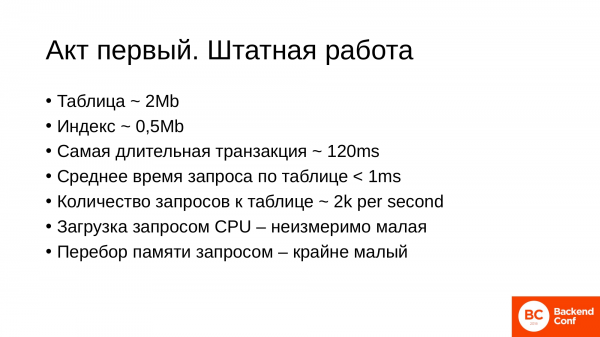
Los datos de origen de la tabla: es bastante pequeña, 2 MB. El tiempo de respuesta de la base de datos y específicamente de la tabla también es muy bueno. Y la carga es suficientemente buena: 2,000 operaciones por segundo en la tabla.
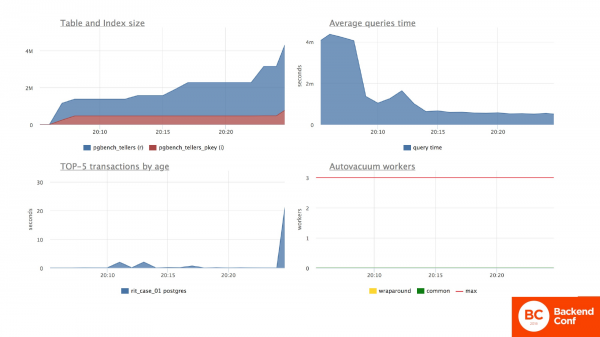
Y a lo largo de este informe, les mostraré gráficos para que sea evidente lo que está sucediendo. Siempre habrá 2 diapositivas con gráficos. La primera diapositiva mostrará lo que ocurre en el servidor en general.
Y en esta situación, vemos que de hecho, tenemos una tabla de tamaño pequeño. Un índice pequeño de 2 MB. Este es el primer gráfico a la izquierda.
El tiempo medio de respuesta del servidor también es estable y bajo. Este es el gráfico superior derecho.
El gráfico inferior izquierdo muestra las transacciones más prolongadas. Vemos que las transacciones se completan rápidamente. Y el autovacuum aún no está funcionando aquí, porque fue una prueba inicial. Más adelante funcionará y será útil para nosotros.
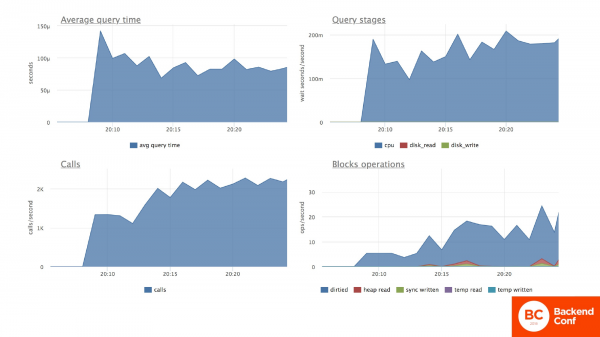
La segunda diapositiva siempre se dedicará a la tabla en prueba. En esta situación, actualizamos constantemente los saldos de las cuentas del cliente. Y vemos que el tiempo de respuesta promedio para la operación de actualización es bastante bueno, menos de una milésima de segundo. Vemos que los recursos de la CPU (esto es el gráfico superior derecho) se consumen de manera uniforme y en cantidades bastante pequeñas.
El gráfico inferior derecho muestra cuánto de memoria operativa y de disco estamos recorriendo en busca de nuestra línea necesaria antes de actualizarla. Y la cantidad de operaciones en la tabla es de 2,000 por segundo, como mencioné al principio.
Y ahora ocurre una tragedia. Por alguna razón, aparece una transacción olvidada y prolongada. Las razones suelen ser bastante banales:
- Una de las más comunes es que en el código de la aplicación comenzamos a comunicarnos con un servicio externo. Y ese servicio no nos responde. Es decir, abrimos una transacción, hicimos un cambio en la base de datos y nos fuimos a leer correos o a otro servicio dentro de nuestra infraestructura, y por alguna razón no nos responde. Y nuestra sesión queda colapsada en un estado – no se sabe cuándo se resolverá.
- La segunda situación ocurre cuando en nuestro código, por alguna razón, se produce una excepción. Y no procesamos el cierre de la transacción en la excepción. Y terminamos con una sesión colgada con una transacción abierta.
- Y, finalmente, este también es un caso bastante común. Es código de mala calidad. Algunos frameworks abren una transacción. Esta queda suspendida, y es posible que no sepas en la aplicación que está así.
¿A qué conducen estas cosas?
A que nuestras tablas e índices comienzan a hincharse drásticamente. Este es precisamente el efecto bloat. Para la base de datos, esto se expresará en un aumento brusco en el tiempo de respuesta de la base de datos, y aumentará la carga en el servidor de la base de datos. Como resultado, nuestra aplicación sufrirá. Porque si en el código dedicas 10 milisegundos a una consulta de la base de datos, 10 milisegundos a tu lógica, entonces tu función funcionaba en 20 milisegundos. Pero ahora la situación será bastante triste.
Y veamos qué está pasando. El gráfico inferior izquierdo muestra que tenemos una transacción prolongada. Y si miramos el gráfico superior izquierdo, vemos que el tamaño de la tabla ha saltado abruptamente de dos megabytes a 300 megabytes. Sin embargo, la cantidad de datos en la tabla no ha cambiado, es decir, hay una gran cantidad de basura.
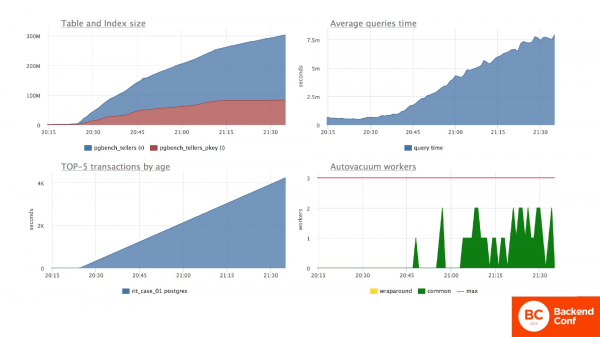
La situación general en cuanto al tiempo medio de respuesta del servidor también ha cambiado drásticamente. Es decir, todas las solicitudes al servidor han comenzado a caer considerablemente. Además, se han iniciado los procesos internos de Postgres en forma de autovacuum, que intentan hacer algo y consumen recursos.
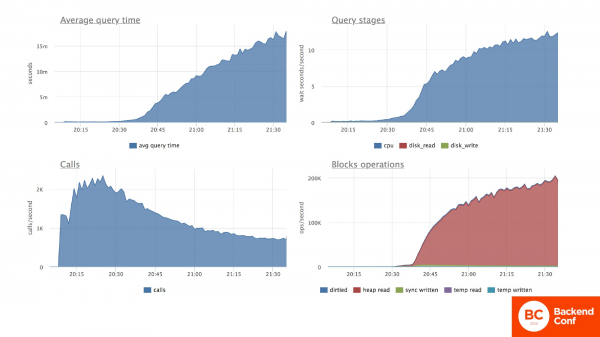
¿Qué está ocurriendo con nuestra tabla? Lo mismo. El tiempo medio de respuesta de la tabla ha aumentado drásticamente. En cuanto a los recursos consumidos, vemos que la carga en el procesador ha aumentado significativamente. Este es el gráfico superior derecho. Y ha aumentado porque el procesador tiene que revisar muchas filas innecesarias en busca de una necesaria. Este es el gráfico inferior derecho. Y como resultado, el número de llamadas por segundo ha comenzado a caer significativamente, porque la base no puede procesar la misma cantidad de solicitudes.
Necesitamos volver a la vida. Vamos a internet y descubrimos que las transacciones largas causan problemas. Encontramos y eliminamos esa transacción. Y todo vuelve a estar normal. Todo funciona como debería.
Nos calmamos, pero después de un tiempo comenzamos a notar que la aplicación no funciona como antes de la situación de emergencia. Las solicitudes siguen siendo procesadas más lento, y significativamente más lento. En mi caso, una vez y media a dos veces más lento. La carga en el servidor también es superior a la que había antes de la emergencia.
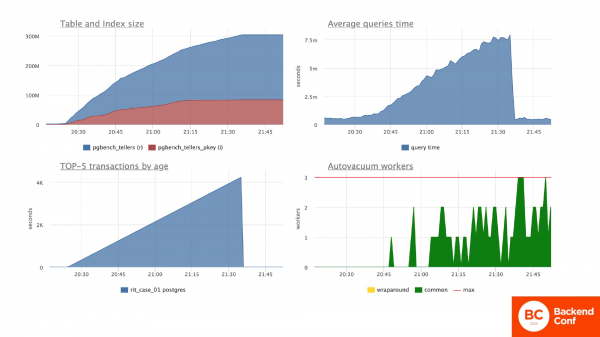
Y la pregunta es: "¿Qué está pasando con la base en este momento?". Con la base está ocurriendo la siguiente situación. En el gráfico de transacciones, ves que se ha detenido y realmente no hay transacciones largas. Pero los tamaños de la tabla durante la emergencia han aumentado fatalmente. Y desde entonces no han disminuido. El tiempo medio en la base se ha estabilizado. Y las respuestas parecen estar fluyendo de manera adecuada a una velocidad aceptable para nosotros. El autovacuum se ha vuelto más activo y ha comenzado a hacer algo con la tabla, porque necesita procesar una mayor cantidad de datos.
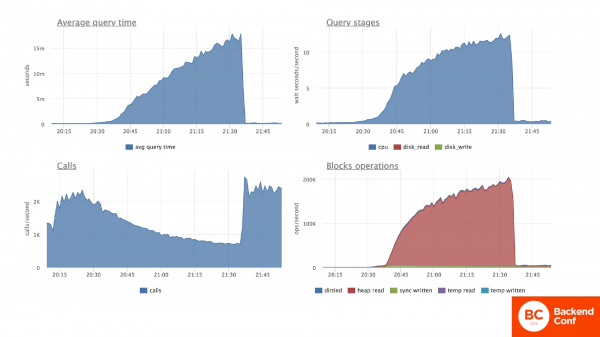
Específicamente sobre la tabla de cuentas en la que cambiamos los saldos: el tiempo de respuesta a la consulta parece haber vuelto a la normalidad. Pero en realidad, es una vez y media más alto.
Y respecto a la carga del procesador, vemos que no ha regresado a los niveles requeridos antes de la falla. Las causas se encuentran en el gráfico de la esquina inferior derecha. Es evidente que estamos sobresaturando una cierta cantidad de memoria. Es decir, para encontrar la línea necesaria, estamos gastando recursos del servidor de bases de datos al procesar datos inútiles. La cantidad de transacciones por segundo se ha estabilizado.
En general, está bien, pero la situación es peor que antes. Hay una clara degradación de la base de datos como consecuencia de nuestra aplicación que trabaja con esta base de datos.
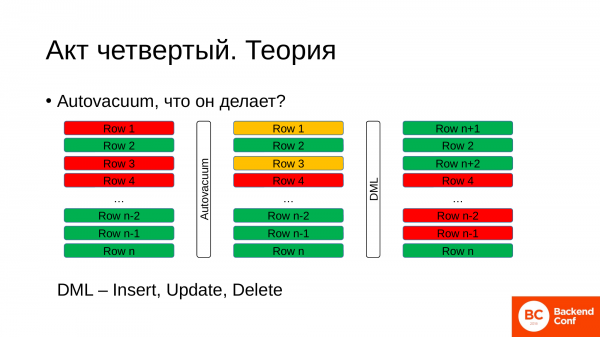
Y para entender qué está sucediendo, si no asistieron a la presentación anterior, ahora un poco de teoría. Teoría sobre el proceso interno. ¿Para qué sirve el autovacuum y qué hace?
Brevemente, para la comprensión. En algún momento, tenemos una tabla. En la tabla hay filas. Estas filas pueden ser activas, vivas, que necesitamos ahora. En la imagen, están marcadas en verde. Y hay filas muertas, que ya han sido procesadas, actualizadas, y aparecen nuevos registros sobre ellas. Y están marcadas como que ya no interesan a la base de datos. Pero permanecen en la tabla debido a las peculiaridades de Postgres.
¿Para qué se necesita el autovacuum? El autovacuum en algún momento se presenta, se dirige a la base de datos y le pregunta: "Dame, por favor, el id de la transacción más antigua que está abierta en este momento en la base de datos". La base de datos devuelve este id. Y el autovacuum, basándose en él, revisa las filas de la tabla. Si ve que algunas filas han sido modificadas por transacciones mucho más antiguas, entonces tiene derecho a marcarlas como filas que podemos reutilizar en el futuro, escribiendo nuevos datos en ellas. Este es un proceso en segundo plano.
Mientras tanto, seguimos trabajando con la base de datos, seguimos realizando algunos cambios en la tabla. Y sobre estas filas que podemos reutilizar, escribimos nuevos datos. De esta manera, tenemos un ciclo, es decir, constantemente aparecen en la base de datos algunas filas muertas antiguas, y en su lugar escribimos nuevas filas que necesitamos. Y este es un estado normal para el funcionamiento de PostgreSQL.
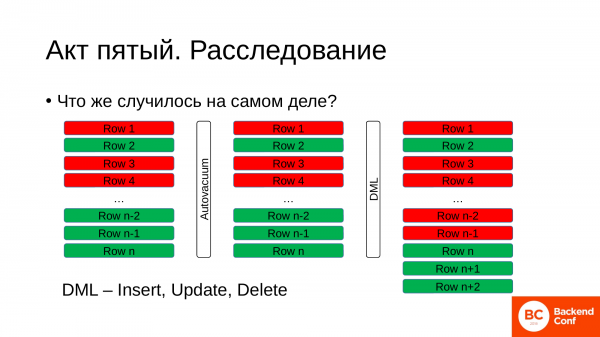
¿Qué sucedió durante el accidente? ¿Cómo se desarrolló este proceso?
Teníamos una tabla en algún estado, algunas filas vivas y otras muertas. Vino el autovacuum. Preguntó a la base de datos cuál era nuestra transacción más antigua y cuál era su id. Obtuvo este id, que podría tener horas de antigüedad o solo diez minutos. Esto depende de cuán alta sea la carga en su base de datos. Y comenzó a buscar filas que pudiera marcar como reutilizables. Y no encontró tales filas en nuestra tabla.
Pero mientras tanto seguimos trabajando en la tabla. Hacemos algo en ella, actualizamos, cambiamos datos. ¿Y qué debe hacer la base de datos en ese momento? No le queda otra opción que añadir nuevas filas al final de la tabla existente. De esta manera, el tamaño de la tabla comienza a aumentar.
Realmente necesitamos filas verdes para trabajar. Pero durante un problema así, el porcentaje de filas verdes en toda la tabla es extremadamente bajo.
Y cuando ejecutamos una consulta, la base de datos tiene que recorrer todas las filas: tanto las rojas como las verdes, para encontrar la fila correcta. Y el efecto de inflación de la tabla con datos innecesarios se llama "bloat", que también consume nuestro espacio en disco. ¿Recuerdas, tenía 2 MB, ahora tiene 300 MB? Ahora cambia megabytes por gigabytes y rápidamente te quedarás sin espacio en tus recursos de disco.
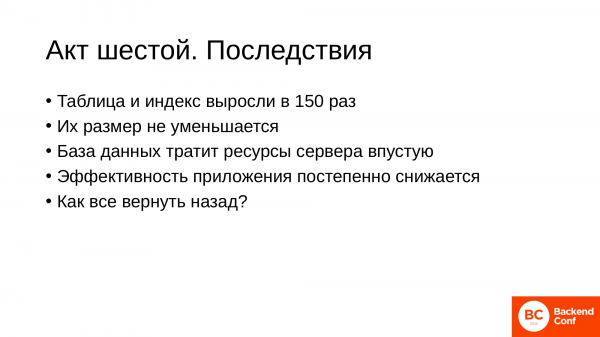
¿Qué consecuencias pueden haber para nosotros?
- En mi ejemplo, la tabla y el índice crecieron 150 veces. Algunos de nuestros clientes han tenido casos más fatales, donde simplemente se empezaba a acabar el espacio en disco.
- El tamaño de las tablas por sí mismo nunca disminuirá. El autovacuum en algunos casos puede recortar la cola de la tabla si solo hay filas muertas. Pero dado que hay una rotación constante, una fila verde puede quedarse al final y no actualizarse, mientras que todas las demás se registran en la parte superior de la tabla. Pero esto es un evento tan poco probable que no debemos esperar que nuestra tabla disminuya de tamaño por sí sola.
- La base de datos necesita revisar toda una pila de filas inútiles. Y estamos gastando recursos de disco, recursos de procesador y electricidad.
- Y esto afecta directamente a nuestra aplicación, porque si al principio gastábamos 10 milisegundos en la solicitud, 10 milisegundos en nuestro código, durante la caída comenzamos a gastar un segundo en la solicitud y 10 milisegundos en el código, es decir, el rendimiento de la aplicación disminuyó en un orden de magnitud. Y cuando se resolvió la caída, comenzamos a gastar 20 milisegundos en la solicitud, 10 milisegundos en el código. Esto significa que aún así caímos en un 50% en rendimiento. Y todo esto debido a una transacción que quedó atascada, posiblemente por nuestra culpa.
- Y la pregunta es: «¿Cómo lo revertimos?», para que todo funcione bien y las solicitudes corran tan rápido como antes de la caída.
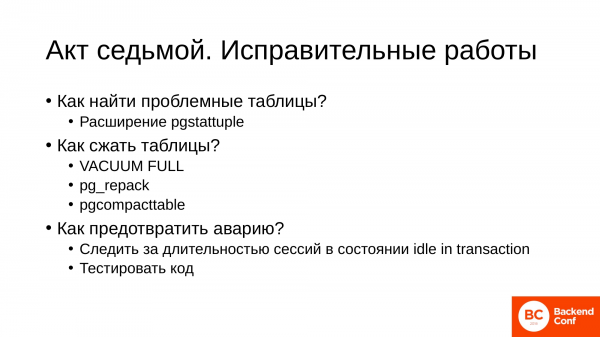
Para ello, hay un ciclo de trabajo específico que se lleva a cabo.
Primero necesitamos encontrar las tablas problemáticas que se han expandido. Entendemos que para algunas tablas la escritura es más activa, para otras menos activa. Y para esto se utiliza la extensión . Al instalar esta extensión, puedes escribir consultas que te ayudarán a encontrar las tablas que han crecido significativamente.
Después de encontrar estas tablas, es necesario comprimirlas. Para ello, ya hay herramientas. En nuestra empresa usamos tres herramientas. La primera es VACUUM FULL integrado. Es duro, severo y despiadado, pero a veces es muy útil. y son utilidades externas para comprimir tablas. Y son más cuidadosas con la base de datos.
Se utilizan dependiendo de lo que te resulte más conveniente. Pero de esto hablaré al final. Lo principal es que hay tres herramientas. Hay de dónde elegir.
Después de que hayamos hecho todas las correcciones y nos hayamos asegurado de que todo esté bien, debemos saber cómo prevenir esta situación en el futuro:
- Se previene bastante fácil. Es necesario monitorear la duración de las sesiones en el servidor maestro. Las sesiones especialmente peligrosas están en estado de idle in transaction. Son aquellas que abrieron una transacción, hicieron algo y se fueron o simplemente se quedaron atrapadas, perdidas en el código.
- Y para ustedes, como desarrolladores, es importante probar el código en el momento en que se presentan estas situaciones. No es difícil hacerlo. Será una revisión útil. Evitarán una gran cantidad de problemas 'infantiles' relacionados con transacciones prolongadas.
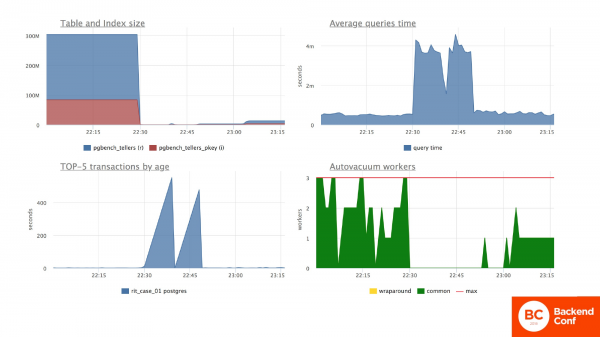
En estos gráficos, quería mostrarles cómo cambió la tabla y el comportamiento de la base de datos después de que pasé por la tabla con VACUUM FULL. Esto no está en producción.
El tamaño de la tabla volvió a un estado operativo normal de unos pocos megabytes. Esto no afectó significativamente el tiempo de respuesta del servidor.
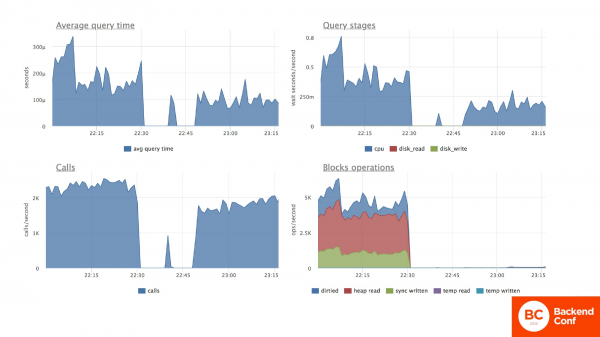
Pero en nuestra tabla de prueba, donde actualizamos los saldos en las cuentas, vemos que el tiempo medio de respuesta para la actualización de datos en la tabla se redujo a un nivel previo a la crisis. Los recursos consumidos por el procesador para ejecutar esta consulta también cayeron a niveles anteriores a la crisis. Y el gráfico en la esquina inferior derecha muestra que ahora encontramos exactamente la fila que necesitamos de inmediato, sin tener que revisar un montón de filas muertas que existían antes de la compresión de la tabla. El tiempo medio de las consultas se mantiene aproximadamente al mismo nivel. Pero aquí, más bien, tengo un margen de error de mi hardware.
Aquí termina la primera historia. Es la más común y le sucede a todos, independientemente de la experiencia del cliente o de cuán calificados sean los programadores. Tarde o temprano esto sucede.
La segunda historia, en la que distribuimos la carga y optimizamos los recursos del servidor.
- Ya hemos crecido y nos hemos convertido en una empresa seria. Y sabemos que tenemos una réplica y sería bueno equilibrar la carga: escribir en el Maestro y leer de la réplica. Y generalmente esta situación surge cuando queremos generar informes o realizar ETL. Y el negocio está muy contento con esto. Quiere informes variados con un montón de análisis complejos.
- Los informes llevan horas porque no se puede calcular un análisis complejo en milisegundos. Nosotros, como chicos valientes, escribimos código. Hacemos inserciones en la aplicación, escribimos en el Maestro y ejecutamos los informes en la réplica.
- Distribuimos la carga.
- Todo funciona perfectamente. Somos geniales.
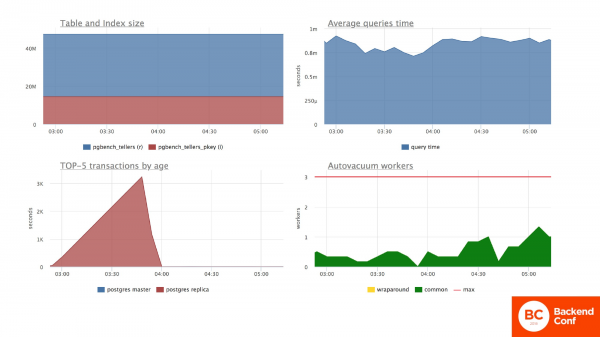
¿Y cómo se ve esta situación? En estos gráficos, también añadí la duración de las transacciones desde la réplica para la duración de la transacción. Todos los demás gráficos se refieren solo al servidor Maestro.
La tabla de informes ha crecido hasta este momento. Hay más informes. Vemos que el tiempo medio de respuesta del servidor es estable. Notamos que hay una transacción larga en la réplica que lleva 2 horas. Vemos el funcionamiento tranquilo del autovacuum que está procesando las filas muertas. Y todo va bien.
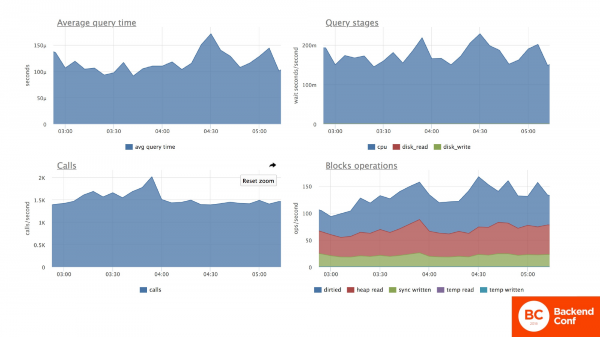
Específicamente en la tabla en cuestión, seguimos actualizando los saldos en las cuentas. También tenemos un tiempo de respuesta estable para las consultas, un consumo de recursos estable. Todo va bien.
Todo va bien hasta que los informes comienzan a fallar debido a un conflicto con la replicación. Y estos fallos ocurren de forma continua.
Nos metemos en Internet y empezamos a leer por qué está sucediendo esto. Y encontramos una solución.
La primera solución es aumentar el retraso de replicación. Sabemos que nuestro informe tarda 3 horas en procesarse. Establecemos el retraso de replicación a 3 horas. Ejecutamos todo, pero aún continuamos teniendo problemas con los informes que a veces fallan.
Queremos que todo funcione perfectamente. Buscamos más y encontramos una buena configuración en Internet: hot_standby_feedback. Lo activamos. Hot_standby_feedback nos permite retener el funcionamiento del autovacuum en el maestro. De este modo, eliminamos por completo los conflictos de replicación. Y todo funciona bien con los informes.
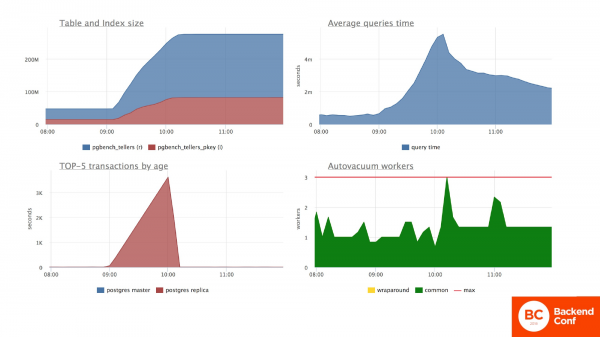
¿Y qué está sucediendo con el servidor maestro en este momento? La situación en el servidor maestro es crítica. Ahora estamos observando los gráficos desde que activé estas dos configuraciones. Y vemos que las sesiones en la réplica de alguna manera han empezado a influir en la situación del servidor maestro. De hecho, están influyendo, ya que han detenido el autovacuum que limpia las filas muertas. El tamaño de la tabla ha vuelto a dispararse. El tiempo medio de ejecución de las consultas en toda la base de datos también ha aumentado considerablemente. Los autovacuums se han tensado un poco.
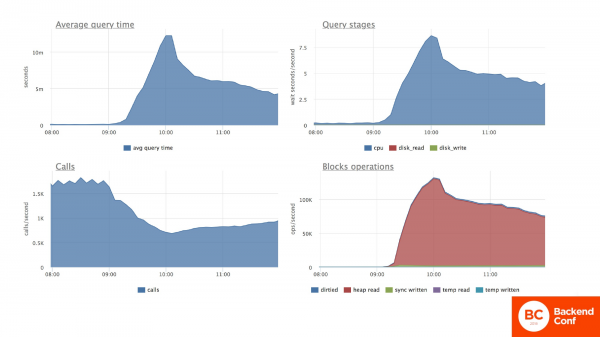
Concretamente en nuestra tabla, vemos que la actualización de datos también ha aumentado considerablemente. El consumo de recursos de la CPU también ha aumentado drásticamente. Nuevamente estamos procesando una gran cantidad de filas muertas e inútiles. Y el tiempo de respuesta para esta tabla y el número de transacciones han caído.
¿Cómo se vería esto si no supiéramos de qué estaba hablando antes?
- Comenzamos a buscar problemas. Si hemos enfrentado problemas en la primera parte, sabemos que la causa puede ser una transacción larga y vamos al Maestro. El problema está en el Maestro. Está fallando. Se calienta, su carga promedio está cerca del cien.
- Las solicitudes están desaceleradas allí, pero no vemos transacciones largas. Y no entendemos qué está pasando. No sabemos dónde buscar.
- Verificamos el hardware del servidor. Puede que se haya estropeado el RAID. Puede que se haya quemado un módulo de memoria. Cualquier cosa puede suceder. Pero no, los servidores son nuevos, todo funciona perfectamente.
- Todos están corriendo: administradores, desarrolladores y el director. Nada ayuda.
- Y en algún momento, de repente, todo comienza a corregirse solo.
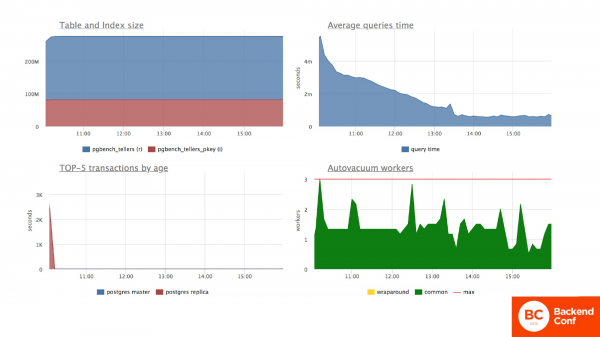
Mientras tanto, en la réplica, una solicitud se procesó y se fue. Recibimos el informe. El negocio sigue satisfecho. Como podemos ver, la tabla ha crecido nuevamente y no parece que vaya a disminuir. En el gráfico de sesiones dejé una parte de esta larga transacción de la réplica para que puedan evaluar cuánto tiempo pasa hasta que la situación se estabiliza.
La sesión se fue. Y solo después de un tiempo, el servidor vuelve más o menos a la normalidad. Y el tiempo medio de respuesta de las solicitudes en el servidor Maestro se normaliza. Porque, finalmente, el autovacuum tuvo la oportunidad de limpiar, marcar esas líneas muertas. Y comenzó a hacer su trabajo. Y tan rápido como lo hace, así de rápido volveremos a la normalidad.
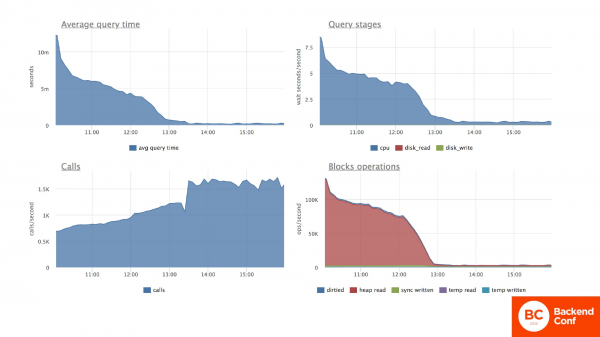
En la tabla de prueba, donde actualizamos los saldos de las cuentas, vemos un patrón muy similar. El tiempo medio de actualización de cuentas también se normaliza gradualmente. Los recursos consumidos por la CPU también disminuyen. Y la cantidad de transacciones por segundo vuelve a la normalidad. Pero nuevamente a una normalidad que no es la que teníamos antes del accidente.
De todos modos, experimentamos una caída en el rendimiento como en el primer caso de una vez y media a dos veces, o a veces incluso más.
Parece que hicimos todo correctamente. Distribuimos la carga. El hardware no está inactivo. Desglosamos las solicitudes de manera inteligente, pero de todos modos, todo salió mal.
- ¿No activar hot_standby_feedback? Sí, no se recomienda activarlo sin razones de peso. Porque este ajuste afecta directamente al Servidor Maestro y detiene el funcionamiento del autovacuum allí. Si lo activas en alguna réplica y olvidas sobre esto, puedes perjudicar al Maestro y tener problemas importantes con la aplicación.
- ¿Aumentar max_standby_streaming_delay? Sí, para los informes – así es. Si tienes un informe de tres horas y no quieres que se caiga debido a conflictos de replicación, simplemente aumenta el retraso. Un informe prolongado nunca requiere datos que hayan llegado a la base en este momento. Si es de tres horas, significa que lo estás ejecutando para un período de datos antiguo. Y para ti, tres horas de retraso o seis horas no marcarán diferencia, pero así recibirás informes de manera estable y no tendrás problemas con su caída.
- Naturalmente, es necesario controlar las sesiones largas en las réplicas, especialmente si has decidido activar hot_standby_feedback en la réplica. Porque puede pasar cualquier cosa. Se le dio esta réplica a un desarrollador para que probara las consultas. Él escribió una consulta loca. La ejecutó y se fue a tomar té, y nosotros obtenemos un Maestro complicado. O introdujimos la aplicación incorrecta. Las situaciones son variadas. Las sesiones en las réplicas deben controlarse con tanto cuidado como en el Maestro.
- Y si tienes consultas rápidas y prolongadas en las réplicas, en este caso es mejor dividirlas para distribuir la carga. Este es un enlace al streaming_delay. Para las rápidas, tener una réplica con un pequeño retraso en la replicación. Para las consultas prolongadas, tener una réplica que pueda retrasarse entre 6 horas y un día. Esta es una situación bastante normal.
Eliminamos las consecuencias de la misma manera:
- Encontramos las tablas infladas.
- Y comprimimos con la herramienta más adecuada para nosotros.
La segunda historia termina aquí. Pasamos a la tercera historia.
También es bastante común para nosotros, en la que hacemos una migración.
- Cualquier producto de software crece. Cambian los requisitos. De todas formas, queremos desarrollarnos. Y a veces necesitamos actualizar los datos en la tabla, específicamente ejecutar la actualización en el marco de nuestra migración hacia la nueva funcionalidad que implementamos en el contexto de nuestro desarrollo.
- El formato de datos antiguo no es adecuado. Supongamos que ahora nos dirigimos a la segunda tabla, donde tengo operaciones en estas cuentas. Y, supongamos que estaban en rublos, y decidimos aumentar la precisión y trabajar en kopeks. Para ello, necesitamos hacer una actualización: multiplicar el campo con el monto de la operación por cien.
- En el mundo moderno, utilizamos herramientas automatizadas para el control de versiones de bases de datos. Supongamos, . Escribimos nuestra migración allí. La probamos en nuestra base de datos de prueba. Todo está excelente. La actualización se lleva a cabo. Bloquea el trabajo durante un tiempo, pero obtenemos datos actualizados. Y podemos lanzar nueva funcionalidad basada en esto. Todo ha sido probado y verificado. Todo está confirmado.
- Se realizaron trabajos planificados, se llevó a cabo la migración.
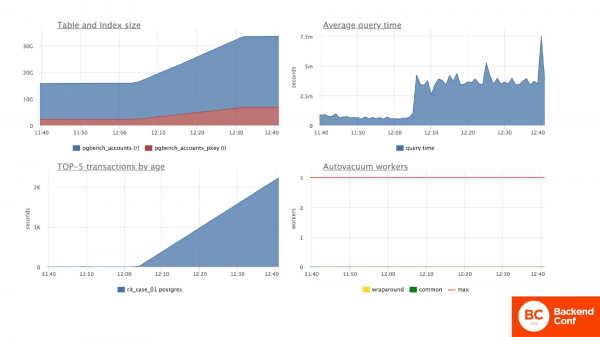
Aquí se presenta la migración con la actualización. Dado que se trata de operaciones en cuentas, la tabla tenía 15 GB. Y como estamos actualizando cada fila, la actualización duplicó el tamaño de la tabla porque reescribimos cada fila.
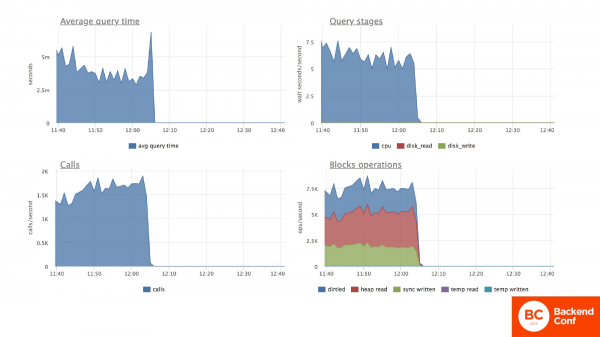
Durante la migración no pudimos hacer nada con esta tabla, porque todas las consultas a ella se pusieron en cola y esperaron a que finalizara esta actualización. Pero aquí quiero llamar su atención sobre los números en el eje vertical. Es decir, tenemos un tiempo medio de consulta antes de la migración de alrededor de 5 milisegundos y una carga en el procesador, el número de operaciones de bloque para la lectura de la memoria del disco es menor que en 7.5.
Realizamos la migración y nuevamente tuvimos problemas.
La migración fue exitosa, pero:
- La funcionalidad antigua comenzó a tardar más en ejecutarse.
- La tabla nuevamente aumentó de tamaño.
- La carga en el servidor nuevamente se volvió mayor que antes.
- Y, por supuesto, mientras seguimos trabajando con la funcionalidad que funcionaba bien, la mejoramos un poco.
Y esto es nuevamente un bloat que nos arruina la vida una vez más.
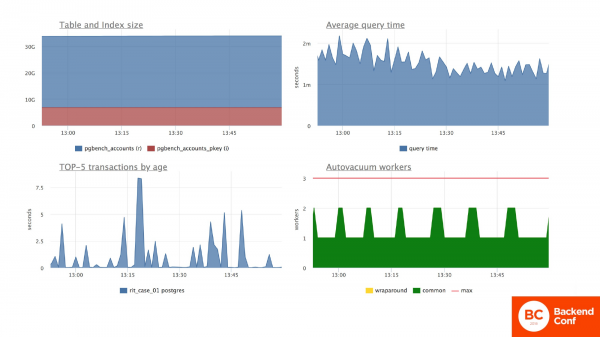
Aquí demuestro que la tabla, al igual que en los dos casos anteriores, no tiene intención de volver a sus tamaños anteriores. La carga promedio del servidor parece ser adecuada.
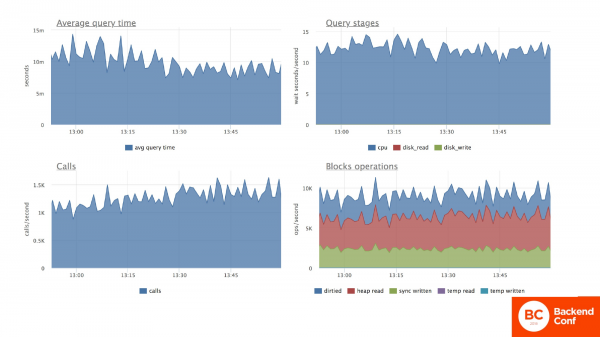
Si consultamos la tabla de cuentas, veremos que el tiempo medio de consulta se ha duplicado con respecto a esta tabla. La carga en el procesador y la cantidad de filas procesadas en memoria ha superado 7.5, mientras que antes estaba por debajo. Además, en el caso de los procesadores, ha aumentado el doble, y en las operaciones por lotes, 1.5 veces, es decir, hemos experimentado una degradación del rendimiento del servidor. Y, como consecuencia, una degradación del rendimiento de nuestra aplicación. Mientras tanto, el número de llamadas se ha mantenido aproximadamente al mismo nivel.
Aquí es fundamental entender cómo hacer correctamente estas migraciones. Y es necesario realizarlas. Hacemos estas migraciones de manera bastante constante.
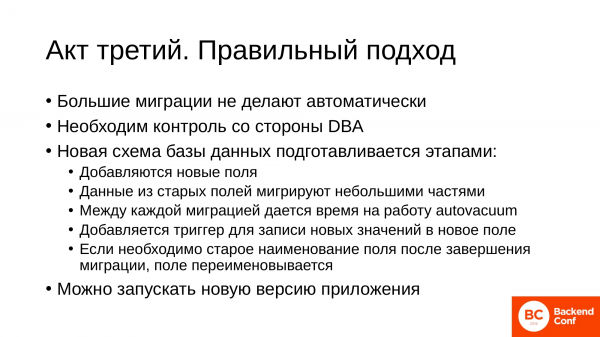
- No se realizan automáticamente tales migraciones grandes. Siempre deben estar controladas.
- Es necesario el control por parte de una persona capacitada. Si tienes un DBA en tu equipo, que lo haga él. Esa es su función. Si no lo tienes, que lo realice la persona más experimentada que sepa cómo trabajar con bases de datos.
- El nuevo esquema de la base de datos, incluso si solo actualizamos una columna, siempre lo preparamos por etapas, es decir, con anticipación antes de implementar una nueva versión de la aplicación:
- Se añaden nuevos campos en los que se registrarán precisamente los datos actualizados.
- Transferimos datos del campo antiguo al nuevo en pequeñas partes. ¿Por qué lo hacemos? En primer lugar, siempre controlamos este proceso. Sabemos cuántos lotes hemos transferido y cuánto nos queda.
- El segundo efecto positivo es que entre cada lote cerramos una transacción, abrimos una nueva y esto permite que el autovacuum procese la tabla y marque las filas muertas para su reutilización.
- Para las filas que aparecerán durante el funcionamiento de la aplicación (todavía está operando la antigua) añadimos un trigger que graba nuevos valores en los nuevos campos. En nuestro caso, esto implica multiplicar el valor antiguo por cien.
- Si somos realmente tercos y queremos usar el mismo campo, al finalizar todas las migraciones y antes de implementar la nueva versión de la aplicación, simplemente renombramos los campos. Los antiguos a algún nombre inventado y los nuevos campos los renombramos a los antiguos.
- Y solo después de eso lanzamos la nueva versión de la aplicación.
Y de esta manera, no tendremos bloat y no perderemos rendimiento.
Aquí concluye la tercera historia.
Y ahora, un poco más sobre las herramientas que mencioné en la primera historia.
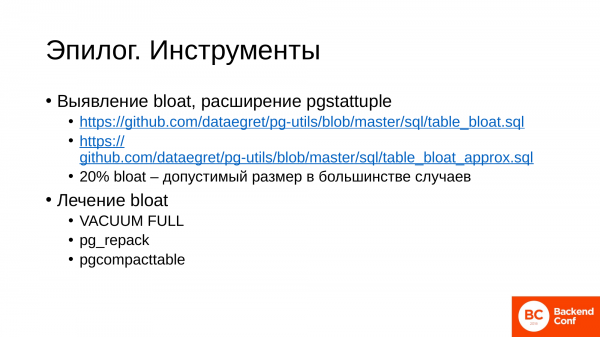
Antes de buscar el bloat, es imprescindible instalar la extensión. .
Para que no tengan que inventar consultas, ya hemos escrito estas consultas en nuestro trabajo. Pueden utilizarlas. Aquí se presentan dos consultas.
- La primera tarda un poco más en ejecutarse, pero te mostrará los valores exactos de bloat en la tabla.
- La segunda es más rápida y muy efectiva cuando necesitas evaluar rápidamente si hay bloat o no en la tabla. Y debes entender que el bloat en la tabla de Postgres siempre está presente. Es una característica de su modelo MVCC.
- Y un 20% de bloat es normal para las tablas en la mayoría de los casos. Es decir, no deberías preocuparte y comprimir esta tabla.
Hemos entendido cómo identificar las tablas que se han inflado, especialmente aquellas que han crecido con datos innecesarios.
Ahora hablemos de cómo corregir el bloat:
- Si tenemos una tabla pequeña y discos buenos, es decir, si la tabla está por debajo de un gigabyte, es perfectamente posible utilizar VACUUM FULL. Te tomará un bloqueo exclusivo sobre la tabla durante unos segundos y listo, pero hará el trabajo de manera rápida y efectiva. ¿Qué hace VACUUM FULL? Toma un bloqueo exclusivo en la tabla y reescribe las filas vivas desde las tablas antiguas a una nueva tabla. Y al final intercambia las tablas. Elimina los archivos antiguos y sustituye lo nuevo por lo viejo. Pero durante su ejecución, toma un bloqueo exclusivo de la tabla. Esto significa que no podrás hacer nada con esa tabla: ni escribir, ni leer, ni modificar. Además, VACUUM FULL requiere espacio adicional en disco para registrar los datos.
- La siguiente herramienta es muy similar a VACUUM FULL en su principio, ya que también reescribe datos de archivos antiguos a nuevos y los intercambia en la tabla. Pero no toma un bloqueo exclusivo sobre la tabla al inicio de su ejecución, sino que solo lo hace cuando ya tiene datos listos para intercambiar. Sus requisitos de recursos de almacenamiento son similares a los de VACUUM FULL. Necesitarás espacio adicional en disco, lo cual puede ser crítico si tienes tablas de varios terabytes. Además, es bastante exigente en cuanto al uso del procesador, debido a que realiza trabajo activo de entrada y salida.
- La tercera utilidad es . Es más cuidadosa con los recursos porque funciona con principios diferentes. La esencia principal de pgcompacttable es que, a través de actualizaciones en la tabla, mueve todas las filas vivas al comienzo de la tabla. Luego ejecuta un vacuum en esta tabla, porque sabemos que al principio están las vivos y al final las muertas. El vacuum recorta esa parte final, es decir, no requiere mucho espacio adicional en disco. Y además, se puede optimizar aún más en cuanto a recursos.
Todo está con las herramientas.
Si te parece interesante el tema de bloat y quieres profundizar más, aquí tienes algunos enlaces útiles:
- – es la presentación de un colega. Es general sobre a dónde va el espacio en Postgres durante su funcionamiento y vida. Hay una sección técnica muy extensa y detallada para administradores de bases de datos sobre el bloat.
- – es un enlace a nuestro repositorio, donde almacenamos un montón de scripts útiles para verificar el estado de la base de datos. Allí puedes encontrar scripts para buscar bloat.
- y enlaces a herramientas que te ayudarán a optimizar las tablas.
- – es una publicación de un colega. Allí analiza de manera bastante seria y técnica el bloat, ya a nivel cercano a los administradores.
Aquí intenté mostrar un aspecto preocupante para los desarrolladores, porque ellos son nuestros principales clientes de bases de datos y deben entender las consecuencias de sus acciones. Espero haberlo logrado. ¡Gracias por su atención!
Preguntas
¡Gracias por la presentación! Hablaste sobre cómo identificar problemas. ¿Cómo se pueden prevenir? Es decir, tuve una situación en la que las consultas se quedaban colgadas no solo porque estaban accediendo a servicios externos. También había algunos joins absurdos. Hubo consultas pequeñas e inocentes que estuvieron colgadas durante un día, y luego comenzaban a causar problemas. Es decir, se parece mucho a lo que describes. ¿Cómo se puede monitorear esto? ¿Se tiene que estar mirando constantemente qué consulta se cuelga? ¿Cómo se puede prevenir?
En este caso, es una tarea para los administradores de tu empresa, no necesariamente para el DBA.
Soy administrador.
En PostgreSQL hay una vista llamada pg_stat_activity, donde se muestran las consultas colgadas. Allí puedes ver cuánto tiempo llevan colgadas.
¿Tengo que entrar cada 5 minutos y revisar?
Configura cron y verifica. Si tienes una consulta prolongada, envía un correo y listo. Es decir, no necesitas mirar manualmente, puedes automatizarlo. Recibirás un correo y reaccionarás a él. También puedes disparar automáticamente.
¿Hay razones evidentes de por qué esto sucede?
He enumerado algunas. Otros ejemplos son más complejos. Y la conversación puede prolongarse.
¡Gracias por la presentación! Quería preguntar sobre la utilidad pg_repack. Si no hace un bloqueo exclusivo, entonces...
Sí, hace un bloqueo exclusivo.
… entonces potencialmente puedo perder datos. ¿Mi aplicación no debería escribir nada en ese momento?
No, funciona sin problemas con la tabla, es decir, pg_repack primero traslada todas las filas activas que hay. Naturalmente, hay alguna escritura en la tabla. Simplemente añade ese último fragmento.
Es decir, ¿al final lo hace?
Al final, toma un bloqueo exclusivo para intercambiar esos archivos.
¿Eso será más rápido que VACUUM FULL?
VACUUM FULL, tan pronto como se inicia, toma inmediatamente un bloqueo exclusivo. Y no lo libera hasta que haya terminado. En cambio, pg_repack toma un bloqueo exclusivo solo en el momento de reemplazar los archivos. En ese momento, no podrás escribir, pero los datos no se perderán, todo estará bien.
¡Hola! Hablaste sobre el funcionamiento del autovacuum. Había un gráfico con celdas rojas, amarillas y verdes. Es decir, las amarillas las marcó como eliminadas. ¿Y, por lo tanto, se puede escribir algo nuevo en ellas?
Sí. Postgres no elimina filas. Tiene esa especificidad. Si actualizamos una fila, marcamos la antigua como eliminada. Se inserta el id de la transacción que cambió esa fila, y escribimos una nueva fila. Y tenemos sesiones que potencialmente pueden leerlas. En algún momento, estas se vuelven muy antiguas. Y la esencia del trabajo del autovacuum es que repasa estas filas y las marca como innecesarias. Y allí se pueden sobrescribir los datos.
Entiendo. Pero la pregunta es un poco diferente. No terminé. Supongamos que tenemos una tabla. Tiene campos de tamaño variable. Y si intento insertar algo nuevo, podría no caber en la antigua celda.
No, de todas formas se actualiza toda la línea. En Postgres hay dos modelos de almacenamiento de datos. Se elige según el tipo de datos. Hay datos que se almacenan directamente en la tabla y hay también tos-datos. Son grandes volúmenes de datos: texto, json. Se almacenan en tablas separadas. Y con estas tablas ocurre la misma historia con el bloat, es decir, todo lo mismo. Simplemente están separadas.
¡Gracias por la presentación! ¿Qué tan aceptable es utilizar la opción statement timeout para limitar la duración de las consultas?
Es muy aceptable. Lo utilizamos en todas partes. Y dado que no tenemos nuestros propios servicios, proporcionamos soporte remoto, hay clientes bastante variados. Y a todos les satisface esto. Es decir, tenemos tareas en cron que hacen verificaciones. Simplemente se acuerda con el cliente la duración de las sesiones, antes de la cual no desconectamos. Esto puede ser un minuto, puede ser 10 minutos. Depende de la carga en la base de datos y su objetivo. Pero todos usamos pg_stat_activity.
¡Gracias por la presentación! Estoy intentando adaptar su informe a mis aplicaciones. Y parece que comenzamos una transacción en todas partes, la terminamos explícitamente en todas partes. Si hay alguna excepción, igual ocurre un rollback. Y aquí me he puesto a pensar. Después de todo, una transacción puede iniciarse de manera implícita. Es una pista para la chica, supongo. Si simplemente actualizo un registro, ¿la transacción se iniciará en PostgreSQL y solo se completará cuando se interrumpa la conexión?
Si hablas ahora del nivel de la aplicación, eso depende del controlador que estés usando, del ORM que se esté utilizando. Hay muchas configuraciones. Si tienes activado el auto commit on, entonces la transacción se inicia y se cierra de inmediato.
Es decir, ¿se cierra inmediatamente después de la actualización?
Eso depende de la configuración. Ya he mencionado una configuración. Es el auto commit on. Es bastante común. Si está habilitada, la transacción se abre y se cierra. Si no has dicho explícitamente "start transaction" y "end transaction", sino que has ejecutado simplemente en la sesión la consulta.
¡Hola! ¡Gracias por la presentación! Supongamos que tenemos una base de datos que se inflando y aquí en el servidor se acaba el espacio. ¿Hay alguna herramienta para solucionar esta situación?
El espacio en el servidor, en principio, debe ser monitoreado.
Por ejemplo, el DBA fue a tomar té, estaba de vacaciones, etc.
Cuando se crea un sistema de archivos, se reserva al menos un espacio de reserva donde no se escriben datos.
¿Y si se reduce a cero?
Ese espacio se llama espacio reservado, es decir, se puede liberar y, dependiendo de cuánto se haya creado, obtienes espacio libre. Por defecto no sé cuánto hay. En otro caso, se necesitan discos para que tengas espacio para realizar una recuperación. Se puede eliminar alguna tabla que estés seguro de que no necesitas.
¿No hay otras herramientas?
Siempre es un trabajo manual. Y en el lugar se determina qué es lo mejor hacer, porque hay datos críticos y no críticos. Y para cada base y aplicación que trabaja con ella, depende del negocio. Siempre se decide en el lugar.
¡Gracias por la presentación! Tengo dos preguntas. En primer lugar, mostraste diapositivas donde se mostraba que en caso de transacciones colgadas, tanto el volumen del espacio de tabla como el tamaño del índice aumentan. Y luego en la presentación había un montón de utilidades que empaquetan la tabla. ¿Y qué pasa con el índice?
También las empaquetan.
Pero el VACUUM no afecta al índice, ¿verdad?
Algunos trabajan con el índice. Por ejemplo, pg_rapack, pgcompacttable. El VACUUM reconstruye los índices, los afecta. La esencia del VACUUM FULL es reescribir todo, es decir, trabaja con todos.
Y la segunda pregunta. No entendí por qué los informes en las réplicas dependen tanto de la misma replicación. Pensaba que los informes eran solo lecturas, y la replicación, escrituras.
¿Dónde surge el conflicto de replicación? Tenemos un Maestro donde ocurren los procesos. Hay un autovacuum. ¿Qué hace realmente el autovacuum? Elimina algunas líneas antiguas. Si en ese momento en la réplica hay una solicitud que lee estas líneas antiguas, y en el Maestro ocurrió una situación en la que el autovacuum marcó estas líneas como posibles para reescribir, entonces las reescribimos. Y tenemos un paquete de datos que debe reescribir esas líneas necesarias para la solicitud en la réplica; el proceso de replicación esperará el tiempo de espera que configuraste. Luego, PostgreSQL decidirá qué es más importante para él. Y la replicación es más importante que la solicitud, por lo que la solicitud se cancelará para realizar esos cambios en la réplica.
Andrei, tengo una pregunta. ¿Esos gráficos maravillosos que mostraste durante la presentación, son el resultado de algún software tuyo? ¿Con qué se construyeron los gráficos?
Este es un servicio .
¿Es un producto comercial?
Sí. Es un producto comercial.
Fuente: habr.com
