

Me llamo Yuri, soy el líder del grupo de administración de sistemas en Sitimobil. Hoy compartiré mi experiencia con la tecnología de aprovisionamiento fino (thin provisioning) de sistemas de archivos Linux y explicaré cómo se puede aplicar en los procesos tecnológicos CI/CD de la empresa. Analizaremos la situación en la que, para realizar pruebas automáticas del código al implementar en producción, necesitamos copias de la base de datos MySQL lo más cercanas posible a la versión 'en vivo', accesibles para lectura y escritura.
Introducción: ¿por qué dar consejos dañinos?
Es una pregunta lógica, ya que existen mecanismos establecidos para migraciones de esquemas de bases de datos a entornos de prueba. ¿Por qué llevar la base de datos principal no shardada a tales volúmenes? Además, no se necesitan todos los datos para las pruebas. Intentaré explicar.
Hace aproximadamente un año, en medio del crecimiento activo de nuestro agregador de taxis (en 2018 aumentamos las operaciones completadas aproximadamente 15 veces), crecieron los volúmenes de datos, la carga en los servidores y la frecuencia de las implementaciones. Nos encontramos en la siguiente situación:
- La base de datos MySQL principal creció hasta aproximadamente 1000 tablas con un volumen total de 2,5 TB, y continuó creciendo.
- No había forma de fragmentar rápidamente y dispersar la base de datos. Esto se debía al antiguo enfoque de 'escribo en la base de datos lo que quiero y como quiero', con un montón de JOINs y dependencias internas en las tablas.
- No había un mecanismo para las migraciones de esquemas de base de datos a entornos de prueba.
- No había pruebas automáticas del código al implementar en producción.
Quería resolver el último problema lo más rápido posible. Ya se habían escrito pruebas de Postman para comprobar el monolito PHP principal, pero faltaba una base de datos actual. Al mismo tiempo, no podíamos crear una réplica por la noche, convertirla en maestro y entregarla para su uso durante el día: un número muy grande de implementaciones y cambios, tanto en los datos como en el esquema de la base de datos, habría hecho que el entorno no funcionara incluso a media jornada. Y restringir las implementaciones a solo la jornada laboral sería ineficaz.
Sin embargo, la tarea se completó: obtuvimos el primer entorno operativo ya después de dos semanas. A lo largo del año pasado, ha sufrido muchos cambios y continúa utilizándose.
A continuación, describiré detalladamente todos los pasos y etapas del desarrollo de nuestra solución. Verás que este método merece existir.
¿Qué es el 'aprovisionamiento fino'?
Esta es una tecnología de hardware o software (otro nombre es volúmenes escasos), que permite asignar más recursos de los que se tienen disponibles. Al mismo tiempo, el volumen asignado debe cumplir con los criterios de just-in-time (lo necesario en el momento justo) y just-enough (sólo lo que se necesita). Principalmente, el aprovisionamiento fino se aplica en diversas SAN para proporcionar espacio en disco en volúmenes que superan los realmente disponibles. La tecnología es compatible con varios sistemas de archivos, como LVM2, ZFS, BTRFS. Se utiliza ampliamente en hipervisores de virtualización. Para nosotros, el aprovisionamiento fino nos permitió crear rápidamente tantas copias de la partición principal de datos (directorio de datos de la base de datos MySQL) a partir de instantáneas como necesitamos.
Primera bancada, tecnología Thin LVM
Este capítulo también se puede llamar 'Cómo hacer instantáneas de grandes volúmenes de datos de la manera más rápida con ', reduciendo la estabilidad del sistema de archivos y de la base de datos MySQL hasta niveles inaceptables.'
Como ya habíamos utilizado LVM para construir las particiones principales del sistema operativo, decidimos comenzar precisamente con esta tecnología. Para empezar, necesitábamos una máquina física separada: una réplica de nuestra base de datos MySQL principal, donde podríamos crear, a pedido, una instantánea de la réplica y levantarla en otra instancia de MySQL. Durante la fase de prueba, permitimos realizar operaciones modificadoras en esta instancia, y al finalizar las pruebas, la eliminamos exitosamente. La configuración del servidor era la siguiente:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD en controlador RAID Adaptec en RAID-10
Sobre la elección entre un controlador RAID y RAID software MD se podría escribir un artículo separado. Solo diré que nuestra elección se vio afectada por dos factores:
- En el momento de establecer la tarea, colocábamos todas las bases de datos en controladores RAID, por lo que se puede decir que así se desarrolló históricamente.
- La diferencia en el rendimiento en pruebas sintéticas del sistema de archivos y pruebas con diversas operaciones en MySQL fue mínima.
Hemos dividido el RAID-10 resultante: creamos un único Grupo de Volumen (VG) para todo el espacio (con sobrecostos de aproximadamente 6,7 GB) y creamos una partición lógica (Logical Volume, LV) para el sistema de 50 GB. En una situación normal, designaríamos el resto del espacio para la partición de MySQL. Pero necesitábamos un almacenamiento fino, así que primero creamos lo que se llama un pool, dentro del cual creamos la partición para /var/lib/mysql de 3,5 TB (en base a los volúmenes de base de datos esperados):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Formateamos la partición en ext4, la montamos, escribimos la réplica y obtuvimos el entorno inicial. Luego hicimos un enlace en forma de API, que debe crear instantáneas, levantar una instancia de BBDD MySQL en un puerto dado y eliminar la instancia creada. Dado que solo se utilizan llamadas del sistema, elegimos bash como el lenguaje de escritura de scripts y como enlace API HTTP → bash implementamos una solución de código abierto , escrito en Go.
Algún día publicaremos nuestros scripts bash en código abierto, pero por ahora simplemente describiré el algoritmo principal:
Creación de la instantánea principal snapmain:
- Detenemos la réplica principal.
- Colocamos un bloqueo en las operaciones con la instantánea snapmain.
- Creamos una nueva instantánea snapmain.
- Iniciamos MySQL y quitamos el bloqueo.
Creación de BBDD en un puerto arbitrario desde snapmain:
- Colocamos un bloqueo en la instancia específica de BBDD (puerto).
- Verificamos la existencia de un bloqueo en la creación de la instantánea principal. Si existe, esperamos y volvemos a verificar cada 5 segundos.
- Verificamos si hay una antigua partición LV de la instancia.
3.1 Si existe, detenemos la instancia de MySQL utilizando kill -9 y eliminamos la partición LV. - Creamos una nueva instancia desde snapmain.
- Preparamos y montamos los directorios para esta instancia.
- Eliminamos las señales de slave (archivos) y comenzamos la instancia de MySQL.
- Hacemos de ella un master.
- Quitamos el bloqueo.
Eliminación de la BBDD en un puerto arbitrario:
- Colocamos un bloqueo en la instancia específica de BBDD (puerto).
- Matamos la instancia de MySQL utilizando kill -9.
- Desmontamos los directorios.
- Eliminamos la partición LV y levantamos el bloqueo.
Ejemplo de comandos para clonar particiones de una nueva instancia de BBDD:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Ahora hablaré sobre el principal problema que enfrentamos al utilizar la reserva fina. Nos encontramos con el rendimiento de los discos SSD. Esto ocurrió debido a las características de Thin LVM: opera a nivel de dispositivo utilizando bloques de baja nivel de 4 MB por defecto. Así es como se presentó la situación:
- Creamos un snapshot de la partición principal /var/lib/mysql.
- Iniciamos la replicación para alcanzar al maestro.
- Cualquier cambio en las tablas de la réplica obliga a guardar bloques de datos antiguos e inalterados en la sección del snapshot.
- Cualquier cambio en la instancia de prueba levantada obliga a guardar bloques de datos antiguos e inalterados en la sección del snapshot clonado para esta instancia.
- Alcanzamos una carga de operaciones de entrada/salida del 100% en el dispositivo, ralentizando cualquier operación y causando un retraso gradual en la réplica.
- Al final de la jornada laboral, tenemos un stand que ha quedado rezagado por varias horas.
Cómo lidiamos con esto para obtener un resultado más razonable (puntos clave):
Controlador RAID:
- Desactivamos por defecto todos los tipos de caché.
- Configuramos el writeback (cuando los datos entran en el búfer, la escritura se completa antes de que se realice el guardado real en el disco).
Sistema de archivos:
- En el punto de montaje /var/lib/mysql especificamos noatime,nodiratime,data=writeback
- Desactivamos el registro de ext4 usando tune2fs.
MySQL:
- Especificamos innodb_flush_method = O_DSYNC (aumentamos la velocidad de escritura, reduciendo así la fiabilidad).
- Desactivamos el registro, no necesitamos logs.
- Especificamos innodb_buffer_pool_size = 4G (cuanto menor sea el tamaño del pool InnoDB, más rápido se apagará MySQL al detenerse y más rápido crearemos el snapshot).
Esta no es una lista completa, especialmente en lo que respecta a MySQL. Sin embargo, los demás cambios son menores y a menudo no se aplican de manera consistente. Por ejemplo, en un intento de aliviar la carga de los discos, incluso trasladamos innodb_parallel_doublewrite_path a /dev/shm, lo que en algunos casos al iniciar una instancia incorrectamente finalizada nos ahorraba hasta 5 segundos.
¿Por qué detenemos MySQL antes de hacer un snapshot? Porque podríamos tomarlo de una réplica en funcionamiento. Es cierto, pero la nueva instancia de la base de datos en este snapshot se considerará dañada por defecto y requerirá un escaneo completo al iniciar. Definitivamente, detener la réplica es más rápido, aunque al final es la operación más prolongada de todo el proceso.
Como resultado, obtuvimos tiempos más aceptables y un stand listo para trabajar. Sin embargo, como se puede ver en el gráfico más elocuente del retraso de replicación de la réplica principal, la situación todavía está lejos de ser ideal:
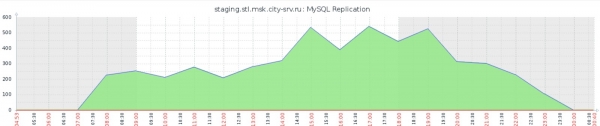
Entre otras desventajas, se debe mencionar la casi imposibilidad de monitorear el grupo Thin LVM: además de las funciones estándar del sistema como iostat, no es posible entender, por ejemplo, qué elemento del grupo está generando la mayor carga en el sistema de archivos.
Cabe destacar una gran desventaja relacionada con la optimización mencionada anteriormente: obtuvimos un stand YOLO. Aproximadamente una vez cada uno o dos meses, ext4 no soportaba tal abuso y se rompía irremediablemente, requiriendo reformateo y recarga de la réplica. Al ganar en velocidad, destruyeron sin esperanza la estabilidad.
¿Qué métricas se deben seguir durante la operación de Thin LVM:
- Porcentaje de datos del grupo delgado
- Porcentaje de metadatos del grupo delgado
Si nuestro stand sobrevive a la falta de espacio para datos (solo es necesario limpiar los discos), la falta de espacio para metadatos conducirá a un colapso total del grupo y a la necesidad de recrearlo desde cero.
El sistema de archivos dentro del grupo se fragmenta mucho con el tiempo. Recomiendo ejecutar a diario, mediante cron, el comando fstrim -v /var/lib/mysql.
Resultados intermedios:
- La tecnología es fácilmente aplicable, al igual que el LVM, y no requiere cualificaciones especiales de los ingenieros.
- Es adecuada para bases de datos pequeñas y no demasiado cargadas. Cuanto más pequeña sea la base de datos, menos fragmentos se mueven por el sistema de archivos dentro del grupo, y menor es la carga en los discos.
- Para nuestra tarea, comenzamos a buscar otras soluciones, de las cuales se hablará en la siguiente sección.
El segundo stand, tecnología ZFS
Hace mucho tiempo traté con el sistema de archivos ZFS, pero entonces funcionaba bastante bien en su sistema operativo nativo Solaris. Existía una versión portado a FreeBSD con un nivel de implementación bastante bueno. También había un puerto incompleto en Linux que pocos utilizaban. Debido a la estructura de almacenamiento de datos B-tree (por cierto, la misma estructura de almacenamiento que InnoDB de MySQL), ZFS tuvo un rendimiento deficiente en instalaciones con un número muy grande de archivos. Todo esto, junto con la necesidad de aprender la teoría antes de usarlo, eliminó esta experiencia de mi práctica durante mucho tiempo. Aparecieron ext4 y xfs, que se convirtieron en el estándar. Pero considerando que ZFS se adapta muy bien a nuestra tarea, y que la versión de Linux, según los comentarios, ha evolucionado en un producto bastante decente (aunque no con soporte completo, por lo que instalar un sistema en ZFS desde cero solo se puede hacer con varios trucos), decidimos probarlo.
Por razones obvias, elegimos un stand con una configuración similar (excepto por el controlador RAID). Instalamos ocho discos SSD de 1920 GB. No teníamos ganas de escribir nuestra propia imagen de red para cargar el servidor en un ZFS virgen, así que tomamos 50 GB de cada disco y creamos un RAID-10 MD para el sistema. Combinamos los restantes 1950 GB en un ZFS análogo de RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Creamos las particiones para MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Tenga en cuenta que hemos habilitado la compresión de datos gzip estándar. Tenemos muchos recursos de CPU en el servidor y no están completamente utilizados. Como resultado, nuestros 3 TB de base de datos se convirtieron en 1.6 TB, y dado que el eslabón débil, al igual que en el caso anterior, son las máximas prestaciones de los discos, cuanto menos datos haya, mejor. Desde el principio obtuvimos un excelente bono de ZFS. En hora pico, con la carga máxima para mantener gzip, se utilizan hasta 4 núcleos, pero no nos quejamos.
Luego, la implementación avanzó más rápido. Copiamos las configuraciones de réplica de MySQL del stand de LVM. Tuvimos que dedicar algo de tiempo a reescribir los scripts a los comandos de ZFS, pero en general los algoritmos permanecieron iguales. Ejemplo de creación de un snapshot:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
De la optimización adicional: hemos extraído a la memoria las secciones ZFS con metadatos y registros l2arc y zil. Para nuestra tarea, como resultó más adelante, esto fue excesivo, pero por ahora hemos dejado esta optimización, cambiarlo en caso de necesidad no es complicado. Entre los efectos negativos, está el tener que recrear las áreas de memoria correspondientes después de reiniciar el servidor. Los datos, en este caso, no se pierden. Extracto de zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
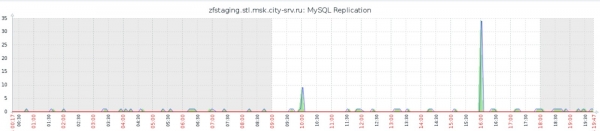
Con esta configuración comenzamos a probar el entorno y obtuvimos excelentes resultados: con dos instancias de la base de datos funcionando simultáneamente (y una réplica principal activa) sobre las instantáneas, obtuvimos una carga de disco del 50-60%.
Hemos eliminado nuestro problema principal, lo que se puede ver en el gráfico de retraso de replicación (comparar con el gráfico anterior en la sección Thin LVM):
Además, y gracias a esto, hemos acelerado significativamente en todas las operaciones: la creación completa de una instantánea con la detención y el reinicio de la réplica tarda hasta 40 segundos, el despliegue de una nueva instancia de MySQL a partir de una instantánea lleva hasta 20 segundos. Lo que satisface más que adecuadamente a nosotros y a nuestras pruebas de código.
Resultados intermedios:
- Los resultados satisfacen completamente nuestra necesidad de obtener una copia de la base de datos de producción para pruebas de código.
- La tecnología requiere aprendizaje: hay que entender qué es ZFS y cómo trabajar con él.
- No hemos comprobado el estado actual de ZFS con una gran cantidad (más de 1 millón) de archivos pequeños. Pero suponemos que el problema persiste, por lo que no recomendaría este sistema de archivos para ningún tipo de almacenamiento de archivos.
¿Qué sigue?
En el marco del stand no hacer más nada, el resultado nos satisface. Quizás más adelante añadamos en la configuración de replicación del stand excepciones para tablas que no son necesarias para las pruebas, lo que reducirá aún más el volumen de la base de datos. No hemos probado el sistema BTRFS y su implementación de la tecnología de respaldo fino. Sin embargo, esa tarea ya no es prioritaria, ya que el objetivo principal ha sido alcanzado. En general, por supuesto, nos gustaría alejarnos del enfoque descrito anteriormente: implementar migraciones de base de datos funcionales en el entorno de pruebas, crear un contorno de prueba de base de datos separado, trabajar en la fragmentación de la base de datos principal. Mucho de esto ya lo estamos llevando a cabo, lo que definitivamente compartiremos en artículos futuros.
Resultados
La tarea inicial se resolvió, aunque de una manera inusual. En los resultados intermedios se describieron las ventajas y desventajas de cada una de las tecnologías aplicadas, por lo que decidamos qué tecnología y cuándo se puede utilizar:
- Thin LVM — en bases de datos pequeñas y cuando no se quiere o no hay tiempo para estudiar ZFS.
- ZFS — si hay experiencia en su uso o la posibilidad de dedicar tiempo a su estudio en cualquier situación.
A un nivel más alto de representación, este artículo no es solo una comparación de la tecnología de dos sistemas de archivos. La idea principal que me gustaría transmitir y consolidar es que no debemos tener miedo de pensar de manera no convencional en situaciones críticas para el negocio y de seguir solo recetas preestablecidas. En su momento, todo el departamento técnico podría haber sacudido la cabeza y haber dicho que la tarea de crear copias de seguridad de base de datos de tres terabytes en menos de un minuto era inejecutable, y que no necesitábamos tecnologías arriesgadas, que hiciéramos como debíamos. Eso era posible, pero habríamos perdido alrededor de seis meses a un año y muchos viajes de clientes (los viajes son nuestro principal indicador comercial) sin pruebas y durante la implementación. Actuando de manera no convencional, no perdimos tanto tiempo en la implementación, ganamos experiencia en nuevas y olvidadas tecnologías, y proporcionamos las pruebas precisamente en el momento en que las necesitábamos mucho. Sin duda, esto tuvo un impacto positivo en todos nuestros indicadores. La elección siempre es suya, y de nuestra parte, continuaremos hablando en nuestro blog sobre logros actuales y futuros interesantes.
Fuente: habr.com
