

¡Saludos a todos!
Me llamo Nikita, soy el líder del equipo de ingenieros en Cian. Una de mis responsabilidades en la empresa es reducir a cero la cantidad de incidentes relacionados con la infraestructura en producción.
Lo que se abordará a continuación nos ha causado mucho dolor, y el objetivo de este artículo es evitar que otras personas cometan nuestros errores o al menos minimizar su impacto.
Preámbulo
Hace mucho tiempo, cuando Cian consistía en monolitos y no había rastros de microservicios, medíamos la disponibilidad del recurso verificando de 3 a 5 páginas.
Responden: todo está bien, no responden por un largo tiempo: alerta. Cuánto tiempo deben estar fuera de servicio para que se considere un incidente, lo decidían las personas en las reuniones. El equipo de ingenieros siempre participaba en la investigación del incidente. Cuando se concluía la investigación, escribían un postmortem, un informe que se enviaba por correo en el formato: qué ocurrió, cuánto duró, qué hicimos en el momento, qué haremos en el futuro.
Páginas principales del sitio o cómo entendemos que hemos tocado fondo
Para poder entender de alguna manera la prioridad del error, destacamos las páginas del sitio más críticas para la funcionalidad del negocio. Sobre ellas, contamos la cantidad de solicitudes exitosas/no exitosas y los timeouts. De esta manera, medimos el uptime.
Supongamos que hemos determinado que hay una serie de secciones super importantes del sitio que son responsables del servicio principal: búsqueda y presentación de anuncios. Si el número de solicitudes que finalizan con error supera el 1%, se considera un incidente crítico. Si durante 15 minutos en la hora pico el porcentaje de errores supera el 0,1%, eso también se considera un incidente crítico. Estos criterios cubren la mayor parte de los incidentes, los demás quedan fuera del alcance de este artículo.
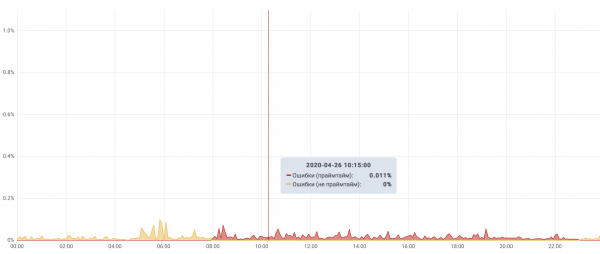
Los mejores incidentes de Cian
Así que hemos aprendido a determinar con precisión que un incidente ha ocurrido.
Ahora cada incidente está detalladamente descrito y reflejado en un epico de Jira. Por cierto: para esto hemos creado un proyecto separado y lo llamamos FAIL, en el que solo se pueden crear épicos.
Si recopilamos todos los fallos de los últimos años, los líderes son:
- incidentes relacionados con mssql;
- incidentes causados por factores externos;
- errores de administrador.
Detengámonos a detallar más sobre los errores de los administradores, así como sobre otros fallos interesantes.
Quinto lugar — 'Organizando el DNS'
Era un martes lluvioso. Decidimos ordenar el clúster DNS.
Quisimos migrar los servidores DNS internos de bind a powerdns, dedicando servidores totalmente separados, donde no hubiera nada más que DNS.
Colocamos un servidor DNS en cada ubicación de nuestros centros de datos, y llegó el momento de migrar las zonas de bind a powerdns y cambiar la infraestructura a los nuevos servidores.
En medio de la migración, de todos servidores, que estaban indicados en las cachés locales de bind en todos los servidores, solo quedó uno, que estaba en el centro de datos de San Petersburgo. Este centro de datos había sido declarado inicialmente como no crítico para nosotros, pero de repente se convirtió en un punto único de falla.
Justo en ese período de migración falló el canal entre Moscú y San Petersburgo. Nos quedamos sin DNS durante cinco minutos y volvimos en línea cuando ofrezca una gran cantidad de espacio en disco. se resolvieron los problemas.
Conclusiones:
Si antes ignorábamos factores externos durante la preparación para las tareas, ahora también los incluimos en la lista de lo que estamos preparando. Y ahora nos esforzamos por que todos los componentes estén reservados n-2, y durante el tiempo de trabajo podemos reducir este nivel a n-1.
- Al elaborar el plan de acción, marque los puntos donde el servicio puede caer y desarrolle un escenario donde todo salga "peor que nunca", por adelantado.
- Distribuya los servidores DNS internos en diferentes ubicaciones geográficas/data centers/baterías/conmutadores/entradas.
- En cada servidor, instale un servidor DNS local caché que redirija las solicitudes a los servidores DNS principales, y en caso de que no esté disponible, responderá desde la caché.
El cuarto lugar - "Organizando Nginx"
Un buen día, nuestro equipo decidió que "ya era suficiente" y se inició el proceso de refactorización de las configuraciones de nginx. El objetivo principal es dar a las configuraciones una estructura intuitiva. Antes, todo era "históricamente" y no tenía ninguna lógica. Ahora cada server_name se ha llevado a un archivo del mismo nombre y hemos distribuido todas las configuraciones en carpetas. Por cierto, la configuración contiene 253949 líneas o 7836520 caracteres y ocupa casi 7 megabytes. El nivel superior de la estructura:
Estructura de Nginx
├── acceso
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Ha mejorado significativamente, pero durante el proceso de renombrar y redistribuir las configuraciones, algunas de ellas tenían una extensión incorrecta y no se incluyeron en la directiva include *.conf. Como consecuencia, algunos hosts se volvieron inaccesibles y devolvían un 301 a la página principal. Dado que el código de respuesta no era 5xx/4xx, no se notó de inmediato, sino más bien por la mañana. Después de eso, comenzamos a escribir pruebas para verificar los componentes de la infraestructura.
Conclusiones:
- Estructura correctamente las configuraciones (no solo nginx) y planifica la estructura en las primeras etapas del proyecto. Esto las hará más comprensibles para el equipo, lo que a su vez reducirá el TTM.
- Para algunos componentes de infraestructura, escribe pruebas. Por ejemplo: verifica que todos los server_name clave devuelvan el estado correcto, más el cuerpo de la respuesta. Solo se necesitará tener a la mano unos pocos scripts que verifiquen las funciones principales del componente, para no recordar frenéticamente a las 3 de la mañana que más hay que comprobar.
Tercer lugar: 'Repentinamente se acabó el espacio en Cassandra'
Los datos crecían de manera constante y todo iba bien hasta que en el clúster de Cassandra comenzaron a fallar las reparaciones de grandes keyspaces, porque no pueden ejecutar la compactación.
En un día desafortunado, el clúster casi se convierte en calabaza, a saber:
- quedaba alrededor del 20% de espacio total en el clúster;
- no se pueden agregar nodos completamente, porque no pasa la limpieza después de agregar un nodo debido a la falta de espacio en las particiones;
- el rendimiento disminuye poco a poco, ya que no funciona la compactación;
- el clúster opera en modo de emergencia.
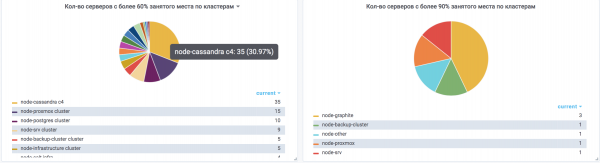
La salida: se añadieron 5 nodos más sin limpieza, después de lo cual comenzamos a retirar progresivamente del clúster e introducir nuevamente, como nodos vacíos, en los que se había agotado el espacio. Se ha gastado mucho más tiempo del que quisiéramos. Había un riesgo de indisponibilidad parcial o total del clúster.
Conclusiones:
- En todos los servidores de Cassandra, no debe ocupar más del 60% del espacio en cada partición.
- Deben estar cargados no más del 50% de uso de CPU.
- No se debe descuidar la planificación de capacidad y debe pensarse para cada componente, dependiendo de sus características.
- Cuantos más nodos en el clúster, mejor. Los servidores que contienen un volumen pequeño de datos se reconfiguran más rápido, y tal clúster es más fácil de reanimar.
Segundo lugar: 'Se perdieron datos del almacenamiento key-value de Consul'
Para el descubrimiento de servicios, nosotros, como muchos, usamos Consul. Pero en nuestro caso, su key-value se utiliza también para el despliegue blue-green del monolito. Allí se almacena información sobre los upstream activos e inactivos, que cambian de lugar durante el despliegue. Para ello, se escribió un servicio de despliegue que interactuaba con KV. En algún momento, los datos de KV desaparecieron. Se recuperaron de memoria, pero con varios errores. Como resultado, durante el despliegue, la carga en los upstream se distribuyó de manera desigual y obtuvimos muchos errores 502 debido a la sobrecarga de los backend por CPU. Al final, migramos de Consul KV a Postgres, desde donde ya no es tan fácil eliminarlos.
Conclusiones:
- Los servicios sin ningún tipo de autorización no deben contener datos críticos para el funcionamiento del sitio. Por ejemplo, si no tiene autorización en ES, es mejor prohibir el acceso a nivel de red desde donde no sea necesario, dejando solo los accesos necesarios, así como configurar action.destructive_requires_name: true.
- Pruebe el mecanismo de copia de seguridad y restauración con antelación. Por ejemplo, prepare un script (por ejemplo, en Python) que pueda hacer copias de seguridad y restaurar.
Primer lugar: 'Capitán Obviedad'
En algún momento, notamos una distribución desigual de carga en los upstreams de nginx cuando había más de 10 servidores en el backend. Debido a que el round-robin dirigía las solicitudes desde el primer hasta el último upstream de manera secuencial, y cada recarga de nginx comenzaba de nuevo, los primeros upstreams siempre recibían más solicitudes que los demás. Como consecuencia, funcionaban más lentamente y todo el sitio sufría. Esto se volvía cada vez más evidente a medida que aumentaba el tráfico. Simplemente actualizar nginx para incluir random no funcionó; había que rehacer un montón de código Lua que no funcionaba en la versión 1.15 (en ese momento). Tuvimos que parchar nuestro nginx 1.14.2, incorporando soporte para random. Esto resolvió el problema. Este error se lleva el premio a «capitán de la obviedad».
Conclusiones:
Fue muy interesante y emocionante investigar este error).
- Configura el monitoreo de tal manera que ayude a detectar rápidamente fluctuaciones similares. Por ejemplo, puedes utilizar ELK para observar el rps de cada backend de cada upstream, y seguir su tiempo de respuesta desde la perspectiva de nginx. En este caso, eso nos ayudó a identificar el problema.
En la mayoría de los fallos se podría haber evitado con un enfoque más meticuloso sobre lo que se está haciendo. Siempre hay que recordar la ley de Murphy: Anything that can go wrong will go wrong, y construir componentes guiándose por ella.
Fuente: habr.com
