

Hoy comenzaremos a estudiar la enrutación mediante el protocolo OSPF. Este tema, al igual que el análisis del protocolo EIGRP, es crucial en todo el curso de CCNA. Como pueden ver, la sección 2.4 se titula ‘Configuración, comprobación y resolución de problemas de OSPFv2 en una sola zona y múltiples zonas para el protocolo IPv4 (excluyendo autenticación, filtrado, resumen manual de rutas, redistribución, área de punto muerto, red virtual y LSA)’.
El tema OSPF es bastante amplio, por lo que ocupará 2, posiblemente 3 vídeos educativos. La clase de hoy se centrará en el aspecto teórico, les explicaré qué es este protocolo en términos generales y cómo funciona. En el siguiente vídeo, pasaremos al modo de configuración de OSPF usando Packet Tracer.
Así que en esta lección veremos tres cosas: qué es OSPF, cómo funciona y qué son las zonas OSPF. En la lección anterior hablamos de que OSPF es un protocolo de enrutamiento tipo Link State, que explora los canales de comunicación entre routers y toma decisiones basadas en la velocidad de esos canales. Un canal largo con mayor velocidad, es decir, con mayor ancho de banda se prioriza frente a un canal corto con menor ancho de banda.
El protocolo RIP, siendo de vector de distancia, elegirá un camino de un salto, incluso si este canal tiene baja velocidad, mientras que el protocolo OSPF elegirá una ruta más larga de varios saltos, si la velocidad total de esta ruta es superior a la velocidad del tráfico en la ruta corta.
Más adelante examinaremos el algoritmo de toma de decisiones, por ahora deben recordar que OSPF es un protocolo de estado de enlace. Este estándar abierto fue creado en 1988, por lo que cualquier fabricante de equipo de red y proveedor de red podría adoptarlo. Por eso, OSPF es mucho más popular que EIGRP.
El protocolo OSPF versión 2 solo admite el protocolo IPv4, y un año después, en 1989, los desarrolladores anunciaron el lanzamiento de la versión 3, que admite IPv6. Sin embargo, la versión 3 de OSPF completamente funcional para IPv6 solo estuvo disponible en 2008. ¿Por qué se eligió OSPF? En la última lección vimos que este protocolo de puerta de enlace interna realiza la convergencia de rutas mucho más rápido que RIP. Es un protocolo sin clase.
Si recuerdas, RIP es un protocolo de clase, es decir, no envía información sobre la máscara de subred, y si se encuentra con una dirección IP de clase A/24, no la aceptará. Por ejemplo, si le presentas una dirección IP como 10.1.1.0/24, la interpretará como la red 10.0.0.0 porque no entiende cuando la red se divide en subredes usando más de una máscara de subred.
OSPF es un protocolo seguro. Por ejemplo, si dos enrutadores intercambian información OSPF, puedes configurar la autenticación de tal manera que compartir información con un enrutador vecino requiera ingresar una contraseña. Como ya mencionamos, es un estándar abierto, así que muchos fabricantes de equipos de red utilizan OSPF.
En un sentido global, OSPF representa un mecanismo para intercambiar anuncios de estado de enlace, Link State Advertisement, o LSA. Los mensajes LSA son generados por el enrutador y contienen mucha información: un identificador único del enrutador, router-id, datos sobre las redes que conoce el enrutador, información sobre su costo y más. Toda esta información es necesaria para que el enrutador tome decisiones sobre el enrutamiento.
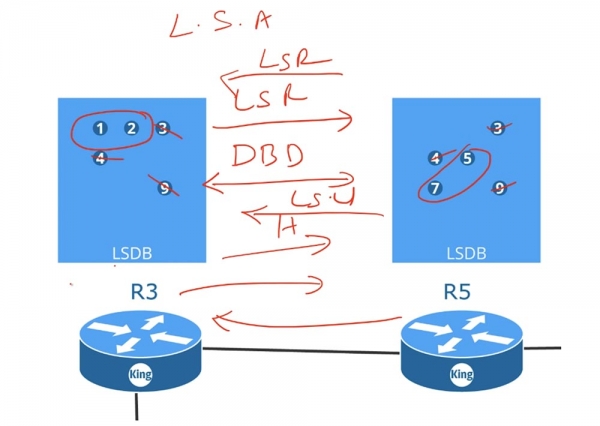
El enrutador R3 envía su información LSA al enrutador R5, y el enrutador R5 comparte su información LSA con R3. Estos LSA representan una estructura de datos que forma la base de datos de estado de enlace, Link State Data Base, o LSDB. El enrutador recopila todos los LSA recibidos y los coloca en su LSDB. Una vez que ambos enrutadores han creado sus bases de datos, intercambian mensajes Hello, que sirven para detectar vecinos, y proceden a la comparación de sus LSDB.
El enrutador R3 envía al enrutador R5 un mensaje DBD, o 'descripción de base de datos', y R5 envía su DBD al enrutador R3. Estos mensajes contienen los índices de LSA que están en las bases de datos de cada enrutador. Al recibir el DBD, el enrutador R3 envía una solicitud de estado de red LSR al enrutador R5, indicando: 'ya tengo los mensajes 3, 4 y 9, así que solo envíame 5 y 7'.
De la misma manera actúa el R5, informando al tercer enrutador: «tengo información 3, 4 y 9, así que mándenme 1 y 2». Al recibir las solicitudes LSR, los enrutadores envían de vuelta paquetes de actualización del estado de la red LSU, es decir, en respuesta a su LSR, el tercer enrutador recibe LSU del enrutador R5. Después de que los enrutadores actualizan sus bases de datos, todos ellos, incluso si tiene 100 enrutadores, tendrán las mismas bases LSDB. Una vez que se han creado las bases de datos LSDB en los enrutadores, cada uno conocerá toda la red en su totalidad. El protocolo OSPF utiliza el algoritmo Shortest Path First para crear la tabla de enrutamiento, por lo que una condición primordial para su correcto funcionamiento es la sincronización de la LSDB de todos los dispositivos en la red.
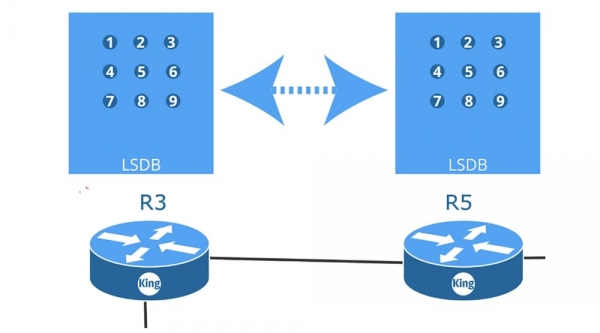
En el diagrama presentado, hay 9 enrutadores, cada uno de los cuales intercambia mensajes LSR, LSU, etc. Todos están interconectados entre sí a través de interfaces tipo p2p, o «punto a punto», que soportan el funcionamiento del protocolo OSPF, y se comunican entre sí con el fin de crear LSDB idénticas.
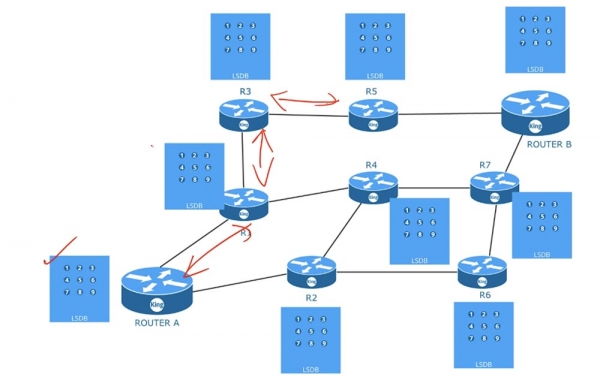
Una vez que las bases estén sincronizadas, cada enrutador, utilizando el algoritmo de camino más corto, formará su tabla de enrutamiento. Las tablas de diferentes enrutadores serán distintas. Es decir, todos los enrutadores utilizan la misma LSDB, pero crean tablas de enrutamiento basadas en sus propias consideraciones sobre los caminos más cortos. Para utilizar este algoritmo, OSPF necesita una actualización regular de la base LSDB.
Por lo tanto, para su propio funcionamiento, OSPF debe primero cumplir 3 condiciones: encontrar vecinos, crear y actualizar la LSDB, y formar la tabla de enrutamiento. Para cumplir la primera condición, es posible que el administrador de red necesite configurar manualmente el router-id, los tiempos o la máscara comodín. En el siguiente video abordaremos la configuración del dispositivo para trabajar con OSPF; por ahora, debe saber que este protocolo utiliza una máscara inversa, y si no coincide, si no coinciden sus subredes, o si la autenticación no coincide, la vecindad de los enrutadores no podrá formarse. Por lo tanto, al solucionar problemas de funcionamiento de OSPF, debe averiguar por qué no se está formando esa vecindad, es decir, verificar la coincidencia de los parámetros mencionados anteriormente.
Como administrador de red, no participas en el proceso de creación del LSDB. La actualización de las bases de datos ocurre automáticamente después de que se establece la vecindad entre los enrutadores, al igual que la construcción de las tablas de enrutamiento. Todo esto lo realiza el propio dispositivo, configurado para trabajar con el protocolo OSPF.
Veamos un ejemplo. Tenemos 2 enrutadores, a los que para simplificar he asignado las identificaciones RID 1.1.1.1 y 2.2.2.2. Tan pronto como los conectemos, el enlace pasará inmediatamente al estado activo, porque primero configuré estos enrutadores para trabajar con OSPF. Una vez que se establezca el enlace, el enrutador A enviará de inmediato un paquete Hello al segundo. Este paquete contendrá información de que este enrutador aún no ha "visto" a nadie en este enlace, ya que está enviando Hello por primera vez, así como su propio identificador, datos sobre la red a la que está conectado y otra información que puede compartir con el vecino.
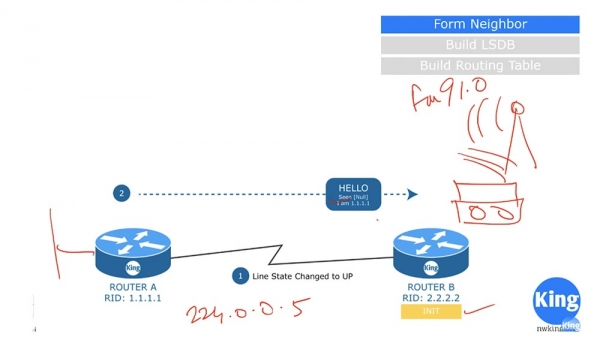
Al recibir este paquete, el enrutador B dirá: "Veo que en este enlace hay un candidato potencial para la vecindad del protocolo OSPF" y pasará al estado de inicialización Init state. El paquete Hello no es un mensaje unicast o broadcast, es un paquete multicast que se envía a la dirección IP multicast OSPF 224.0.0.5. Algunas personas preguntan cuál es la máscara de subred para multicast. La cuestión es que el multicast no tiene máscara de subred, se transmite como una señal de radio que todos los dispositivos configurados para su frecuencia pueden escuchar. Por ejemplo, si deseas escuchar una radio FM que transmite en la frecuencia 91,0, debes sintonizar tu receptor de radio a esa frecuencia.
De la misma manera, el enrutador B está configurado para recibir mensajes para la dirección multicast 224.0.0.5. Al escuchar este canal, recibe el paquete Hello que envió el enrutador A y le responde con su propio mensaje.
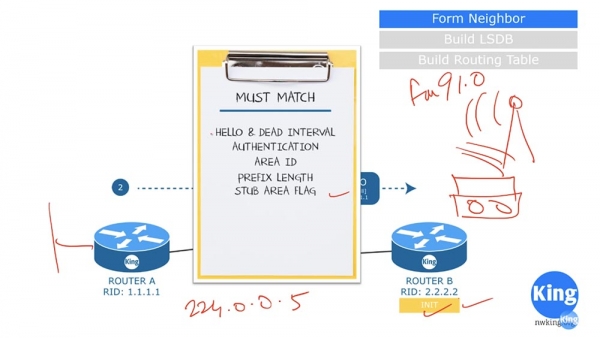
Sin embargo, la vecindad solo se puede establecer si la respuesta de B cumple con un conjunto de criterios. El primer criterio es que la frecuencia de envío de mensajes Hello y el intervalo de espera de respuesta a este mensaje, Dead Interval, deben coincidir en ambos enrutadores. Normalmente, Dead Interval es igual a varios valores del temporizador Hello. Así, si el Hello Timer del enrutador A es de 10 s, y el enrutador B le envía un mensaje después de 30 s mientras que el Dead Interval es de 20 s, la vecindad no se establecerá.
El segundo criterio es que ambos enrutadores deben usar el mismo tipo de autenticación. Por lo tanto, las contraseñas de autenticación también deben coincidir.
El tercer criterio es la coincidencia de los identificadores de zona Arial ID, y el cuarto es la coincidencia de la longitud del prefijo de red. Si el enrutador A informa un prefijo /24, entonces el enrutador B también debe tener un prefijo de red /24. En el siguiente video lo veremos en más detalle, por ahora mencionaré que no se trata de una máscara de subred; aquí los enrutadores utilizan una máscara inversa llamada Wildcard mask. Y, por supuesto, las banderas de la zona de punto muerto Stub area también deben coincidir, si los enrutadores están en esta zona.
Después de verificar estos criterios, en caso de coincidencia, el enrutador B envía a el enrutador A su paquete Hello. A diferencia del mensaje A, el enrutador B informa que ha visto al enrutador A y se presenta a sí mismo.
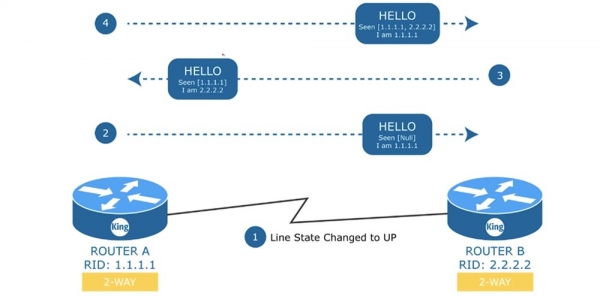
En respuesta a este mensaje, el enrutador A vuelve a enviar un Hello al enrutador B, en el que confirma que también ha visto al enrutador B, el canal de comunicación entre ellos consiste en los dispositivos 1.1.1.1 y 2.2.2.2, y él mismo es el dispositivo 1.1.1.1. Esta es una etapa muy importante en el establecimiento de la vecindad. En este caso se utiliza una conexión bidireccional 2-WAY, pero ¿qué sucederá si tenemos un switch con una red distribuida de 4 enrutadores? En un entorno tan "compartido", uno de los enrutadores debe desempeñar el papel de enrutador designado Designated router D.R., y el segundo, como enrutador designado de respaldo Backup designated router, B.D.R.
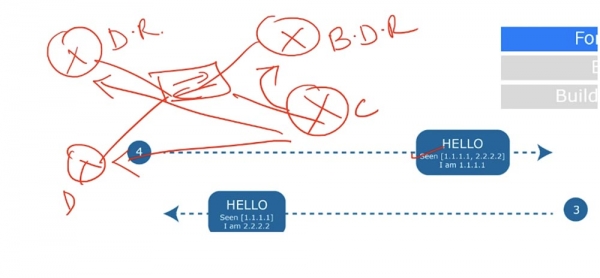
Cada uno de estos dispositivos formará una conexión Full connection, o estado de plena adyacencia, más adelante veremos qué significa eso, sin embargo, este tipo de conexión solo se establecerá con D.R. y B.D.R; entre sí, los otros dos enrutadores D y B seguirán comunicándose a través de un esquema de conexión bidireccional "point-to-point".
Es decir, con D.R. y B.D.R, todos los enrutadores establecen una relación de plena adyacencia, mientras que entre ellos tienen una conexión de tipo point-to-point. Esto es muy importante, porque en una conexión bidireccional entre dispositivos adyacentes, todos los parámetros del paquete Hello deben coincidir. En nuestro caso, todo coincide, por lo que los dispositivos forman la vecindad sin problemas.
Una vez que se establezca la comunicación bidireccional, el router A envía al router B un paquete de Descripción de Base de Datos, o 'database description', y pasa al estado ExStart — inicio del intercambio, o espera de carga. La Descripción de Base de Datos es la información similar a un índice de un libro: es un listado de todo lo que hay en la base de datos de enrutamiento. En respuesta, el router B envía su descripción de base de datos al router A y pasa al estado de intercambio de datos sobre canales, Exchange. Si en el estado Exchange el router detecta que le falta alguna información en su base de datos, cambiará al estado de carga LOADING y comenzará a intercambiar mensajes LSR, LSU y LSA con su vecino.
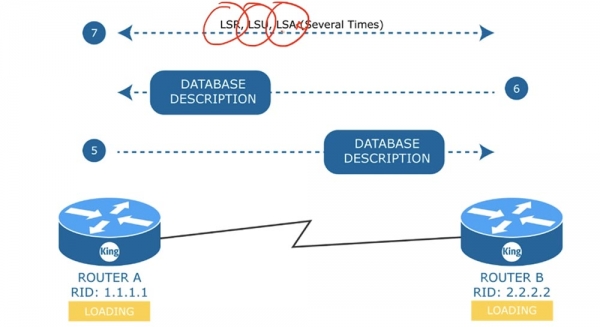
Así, el router A enviará a su vecino un LSR, a lo que este responderá con un paquete LSU, y el router A a su vez responderá al router B con un mensaje LSA. Este intercambio ocurrirá tantas veces como los dispositivos deseen intercambiar mensajes LSA. El estado LOADING significa que la actualización completa de la base de datos LSA aún no ha tenido lugar. Después de cargar todos los datos, ambos dispositivos pasarán al estado de plena adyacencia FULL.
Cabe señalar que en una conexión bidireccional los dispositivos están simplemente en estado de vecindad, y el estado de plena adyacencia solo es posible entre los routers D.R. y B.D.R. Esto significa que cada router informa al D.R. sobre los cambios en la red, y todos los routers se enteran de estos cambios a través del D.R.
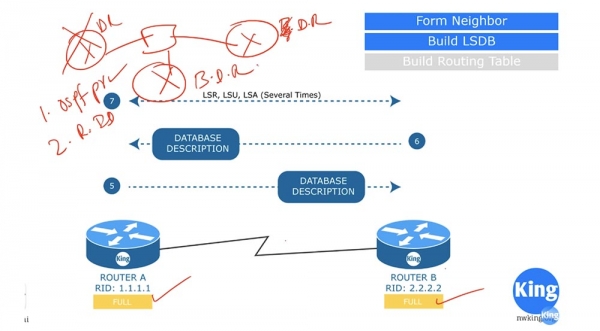
La elección de D.R. y B.D.R. es una cuestión importante. Veamos cómo se elige un D.R. en un entorno general. Supongamos que en nuestro esquema hay tres routers y un switch. Primero, los dispositivos OSPF comparan las prioridades en los mensajes Hello, y luego comparan el Router ID.
El dispositivo con la prioridad más alta se convierte en D.R. Si las prioridades de dos dispositivos coinciden, de entre ellos se elige el dispositivo con el Router ID más alto, que se convierte en D.R.
El router designado como B.D.R. es el dispositivo con la segunda prioridad más alta o el segundo Router ID más alto. Si el D.R. falla, el B.D.R. lo reemplazará inmediatamente. Este comenzará a actuar como D.R., y el sistema elegirá otro B.D.R.
Espero que hayas entendido la elección de D.R. y B.D.R. Si no, regresaré a este tema en uno de los próximos videos y explicaré este proceso.
Así que hemos revisado qué son Hello, la descripción de la base de datos Database Descriptor y los mensajes LSR, LSU y LSA. Antes de pasar al siguiente tema, hablemos un poco sobre el costo de OSPF.
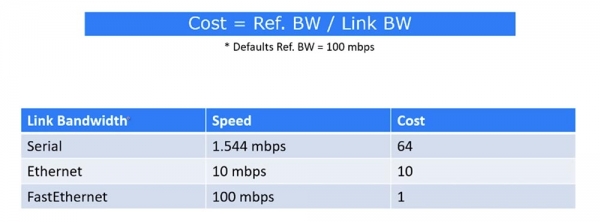
En Cisco, el costo de la ruta se calcula usando la fórmula de la relación entre el ancho de banda de referencia, que por defecto se considera igual a 100 Mbps, y el costo del enlace. Por ejemplo, al conectar dispositivos a través de un puerto serie, la velocidad es de 1.544 Mbps, y el costo será 64. Al usar conexión Ethernet con una velocidad de 10 Mbps, el costo es 10, mientras que el costo de una conexión FastEthernet a 100 Mbps será 1.
Al usar Gigabit Ethernet, tenemos una velocidad de 1000 Mbps, sin embargo, en este caso la velocidad siempre se toma como 1. Así, si hay Gigabit Ethernet en tu red, debes cambiar el valor por defecto de Ref. BW a 1000. En este caso, el costo será 1, y toda la tabla se recalculará multiplicando los valores de costo por 10. Después de que hemos formado la vecindad y construido la base de datos LSDB, pasamos a construir la tabla de rutas.
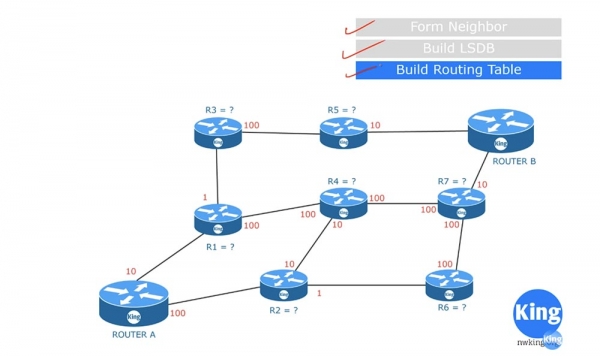
Después de obtener el LSDB, cada uno de los enrutadores comienza a formar su lista de rutas usando el algoritmo SPF. En nuestro esquema, el enrutador A creará tal tabla para sí mismo. Por ejemplo, calcula el costo de la ruta A-R1 y lo determina como 10. Para simplificar la comprensión del esquema, supongamos que el enrutador A determina la ruta óptima al enrutador B. El costo de la conexión A-R1 es 10, la conexión A-R2 es 100, y el costo de la ruta A-R3 es 11, es decir, la suma de la ruta A-R1(10) y R1-R3(1).
Si el enrutador A quiere llegar al enrutador R4, puede hacerlo ya sea por la ruta A-R1-R4 o por la ruta A-R2-R4, y en ambos casos el costo de las rutas será el mismo: 10+100 = 100+10=110. La ruta A-R6 costará 100+1= 101, lo que ya es mejor. A continuación, se considera el camino al enrutador R5 por la ruta A-R1-R3-R5, cuyo costo será 10+1+100 = 111.
El camino al enrutador R7 se puede trazar por dos rutas: A-R1-R4-R7 o A-R2-R6-R7. El costo de la primera será 210, el segundo – 201, por lo que se debe elegir 201. Así que, para alcanzar el enrutador B, el enrutador A puede usar 4 rutas.
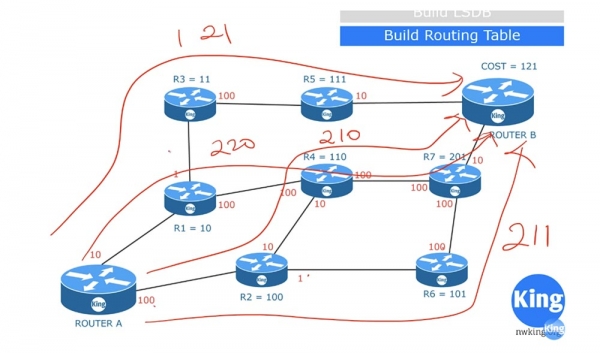
El costo de la ruta A-R1-R3-R5-B será de 121. La ruta A-R1-R4-R7-B costará 220. La ruta A-R2-R4-R7-B cuesta 210, y A-R2-R6-R7-B tiene un costo de 211. Con base en esto, el enrutador A elegirá la ruta con el costo más bajo, que es 121, y la colocará en la tabla de enrutamiento. Este es un esquema muy simplificado de cómo funciona el algoritmo SPF. En realidad, en la tabla no solo se colocan las designaciones de los enrutadores a través de los cuales pasa la ruta óptima, sino también las designaciones de los puertos que los conectan y toda la información necesaria.
Consideremos otro tema relacionado con las áreas de enrutamiento. Normalmente, al configurar dispositivos OSPF de la empresa, todos ellos se encuentran en una misma área común.
¿Qué sucederá si un dispositivo conectado al enrutador R3 falla repentinamente? El enrutador R3 comenzará de inmediato a enviar a los enrutadores R5 y R1 un mensaje indicando que el canal con este dispositivo ya no funciona, y todos los enrutadores comenzarán a intercambiar actualizaciones sobre este evento.
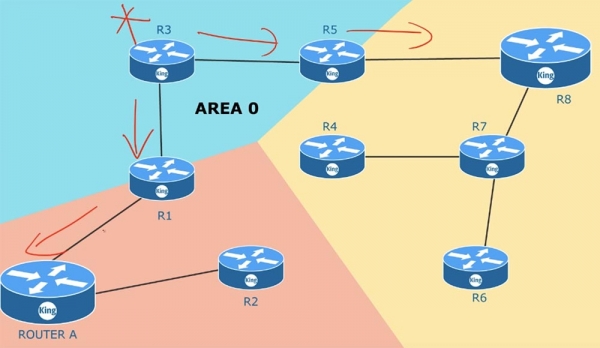
Si tiene 100 enrutadores, todos ellos actualizarán la información sobre el estado de los canales, ya que están en una misma área común. Lo mismo ocurrirá si uno de los enrutadores vecinos falla: todos los dispositivos en el área intercambiarán actualizaciones LSA. Después de intercambiar estos mensajes, la topología de la red cambiará. Una vez que esto ocurra, SPF recalculará las tablas de enrutamiento según las nuevas condiciones. Este es un proceso bastante extenso, y si tiene mil dispositivos en un área, debe controlar el tamaño de la memoria de los enrutadores para asegurarse de que sea suficiente para almacenar todas las LSA y la enorme base de datos de estado de canales LSDB. Tan pronto como haya cambios en alguna parte del área, el algoritmo SPF recalculará las rutas de inmediato. Por defecto, LSA se actualiza cada 30 minutos. Este proceso no ocurre simultáneamente en todos los dispositivos, sin embargo, de todos modos, cada enrutador realiza sus actualizaciones cada 30 minutos. Cuantos más dispositivos de red haya, más memoria y tiempo se requerirán para actualizar LSDB.
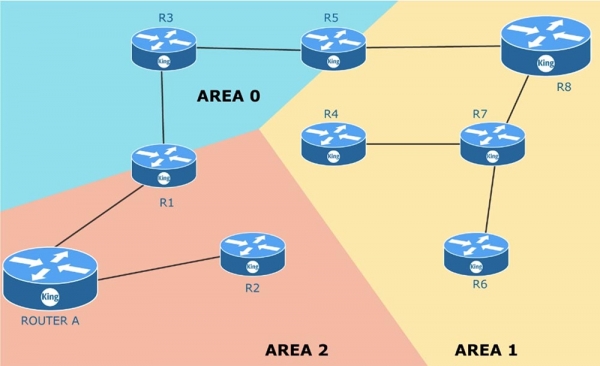
Se puede resolver este problema dividiendo una zona común en varias zonas separadas, es decir, utilizando un multicasting. Para ello, debe tener un plan o esquema de toda la red que está gestionando. La zona cero AREA 0 es su zona principal. Este es el lugar donde se realiza la conexión con la red externa, como el acceso a Internet. Al crear nuevas zonas, debe seguir la regla de que en cada zona debe haber un enrutador de borde ABR, Area Border Router. El enrutador de borde tiene una interfaz en una zona y la segunda interfaz en otra zona. Por ejemplo, el enrutador R5 tiene interfaces en la zona 1 y la zona 0. Como he mencionado, cada una de las zonas debe estar conectada a la zona cero, es decir, tener un enrutador de borde, una de cuyas interfaces está conectada a AREA 0.
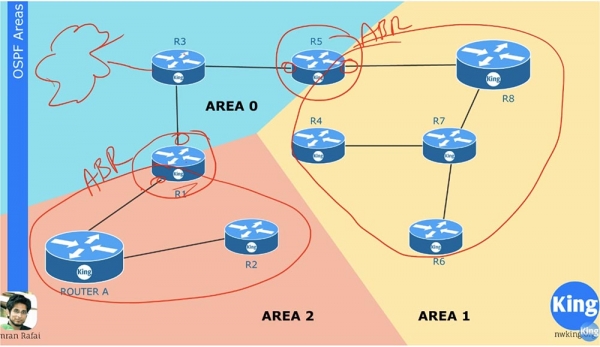
Supongamos que la conexión R6-R7 ha fallado. En este caso, la actualización de LSA solo se propagará por la zona AREA 1 y se referirá únicamente a esta zona. Los dispositivos en la zona 2 y en la zona 0 ni siquiera se enterarán de esto. El enrutador de borde R5 realiza la agregación de la información sobre lo que sucede en su zona y envía a la zona principal AREA 0 un resumen del estado de la red. Los dispositivos en una zona no necesitan conocer todos los cambios de LSA dentro de otras zonas, ya que el enrutador ABR retransmitirá la información agregada sobre las rutas de una zona a otra.
Si no ha comprendido del todo el concepto de zonas, podrá aprender más en las siguientes lecciones, cuando nos ocupemos de la configuración del enrutamiento OSPF y revisemos algunos ejemplos.
Gracias por seguir con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más material interesante? Apóyanos realizando un pedido o recomendándonos a tus conocidos, 30% de descuento para los usuarios de Habr en una alternativa única a los servidores de nivel de entrada, que hemos diseñado para usted: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a la mitad de precio? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
