

Se acercaba el Año Nuevo. Los niños de todo el país ya habían enviado cartas a Papá Noel o se habían pedido regalos, y el principal ejecutor — uno de los grandes minoristas — se preparaba para el apogeo de las ventas. En diciembre, la carga en su centro de datos se multiplica por varias veces. Por lo tanto, la empresa decidió modernizar el centro de datos y poner en funcionamiento varias docenas de nuevos servidores para reemplazar el equipo cuyo tiempo de vida había terminado. Así termina la introducción en medio de los copos de nieve, y comienza el thriller.
El equipo llegó al sitio varios meses antes del pico de ventas. El servicio de operaciones, por supuesto, sabe cómo y qué ajustar en los servidores para ponerlos en el entorno de producción. Pero necesitábamos automatizar esto y eliminar el factor humano. Además, los servidores reemplazaban un conjunto de sistemas SAP, críticamente importantes para la empresa, antes de la migración.
La puesta en funcionamiento de los nuevos servidores estaba estrictamente ligada a un plazo. Y moverlo significaba poner en peligro tanto la entrega de mil millones de regalos como la migración de los sistemas. Ni siquiera el equipo del propio Papá Noel, Santa Claus, podría cambiar la fecha — la migración del sistema SAP para la gestión del almacén solo se puede hacer una vez al año. Desde el 31 de diciembre al 1 de enero, enormes almacenes del minorista, sumando el tamaño de 20 campos de fútbol, detienen su trabajo durante 15 horas. Y ese es el único intervalo de tiempo para trasladar el sistema. No teníamos margen de error en la puesta en marcha de los servidores.
Aclaro de inmediato: mi relato refleja las herramientas y procesos de gestión de configuraciones que utiliza nuestro equipo.
El sistema de gestión de configuraciones consta de varios niveles. El componente clave es el sistema CMS. En un entorno industrial, la falta de uno de los niveles inevitablemente llevaría a sorpresas desagradables.
Gestión de la instalación del sistema operativo
El primer nivel es el sistema de gestión de la instalación de sistemas operativos en servidores físicos y virtuales. Crea configuraciones básicas del sistema operativo, eliminando el factor humano.
Con este sistema, logramos obtener instancias estándar y listas para una futura automatización de servidores con sistema operativo. Durante el "despliegue", recibieron un conjunto mínimo de usuarios locales y claves públicas SSH, así como una configuración coherente del sistema operativo. Podíamos gestionar los servidores a través de CMS de manera garantizada y estábamos seguros de que, en el nivel del sistema operativo, no había sorpresas.
La tarea 'máxima' para el sistema de gestión de instalación es configurar automáticamente los servidores desde el nivel BIOS/Firmware hasta el sistema operativo. Mucho depende aquí del hardware y de las tareas de configuración. Para hardware heterogéneo, se puede considerar . Si todo el 'hardware' proviene de un mismo proveedor, a menudo es más conveniente utilizar herramientas de gestión listas (por ejemplo, HP ILO Amplifier, DELL OpenManage, etc.).
Para la instalación del sistema operativo en servidores físicos, utilizamos el bien conocido Cobbler, que tiene un conjunto de perfiles de instalación acordados con el servicio de explotación. Al añadir un nuevo servidor a la infraestructura, el ingeniero vinculaba la dirección MAC del servidor al perfil requerido en Cobbler. Al primer arranque por red, el servidor obtenía una dirección temporal y un sistema operativo actualizado. Luego se trasladaba a la VLAN/ direccionamiento IP objetivo y continuaba operando allí. Sí, cambiar la VLAN ocupa tiempo y requiere coordinación, pero proporciona una protección adicional contra la instalación accidental del servidor en un entorno de producción.
Creamos servidores virtuales basados en plantillas preparadas con HashiCorp Packer. La razón era la misma: prevenir posibles errores humanos durante la instalación del sistema operativo. Pero, a diferencia de los servidores físicos, Packer permite no utilizar PXE, arranque por red y cambio de VLAN. Esto facilitó y simplificó la creación de servidores virtuales.
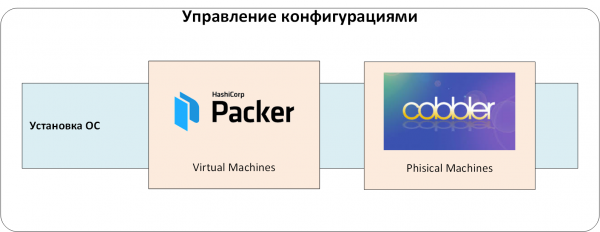
Fig. 1. Gestión de la instalación de sistemas operativos.
Gestión de secretos
Cualquier sistema de gestión de configuraciones contiene datos que deben estar ocultos de los usuarios regulares, pero son necesarios para la preparación de los sistemas. Son contraseñas de usuarios locales y cuentas de servicio, claves de certificados, diversos API Tokens, etc. Normalmente se les llama "secretos".
Si desde el principio no se determina dónde y cómo almacenar estos secretos, dependiendo de la rigurosidad de los requisitos de seguridad de la información, es probable que se utilicen tales métodos de almacenamiento:
- directamente en el código de gestión de configuración o en archivos del repositorio;
- en herramientas especializadas de gestión de configuraciones (por ejemplo, Ansible Vault);
- en sistemas CI/CD (Jenkins/TeamCity/GitLab/etc.) o en sistemas de gestión de configuraciones (Ansible Tower/Ansible AWX);
- también los secretos pueden ser manejados manualmente. Por ejemplo, se colocan en un lugar acordado y luego son utilizados por los sistemas de gestión de configuraciones;
- diferentes combinaciones de lo anteriormente mencionado.
Cada método tiene sus desventajas. La principal es la falta de políticas de acceso a los secretos: no se puede o es difícil determinar quién puede usar ciertos secretos. Otro inconveniente es la falta de auditoría de acceso y un ciclo de vida completo. ¿Cómo reemplazar rápidamente, por ejemplo, una clave pública que está codificada y en varios sistemas relacionados?
Hemos utilizado un almacén centralizado de secretos, HashiCorp Vault. Esto nos permitió:
- guardar secretos de forma segura. Están cifrados, y aunque alguien obtenga acceso a la base de datos del almacén Vault (por ejemplo, restaurándola de una copia de seguridad), no podrá leer los secretos almacenados allí;
- organizar políticas de acceso a los secretos. Los usuarios y aplicaciones solo tienen acceso a los secretos ‘designados’ para ellos;
- realizar auditoría de acceso a los secretos. Cualquier acción con los secretos se registra en el registro de auditoría de Vault;
- organizar un ‘ciclo de vida’ completo para trabajar con secretos. Se pueden crear, revocar, establecer plazos, etc.
- integrarse fácilmente con otros sistemas que necesitan acceso a los secretos;
- y aplicar también cifrado de extremo a extremo, contraseñas de un solo uso para sistemas operativos y bases de datos, certificados de autoridades acreditadas, etc.
Ahora pasemos al sistema central de autenticación y autorización. Se podría haber prescindido de él, pero administrar usuarios en múltiples sistemas relacionados es demasiado complicado. Configuramos la autenticación y autorización a través del servicio LDAP. De lo contrario, en el mismo Vault tendríamos que estar emitiendo continuamente y contabilizando los tokens de autenticación para los usuarios. Y agregar o eliminar usuarios se convertiría en una búsqueda del tesoro: '¿He creado/eliminado esta cuenta en todas partes?'
Agregamos un nivel más a nuestro sistema: gestión de secretos y autenticación/autorización central;
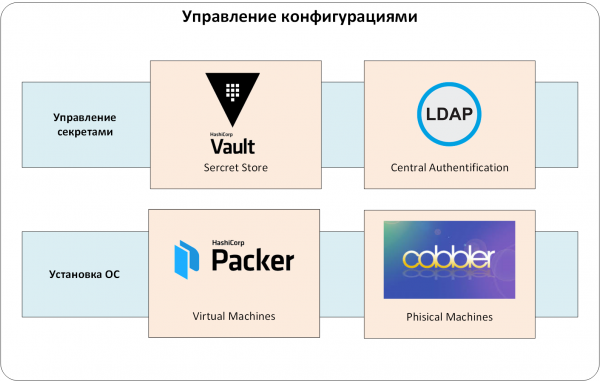
Fig. 2. Gestión de secretos.
Gestión de configuraciones
Hemos llegado al núcleo: al sistema CMS. En nuestro caso, esto es una combinación de Ansible y Red Hat Ansible AWX.
En lugar de Ansible, se puede usar Chef, Puppet, SaltStack. Elegimos Ansible por varios criterios.
- Primero, su versatilidad. El conjunto de módulos disponibles para la gestión . Y si no es suficiente, se puede buscar en GitHub y Galaxy.
- En segundo lugar, no es necesario instalar ni mantener agentes en el equipo gestionado, demostrar que no interrumpen la carga y confirmar la ausencia de "backdoors".
- En tercer lugar, Ansible tiene una baja barrera de entrada. Un ingeniero competente puede escribir un playbook funcional literalmente en su primer día con el producto.
Pero solo Ansible en un entorno industrial no es suficiente. De lo contrario, surgirían muchos problemas con la restricción de acceso y la auditoría de las acciones de los administradores. ¿Cómo limitar el acceso? Era necesario que cada unidad gestionara (léase: ejecutara playbook de Ansible) su propio conjunto de servidores. ¿Cómo permitir la ejecución de ciertos playbooks de Ansible solo a empleados específicos? ¿O cómo rastrear quién ejecutó un playbook sin crear múltiples cuentas locales en los servidores y equipos que gestiona Ansible?
La mayor parte de tales preguntas son resueltas por Red Hat , o su proyecto upstream de código abierto . Por eso lo preferimos para el cliente.
Y un detalle más sobre nuestro sistema CMS. El playbook de Ansible debe almacenarse en sistemas de gestión de repositorios de código. En nuestro caso, es .
Así que las configuraciones son gestionadas por la combinación de Ansible/Ansible AWX/GitLab (ver Fig. 3). Por supuesto, AWX/GitLab están integrados con un sistema de autenticación unificado, y el playbook de Ansible con HashiCorp Vault. Las configuraciones solo llegan al entorno de producción a través de Ansible AWX, donde se establecen todas las "reglas del juego": quién y qué puede configurar, de dónde obtener el código para gestionar las configuraciones para el CMS, etc.
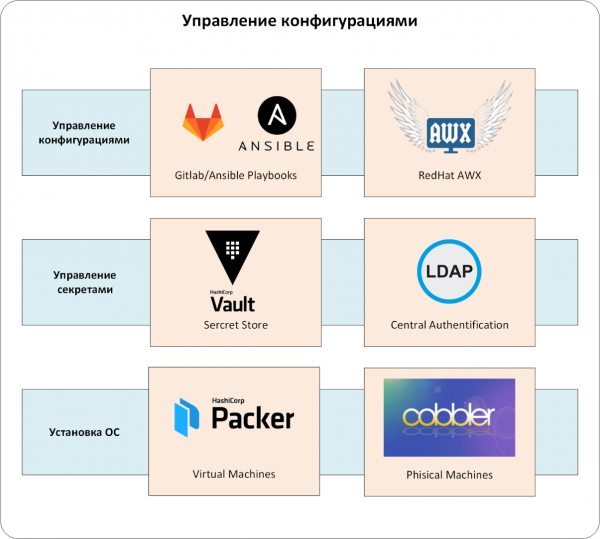
Fig. 3. Gestión de configuraciones.
Gestión de pruebas
Nuestra configuración se presenta en forma de código. Por lo tanto, debemos jugar bajo las mismas reglas que los desarrolladores de software. Necesitamos organizar los procesos de desarrollo, pruebas continuas, entrega y aplicación de código de configuración en los servidores de producción.
Si no se hace de inmediato, los roles escritos para la configuración dejarían de ser compatibles y actualizables, o dejarían de ejecutarse en producción. La solución a este problema es conocida y se ha implementado en este proyecto:
- cada rol está cubierto por pruebas modulares;
- las pruebas se ejecutan automáticamente con cualquier cambio en el código que gestiona las configuraciones;
- los cambios en el código de gestión de configuraciones solo se implementan en el entorno de producción tras pasar exitosamente todas las pruebas y la revisión del código.
El desarrollo de código y la gestión de configuraciones se volvieron más tranquilos y predecibles. Para organizar pruebas continuas, utilizamos la herramienta GitLab CI/CD, y como marco para organizar las pruebas optamos por .
Con cualquier cambio en el código de gestión de configuraciones, GitLab CI/CD invoca a Molecule:
- este verifica la sintaxis del código,
- levanta un contenedor Docker,
- aplica el código modificado en el contenedor creado,
- verifica la idempotencia del rol y ejecuta las pruebas para este código (la granularidad aquí está a nivel de rol de ansible, véase la Fig. 4).
Las configuraciones en el entorno de producción se entregaron mediante Ansible AWX. Los ingenieros responsables de la operación aplicaron los cambios en la configuración a través de plantillas predefinidas. AWX solicitaba automáticamente la última versión del código de la rama principal de GitLab en cada aplicación. Así, evitamos el uso de código no verificado o desactualizado en el entorno de producción. Por supuesto, el código en la rama principal solo se incorporaba después de pruebas, revisión y aprobación.
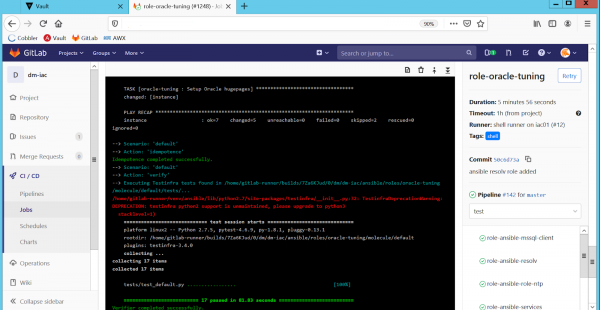
Fig. 4. Pruebas automáticas de roles en GitLab CI/CD.
También hay otro problema relacionado con la operación de sistemas en producción. En la vida real, es muy difícil realizar cambios en la configuración solo a través del código de CMS. Surgen situaciones excepcionales donde un ingeniero debe modificar la configuración "aquí y ahora", sin esperar la corrección del código, pruebas, aprobaciones, etc.
Como resultado, debido a cambios manuales, aparecen discrepancias en la configuración en equipos homogéneos (por ejemplo, en nodos de un clúster HA, la configuración de sysctl puede ser diferente). O la configuración real en el hardware difiere de aquella que está definida en el código del CMS.
Por lo tanto, además de las pruebas continuas, verificamos los entornos de producción en busca de discrepancias en las configuraciones. Elegimos la opción más sencilla: ejecutar el código de configuración del CMS en modo 'dry run', es decir, sin aplicar cambios, pero notificando sobre todas las discrepancias entre la configuración planificada y la real. Implementamos esto a través de ejecuciones periódicas de todos los playbooks de Ansible con la opción '--check' en los servidores de producción. Como siempre, Ansible AWX se encarga de la ejecución y la actualidad del playbook (ver Fig. 5):
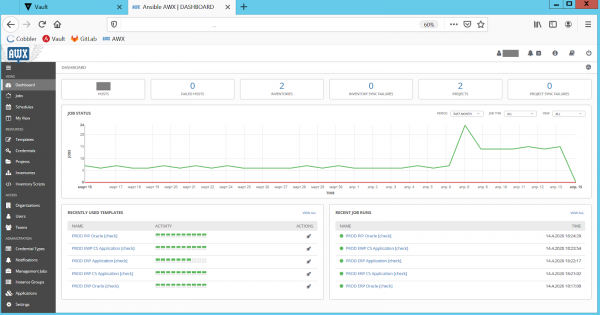
Fig. 5. Verificaciones de discrepancias en configuraciones en Ansible AWX.
Después de las verificaciones, AWX envía un informe de discrepancias a los administradores. Ellos estudian la configuración problemática y luego la corrigen mediante un playbook corregido. Así mantenemos la configuración en el entorno de producción y el CMS siempre está en un estado actual y sincronizado. Esto evita las desagradables 'sorpresas' cuando el código del CMS se aplica en servidores 'en producción'.
Ahora tenemos un nivel importante de pruebas que consiste en Ansible AWX/GitLab/Molecule (Ver Fig. 6).
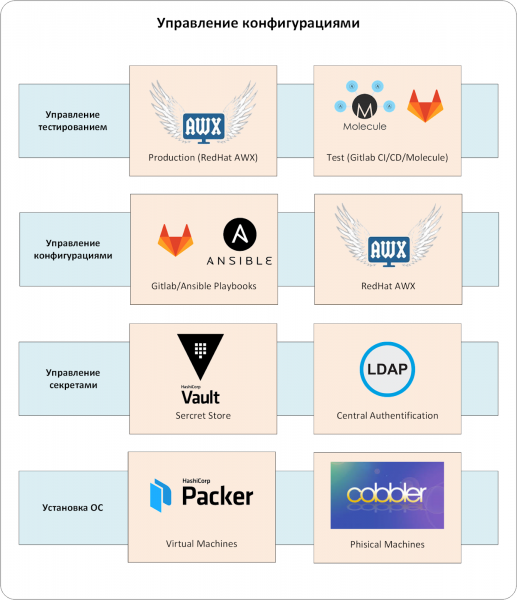
Fig. 6. Gestión de pruebas.
¿Difícil? No lo discuto. Pero este complejo de gestión de configuraciones se ha convertido en una respuesta exhaustiva a muchas preguntas relacionadas con la automatización de la configuración de servidores. Ahora, el minorista siempre tiene una configuración estrictamente definida para los servidores estándar. El CMS, a diferencia del ingeniero, no olvidará agregar las configuraciones necesarias, crear usuarios y realizar decenas o cientos de configuraciones requeridas.
Hoy en día, en la configuración de servidores y entornos no hay 'conocimientos ocultos'. Todas las características necesarias están reflejadas en el playbook. Ya no hay creatividad ni instrucciones ambiguas: 'configúralo como un Oracle normal, pero allí necesitas definir un par de configuraciones de sysctl y agregar usuarios con el UID correcto. Pregunta a los chicos de operaciones, ellos lo saben.».
La capacidad de detectar discrepancias en las configuraciones y corregirlas con anticipación brinda tranquilidad. Sin un sistema de gestión de configuraciones, esto normalmente se ve de otra manera. Los problemas se acumulan hasta que en algún momento 'estallan' en producción. Luego, se realiza un análisis, se verifican y corrigen las configuraciones. Y el ciclo se repite nuevamente.
Y, por supuesto, hemos acelerado la puesta en marcha de los servidores de varios días a horas.
Y en la misma noche de Año Nuevo, cuando los niños abrían alegremente sus regalos y los adultos pedían deseos al sonar de las campanas, nuestros ingenieros migraron el sistema SAP a nuevos servidores. Incluso Papá Noel diría que los mejores milagros son los que están bien preparados.
P.D. Nuestro equipo a menudo se encuentra con que los clientes desean resolver la tarea de gestión de configuraciones de la manera más simple posible. Idealmente, como por arte de magia, con una sola herramienta. Pero en la vida, todo es más complicado (sí, otra vez no llegaron las balas de plata): hay que crear todo un proceso utilizando herramientas que sean convenientes para el equipo del cliente.
Autor: Sergey Artemov, arquitecto del departamento «Infosishtemy Jet»
Fuente: habr.com
