

Hoy en día, es probable que nadie se pregunte por qué es necesario recopilar métricas de servicios. El siguiente paso lógico es configurar alertas para las métricas recopiladas, que te notificarán sobre cualquier desviación en los datos a los canales que prefieras (correo, Slack, Telegram). En el servicio de reserva de hoteles en línea, todas las métricas de nuestros servicios se envían a InfluxDB y se muestran en Grafana, donde también se ha configurado la alerta básica. Para tareas como 'necesito calcular algo y compararlo con esto', utilizamos Kapacitor.
Kapacitor es parte del stack TICK, que puede procesar métricas de InfluxDB. Puede unir varias medidas entre sí (join), calcular algo útil a partir de los datos obtenidos, escribir el resultado de nuevo en InfluxDB y enviar una alerta a Slack/Twitter/correo.
Todo el stack tiene una documentación increíble y detallada , pero siempre hay cosas útiles que no se mencionan explícitamente en los manuales. En este artículo, he decidido reunir una serie de consejos útiles no tan evidentes (la sintaxis básica de TICKscript está descrita ) y mostrar cómo se pueden aplicar, con el ejemplo de una de nuestras tareas.
¡Vamos!
float & int, errores de cálculo
Es un problema completamente estándar, se resuelve mediante un cast:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Uso de default()
Si una etiqueta/campo no está lleno, ocurrirán errores en los cálculos:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill en join (inner vs outer)
Por defecto, join descartará puntos donde no hay datos (inner).
Con fill('null'), se realizará un outer join, después del cual debes hacer default() y llenar los valores vacíos:
var data = res1
    |join(res2)
        .as('res1', 'res2')
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Aquí, todavía hay un matiz. Si en el ejemplo anterior una de las series (res1 o res2) está vacía, la serie final (data) también estará vacía. Hay varios tickets al respecto en GitHub (, , ) – estamos esperando correcciones y sufriendo un poco.
Uso de condiciones en cálculos (if en lambda)
|eval(lambda: if("value" > 0, true, false)
Los últimos cinco minutos del pipeline en el período
Por ejemplo, necesitas comparar los valores de los últimos cinco minutos con la semana anterior. Puedes obtener dos partidas de datos en dos batchs separados o extraer parte de datos de un período mayor:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Una alternativa para los últimos cinco minutos puede ser el uso del nodo BarrierNode, que corta los datos antes del tiempo especificado:
|barrier()
        .period(5m)
Ejemplos de uso de las plantillas de Go en el mensaje
Las plantillas corresponden al formato del paquete , a continuación, algunas tareas comunes.
if-else
Organizamos, sin desencadenar a las personas con texto innecesario:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Está bien ahora{{ else }}Jefe, todo está roto{{end}}'
    )
Dos cifras después de la coma en el mensaje
Mejoramos la legibilidad del mensaje:
|alert()
    ...
    .message(
        'el valor ahora es {{ index .Fields "value" | printf "%0.2f" }}'
    )
Despliegue de variables en el mensaje
Proporcionamos más información en el mensaje para responder a la pregunta "¿Por qué está sonando?"
var warnAlert = 10
  |alert()
    ...
    .message(
       'El valor de hoy es menor al '+string(warnAlert)+'%'
    )
Identificador único de alerta
Una herramienta necesaria cuando hay más de un grupo en los datos, de lo contrario solo se generará una alerta:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Handlers personalizados
En una larga lista de handlers hay exec, que permite ejecutar tu propio script con parámetros pasados (stdin) – ¡eso es creatividad!
Uno de nuestros personalizados es un pequeño script en Python para enviar notificaciones a Slack.
Primero queríamos enviar una imagen de Grafana en el mensaje, protegida por autorización. Después, escribir OK en el hilo de la alerta anterior del mismo grupo, en lugar de como un mensaje separado. Un poco más tarde – añadir el error más común en el mensaje de los últimos X minutos.
Un tema separado es la conexión con otros servicios y cualquier acción iniciada por la alerta (solo si tu monitoreo funciona lo suficientemente bien).
Ejemplo de descripción del handler, donde slack_handler.py es nuestro script personalizado:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
¿Cómo depurar?
Opción con salida en log
|log()
      .level("error")
      .prefix("algo")
Ver (cli): kapacitor -url :9092 logs lvl=error
Opción con httpOut
Muestra datos en la canalización actual:
|httpOut('algo')
Ver (get): :9092\/kapacitor\/v1\/tasks\/task_name\/algo
Esquema de ejecución
- Cada tarea devuelve un árbol de ejecución con cifras útiles en formato .
- Tomamos el bloque .
- Lo insertamos en el visor, .
Dónde más se pueden obtener datos
timestamp en influxdb al escribir al revés
Por ejemplo, configuramos una alerta para la cantidad de solicitudes por hora (groupBy(1h)) y queremos registrar la alerta ocurrida en influxdb (para mostrar de manera atractiva la existencia de un problema en el gráfico en grafana).
influxDBOut() registrará en timestamp el valor de time de la alerta, por lo tanto, el punto en el gráfico se registrará antes/después de que llegue la alerta.
Cuando se requiere precisión: abordamos este problema mediante la llamada a un manejador personalizado que registrará los datos en influxdb con el timestamp actual.
docker, construcción y despliegue
Al iniciar, kapacitor puede cargar tareas, plantillas y manejadores desde el directorio especificado en la configuración, en el bloque [load].
Para crear una tarea correctamente se necesitan las siguientes cosas:
- Nombre del archivo – se despliega como id/nombre del script
- Tipo – stream/batch
- dbrp – palabra clave para indicar en qué base + política trabaja el script (dbrp "supplier"."autogen")
Si en alguna tarea batch no hay la línea con dbrp, todo el servicio se negará a iniciarse y lo indicará claramente en el registro.
En chronograf, por el contrario, esta línea no debe existir, ya que a través de la interfaz no se acepta y produce un error.
Hackeando durante la construcción del contenedor: Dockerfile falla con -1 si hay líneas con //.+dbrp, lo que permitirá entender inmediatamente la razón del fallo en la construcción.
join uno a muchos
Ejemplo de tarea: necesitamos tomar el percentil 95 del tiempo de funcionamiento del servicio durante una semana, comparando cada minuto de los últimos 10 con este valor.
No se puede hacer un join uno a muchos; last/mean/median por grupo de puntos convierte el nodo en un stream, regresando un error "cannot add child mismatched edges: batch -> stream".
El resultado de un batch, como variable en una expresión lambda, tampoco se inserta.
Hay una opción para guardar los números necesarios de la primera batch en un archivo a través de udf y cargar este archivo mediante sideload.
¿Qué estábamos resolviendo con esto?
Tenemos alrededor de 100 proveedores de hoteles, cada uno de los cuales puede tener varias conexiones, llamémoslo canal. Hay aproximadamente 300 de estos canales, y cada canal puede fallar. De todas las métricas grabadas, monitorizaremos la tasa de errores (requests y errors).
¿Por qué no grafana?
Las alertas por errores configuradas en grafana tienen varios inconvenientes. Algunos son críticos, otros se pueden pasar por alto, dependiendo de la situación.
Grafana no puede realizar cálculos entre medidas + alertas, y necesitamos la tasa (requests-errors)/requests.
Los errores se ven malvados:
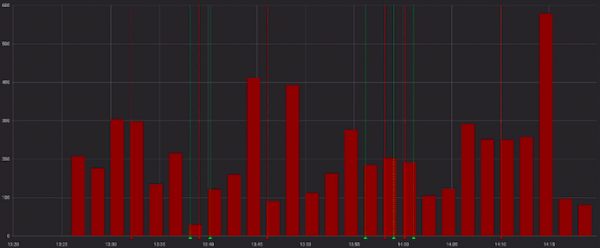
Y menos malvados, si se miran con solicitudes exitosas:
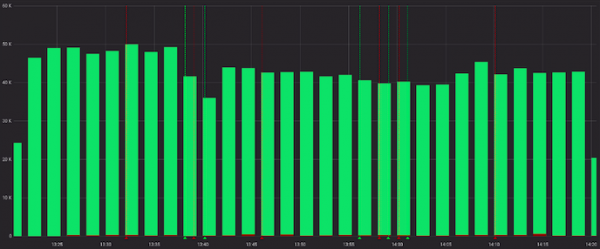
Está bien, podemos calcular preliminarmente la tasa en el servicio antes de Grafana, y en algunos casos esto funcionará. Pero no en nuestro caso, ya que para cada canal se considera que su relación es «normal», y las alertas funcionan con valores estáticos (las buscamos manualmente y las cambiamos si alertan con frecuencia).
Estos son ejemplos de lo que se considera «normal» para diferentes canales:
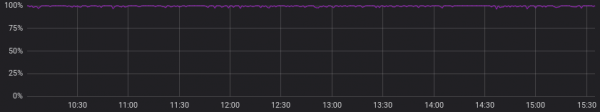
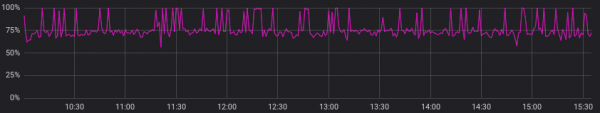
Desestimemos el punto anterior y asumamos que todos los proveedores tienen una imagen «normal» similar. Ahora todo está bien, ¿podemos manejarnos con alertas en Grafana?
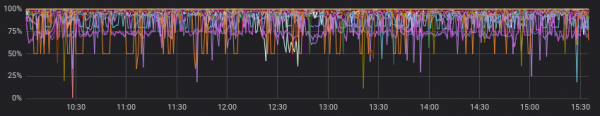
Podemos, pero no queremos, porque hay que elegir una de las siguientes opciones:
a) crear múltiples gráficos para cada canal por separado (y lidiar con su mantenimiento dolorosamente)
b) dejar un único gráfico con todos los canales (y perdernos entre líneas de colores y alertas configuradas)
¿Cómo lo hicieron?
Una vez más, en la documentación hay un buen ejemplo inicial (), se puede consultar o tomar como base para tareas similares.
Esto es lo que se hizo al final:
- unir dos series en unas pocas horas, agrupación por canales;
- rellenamos las series por grupos si no hubo datos;
- comparamos la mediana de los últimos 10 minutos con los datos anteriores;
- gritamos si encontramos algo;
- escribimos las tasas calculadas y las alertas que se activaron en InfluxDB;
- enviamos un mensaje útil a Slack.
En mi opinión, logramos hacer de la mejor manera todo lo que deseábamos obtener como resultado (e incluso un poco más con los manejadores personalizados).
En github.com se puede ver y del script obtenido.
Ejemplo del código resultante:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // rellenamos los valores a cero si no hubo
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // si en lambda: calculamos tasa, solo si hubo errores
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// grabamos los valores calculados en influx
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// seleccionamos datos de los últimos 10 minutos, calculamos la mediana
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // ensamblamos en el mensaje el enlace al gráfico del panel de Grafana
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} relación err/req ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Está bien ahora{{ else }}
'+string(todayPeriod)+' mediana es {{ index .Fields "today.median" | printf "%0.2f" }}%, comparado con el anterior '+string(period)+' que es {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+
'?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}\/{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" se duplica como "value", también escribimos en influx los otros campos de alerta (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
¿Y cuál es la salida?
Kapacitor hace un excelente trabajo en el monitoreo y alerta con múltiples agrupaciones, realizando cálculos adicionales sobre métricas ya registradas, ejecutando acciones personalizadas y lanzando scripts (udf).
La barrera de entrada no es muy alta; pruébalo si Grafana u otras herramientas no satisfacen completamente tus necesidades.
Fuente: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish