

¿Qué sentirías si en un hermoso día de verano el centro de datos con tu equipo se viera así?
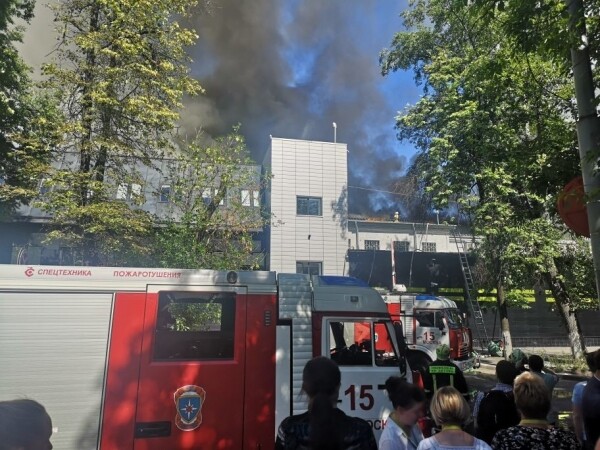
¡Hola a todos! Me llamo Dmitry Samsonov, trabajo como administrador de sistemas senior en “”. En la foto se muestra uno de los cuatro centros de datos donde se encuentra el equipo que da soporte a nuestro proyecto. Detrás de estas paredes hay alrededor de 4,000 unidades de hardware: servidores, sistemas de almacenamiento de datos, equipos de red, etc. — casi ⅓ de todo nuestro equipo.
La mayoría de los servidores son Linux. También hay varias docenas de servidores en Windows (MS SQL) — nuestro legado, del que nos hemos estado deshaciendo lentamente durante muchos años.
Así que, el 5 de junio de 2019 a las 14:35, los ingenieros de uno de nuestros centros de datos informaron sobre una alarma de incendio.
Negación
14:45. Los pequeños incidentes de humo en los centros de datos ocurren más a menudo de lo que parece. Los indicadores dentro de los salones estaban dentro de lo normal, así que nuestra primera reacción fue relativamente tranquila: se impuso una prohibición de trabajos en producción, lo que significa que no se harían cambios en las configuraciones, despliegues de nuevas versiones, etc., excepto los trabajos relacionados con la reparación de algo.
Ira
¿Alguna vez has intentado preguntarle a los bomberos dónde exactamente en el techo ocurrió el incendio, o tratar de subir a un techo en llamas para evaluar la situación? ¿Qué nivel de confianza tendrías en la información obtenida a través de cinco personas?
14:50. Se recibió información de que el fuego se estaba acercando al sistema de refrigeración. Pero, ¿llegará? El administrador de sistemas de guardia está sacando el tráfico externo de los frentes de este centro de datos.
En este momento, los frentes de todos nuestros servicios están duplicados en tres centros de datos, se utiliza balanceo a nivel de DNS, lo que permite eliminar las direcciones de un centro de datos del DNS, blindando así a los usuarios de posibles problemas de acceso a los servicios. En caso de que ya hayan ocurrido problemas en el centro de datos, automáticamente saldrá de la rotación. Puedes leer más sobre esto aquí:
El incendio aún no nos ha afectado de ninguna manera: ni los usuarios ni el equipo han sufrido daños. ¿Es esto un accidente? La primera sección del documento “Plan de acción en caso de emergencia” define el término “Accidente”, y la sección termina así:
«Si hay dudas, si es un accidente o no, ¡entonces es un accidente!»
14:53. Se designa al coordinador de emergencia.
El coordinador es la persona que controla la comunicación entre todos los participantes, evalúa la magnitud de la emergencia, utiliza el «Plan de acción en caso de emergencia», convoca al personal necesario, supervisa la finalización de las reparaciones y, lo más importante, delega cualquier tarea. En otras palabras, es la persona que gestiona todo el proceso de resolución de la emergencia.
Subasta
15:01. Comenzamos a desconectar los servidores que no están relacionados con la producción.
15:03. Apagamos correctamente todos los servicios reservados.
Esto incluye no solo los frontales (a los que los usuarios ya no acceden en este momento) y sus servicios auxiliares (lógica de negocio, cachés, etc.), sino también diversas bases de datos con un factor de replicación de 2 o más (, , , y otros).
15:06. Se recibió información de que un incendio amenaza una de las salas del centro de datos. En esta sala no tenemos equipos, pero el hecho de que el fuego pueda propagarse desde el techo hacia las salas cambia drásticamente la situación.
(Más tarde se descubrió que no había una amenaza física para la sala, ya que está herméticamente aislada del techo. La amenaza era solo para el sistema de refrigeración de esta sala.)
15:07. Se permite la ejecución de comandos en los servidores en modo acelerado sin verificaciones adicionales ().
15:08. La temperatura en las salas está dentro de la norma.
15:12. Se ha registrado un aumento de temperatura en las salas.
15:13. Más de la mitad de los servidores en el centro de datos están apagados. Continuamos.
15:16. Se toma la decisión de apagar todo el equipo.
15:21. Comenzamos a desconectar la alimentación en servidores sin estado sin un apagado correcto de la aplicación y del sistema operativo.
15:23. Se designa un grupo responsable para MS SQL (son pocos, la dependencia de los servicios de ellos no es grande, pero el procedimiento para restaurar la funcionalidad lleva más tiempo y es más complicado que, por ejemplo, con Cassandra).
Depresión
15:25. Se recibió información de que se apagó la alimentación en cuatro salas de 16 (números 6, 7, 8, 9). En las salas 7 y 8 se encuentra nuestro equipo. No tenemos información sobre otras dos de nuestras salas (números 1 y 3).
Generalmente, en casos de incendios, la alimentación eléctrica se apaga de inmediato, pero en este caso, gracias al trabajo coordinado de los bomberos y al personal técnico del centro de datos, no se apagó en todos lados y no de inmediato, sino según fue necesario.
(Se descubrió más tarde que la alimentación en las salas 8 y 9 no se había apagado.)
15:28. Comenzamos a desplegar las bases MS SQL desde copias de seguridad en otros centros de datos.
¿Cuánto tiempo tomará esto? ¿Será suficiente el ancho de banda de la red en todo el recorrido?
15:37. Se ha registrado la desconexión de algunos tramos de la red.
La gestión y la red de producción están físicamente aisladas entre sí. Si la red de producción está disponible, puede acceder al servidor, detener la aplicación y apagar el sistema operativo. Si no está disponible, puede acceder a través de IPMI, detener la aplicación y apagar el sistema operativo. Si ninguna de las redes está disponible, no puede hacer nada. "¡Gracias, capitán!", podría pensar.
"Y en general, hay demasiada confusión", podría pensar también.
La cuestión es que los servidores generan una gran cantidad de calor incluso sin un incendio. Más precisamente, cuando hay refrigeración, generan calor, y cuando no la hay, crean un infierno que, en el mejor de los casos, derretirá parte del equipo y apagará otra parte, y en el peor de los casos... provocará un incendio dentro de la sala, que prácticamente destruirá todo.
15:39. Registramos problemas con la base conf.
La base conf es el backend para el servicio del mismo nombre, que es utilizado por todas las aplicaciones de producción para cambiar la configuración de manera operativa. Sin esta base, no podemos gestionar el funcionamiento del portal, pero el portal puede seguir funcionando.
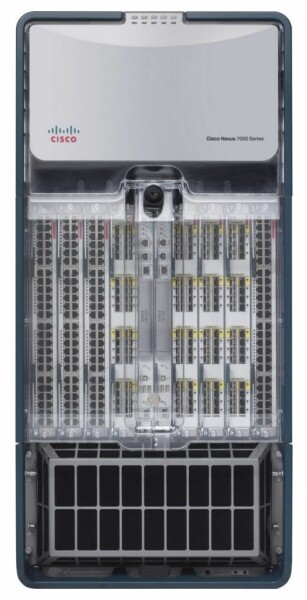
15:41. Los sensores de temperatura en el equipo de red Core registran lecturas cercanas a los límites permitidos. Es una caja que ocupa un rack entero y asegura el funcionamiento de todas las redes dentro del centro de datos.
15:42. El rastreador de problemas y la wiki no están disponibles, pasamos a standby.
Esto no es producción, pero durante un accidente, la disponibilidad de cualquier base de conocimiento puede ser crítica.
15:50. Uno de los sistemas de monitoreo se apagó.
Hay varios, y son responsables de diferentes aspectos del funcionamiento de los servicios. Algunos de ellos están configurados para funcionar de manera autónoma dentro de cada centro de datos (es decir, monitorean solo su centro de datos), otros constan de componentes distribuidos que manejan de manera transparente la pérdida de cualquier centro de datos.
En este caso dejó de funcionar , que opera en modo master-standby. Cambiamos a standby.
Aceptación
15:51. A través de IPMI se apagaron todos los servidores sin una correcta finalización del trabajo, excepto MS SQL.
¿Estás listo para la gestión masiva de servidores a través de IPMI si es necesario?
Ese momento cuando el rescate del equipamiento en el centro de datos ha finalizado. Todo lo que se podía hacer, se ha hecho. Algunos colegas pueden descansar.
16:13. Se ha recibido información de que los tubos de refrigerante de los aires acondicionados en el techo se han roto, lo que retrasará el inicio del centro de datos después de extinguida la incendio.
16:19. Según la información proporcionada por el personal técnico del centro de datos, se ha detenido el aumento de temperatura en las salas.
17:10. Se ha restaurado el funcionamiento de la base conf. Ahora podemos cambiar la configuración de las aplicaciones.
¿Por qué es esto tan importante, si todo es tolerante a fallos y funciona incluso sin un centro de datos?
En primer lugar, no todo es tolerante a fallos. Hay diversos servicios secundarios que aún no sobreviven lo suficientemente bien a la falla de un centro de datos, y hay bases en modo maestro-esclavo. La capacidad de gestionar configuraciones permite hacer todo lo necesario para minimizar el impacto de las consecuencias de un fallo en los usuarios, incluso en condiciones difíciles.
En segundo lugar, se ha vuelto claro que en las próximas horas el funcionamiento del centro de datos no se restablecerá por completo, por lo que era necesario tomar medidas para que la larga indisponibilidad de las réplicas no condujera a problemas adicionales como el desbordamiento de discos en los centros de datos restantes.
17:29. ¡Es hora de pizza! Tenemos personas trabajando, no robots.
Rehabilitación
18:02. La temperatura en las salas 8 (la nuestra), 9, 10 y 11 se ha estabilizado. En una de las que permanecen desconectadas (la 7), se encuentra nuestro equipo y la temperatura sigue aumentando.
18:31. Se ha dado la aprobación para el encendido del equipo en las salas 1 y 3 — estas salas no fueron afectadas por el incendio.
En este momento se están iniciando los servidores en las salas 1, 3 y 8, comenzando por los más críticos. Se está verificando el correcto funcionamiento de todos los servicios iniciados. Aún hay problemas con la sala 7.
18:44. El personal técnico del centro de datos descubrió que en la sala 7 (donde sólo está nuestro equipo) muchos servidores no están apagados. Según nuestros datos, hay 26 servidores encendidos. Tras una segunda verificación, encontramos 58 servidores.
20:18. El personal técnico del centro de datos está ventilando el aire en la sala sin aires acondicionados a través de conductos móviles colocados por los pasillos.
23:08. Se envió a casa al primer administrador. Alguien debe dormir por la noche para continuar con los trabajos mañana. Luego, enviamos a casa a más administradores y desarrolladores.
02:56. Hemos lanzado todo lo que se podía activar. Hacemos una gran verificación de todos los servicios con pruebas automáticas.
03:02. El aire acondicionado en la última sala, la séptima, ha sido restaurado.
03:36. Hemos añadido los frontales en el centro de datos a la rotación en DNS. A partir de este momento, comenzará a llegar tráfico de usuarios.
Estamos despidiendo a la mayor parte del equipo de administradores. Pero dejamos a algunas personas.
Pequeño FAQ:
P: ¿Qué sucedió entre las 18:31 y las 02:56?
R: Siguiendo el ‘Plan de Acción en Caso de Emergencia’, activamos todos los servicios, comenzando por los más importantes. Mientras tanto, el coordinador en el chat asigna un servicio a un administrador libre, quien verifica si el sistema operativo y la aplicación se han iniciado, si hay errores y si los parámetros están normales. Después de completar el lanzamiento, informa en el chat que está libre y recibe un nuevo servicio del coordinador.
El proceso se retrasa aún más por un hardware que ha fallado. Incluso si la detención del sistema operativo y el apagado de los servidores se realizaron correctamente, algunos servidores no regresan debido a discos, memoria o chasis que han fallado repentinamente. Al perder la alimentación, el porcentaje de fallas aumenta.
P: ¿Por qué no se puede simplemente iniciar todo de una vez y luego reparar lo que surja en el monitoreo?
R: Todo debe hacerse gradualmente, porque hay dependencias entre los servicios. Y se debe verificar todo de inmediato, sin esperar el monitoreo, porque es mejor abordar los problemas de inmediato y no esperar a que se agraven.
7:40. El último administrador (coordinador) se fue a dormir. Los trabajos del primer día han finalizado.
8:09. Los primeros desarrolladores, ingenieros en los centros de datos y administradores (incluido el nuevo coordinador) han comenzado las labores de restauración.
09:37. Hemos comenzado a levantar la sala Nº 7 (la última).
Paralelamente, continuamos restaurando lo que no se completó en otras salas: reemplazo de discos/memoria/servidores, reparación de todo lo que ‘está fallando’ en el monitoreo, conmutación inversa de roles en los esquemas de master-standby y otras pequeñas cosas, de las cuales, sin embargo, hay bastante.
17:08. Permitimos todas las operaciones rutinarias con producción.
21:45. Los trabajos del segundo día han finalizado.
09:45. Hoy es viernes. En el monitoreo aún hay bastantes problemas menores. Ya se acercan el fin de semana, todos quieren descansar. Seguimos reparando masivamente todo lo que se puede. Las tareas administrativas que se podían posponer han sido pospuestas. Hay un nuevo coordinador.
15:40. De repente se reinició la mitad del stack de equipos de red en OTRO centro de datos. Sacamos de la rotación los frontes para minimizar riesgos. No hubo impacto para los usuarios. Más tarde se descubrió que fue un chasis defectuoso. El coordinador está trabajando en reparar dos fallas a la vez.
17:17. El funcionamiento de la red en otro centro de datos ha sido restaurado, todo ha sido verificado. El centro de datos ha sido incorporado de nuevo a la rotación.
18:29. El trabajo del tercer día y, en general, la recuperación tras la falla han sido completados.
Póscrito
04.04.2013, «VKontakte» durante tres días el portal estuvo totalmente o parcialmente inaccesible. A lo largo de este tiempo, más de 100 personas de diferentes ciudades y compañías (¡muchas gracias de nuevo!), trabajaron de forma remota y directamente en los centros de datos, arreglando miles de servidores de manera manual y automática.
Hemos tomado lecciones. Para que esto no vuelva a suceder, hemos realizado y seguimos realizando trabajos extensos.
¿Cuáles son las principales diferencias entre la falla actual y la 404?
- Hemos establecido un "Plan de Acción ante Emergencias". Cada trimestre realizamos simulacros: generamos una situación de emergencia que un grupo de administradores (todos por turno) debe resolver utilizando el "Plan de Acción ante Emergencias". Los principales administradores de sistemas alternan en el rol de coordinador.
- Cada tres meses, en modo de prueba aislamos los centros de datos (todos por turno) en la red LAN y WAN, lo que permite identificar a tiempo los cuellos de botella.
- Menos discos defectuosos, porque hemos endurecido las normas: menos horas de funcionamiento, criterios umbral más estrictos para S.M.A.R.T.,
- Hemos abandonado totalmente BerkeleyDB, una base de datos antigua e inestable que requería mucho tiempo para su recuperación tras el reinicio del servidor.
- Hemos reducido la cantidad de servidores con MS SQL y disminuido la dependencia de los que quedan.
- Ya contamos con nuestra propia a la que hemos estado migrando activamente todos los servicios durante dos años. La nube simplifica significativamente todo el ciclo de trabajo con la aplicación y, en caso de emergencia, proporciona herramientas únicas como:
- detención correcta de todas las aplicaciones con un solo clic;
- migración simple de aplicaciones desde servidores fallidos;
- inicio automático clasificado (por prioridad de servicios) de todo el centro de datos.
El accidente descrito en este artículo fue el más grande desde el 404. Por supuesto, no todo fue fácil. Por ejemplo, durante la inaccesibilidad del centro de datos incendiado, un disco falló en uno de los servidores de otro centro de datos, lo que dejó disponible solo una de las tres réplicas en el clúster de Cassandra, provocando que el 4.2% de los usuarios de aplicaciones móviles no pudieran iniciar sesión. Sin embargo, los usuarios ya conectados continuaron trabajando. En total, se identificaron más de 30 problemas como resultado del accidente, desde errores triviales hasta deficiencias en la arquitectura de los servicios.
Pero la principal diferencia entre el accidente actual y el 404 es que mientras solucionábamos las consecuencias del incendio, los usuarios continuaban escribiendo y realizando videollamadas en , jugaban, escuchaban música, se enviaban regalos, veían videos, series y canales de televisión en , así como transmitían en .
¿Y cómo manejan ustedes sus accidentes?
Fuente: habr.com
