

Una pequeña palabra introductoria
Creo que podríamos llevar a cabo muchas más tareas si se nos proporcionaran guías paso a paso que nos dijeran qué hacer y cómo hacerlo. Recuerdo momentos en mi vida en los que no podía empezar algo porque simplemente era difícil comprender por dónde empezar. Tal vez, hace tiempo en internet viste las palabras "Data Science" y decidiste que estaba muy lejos de ti, pensando que las personas que se dedican a eso están en otro mundo. Pero no, están justo aquí. Y quizás, gracias a personas de este campo, un artículo te llegó a tu feed. Hay muchos cursos que te ayudarán a dominar este oficio, y aquí te ayudaré a dar tu primer paso.
Bueno, ¿estás listo? Te diré de inmediato que necesitarás conocer Python 3, ya que lo utilizaré aquí. También te recomiendo que instales Jupyter Notebook de antemano o que veas cómo usar Google Colab.
Primer paso
Kaggle es tu gran aliado en esto. En principio, podrías prescindir de él, pero hablaré de eso en otro artículo. Es una plataforma donde se llevan a cabo competencias de Data Science. En cada competencia de este tipo, en las primeras etapas, obtendrás una cantidad increíble de experiencia resolviendo diversos problemas, así como experiencia en desarrollo y trabajo en equipo, lo cual es importante en nuestros días.
Tomaremos nuestra tarea de allí. Se llama "Titánic". La condición es la siguiente: predecir si cada persona individualmente sobrevivirá. En términos generales, la tarea de alguien que se dedica a DS es la recopilación de datos, su procesamiento, el entrenamiento del modelo, la predicción, etc. En Kaggle se nos permite saltar la etapa de recopilación de datos: ya están disponibles en la plataforma. ¡Debemos cargarlos y podemos comenzar a trabajar!
Esto se puede hacer de la siguiente manera:
en la pestaña Datos se encuentran los archivos que contienen los datos


Hemos cargado los datos, preparado nuestras notas de Jupyter y...
Segundo paso
¿Cómo vamos a cargar estos datos ahora?
Primero, importamos las bibliotecas necesarias:
import pandas as pd
import numpy as np
Pandas nos permitirá cargar archivos .csv para su posterior procesamiento.
Numpy es necesario para representar nuestra tabla de datos como una matriz de números.
Continuemos. Tomemos el archivo train.csv y cargémoslo:
dataset = pd.read_csv('train.csv')
Nos referiremos a nuestra muestra de datos train.csv a través de la variable dataset. Veamos qué hay allí:
dataset.head()
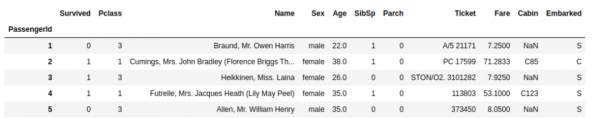
La función head() nos permite ver las primeras filas del dataframe.
La columna Survived representa nuestros resultados conocidos en este dataframe. Para nuestra tarea, necesitamos predecir la columna Survived de los datos test.csv. Estos datos contienen información sobre otros pasajeros del Titanic, cuyos resultados son desconocidos para nosotros, que estamos resolviendo el problema.
Así que dividiremos nuestra tabla en datos dependientes e independientes. Aquí todo es simple. Los datos dependientes son aquellos que dependen de los independientes, es decir, de lo que se encuentra en los resultados. Los datos independientes son los que influyen en el resultado.
Por ejemplo, tenemos este conjunto de datos:
«Vova estaba estudiando informática — no.»
«Vova obtuvo un 2 en informática.»
La calificación en informática depende de la respuesta a la pregunta: ¿estudió Vova informática? ¿Está claro? ¡Sigamos, ya estamos más cerca del objetivo!
La variable tradicional para los datos independientes es X. Para los dependientes es y.
Hacemos lo siguiente:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
¿Qué es esto? Con la función iloc[:, 2: ] le decimos a Python: quiero ver en la variable X los datos que comienzan desde la segunda columna (incluida y suponiendo que la cuenta empieza desde cero). En la segunda línea decimos que queremos ver en y los datos de la primera columna.
[ a:b, c:d ] — esta es la construcción que utilizamos en los paréntesis. Si no especificamos algunas variables, se guardarán por defecto. Es decir, podemos indicar [:,: d] y entonces obtendremos en el dataframe todas las columnas excepto aquellas que comienzan desde el número d en adelante. Las variables a y b determinan las filas, pero todas nos son necesarias, así que las dejamos por defecto.
Veamos qué hemos obtenido:
X.head() 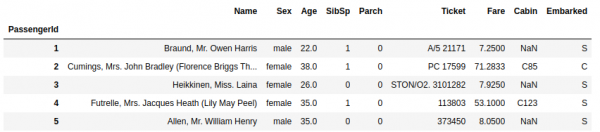
y.head() 
Para simplificar esta pequeña lección, eliminaremos las columnas que requieren un «cuidado» especial, o que no influyen en la supervivencia. Contienen datos de tipo str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
¡Genial! Vamos al siguiente paso.
Paso tres
Aquí necesitamos codificar nuestros datos para que la máquina entienda mejor cómo estos afectan el resultado. Pero codificaremos solo los datos de tipo str que hemos dejado. La columna 'Sexo'. ¿Cómo queremos codificarlo? Imaginemos los datos sobre el género de una persona como un vector: 10 — masculino, 01 — femenino.
Para empezar, convertiremos nuestras tablas en una matriz NumPy:
X = np.array(X)
y = np.array(y)
Y ahora observemos:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
La biblioteca sklearn es una biblioteca increíble que nos permite realizar un trabajo completo en Ciencia de Datos. Contiene una gran cantidad de modelos interesantes de aprendizaje automático y también nos ayuda a preparar los datos.
OneHotEncoder nos permitirá codificar el género de una persona en la forma que hemos descrito. Se crearán 2 clases: masculino, femenino. Si la persona es hombre, se registrará un 1 en la columna 'masculino' y un 0 en 'femenino'.
Después de OneHotEncoder() hay [1] — esto significa que queremos codificar la columna número 1 (empezando desde cero).
Genial. ¡Sigamos adelante!
Por lo general, sucede que algunos datos quedan sin rellenar (es decir, NaN — not a number). Por ejemplo, hay información sobre una persona: su nombre, género. Pero no hay datos sobre su edad. En este caso, aplicaremos el siguiente método: encontraremos el promedio de todas las columnas y, si algunos datos en la columna están ausentes, rellenaremos el vacío con el promedio.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Ahora tomemos en cuenta que a veces los datos están muy dispersos. Algunos datos están en el intervalo [0:1], mientras que otros pueden alcanzar cientos o miles. Para evitar tal dispersión y hacer que la computadora sea más precisa en los cálculos, escalaremos los datos, los ajustaremos. Que todos los números no superen los tres. Para esto utilizaremos la función StandardScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Ahora nuestros datos se ven así:

¡Genial! ¡Estamos cerca de nuestra meta!
Paso cuatro
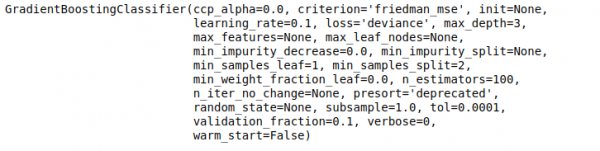
¡Entrenemos nuestro primer modelo! En la biblioteca sklearn podemos encontrar una gran cantidad de cosas interesantes. He aplicado a esta tarea el modelo Gradient Boosting Classifier. Usamos un clasificador ya que nuestra tarea es una tarea de clasificación. Necesitamos predecir si se clasifica como 1 (sobrevivió) o 0 (no sobrevivió).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
La función fit le dice a Python: Deja que el modelo busque las dependencias entre X e y.
Menos de un segundo y el modelo está listo.
¿Cómo aplicarlo? ¡Ahora lo veremos!
Paso cinco. Conclusión
Ahora necesitamos cargar la tabla con nuestros datos de prueba, para los cuales se necesita hacer la predicción. Con esta tabla haremos todas las mismas acciones que llevamos a cabo para X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
¡Ya apliquemos nuestro modelo!
gbc_predict = gbc.predict(X_test)
Todo. Hemos realizado la predicción. Ahora hay que escribirla en un csv y enviarlo al sitio web.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Listo. Hemos obtenido un archivo que contiene las predicciones para cada pasajero. Solo queda subir estas decisiones al sitio y recibir la evaluación de la predicción. Esta solución primitiva da no solo un 74% de respuestas correctas en público, sino también un impulso en Data Science. Los más curiosos pueden escribirme en cualquier momento en mensajes privados y hacer preguntas. ¡Gracias a todos!
Fuente: habr.com
