

¡Hola, Habr!
A la luz de los acontecimientos actuales debido al coronavirus, varios servicios en línea han empezado a recibir una carga incrementada. Por ejemplo, , ya que no contaba con los recursos necesarios. Y no siempre se puede acelerar un servidor simplemente agregando hardware más potente, sin embargo, es necesario procesar las solicitudes de los clientes (o se irán con la competencia).
En este artículo, mencionaré brevemente las prácticas populares que permitirán crear un servicio rápido y resistente a fallos. Sin embargo, de las posibles esquemas de desarrollo, he seleccionado solo aquellos que ahora son fáciles de utilizar. Para cada punto, ya tienes bibliotecas listas o hay opciones para resolver el problema a través de una plataforma en la nube.
Escalado horizontal
El punto más simple y conocido por todos. En general, hay dos esquemas de distribución de carga que se ven con más frecuencia: escalado horizontal y escalado vertical. permites que los servicios operen en paralelo, distribuyendo así la carga entre ellos. pides servidores más potentes o optimizas el código.
Por ejemplo, tomaré un almacenamiento en la nube abstracto de archivos, es decir, un análogo de OwnCloud, OneDrive, etc.
La imagen estándar de un esquema similar se muestra a continuación, pero solo demuestra la complejidad del sistema. Tenemos que sincronizar los servicios de alguna manera. ¿Qué pasará si un usuario guarda un archivo desde su tableta y luego quiere verlo desde su teléfono?
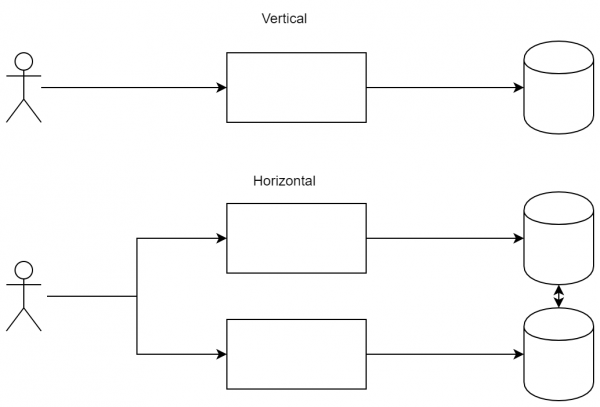
La diferencia entre los enfoques: en el escalado vertical estamos dispuestos a aumentar la potencia de los nodos, mientras que en el escalado horizontal, agregamos nodos nuevos para distribuir la carga.
CQRS
es un patrón bastante importante, ya que permite a diferentes clientes no solo conectarse a diferentes servicios, sino también recibir flujos de eventos idénticos. Sus beneficios no son tan evidentes para una aplicación simple, sin embargo, es crucial (y simple) para un servicio de alta carga. Su esencia es: los flujos de datos entrantes y salientes no deben cruzarse. Es decir, no puedes enviar una solicitud y esperar una respuesta; en su lugar, envías una solicitud al servicio A, pero recibes una respuesta en el servicio B.
El primer beneficio de este enfoque es la capacidad de desconexión (en un sentido amplio) durante la ejecución de una larga solicitud. Tomemos como ejemplo una secuencia más o menos estándar:
- El cliente envió una solicitud al servidor.
- El servidor inició un procesamiento prolongado.
- El servidor respondió al cliente con el resultado.
Imaginemos que en el punto 2 se produjo una interrupción de la conexión (ya sea que la red se reconectó o que el usuario cambió a otra página, cortando la conexión). En este caso, será difícil para el servidor enviar una respuesta al usuario con información sobre lo que se procesó. Al aplicar CQRS, la secuencia será un poco diferente:
- El cliente se suscribió a las actualizaciones.
- El cliente envió una solicitud al servidor.
- El servidor respondió "solicitud aceptada".
- El servidor respondió con el resultado a través del canal del punto "1".
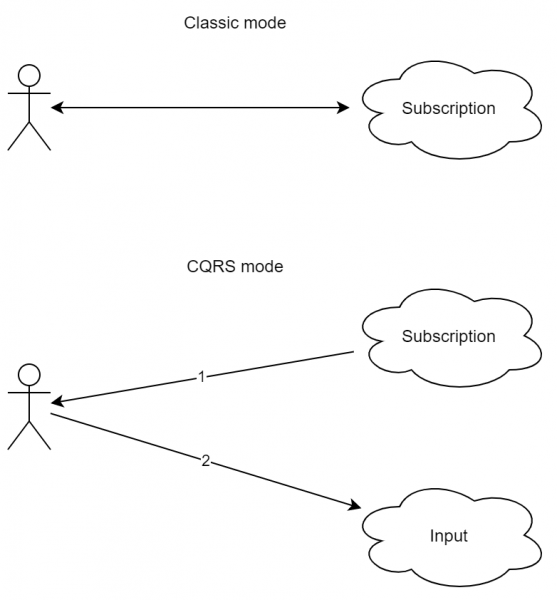
Como se puede ver, el esquema es un poco más complejo. Además, el enfoque intuitivo de solicitud-respuesta está ausente aquí. Sin embargo, como se observa, la interrupción de la conexión durante el procesamiento de la solicitud no conducirá a un error. Además, si efectivamente el usuario está conectado al servicio desde varios dispositivos (por ejemplo, desde un teléfono móvil y una tableta), se puede hacer que la respuesta llegue a ambos dispositivos.
Curiosamente, el código para procesar los mensajes entrantes se vuelve similar (no al 100%) tanto para los eventos que fueron influenciados por el cliente como para otros eventos, incluidos los de otros clientes.
Sin embargo, en realidad, obtenemos beneficios adicionales debido a que el flujo unidireccional puede ser procesado de manera funcional (utilizando RX y análogos). Y eso ya es una ventaja considerable, ya que, en esencia, la aplicación puede hacerse completamente reactiva, además de utilizar un enfoque funcional. Para aplicaciones robustas, esto puede ahorrar significativamente recursos en desarrollo y mantenimiento.
Si combinamos este enfoque con la escalabilidad horizontal, obtenemos como bono la posibilidad de enviar solicitudes a un servidor y recibir respuestas de otro. De esta manera, el cliente puede elegir el servicio que le sea conveniente, y el sistema interno podrá manejar correctamente los eventos.
Event Sourcing
Como saben, una de las características principales de un sistema distribuido es la ausencia de un tiempo común y una sección crítica común. Para un proceso, puede hacerse la sincronización (en los mismos mutex), dentro de la cual estás seguro de que nadie más está ejecutando ese código. Sin embargo, para un sistema distribuido, esto es peligroso, ya que requeriría gastos generales y se perdería toda la ventaja de la escalabilidad: de todos modos, todos los componentes esperarían a uno.
De aquí obtenemos un hecho importante: no se puede sincronizar un sistema distribuido rápido, ya que entonces disminuiríamos el rendimiento. Por otro lado, a menudo necesitamos cierta consistencia de los componentes. Para ello, se puede utilizar el enfoque de , donde se garantiza que, en ausencia de cambios en los datos, después de un cierto período de tiempo tras la última actualización («eventualmente»), todas las solicitudes devolverán el último valor actualizado.
Es importante entender que para las bases de datos clásicas a menudo se aplica , donde cada nodo posee la misma información (esto a menudo se logra cuando la transacción se considera establecida solo después de la respuesta del segundo servidor). Hay ciertas flexibilidades debido a los niveles de aislamiento, pero la esencia general sigue siendo la misma: puedes vivir en un mundo completamente consistente.
Sin embargo, volvamos a la tarea inicial. Si una parte del sistema puede construirse con , entonces se puede construir el siguiente esquema.
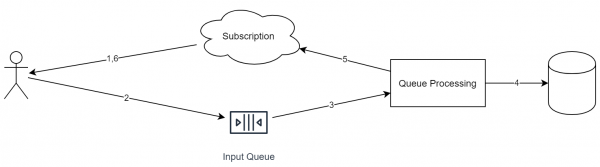
Características importantes de este enfoque:
- Cada solicitud entrante se coloca en una cola.
- Durante el proceso de procesamiento de la solicitud, el servicio también puede colocar tareas en otras colas.
- Cada evento entrante tiene un identificador (que es necesario para la deduplicación).
- La cola, ideológicamente, funciona bajo el principio de "solo añadir". No se pueden eliminar elementos de ella ni reorganizarlos.
- La cola funciona según el esquema FIFO (perdón por la tautología). Si es necesario realizar ejecución paralela, entonces se deben trasladar objetos a diferentes colas en una de las etapas.
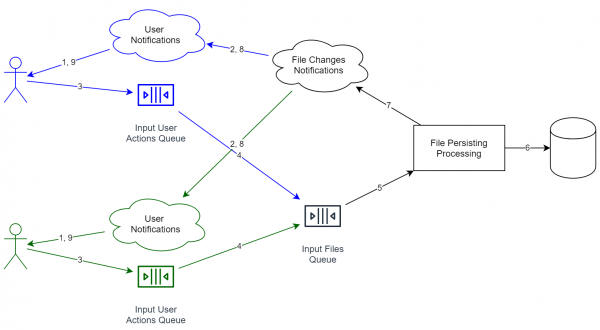
Recuerdo que estamos considerando el caso de un almacenamiento en línea de archivos. En este caso, el sistema se verá, más o menos, así:
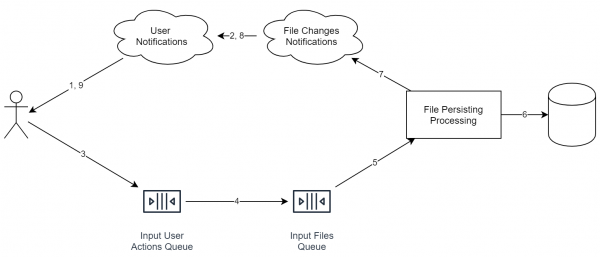
Es importante destacar que los servicios en el diagrama no necesariamente indican un servidor separado. Incluso el proceso puede ser el mismo. Lo que importa es que, ideológicamente, estas cosas están divididas de tal manera que se puede aplicar fácilmente la escalabilidad horizontal.
Y para dos usuarios, el esquema se verá así (los servicios destinados a diferentes usuarios están marcados con diferentes colores):
Los beneficios de esta combinación:
- Los servicios de procesamiento de información están separados. Las colas también están separadas. Si necesitamos aumentar la capacidad del sistema, solo necesitamos iniciar más servicios en más servidores.
- Cuando recibimos información del usuario, no es necesario esperar a que se complete el guardado de datos. Por el contrario, es suficiente con responder "ok", y luego comenzar a trabajar gradualmente. Al mismo tiempo, la cola suaviza los picos, ya que la adición de un nuevo objeto ocurre rápidamente y el usuario no necesita esperar por un recorrido completo por todo el ciclo.
- Como ejemplo, he añadido un servicio de deduplicación, que intenta combinar archivos idénticos. Si tarda mucho en un 1% de los casos, el cliente prácticamente no se dará cuenta (ver arriba), lo que es una gran ventaja, ya que de nosotros ya no se requiere una velocidad y fiabilidad del 100%.
Sin embargo, también se pueden ver desventajas:
- Nuestro sistema ha perdido la estricta coherencia. Esto significa que, por ejemplo, si uno se suscribe a diferentes servicios, teóricamente se puede obtener un estado diferente (ya que uno de los servicios podría no recibir a tiempo la notificación de la cola interna). Como otra consecuencia, el sistema ahora no tiene un tiempo común. Es decir, no se pueden, por ejemplo, clasificar todos los eventos simplemente por el tiempo de llegada, ya que los relojes entre servidores pueden no estar sincronizados (más aún, tener la misma hora en dos servidores sería una utopía).
- No se puede retroceder ningún evento ahora (como se podría hacer con una base de datos). En lugar de eso, es necesario añadir un nuevo evento — , que cambiará el último estado al necesario. Como ejemplo de un área similar: sin reescribir el historial (lo cual es malo en ciertos casos), en git no se puede deshacer un commit, sin embargo, se puede hacer un , que en esencia simplemente devolverá el estado anterior. Sin embargo, tanto el commit erróneo como el rollback quedarán registrados en el historial.
- El esquema de datos puede cambiar de una versión a otra, sin embargo, no será posible actualizar eventos antiguos al nuevo estándar (ya que los eventos no se pueden cambiar en principio).
Como se puede ver, Event Sourcing se lleva bien con CQRS. De hecho, implementar un sistema con colas eficaces y convenientes, pero sin separación de flujos de datos, ya es complicado en sí mismo, ya que habrá que añadir puntos de sincronización que anularán todo el efecto positivo de las colas. Al aplicar ambos enfoques a la vez, es necesario realizar ligeras correcciones en el código del funcionamiento del programa. En nuestro caso, al enviar un archivo al servidor, la respuesta solo dice 'ok', lo que significa que 'la operación de adición de archivo se ha guardado'. Formalmente, esto no implica que los datos ya estén disponibles en otros dispositivos (por ejemplo, el servicio de deduplicación puede estar reestructurando el índice). Sin embargo, después de un tiempo, el cliente recibirá una notificación del tipo 'el archivo X ha sido guardado'.
Como resultado:
- El número de estados de envío de archivos aumenta: en lugar del clásico 'archivo enviado', obtenemos dos: 'archivo añadido a la cola en el servidor' y 'archivo guardado en el almacenamiento'. Lo último significa que otros dispositivos ya pueden comenzar a recibir el archivo (teniendo en cuenta que las colas funcionan a diferentes velocidades).
- Debido a que la información sobre el envío ahora llega a través de diferentes canales, necesitamos idear soluciones para obtener el estado del procesamiento del archivo. Como consecuencia de esto: a diferencia de la clásica request-response, el cliente puede reiniciarse durante el procesamiento del archivo, pero el estado de este mismo procesamiento será correcto. Además, este aspecto funciona, en esencia, de forma predeterminada. Como consecuencia: ahora somos más tolerantes a fallos.
Sharding
Como se mencionó anteriormente, en sistemas con event sourcing no hay una coherencia estricta. Esto significa que podemos utilizar varios almacenes sin ninguna sincronización entre ellos. Acercándonos a nuestra tarea, podemos:
- Separar archivos por tipos. Por ejemplo, imágenes/videos pueden ser decodificados y seleccionados en un formato más eficiente.
- Separar cuentas por países. Esto puede ser necesario debido a muchas leyes, sin embargo, esta arquitectura permite hacerlo automáticamente.
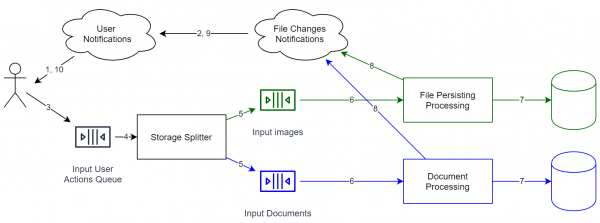
Si desea transferir datos de un almacenamiento a otro, aquí ya no será posible hacerlo con medios estándar. Desafortunadamente, en este caso es necesario detener la cola, realizar la migración y luego reactivarla. En general, no es posible transferir datos 'en caliente', sin embargo, si la cola de eventos se almacena completamente y tiene copias de los estados anteriores del almacenamiento, podemos reproducir los eventos de la siguiente manera:
- En Event Source, cada evento tiene su propio identificador (idealmente, no decreciente). Por lo tanto, en el almacenamiento podemos agregar un campo: id del último elemento procesado.
- Duplicamos la cola para que todos los eventos puedan ser procesados para varios almacenes independientes (el primero es el que ya contiene datos y el segundo es nuevo, aunque todavía vacío). La segunda cola, por supuesto, aún no se está procesando.
- Iniciamos la segunda cola (es decir, comenzamos a reproducir eventos).
- Cuando la nueva cola esté relativamente vacía (es decir, la diferencia media de tiempo entre la adición de un elemento y su extracción sea aceptable), se puede comenzar a redirigir a los lectores al nuevo almacenamiento.
Como se puede ver, en nuestro sistema nunca ha habido ni hay una estricta consistencia. Solo existe eventual consistencia, es decir, la garantía de que los eventos se procesan en el mismo orden (sin embargo, posiblemente, con diferentes retrasos). Y aprovechando esto, podemos transferir datos comparativamente fácil sin detener el sistema en el otro extremo del mundo.
Así, continuando con nuestro ejemplo sobre el almacenamiento en línea para archivos, esta arquitectura ya nos ofrece varias ventajas:
- Podemos mover objetos más cerca de los usuarios, y de manera dinámica. Esto puede mejorar la calidad del servicio.
- Podemos almacenar parte de los datos dentro de las empresas. Por ejemplo, los usuarios de Enterprise a menudo exigen que sus datos se almacenen en centros de datos controlables (para evitar fugas de datos). Gracias al sharding podemos soportar esto fácilmente. Y la tarea se simplifica aún más si el cliente tiene una nube compatible (por ejemplo, ).
- Lo más importante es que no tenemos que hacerlo. Al principio, bastaría con un solo almacenamiento para todas las cuentas (para comenzar a trabajar más rápido). Y la característica clave de este sistema es que, aunque es escalable, en la etapa inicial es bastante simple. Simplemente no hay que escribir de inmediato código que funcione con un millón de colas independientes, etc. Si es necesario, se puede hacer en el futuro.
Alojamiento de Contenido Estático
Este punto puede parecer obvio, pero sigue siendo necesario para una aplicación de carga más o menos estándar. Su esencia es simple: todo el contenido estático se entrega no desde el mismo servidor donde está la aplicación, sino desde especiales, dedicados precisamente para este propósito. Como consecuencia, estas operaciones se realizan más rápidamente (un nginx hipotético entrega archivos de manera más eficiente y menos costosa que un servidor Java). Además, la arquitectura CDN () permite ubicar nuestros archivos más cerca de los usuarios finales, lo que mejora la experiencia de uso del servicio.
El ejemplo más simple y estándar de contenido estático es un conjunto de scripts e imágenes para un sitio web. Con ellos es todo bastante sencillo: se conocen por adelantado, luego se carga el archivo en los servidores de CDN, desde donde se entregan a los usuarios finales.
Sin embargo, en la práctica, se puede aplicar un enfoque similar a la arquitectura lambda para el contenido estático. Regresando a nuestra tarea (almacenamiento en línea de archivos), en la que necesitamos entregar archivos a los usuarios. La solución más simple sería crear un servicio que, para cada solicitud del usuario, realice todas las comprobaciones necesarias (autorización, etc.) y luego descargue el archivo directamente de nuestro almacenamiento. El principal inconveniente de este enfoque es que el contenido estático (y un archivo con una revisión específica es esencialmente contenido estático) es entregado por el mismo servidor que contiene la lógica empresarial. En su lugar, se podría realizar el siguiente esquema:
- El servidor emite una URL para la descarga. Puede tener el formato file_id + key, donde key es una firma digital mínima que otorga el acceso al recurso durante las siguientes 24 horas.
- La entrega del archivo es manejada por un sencillo nginx con las siguientes opciones:
- Almacenamiento en caché de contenido. Dado que este servicio puede estar en un servidor separado, nos hemos dejado un margen para el futuro con la posibilidad de almacenar todos los archivos descargados últimamente en el disco.
- Verificación de la clave en el momento de establecer la conexión
- Opcional: procesamiento de contenido en streaming. Por ejemplo, si comprimimos todos los archivos en el servicio, se puede realizar la descompresión directamente en este módulo. Como consecuencia: las operaciones de IO se llevan a cabo donde realmente tienen sentido. Un archivador en Java puede requerir mucha memoria adicional, sin embargo, reescribir el servicio con lógica empresarial en lenguajes como Rust o C++ podría resultar también ineficaz. En nuestro caso, se utilizan diferentes procesos (o incluso servicios), por lo que se puede separar de manera bastante eficiente la lógica empresarial de las operaciones de IO.
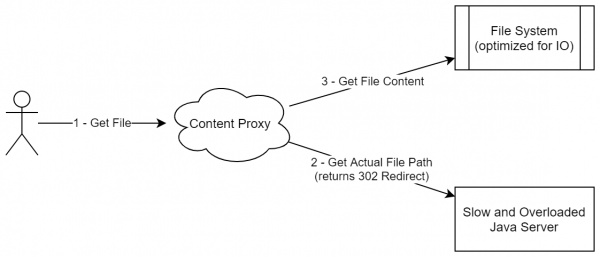
Tal esquema no se asemeja mucho a la distribución de contenido estático (ya que no estamos exportando todo el paquete de estáticos a ningún lado), sin embargo, en realidad, este enfoque se ocupa precisamente de la entrega de datos inmutables. Además, este esquema puede generalizarse a otros casos donde el contenido no solo es estático, sino que puede presentarse como un conjunto de bloques inmutables y no eliminables (aunque se pueden agregar).
Como otro ejemplo (para reforzar la idea): si has trabajado con Jenkins o TeamCity, sabes que ambas soluciones están escritas en Java. Ambas se presentan como un proceso Java que se encarga tanto de la orquestación de construcciones como de la gestión de contenido. En particular, ambas tienen tareas del tipo "transferir archivo/carpeta desde el servidor". Por ejemplo: la entrega de artefactos, la transferencia de código fuente (cuando el agente no descarga el código directamente del repositorio, sino que lo hace el servidor), acceso a registros. Todas estas tareas tienen diferentes cargas en IO. Es decir, el servidor que se ocupa de la compleja lógica empresarial también debe ser capaz de manejar grandes flujos de datos de manera eficiente. Y lo más interesante es que dicha operación se puede delegar al mismo nginx utilizando exactamente el mismo esquema (excepto que en la solicitud se debe añadir la clave de datos).
Sin embargo, si volvemos a nuestro sistema, el esquema que resulta es el siguiente:
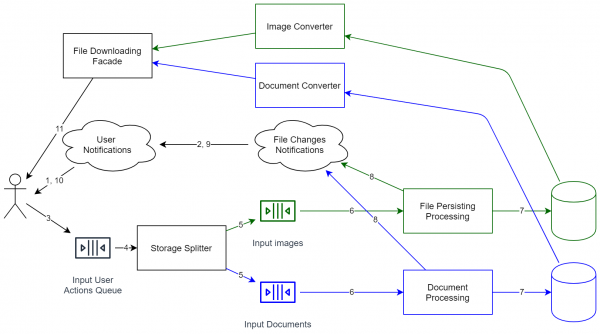
Como se puede ver, el sistema se ha vuelto radicalmente más complejo. Ahora no es solo un mini-proceso que almacena archivos localmente. Ahora se requiere un soporte que no es el más sencillo, control de versiones de API, etc. Por lo tanto, después de que se dibujen todos los diagramas, es mejor evaluar en detalle si la escalabilidad justifica esos costos. Sin embargo, si desea tener la capacidad de expandir el sistema (incluyendo para trabajar con un mayor número de usuarios), tendrá que optar por estas soluciones. Como resultado, la arquitectura del sistema está lista para aumentar la carga (casi cada componente se puede clonar para escalado horizontal). El sistema se puede actualizar sin detenerlo (simplemente algunas operaciones se ralentizarán ligeramente).
Como mencioné al principio, varios servicios en línea están experimentando una carga aumentada. Y algunos de ellos simplemente han dejado de funcionar correctamente. De hecho, los sistemas fallaron justo en el momento en que el negocio debería estar generando ingresos. En lugar de posponer la entrega, en lugar de ofrecer a los clientes 'planifiquen el suministro para los próximos meses', el sistema simplemente dijo 'vayan con la competencia'. Esa es la verdadera dimensión del costo de un bajo rendimiento: las pérdidas ocurren precisamente cuando las ganancias serían más altas.
Conclusión
Todos estos enfoques ya eran conocidos anteriormente. VK ha estado utilizando la idea de Hosting de Contenido Estático para emitir imágenes desde hace tiempo. Un montón de juegos en línea utilizan un esquema de Sharding para dividir a los jugadores por regiones o para separar las ubicaciones de juego (si el mundo es único). El enfoque de Event Sourcing se utiliza ampliamente en el correo electrónico. La mayoría de las aplicaciones de los traders, donde los datos llegan continuamente, están construidas sobre el enfoque CQRS para poder filtrar los datos recibidos. Además, el escalado horizontal se ha estado aplicando en muchos servicios desde hace bastante tiempo.
Sin embargo, lo más importante es que todos estos patrones se han vuelto muy fáciles de aplicar en las aplicaciones modernas (siempre que sean pertinentes, por supuesto). Las nubes ofrecen Sharding y escalado horizontal de inmediato, lo cual es mucho más fácil que pedir diferentes servidores dedicados en distintos centros de datos por su cuenta. CQRS se ha vuelto mucho más fácil, en parte gracias al desarrollo de bibliotecas como RX. Hace 10 años, un sitio web raro podría haber soportado esto. La configuración de Event Sourcing también se hace increíblemente sencilla gracias a los contenedores ya preparados con Apache Kafka. Hace 10 años, esto sería una innovación; ahora es cotidiano. Lo mismo ocurre con el Hosting de Contenido Estático: debido a las tecnologías más convenientes (incluyendo el hecho de que hay documentación detallada y una gran base de respuestas), esta aproximación se ha vuelto aún más simple.
Como resultado, la implementación de varios patrones arquitectónicos bastante complejos ahora es mucho más sencilla, lo que significa que es recomendable considerarlos de antemano. Si en una aplicación de diez años se descartó una de las soluciones anteriores debido al alto costo de implementación y operación, en una nueva aplicación, o tras una refactorización, se puede crear un servicio que arquitectónicamente ya sea tanto escalable (en términos de rendimiento) como preparado para nuevas demandas de clientes (por ejemplo, para la localización de datos personales).
Y lo más importante: por favor, no utilicen estos enfoques si tienen una aplicación simple. Sí, son bonitos e interesantes, pero para un sitio con un pico de visita de 100 personas, a menudo se puede optar por un monolito clásico (al menos externamente, internamente todo se puede dividir en módulos, etc.).
Fuente: habr.com
