

La primera parte — .
Imagina la situación. Tienes la tarea de desarrollar una nueva funcionalidad. Cuentas con los avances de tus predecesores. Si asumimos que no tienes ninguna obligación moral, ¿cómo procederías?
Con frecuencia, todos los antiguos desarrollos caen en el olvido y todo comienza desde cero. Nadie quiere hurgar en el código ajeno, y si hay tiempo, ¿por qué no dedicarse a crear un sistema propio? Este es un enfoque típico y, en gran medida, correcto. Pero en nuestro proyecto no hicimos eso. Basamos el futuro sistema de pruebas automáticas en los desarrollos de pruebas unitarias en utPLSQL de nuestros predecesores y luego comenzamos a trabajar en varias direcciones paralelas.
- Recuperación de antiguas pruebas unitarias. Por recuperación se entiende la adaptación de las pruebas al estado actual del sistema de lealtad y la adaptación de las pruebas a los estándares de utPLSQL.
- La solución al problema de la comprensión de qué métodos y procesos están cubiertos por las pruebas automáticas. Hay que mantener esta información en la cabeza o sacar conclusiones directamente del código de las pruebas automáticas. Por eso decidimos crear un catálogo. A cada prueba automática le asignamos un código mnemotécnico único, creamos una descripción y registramos la configuración (por ejemplo, en qué condiciones debe ejecutarse o qué debe suceder si la ejecución de la prueba falla). En esencia, completamos los metadatos de las pruebas automáticas y los colocamos en las tablas estándar del esquema de utPLSQL.
- Definición de la estrategia de expansión, es decir, la elección de las funcionalidades que serán verificadas por las pruebas automáticas. Decidimos centrarnos en tres aspectos: las nuevas mejoras del sistema, los incidentes en producción y los procesos clave del sistema. De esta manera, evolucionamos paralelamente al lanzamiento, mejorando su calidad, ampliamos el volumen de regresiones y garantizamos la fiabilidad del sistema en lugares críticos. El primer punto crítico fue el proceso de distribución de descuentos y bonificaciones en los recibos.
- Por supuesto, nos dedicamos al desarrollo de nuevas pruebas automáticas. Una de las primeras tareas del lanzamiento fue evaluar el rendimiento de las muestras predefinidas del sistema de lealtad. En nuestro proyecto, hay un bloque de consultas SQL rígidamente definidas que seleccionan clientes según ciertos criterios. Por ejemplo, obtener una lista de todos los clientes cuya última compra se realizó en una ciudad específica, o una lista de clientes cuya media de compra supera un valor determinado. Al escribir pruebas automáticas, verificamos las muestras predefinidas, registramos los parámetros de rendimiento de referencia y, además, realizamos pruebas de carga.
- El trabajo con pruebas automáticas debe ser conveniente.. Las acciones más comunes son: ejecutar pruebas automáticas y crear datos de prueba. Así, en nuestro sistema surgieron dos módulos auxiliares: un módulo de ejecución y un módulo de generación de datos.
El módulo de ejecución se presenta como un procedimiento universal con un único parámetro de texto de entrada. Como parámetro, se puede pasar el código mnemotécnico de la prueba automática, el nombre del paquete, el nombre de la prueba, la configuración de la prueba automática o una palabra clave reservada. El procedimiento selecciona y ejecuta todas las pruebas automáticas que cumplen con las condiciones.
El módulo de generación de datos se presenta como un paquete, en el cual para cada objeto del sistema en prueba (tabla en la base de datos), se creó un procedimiento especial que inserta datos allí. En este procedimiento, se maximizan los valores predeterminados, lo que permite crear objetos literalmente con un chasquido de dedos. Y para comodidad de uso, se crearon plantillas de datos generados. Por ejemplo, crear un cliente de cierta edad con un teléfono de prueba y una compra realizada.
- Las pruebas automáticas deben iniciarse y funcionar en un tiempo aceptable para su sistema. Por lo tanto, se organizó un lanzamiento diario nocturno, cuyos resultados se recopilan en un informe que se envía a todo el equipo de desarrollo a través del correo corporativo. Después de restaurar las pruebas automáticas antiguas y crear nuevas, el tiempo total de operación fue de 30 minutos. Este nivel de rendimiento fue satisfactorio para todos, ya que la ejecución se realizaba fuera del horario laboral.
Sin embargo, se tuvo que trabajar en la optimización de la velocidad. La actualización del sistema de lealtad en producción se realiza por la noche. Durante uno de los lanzamientos, se tuvieron que hacer cambios de emergencia en medio de la noche. La media hora de espera por los resultados de las pruebas automáticas a las tres de la mañana no hizo feliz al responsable del lanzamiento (un saludo cálido a Alexey Vasyukov), y a la mañana siguiente se dijeron muchas cosas amables sobre nuestro sistema. Sin embargo, al final se estableció un estándar de 5 minutos para el funcionamiento.
Para acelerar el rendimiento, utilizamos dos métodos: las pruebas automáticas se ejecutan en tres flujos paralelos, lo cual es muy conveniente debido a la arquitectura de nuestro sistema de lealtad. Y abandonamos el enfoque en el que la prueba automática no crea datos de prueba para sí misma, sino que intenta encontrar algo adecuado en el sistema. Después de realizar estos cambios, el tiempo total de ejecución se redujo a 3-4 minutos.
- El proyecto de pruebas automáticas debe poder desplegarse en diferentes entornos. Al principio, intentamos escribir nuestros propios scripts, pero nos dimos cuenta de que una instalación automatizada hecha a mano es un verdadero desastre, así que nos orientamos hacia soluciones industriales. Dado que hay mucho código en el proyecto (principalmente almacenamos el código de las pruebas automáticas) y pocos datos (los datos principales son metadatos sobre las pruebas automáticas), la implementación de Liquibase en el proyecto resultó ser muy sencilla.
Es una biblioteca independiente de la base de datos de código abierto para rastrear, gestionar y aplicar cambios en el esquema de la base de datos. Se gestiona a través de la línea de comandos o de marcos como Apache Maven. El principio de funcionamiento de Liquibase es bastante simple. Tenemos un proyecto organizado de cierta manera, que consiste en cambios o scripts que se deben aplicar al servidor de destino, y archivos de control que determinan en qué orden y con qué parámetros se deben instalar dichos cambios.
A nivel de la base de datos, se crea una tabla especial donde Liquibase almacena el registro de las implementaciones. Cada cambio tiene un hash calculado que se compara cada vez entre el proyecto y el estado en la base de datos. Gracias a Liquibase, implementamos fácilmente los cambios en nuestro sistema en cualquier entorno. Las pruebas automáticas se ejecutan actualmente en entornos de prueba y de lanzamiento, así como en contenedores (entornos personales de desarrolladores).
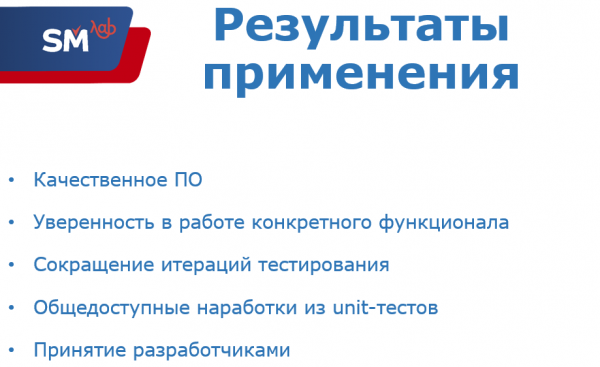
Así que hablemos sobre los resultados de la aplicación de nuestro sistema de pruebas unitarias.
- Por supuesto, en primer lugar, estamos convencidos de que hemos comenzado a desarrollar software de mejor calidad. Las pruebas automáticas se ejecutan diariamente y en cada lanzamiento, detectando decenas de errores. Además, parte de estos errores están solo indirectamente relacionados con la funcionalidad que realmente queríamos cambiar. Hay serias dudas de que estos errores fueron encontrados a través de pruebas manuales.
- El equipo ha ganado confianza en que una funcionalidad específica funciona correctamente... Esto se aplica en primer lugar a nuestros procesos críticos. Por ejemplo, en los últimos seis meses no hemos tenido problemas con la distribución de descuentos y bonos en el ticket, a pesar de los cambios en cada lanzamiento, aunque en períodos anteriores los errores ocurrían con cierta periodicidad.
- Hemos logrado reducir la cantidad de iteraciones de pruebas. Gracias a que las pruebas automáticas se escriben para nueva funcionalidad, los analistas y, por su parte, los testers reciben código de mayor calidad, ya que ha sido verificado.
- Parte de los desarrollos de pruebas automatizadas es utilizada por los desarrolladores. Por ejemplo, los datos de prueba en los contenedores se generan mediante un módulo de generación de objetos.
- Es importante destacar que hemos logrado una aceptación del sistema de pruebas automatizadas por parte de los desarrolladores. Existe un entendimiento de que es importante y útil. Y por experiencia propia, puedo decir que no siempre es así. Las pruebas automáticas deben escribirse, mantenerse y desarrollarse, analizar los resultados, y a menudo, este tiempo invertido simplemente no vale la pena. Es mucho más fácil ir al entorno de producción y allí resolver los problemas. Sin embargo, nuestros desarrolladores hacen fila y piden que cubramos su funcionalidad con pruebas automáticas.
¿Qué sigue?
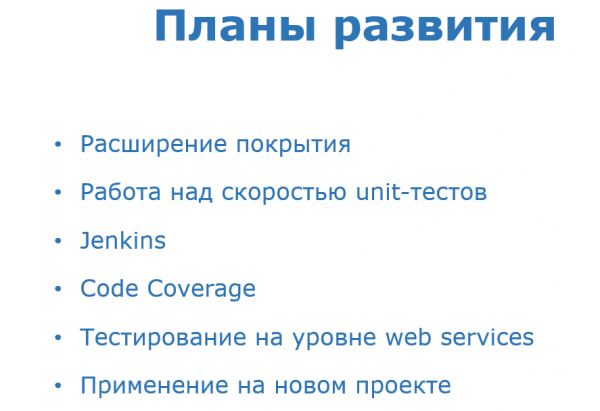
Hablemos sobre los planes de desarrollo del proyecto de pruebas automatizadas.
Sin duda, mientras el sistema de lealtad de Sportmaster esté vivo y en constante desarrollo, también se pueden desarrollar prácticamente de forma infinita las pruebas automatizadas. Por lo tanto, la principal dirección de desarrollo es la expansión de la cobertura.
A medida que aumenta la cantidad de pruebas automatizadas, el tiempo total de su ejecución también crecerá de manera invariable, y deberemos volver a abordar la cuestión del rendimiento. Lo más probable es que la solución radique en aumentar la cantidad de hilos paralelos.
Pero estos son caminos evidentes de desarrollo. Si hablamos de algo más no trivial, destaquemos lo siguiente:
- Actualmente, la gestión de las pruebas automatizadas se realiza a nivel de base de datos, es decir, se necesitan conocimientos de PL/SQL para un funcionamiento exitoso. Si es necesario, la gestión del sistema (por ejemplo, ejecutar lanzamientos o crear metadatos) se puede delegar a algún panel de administración, utilizando Jenkins o algo similar.
- A todos les gustan los indicadores cuantitativos y cualitativos. Para las pruebas automáticas, un indicador universal es la cobertura de código o la métrica de cobertura de código. Con esta métrica podemos determinar qué porcentaje del código de nuestro sistema en prueba está cubierto por pruebas automatizadas. A partir de la versión 12.2, Oracle ofrece capacidades para el cálculo de esta métrica y sugiere usar el paquete estándar DBMS_PLSQL_CODE_COVERAGE.
Nuestro sistema de pruebas automatizadas tiene poco más de un año y, tal vez, ahora sea el momento adecuado para evaluar la cobertura. En mi proyecto anterior (no el de Sportmaster) ocurrió así. Un año después de trabajar en pruebas automatizadas, la dirección estableció la tarea de evaluar qué porcentaje de código está cubierto. Con una cobertura de más del 1%, la dirección estaría satisfecha. Nosotros, los desarrolladores, esperábamos un resultado cercano al 10%. Activamos la cobertura de código, medimos y obtuvimos un 20%. Con la alegría, fuimos a buscar una bonificación, pero cómo la conseguimos y a dónde fuimos después, es toda otra historia.
- Las pruebas automatizadas pueden verificar los servicios web expuestos. Oracle permite hacer esto, y ya no enfrentaremos una serie de problemas.
- Y, por supuesto, nuestro sistema de pruebas automatizadas se puede aplicar a otros proyectos. La solución que hemos obtenido es universal y solo requiere el uso de Oracle. He oído que en otros proyectos de Sportmaster hay interés en las pruebas automatizadas y, posiblemente, nos dirigiremos hacia ellos.
Conclusiones
Resumamos. En el proyecto del sistema de lealtad de Sportmaster, logramos implementar un sistema de pruebas automatizadas. Su base es la solución utPLSQL de Steven Feuerstein. Alrededor de utPLSQL se encuentra el código de las pruebas automáticas y módulos auxiliares hechos a medida: módulo de lanzamiento, módulo de generación de datos y otros. Las pruebas automáticas se ejecutan diariamente y, lo que es más importante, funcionan y aportan beneficios. Estamos convencidos de que hemos comenzado a lanzar software de mayor calidad. Además, la solución obtenida es universal y puede aplicarse libremente a cualquier proyecto donde sea necesario implementar pruebas automatizadas en la base de datos Oracle.
P.D. Este artículo resultó no ser muy concreto: hay mucho texto y prácticamente no hay ejemplos técnicos. Si a grandes rasgos el tema es interesante, estamos dispuestos a continuar y volver con una continuación, donde contaremos qué ha cambiado en los últimos seis meses y proporcionaremos ejemplos de código.
Escriban comentarios si hay aspectos que merece destacar en el futuro, o preguntas que requieran aclaración.
Solo los usuarios registrados pueden participar en la encuesta. , por favor.
¿Seguimos escribiendo sobre esto?
Sí, claro
No, gracias
12 usuarios votaron. 4 usuarios se abstuvieron.
Fuente: habr.com
