

prefacio
Existe una utilidad tan simple y muy útil en el mundo: , y resultó que llevaba mucho tiempo arraigado en nuestro proceso de producción (aunque no fue posible instalar su versión, pero definitivamente no fue la última disponible). Lo usamos para el propósito previsto: crear parches binarios. Si miras lo que hay en el repositorio, se vuelve un poco triste: de hecho, fue abandonado hace mucho tiempo y gran parte está muy desactualizado (mi ex colega una vez hizo varias ediciones allí, pero eso fue hace mucho tiempo). . En general, decidí resucitar este asunto: bifurqué, tiré lo que no planeaba usar, moví el proyecto a , incorporó las microfunciones "calientes", eliminó matrices grandes de la pila (y matrices de longitud variable, que francamente me hacen "bomba"), ejecutó el generador de perfiles una vez más y descubrió que aproximadamente el 40% del tiempo se dedica a ...
Entonces, ¿qué pasa con fwrite?
En este código, fwrite (en mi caso de prueba específico: creando un parche entre archivos cercanos de 300 MB, los datos de entrada están completamente en la memoria) se llama millones de veces con un tamaño de búfer pequeño. Obviamente, esto se ralentizará y, por lo tanto, me gustaría influir de alguna manera en esta desgracia. Todavía no deseo implementar varios tipos de fuentes de datos, entrada y salida asíncrona, quería encontrar una solución más simple. Lo primero que me vino a la mente fue aumentar el tamaño del buffer.
setvbuf(file, nullptr, _IOFBF, 64* 1024)pero no obtuve una mejora significativa en el resultado (ahora fwrite representó aproximadamente el 37% del tiempo), lo que significa que todavía no se trata de escribir datos con frecuencia en el disco. Mirando "debajo del capó" de fwrite, puede ver que se está produciendo una estructura de ARCHIVO de bloqueo/desbloqueo dentro de algo como esto (pseudocódigo, todo el análisis se realizó en Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lock stream */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* unlock stream */
   }
   return retval;
}
Según el perfilador, _fwrite_nolock representa solo el 6% del tiempo, el resto es gastos generales. En mi caso particular, la seguridad de los subprocesos es claramente excesiva, por lo que la sacrificaré reemplazando la llamada fwrite con - Ni siquiera necesitas ser inteligente con los argumentos. Total: esta sencilla manipulación redujo significativamente el coste de registrar el resultado, que en la versión original ascendía a casi la mitad del tiempo invertido. Por cierto, en el mundo POSIX existe una función similar: . En términos generales, lo mismo se aplica a fread. Por lo tanto, usando un par de #defines, puede obtener una solución completamente multiplataforma sin bloqueos innecesarios si no son necesarios (y esto sucede con bastante frecuencia).
fwrite, _fwrite_nolock, setvbuf
Alejémonos del proyecto original y centrémonos en probar un caso específico: escribir un archivo grande (512 MB) en fragmentos muy pequeños, de un byte cada uno. Sistema de prueba: AMD Ryzen 7 1700, 16 GB de RAM, disco duro de 7200 rpm, caché de 64 MB. Windows 10 1809, el binario se compiló como de 32 bits, las optimizaciones están habilitadas, la biblioteca está enlazada estáticamente.
Muestra para el experimento:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
Las variables serán TEST_BUFFER_SIZE y, en un par de casos, reemplazaremos fwrite_unlocked con fwrite. Comencemos con el caso fwrite sin configurar explícitamente el tamaño del búfer (comente setvbuf y el código asociado): tiempo 27048906 µs, velocidad de escritura: 18.93 MB/s. Ahora establezcamos el tamaño del búfer en 64 KB: tiempo - 25037111 μs, velocidad - 20.44 Mb/s. Ahora probemos el funcionamiento de _fwrite_nolock sin llamar a setvbuf: 7262221 µs, velocidad - 70.5 Mb/s.
A continuación, experimentemos con el tamaño del búfer (setvbuf):
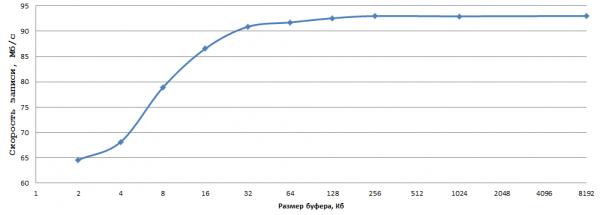
Los datos se obtuvieron promediando 5 experimentos; era demasiado vago para calcular los errores. En lo que a mí respecta, 93 MB/s al escribir 1 byte en un disco duro normal es un resultado muy bueno, solo necesitas seleccionar el tamaño de búfer óptimo (en mi caso, 256 KB es el correcto) y reemplazar fwrite con _fwrite_nolock/fwrite_unlocked ( en caso de que no se necesite seguridad para hilos, por supuesto).
Lo mismo ocurre con fread en similares condiciones. Como no tengo una máquina de hardware con Linux a mano (las placas individuales no cuentan), decidí realizar un experimento limitado en una máquina virtual (Hyper-V, OpenSUSE 15, GCC 8.3.1): el patrón es básicamente lo mismo: fwrite “desnudo” 20 Mb/s, fwrite + búfer de 256 KB produjo 23 Mb/s, fwrite_unlocked con el mismo búfer - 35 Mb/s (binario de 64 bits, ensamblado g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Epílogo
El propósito de escribir este artículo fue describir una técnica simple y efectiva en muchos casos (nunca antes me había encontrado con las funciones _fwrite_nolock/fwrite_unlocked, no son muy populares, pero en vano). No pretendo que el material sea nuevo, pero espero que el artículo sea útil para la comunidad.
Fuente: habr.com
