

Netflix es el líder del mercado de televisión por internet, una empresa que ha creado y desarrollado activamente este segmento. Netflix es conocido no solo por su extenso catálogo de películas y series, accesibles desde casi cualquier rincón del planeta y cualquier dispositivo con pantalla, sino también por su infraestructura sólida y su cultura ingenieril única.
Un ejemplo claro del enfoque de Netflix en el desarrollo y mantenimiento de sistemas complejos fue presentado en DevOops 2019 — director de desarrollo en Netflix. Graduado de la Facultad de Matemáticas y Ciencias de la Computación de la Universidad Estatal Nizhni Nóvgorod, Serguéi es uno de los primeros ingenieros en Open Connect, el equipo de CDN de Netflix. Construyó sistemas de monitoreo y análisis de datos de video, lanzó el popular servicio de evaluación de la velocidad de conexión a Internet FAST.com y en los últimos años ha trabajado en la optimización de las solicitudes de Internet para que la aplicación de Netflix funcione lo más rápido posible para los usuarios.
La charla recibió las mejores críticas de los participantes de la conferencia, y hemos preparado para ustedes una versión escrita.
En la presentación, Serguéi habló en detalle
- sobre lo que afecta la latencia de las solicitudes de internet entre el cliente y el servidor;
- cómo reducir dicha latencia;
- cómo diseñar, mantener y monitorear sistemas resilientes;
- cómo lograr resultados en plazos ajustados y con el mínimo riesgo para el negocio;
- cómo analizar los resultados y aprender de los errores.
Las respuestas a estas preguntas son necesarias no solo para quienes trabajan en grandes corporaciones.
Los principios y técnicas presentados deben ser conocidos y practicados por cualquier persona que desarrolle y mantenga productos de internet.
A continuación, un relato desde la perspectiva del ponente.
La importancia de la velocidad de internet
La velocidad de las solicitudes de internet está directamente relacionada con el negocio. Consideremos el ámbito de las compras: la empresa Amazon en 2009 , que un retraso de 100 ms provoca una pérdida del 1% en ventas.
Cada vez hay más dispositivos móviles, seguidos de sitios y aplicaciones móviles. Si tu página tarda más de 3 segundos en cargar, estás perdiendo alrededor de la mitad de los usuarios. Desde Google tiene en cuenta la velocidad de carga de tu página en los resultados de búsqueda: cuanto más rápida sea la página, mejor será su posición en Google.
La velocidad de conexión también es importante en las organizaciones financieras, donde el retraso es crítico. En 2015, la empresa Hibernia Networks la instalación de un cable entre Nueva York y Londres con un costo de 400 millones de dólares para reducir la latencia entre las ciudades en 6 ms. ¡Imagínate, 66 millones de dólares por cada 1 ms de reducción de latencia!
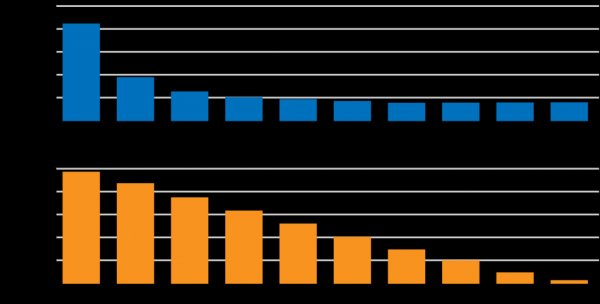
Según , la velocidad de conexión superior a 5 Mbit/s deja de influir directamente en la velocidad de carga de un sitio web típico. Sin embargo, existe una relación lineal entre la latencia de conexión y la velocidad de carga de la página:
Sin embargo, Netflix no es un producto típico. El impacto de la latencia y la velocidad en el usuario es un área activa de análisis y desarrollo. Hay cargas de aplicación y selección de contenido que dependen de la latencia, pero la carga de elementos estáticos y el streaming también dependen de la velocidad de conexión. El análisis y la optimización de los factores clave que afectan la calidad del servicio para el usuario es un área activa de desarrollo de varios equipos en Netflix. Una de las tareas es reducir la latencia de las solicitudes entre los dispositivos de Netflix y la infraestructura en la nube.
En este informe, nos centraremos precisamente en la reducción de la latencia utilizando la infraestructura de Netflix como ejemplo. Consideraremos desde un punto de vista práctico cómo abordar los procesos de diseño, desarrollo y operación de sistemas distribuidos complejos, y dedicar tiempo a la innovación y a los resultados, no al diagnóstico de problemas operativos y fallos.
Dentro de Netflix
Miles de dispositivos diferentes soportan las aplicaciones de Netflix. Su desarrollo está a cargo de cuatro equipos distintos, que crean versiones separadas del cliente para Android, iOS, TV y navegadores web. Y dedicamos muchos recursos a mejorar y personalizar la interfaz de usuario. Para ello, llevamos a cabo cientos de pruebas A/B de manera paralela.
La personalización se mantiene gracias a cientos de microservicios en la nube de AWS que proporcionan datos personalizados para el usuario, gestión de solicitudes, telemetría, Big Data y codificación. La visualización del tráfico es la siguiente:
A la izquierda se encuentra el punto de entrada, y luego el tráfico se distribuye entre varios cientos de microservicios, que son soportados por diferentes equipos de backend.
Otro componente importante de nuestra infraestructura es Open Connect CDN, que entrega contenido estático al usuario final, como videos, imágenes y código para clientes, entre otros. El CDN está ubicado en servidores personalizados (OCA — Open Connect Appliance). Dentro de estos, hay arreglos de discos SSD y HDD gestionados por un FreeBSD optimizado, con NGINX y un conjunto de servicios. Diseñamos y optimizamos los componentes de hardware y software para que este servidor CDN pueda enviar la mayor cantidad de datos posible a los usuarios.
La 'pared' de estos servidores en el punto de intercambio de tráfico de Internet (Internet eXchange — IX) se ve así:
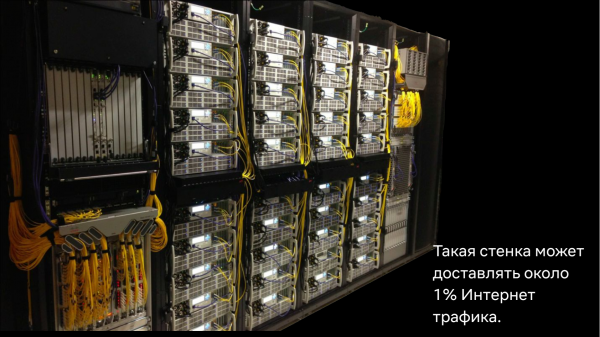
El Internet Exchange permite a los proveedores de Internet y a los proveedores de contenido 'conectarse' entre sí para un intercambio más directo de datos en Internet. En todo el mundo, hay aproximadamente 70-80 puntos de Internet Exchange donde se encuentran nuestros servidores, y nos encargamos por nuestra cuenta de su instalación y mantenimiento:
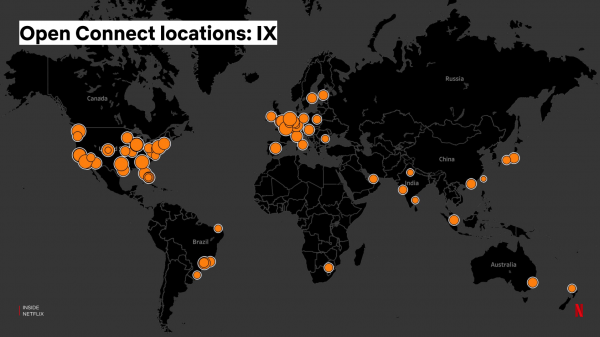
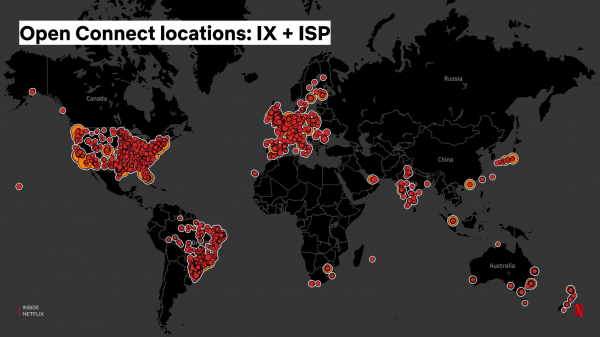
Además, también proporcionamos servidores directamente a los proveedores de Internet, que los instalan en su red, mejorando la localización del tráfico de Netflix y la calidad de transmisión para los usuarios:
El conjunto de servicios de AWS es responsable de la gestión de las solicitudes de video de los clientes a los servidores CDN, así como de la configuración de los propios servidores — actualización de contenido, código de software, configuraciones, etc. Para esto, también hemos construido una red backbone que conecta los servidores en los puntos de Internet Exchange con AWS. La red backbone consiste en una red global de cables de fibra óptica y enrutadores que podemos diseñar y configurar según nuestras necesidades.
Por , nuestra infraestructura CDN entrega en horas pico aproximadamente ⅛ parte del tráfico de Internet mundial y ⅓ del tráfico en América del Norte, donde Netflix ha estado presente durante más tiempo. Son cifras impresionantes, pero para mí, uno de los logros más sorprendentes es que todo el sistema CDN es desarrollado y mantenido por un equipo de menos de 150 personas.
Inicialmente, la infraestructura CDN fue diseñada para entregar datos de video. Sin embargo, con el tiempo, nos dimos cuenta de que también podíamos utilizarla para optimizar solicitudes dinámicas de clientes en la nube de AWS.
Sobre la aceleración de Internet
Hoy Netflix tiene 3 regiones de AWS, y la latencia de las solicitudes en la nube dependerá de la distancia del cliente al área regional más cercana. Además, contamos con numerosos servidores CDN que se utilizan para entregar contenido estático. ¿Hay alguna manera de usar esta infraestructura para acelerar las solicitudes dinámicas? Lamentablemente, no se pueden almacenar en caché estas solicitudes, ya que las API están personalizadas y cada resultado es único.
Hagamos un proxy en el servidor CDN y empecemos a dirigir el tráfico a través de él. ¿Será más rápido?
Material técnico
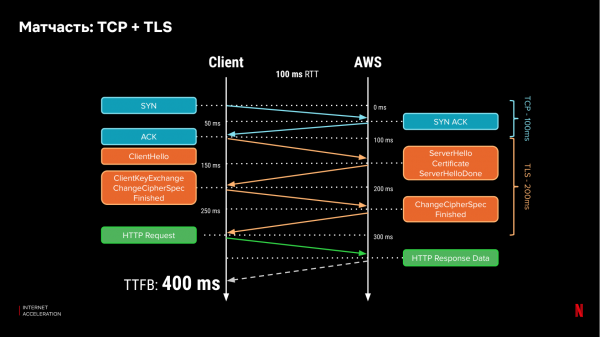
Recordemos cómo funcionan los protocolos de red. Hoy en día, la mayor parte del tráfico en Internet utiliza HTTPs, que depende de los protocolos de nivel inferior TCP y TLS. Para que un cliente se conecte al servidor, realiza un handshake, y para establecer una conexión segura, el cliente debe intercambiar mensajes con el servidor tres veces y al menos una vez más para transmitir datos. Con una latencia en una interacción (RTT) de 100 ms, necesitaremos 400 ms para recibir el primer bit de datos:
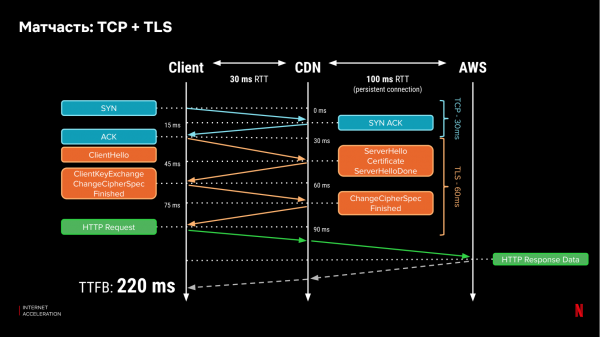
Si ubicamos los certificados en el servidor CDN, podemos reducir drásticamente el tiempo de 'handshake' entre el cliente y el servidor, si el CDN está más cerca. Supongamos que la latencia al servidor CDN es de 30 ms. Entonces, para recibir el primer bit se requerirán solo 220 ms:
Pero las ventajas no terminan aquí. Una vez que la conexión ya está establecida, TCP aumenta la ventana de congestión (la cantidad de información que puede enviar a través de esta conexión en paralelo). Si se pierde un paquete de datos, las implementaciones clásicas del protocolo TCP (como TCP New Reno) reducen la 'ventana' abierta a la mitad. El crecimiento de la ventana de congestión y la velocidad de su recuperación de pérdidas dependen nuevamente de la latencia (RTT) al servidor. Si esta conexión va solo hasta el servidor CDN, esta recuperación será más rápida. Además, la pérdida de paquetes es un fenómeno estándar, especialmente en redes inalámbricas.
La capacidad de Internet puede disminuir, especialmente en horas pico debido al tráfico de usuarios, lo que puede provocar 'congestiones'. Sin embargo, no hay forma de priorizar unas solicitudes sobre otras en la red. Por ejemplo, dar prioridad a solicitudes pequeñas y sensibles a la latencia sobre flujos de datos 'pesados' que sobrecargan la red. No obstante, en nuestro caso, contar con una red backbone propia permite hacerlo en parte del recorrido de la solicitud, entre el CDN y la nube, y podemos configurarla completamente. Se puede ajustar para priorizar paquetes pequeños y dependientes de la latencia, mientras que los flujos de datos grandes se procesan un poco más tarde. Cuanto más cerca esté el CDN del cliente, mayor será la eficiencia.
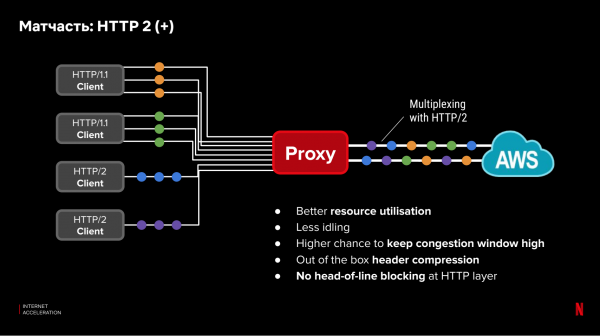
Además, los protocolos de nivel de aplicación (Nivel OSI 7) también influyen en la latencia. Nuevos protocolos como HTTP/2 permiten optimizar el rendimiento de solicitudes paralelas. Sin embargo, tenemos clientes de Netflix con dispositivos antiguos que no soportan nuevos protocolos. No todos los clientes se pueden actualizar o configurar de manera óptima. Al mismo tiempo, entre el proxy CDN y la nube, tenemos control total y la capacidad de utilizar nuevos protocolos y configuraciones óptimas. La parte ineficiente con protocolos antiguos solo actuará entre el cliente y el servidor CDN. Además, podemos hacer multiplexión de solicitudes en una conexión ya establecida entre el CDN y la nube, mejorando la utilización de la conexión a nivel TCP.
Medimos
A pesar de que la teoría promete mejoras, no nos apresuramos a implementar el sistema en producción de inmediato. En su lugar, primero debemos demostrar que la idea funcionará en la práctica. Para ello, necesitamos responder a algunas preguntas:
- Velocidad: ¿será el proxy más rápido?
- Fiabilidad: ¿se romperá con más frecuencia?
- Complejidad: ¿cómo integrar con las aplicaciones?
- Costo: ¿cuánto costará desplegar infraestructura adicional?
Analicemos detenidamente nuestro enfoque para evaluar el primer punto. Los demás se abordan de manera similar.
Para analizar la velocidad de las solicitudes, queremos obtener datos para todos los usuarios, sin gastar mucho tiempo en el desarrollo y sin romper la producción. Existen varios enfoques para esto:
- RUM, o medición pasiva de solicitudes. Medimos el tiempo de ejecución de las solicitudes actuales de los usuarios y garantizamos una cobertura completa de los mismos. La desventaja es que la señal no es muy estable debido a múltiples factores, como los diferentes tamaños de las solicitudes, el tiempo de procesamiento en el servidor y en el cliente. Además, no se puede probar una nueva configuración sin afectar la producción.
- Pruebas de laboratorio. Servidores e infraestructura especiales que simulan clientes. Con ellos realizamos las pruebas necesarias. Así obtenemos un control total sobre los resultados de las mediciones y una señal clara. Sin embargo, no hay cobertura completa de dispositivos y ubicaciones de usuarios (especialmente con un servicio global que admite miles de modelos de dispositivos).
¿Cómo se pueden combinar las ventajas de ambos métodos?
Nuestro equipo encontró una solución. Hemos escrito un pequeño fragmento de código —una prueba— que se integró en nuestra aplicación. Las pruebas nos permiten realizar pruebas de red completamente controladas desde nuestros dispositivos. Funciona de la siguiente manera:
- Poco después de cargar la aplicación y completar la actividad inicial, lanzamos nuestras pruebas.
- El cliente solicita al servidor y recibe una «receta» de prueba. La receta es una lista de URL a las que se debe hacer una solicitud HTTP(s). Además, la receta configura los parámetros de las solicitudes: retrasos entre solicitudes, volumen de datos solicitados, encabezados HTTP(s), etc. Al mismo tiempo, podemos probar varios diferentes recetas en paralelo: al solicitar la configuración, se determina aleatoriamente qué receta se debe entregar.
- El momento de inicio de la prueba se elige de manera que no interfiera con el uso activo de los recursos de red por parte del cliente. Básicamente, se elige un momento en que el cliente no esté activo.
- Después de recibir la receta, el cliente realiza solicitudes a cada una de las URL, en paralelo. La solicitud a cada dirección puede repetirse —los llamados «pulsos»—. En el primer pulso medimos cuánto tiempo se tardó en establecer la conexión y descargar los datos. En el segundo pulso medimos el tiempo de carga de los datos a través de la conexión ya establecida. Antes del tercer pulso, podemos introducir un retraso y medir la velocidad de re-conexión, etc.
Durante la prueba, medimos todos los parámetros que puede obtener el dispositivo:
- el tiempo de la solicitud DNS;
- el tiempo para establecer la conexión TCP;
- el tiempo para establecer la conexión TLS;
- el tiempo para recibir el primer byte de datos;
- el tiempo total de carga;
- el código de estado del resultado.
- Al finalizar todos los pulsos, la muestra carga los resultados de todas las mediciones para el análisis.
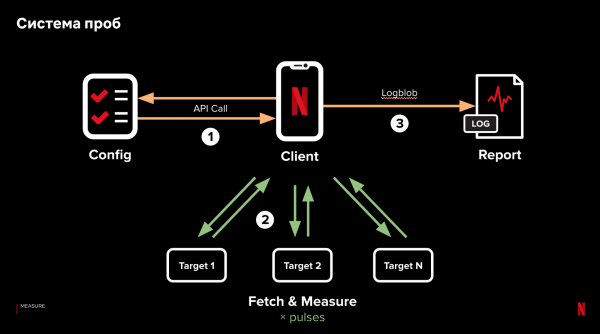
Los puntos clave son la mínima dependencia de la lógica en el cliente, el procesamiento de datos en el servidor y la medición de solicitudes paralelas. De esta manera, tenemos la capacidad de aislar y probar el impacto de diversos factores que afectan el rendimiento de las solicitudes, variándolos dentro de una misma receta, y obteniendo resultados de clientes reales.
Esta infraestructura ha demostrado ser útil no solo para el análisis del rendimiento de las solicitudes. Actualmente tenemos 14 recetas activas, más de 6000 muestras por segundo, obteniendo datos de todos los rincones del mundo y con una cobertura completa de dispositivos. Si Netflix comprara un servicio similar a empresas externas, costaría millones de dólares al año, con una cobertura mucho peor.
Verificamos la teoría en la práctica: prototipo
Con este sistema, hemos podido evaluar la eficiencia del proxy CDN en la latencia de las solicitudes. Ahora necesitamos:
- crear un prototipo de proxy;
- desplegar el prototipo en el CDN;
- determinar cómo dirigir a los clientes al proxy en un servidor CDN específico;
- comparar el rendimiento con las solicitudes en AWS sin proxy.
La tarea es evaluar lo más rápido posible la eficacia de la solución propuesta. Para implementar el prototipo elegimos Go, gracias a la disponibilidad de excelentes bibliotecas de red. En cada servidor CDN instalamos el prototipo del proxy como un binario estático, para minimizar las dependencias y simplificar la integración. En la implementación inicial, utilizamos al máximo los componentes estándar y pequeñas modificaciones para el agrupamiento de conexiones HTTP/2 y multiplexación de solicitudes.
Para equilibrar entre regiones de AWS, utilizamos una base de datos geográfica DNS, la misma que se usa para el balanceo de clientes. Para seleccionar el servidor CDN para el cliente, usamos TCP Anycast para los servidores en Internet Exchange (IX). En este caso, utilizamos una dirección IP para todos los servidores CDN, dirigiendo al cliente al servidor CDN con el menor número de saltos IP. En los servidores CDN situados en los proveedores de internet (ISP), no tenemos control sobre el enrutador para configurar TCP Anycast, por lo que empleamos , por la cual los clientes son dirigidos a los proveedores de internet para la transmisión de video.
Así que tenemos tres tipos de rutas para la solicitud: a la nube a través de Internet abierto, a través de un servidor CDN en IX o a través de un servidor CDN ubicado en el proveedor de internet. Nuestro objetivo es entender qué ruta es mejor y qué beneficios trae el proxy, en comparación con cómo se dirigen las solicitudes en producción. Para ello, usamos un sistema de pruebas de la siguiente manera:
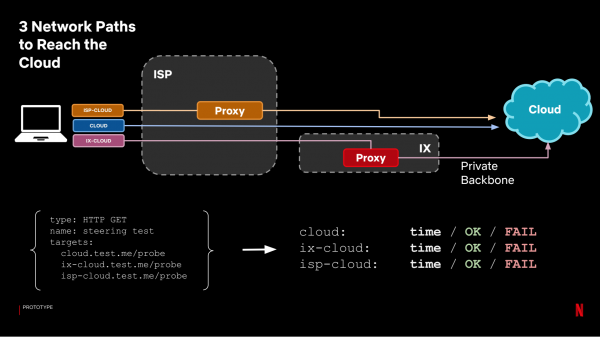
Cada una de las rutas se convierte en un objetivo separado, y observamos el tiempo que hemos obtenido. Para el análisis, combinamos los resultados del proxy en un solo grupo (seleccionamos el mejor tiempo entre el proxy IX y ISP) y comparamos con el tiempo de las solicitudes a la nube sin proxy:
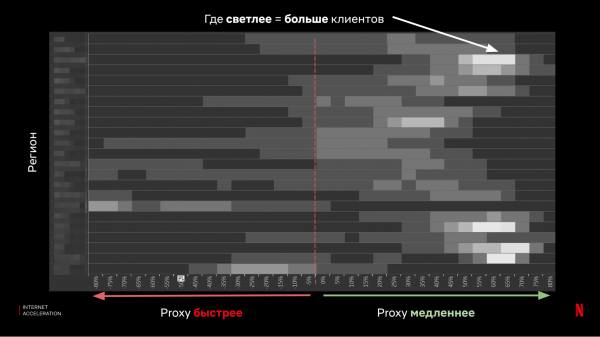
Como se puede ver, los resultados son ambiguos: en la mayoría de los casos, el proxy proporciona una buena aceleración, pero también hay una cantidad suficiente de clientes para los cuales la situación empeorará significativamente.
En resumen, hicimos varias cosas importantes:
- Evaluamos el rendimiento esperado de las solicitudes de los clientes a la nube a través del proxy CDN.
- Recopilamos datos de clientes reales, de todos los tipos de dispositivos.
- Entendimos que la teoría no se confirmó al 100% y que la propuesta inicial de proxy CDN no funcionará para nosotros.
- No arriesgamos: no cambiamos la configuración de producción de los clientes.
- No rompimos nada.
Prototipo 2.0
Así que regresamos a la mesa de dibujo y repetimos el proceso desde el principio.
La idea es que en lugar de un 100% de proxy, para cada cliente determinaremos el camino más rápido y dirigiremos las solicitudes allí; es decir, haremos lo que se llama 'client steering'.
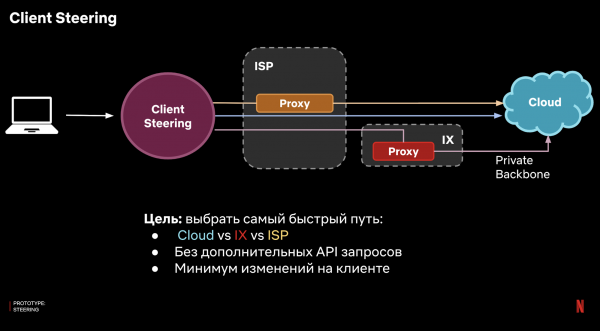
¿Cómo se implementa esto? No podemos utilizar lógica del lado del servidor, ya que el objetivo es conectarse a este servidor. Hay que hacerlo de alguna manera en el cliente. Idealmente, esto debería hacerse con la mínima cantidad de lógica compleja, para no enfrentar problemas de integración con un amplio número de plataformas clientes.
La respuesta es el uso de DNS. En nuestro caso, tenemos nuestra propia infraestructura DNS, y podemos configurar una zona de dominio para la cual nuestros servidores serán autoritativos. Funciona así:
- El cliente realiza una solicitud al servidor DNS utilizando un host, por ejemplo, api.netflix.xom.
- La solicitud llega a nuestro servidor DNS.
- El servidor DNS sabe cuál es el camino más rápido para este cliente y devuelve la dirección IP correspondiente.
En la solución hay una complejidad adicional: los proveedores de DNS autoritativos no ven la dirección IP del cliente y solo pueden considerar la dirección IP del resolver recursivo que utiliza el cliente.
Como resultado, nuestro resolver autoritativo debe tomar decisiones no para un cliente individual, sino para un grupo de clientes basado en el resolver recursivo.
Para resolverlo, utilizamos las mismas pruebas, agregamos los resultados de las mediciones de los clientes desde cada uno de los resolvers recursivos y decidimos a dónde dirigir a este grupo: a través de un proxy por IX utilizando TCP Anycast, a través de un proxy ISP o directamente a la nube.
Obtenemos un sistema de este tipo:
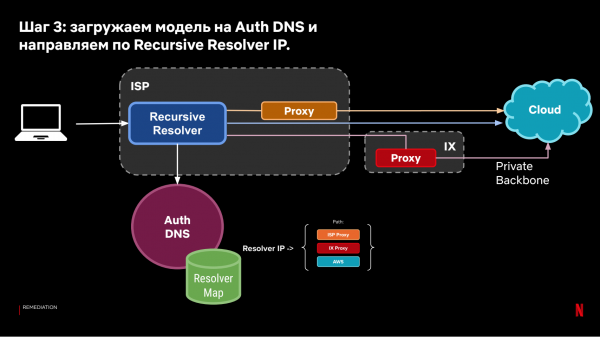
El modelo de DNS steering obtenido permite dirigir a los clientes basado en observaciones históricas sobre la velocidad de las conexiones desde los clientes hacia la nube.
De nuevo, la pregunta es: ¿qué tan efectivo será funcionar de esta manera? Para responder, una vez más utilizamos nuestro sistema de pruebas. Por lo tanto, configuramos una evaluación reciente, donde uno de los objetivos sigue la dirección del DNS steering, mientras que el otro va directamente a la nube (producción actual).
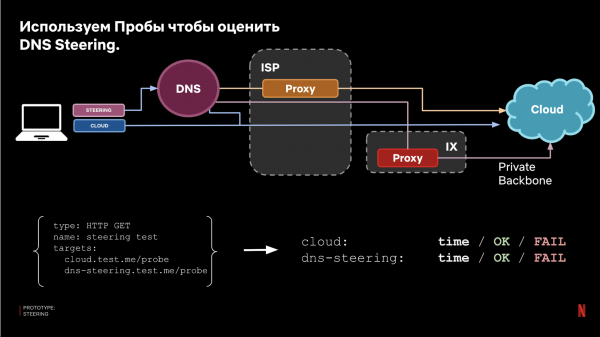
Al final, comparamos los resultados y obtenemos una evaluación de la efectividad:
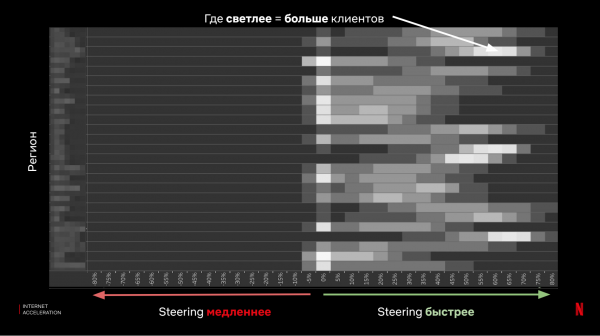
Al final, hemos aprendido varias cosas importantes:
- Hemos evaluado el rendimiento esperado de las solicitudes desde los clientes hacia la nube usando DNS Steering.
- Recopilamos datos de clientes reales, de todos los tipos de dispositivos.
- Hemos demostrado la efectividad de la idea propuesta.
- No arriesgamos: no cambiamos la configuración de producción de los clientes.
- No rompimos nada.
Ahora, lo complicado: lanzamos en producción.
Lo más fácil ya ha pasado: hay un prototipo funcional. Ahora viene la parte complicada: implementar la solución para todo el tráfico de Netflix, desplegarla para 150 millones de usuarios, miles de dispositivos, cientos de microservicios y un producto e infraestructura en constante cambio. Los servidores de Netflix reciben millones de solicitudes por segundo, y es fácil romper el servicio con un error imprudente. Al mismo tiempo, queremos redirigir dinámicamente el tráfico a través de miles de servidores CDN, en un entorno de Internet donde las cosas cambian y se rompen constantemente y en los peores momentos.
Y a pesar de todo esto, en el equipo hay 3 ingenieros responsables del desarrollo, implementación y completo soporte del sistema.
Así que a partir de ahora hablaremos sobre un sueño tranquilo y saludable.
¿Cómo continuar con el desarrollo y no perder todo el tiempo en el soporte? Nuestra estrategia se basa en 3 principios:
- Reducimos el posible alcance de las fallas (blast radius).
- Nos preparamos para sorpresas: esperamos que algo se rompa, a pesar de las pruebas y la experiencia personal.
- Degradación gradual (graceful degradation): si algo no funciona correctamente, debe repararse automáticamente, aunque no de la manera más eficiente.
Resultó que en nuestro caso, con este enfoque al problema, se puede encontrar una solución simple y efectiva y simplificar considerablemente el soporte del sistema. Nos dimos cuenta de que podíamos agregar un pequeño fragmento de código en el cliente y supervisar los errores de las solicitudes de red causados por problemas de conexión. Ante fallas de red, hacemos un fallback directo a la nube. Esta solución no requiere grandes esfuerzos por parte de los equipos de cliente, pero reduce significativamente el riesgo de fallas inesperadas y sorpresas para nosotros.
Por supuesto, a pesar del fallback, seguimos una disciplina clara durante el desarrollo:
- Prueba de muestras.
- Pruebas A/B o Canaries.
- Lanzamiento progresivo (progressive rollout).
Con las pruebas, el enfoque fue descrito: los cambios primero se prueban mediante una receta configurada.
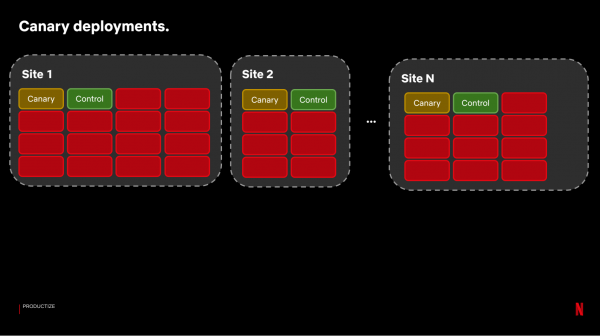
Para las pruebas canary, necesitamos obtener pares de servidores comparables en los que se pueda comparar cómo funciona el sistema antes y después de los cambios. Para esto, de nuestros numerosos sitios CDN, hacemos una selección de pares de servidores que reciben tráfico comparable:
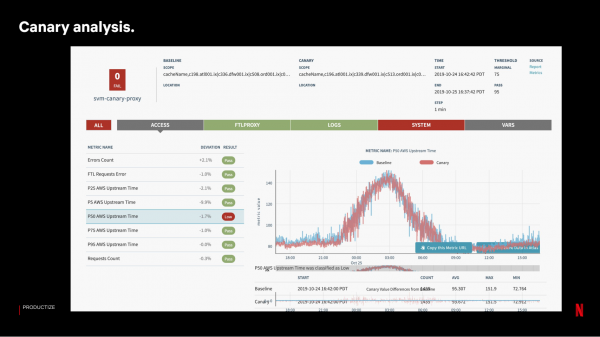
Luego, colocamos la versión con los cambios en los servidores Canary. Para evaluar los resultados, ejecutamos un sistema que compara alrededor de 100-150 métricas tomando como referencia los servidores Control:
Si la prueba en Canary fue exitosa, lanzamos la versión de manera gradual, por oleadas. En cada uno de los sitios no actualizamos los servidores al mismo tiempo; la pérdida de un sitio entero en caso de problemas tiene un impacto más significativo en el servicio para los usuarios que la pérdida de la misma cantidad de servidores, pero en diferentes ubicaciones.
En general, la efectividad y seguridad de este enfoque depende de la cantidad y calidad de las métricas recopiladas. Para nuestro sistema de aceleración de solicitudes, recopilamos métricas de todos los componentes posibles:
- de los clientes: número de sesiones y solicitudes, tasas de retroceso;
- proxy: estadísticas sobre el número y la duración de las solicitudes;
- DNS: cantidad y resultados de las solicitudes;
- nube perimetral: cantidad y tiempo de procesamiento de solicitudes en la nube.
Todo esto se recopila en un pipeline único, y, según las necesidades, decidimos qué métricas enviar a la analítica en tiempo real y cuáles a Elasticsearch o Big Data para un diagnóstico más detallado.
Monitoreo
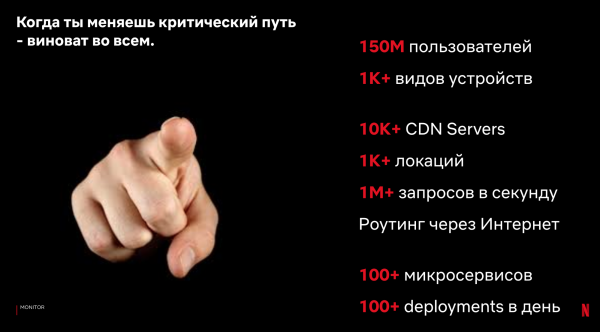
En nuestro caso, realizamos cambios en la ruta crítica de las solicitudes entre el cliente y el servidor. Al mismo tiempo, la cantidad de diversos componentes en el cliente, en el servidor y en el camino a través de internet es enorme. Los cambios en el cliente y el servidor ocurren constantemente, a lo largo del trabajo de decenas de equipos y los cambios naturales en el ecosistema. Estamos en medio; al diagnosticar problemas hay una gran probabilidad de que estemos involucrados. Por lo tanto, necesitamos entender claramente cómo determinar, recopilar y analizar métricas para identificar problemas rápidamente.
Lo ideal es tener acceso completo a todos los tipos de métricas y filtros en tiempo real. Pero hay muchas métricas, por lo que surge la cuestión del costo. En nuestro caso, separamos las métricas y las herramientas de desarrollo de la siguiente manera:
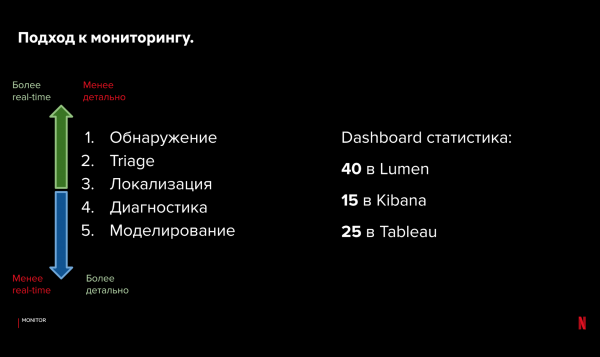
Para detectar y clasificar problemas, utilizamos nuestro propio sistema de código abierto en tiempo real y — para visualización. Este sistema almacena métricas agregadas en memoria, es confiable e integra con el sistema de alertas. Para la localización y diagnóstico, tenemos acceso a los registros de Elasticsearch y Kibana. Para el análisis estadístico y modelado, utilizamos big data y visualización en Tableau.
Parece que es muy difícil trabajar con este enfoque. Sin embargo, con una organización jerárquica de métricas y herramientas, podemos analizar rápidamente el problema, identificar el tipo de problema y luego profundizar en métricas detalladas. Por lo general, tardamos alrededor de 1 a 2 minutos en identificar la fuente del fallo. Después de eso, ya trabajamos con un equipo específico en el diagnóstico, que puede llevar desde decenas de minutos hasta varias horas.
Incluso si el diagnóstico se realiza rápidamente, no queremos que esto suceda con frecuencia. En un escenario ideal, recibiremos una alerta crítica solo cuando haya un impacto significativo en el servicio. Para nuestro sistema de aceleración de solicitudes, tenemos solo 2 alertas que nos notificarán:
- porcentaje de Client Fallback — evaluación del comportamiento de los clientes;
- porcentaje de Probe errors — datos de estabilidad de los componentes de red.
Estas alertas críticas monitorizan si el sistema está funcionando para la mayoría de los usuarios. Observamos cuántos clientes han utilizado el fallback si no pudieron obtener la aceleración de solicitudes. En promedio, tenemos menos de 1 alerta crítica a la semana, aunque se producen un gran número de cambios en el sistema. ¿Por qué es suficiente para nosotros?
- Hay un client fallback en caso de que nuestro proxy no funcione.
- Hay un sistema de steering automático que reacciona ante problemas.
Hablemos más sobre esto. Nuestro sistema de sondas y el sistema de determinación automática de la ruta óptima para las solicitudes del cliente en la nube permiten lidiar automáticamente con algunos problemas.
Regresando a nuestra configuración de sondas y 3 categorías de rutas. Además del tiempo de carga, podemos observar el hecho mismo de la entrega. Si no se pudieron cargar los datos, al observar los resultados de diferentes rutas, podemos determinar dónde y qué falló, y si podemos solucionarlo automáticamente cambiando la ruta de la solicitud.
Ejemplos:
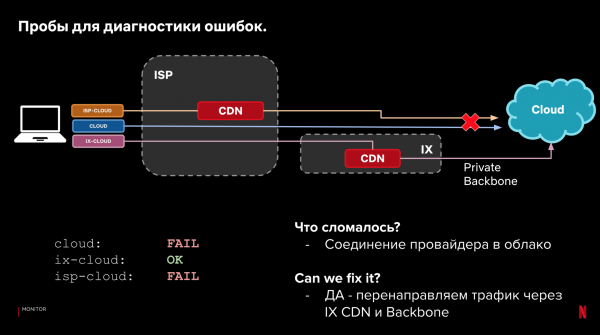
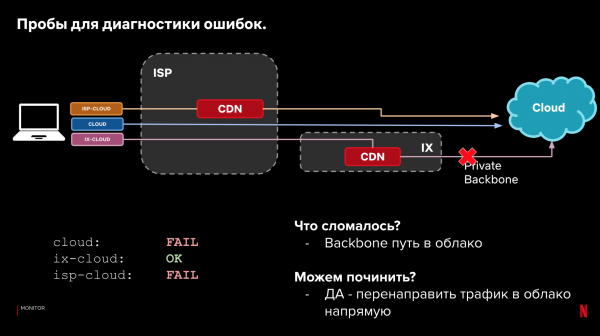
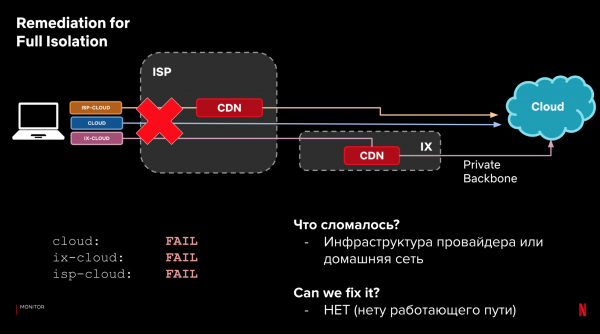
Este proceso se puede automatizar. Incluirlo en el sistema de steering. Y enseñarle a reaccionar ante problemas de rendimiento y fiabilidad. Si algo comienza a fallar, reacciona si hay una mejor opción. Sin embargo, la respuesta instantánea no es crítica, gracias al fallback en los clientes.
Por lo tanto, los principios de mantenimiento del sistema se pueden formular así:
- reducción de la magnitud de las fallas;
- recolección de métricas;
- reparación automática de fallas, si es posible;
- si no es posible, notificamos;
- Estamos trabajando en dashboards y un conjunto de herramientas de triage para una respuesta rápida.
Lecciones aprendidas.
Crear un prototipo no requiere mucho tiempo. En nuestro caso, estuvo listo en solo 4 meses. Con él, obtuvimos nuevas métricas, y después de 10 meses desde el inicio del desarrollo, recibimos el primer tráfico de producción. Luego comenzó el trabajo arduo y complicado: productizar y escalar gradualmente el sistema, migrar el tráfico principal y aprender de los errores. Este proceso eficiente no será lineal: a pesar de todos los esfuerzos, no se puede predecir todo. Es mucho más efectivo: iterar rápidamente y reaccionar ante nuevas informaciones.
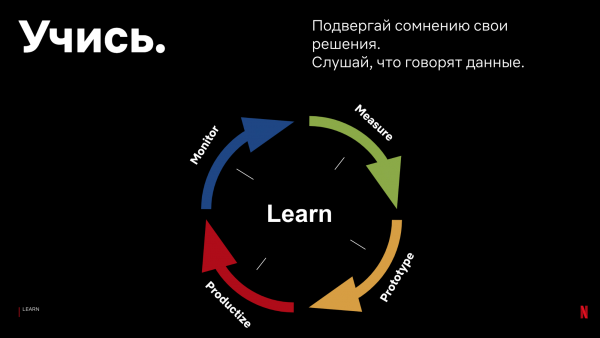
Basándonos en nuestra experiencia, podemos recomendar lo siguiente:
- No confíes en la intuición.
Nuestra intuición nos fallaba constantemente, a pesar de la gran experiencia de los miembros del equipo. Por ejemplo, predecíamos incorrectamente la aceleración esperada al usar proxies CDN, o el comportamiento de TCP Anycast.
- Obtén datos de producción.
Es importante obtener acceso lo antes posible, aunque sea a una pequeña cantidad de datos de producción. Es prácticamente imposible obtener el número único de casos, configuraciones y ajustes en condiciones de laboratorio. Tener acceso rápido a los resultados permitirá conocer más rápidamente sobre problemas potenciales y tenerlos en cuenta en la arquitectura del sistema.
- No sigas los consejos y resultados de otros; recopila tus propios datos.
Sigue los principios de recopilación y análisis de datos, pero no tomes ciegamente los resultados y afirmaciones de otros. Solo tú puedes saber exactamente lo que funciona para tus usuarios. Tus sistemas y tus clientes pueden diferir significativamente de los de otras empresas. Afortunadamente, las herramientas de análisis son ahora accesibles y fáciles de usar. Los resultados que obtengas pueden no coincidir con lo que afirman Netflix, Facebook, Akamai y otras empresas. En nuestro caso, el rendimiento de TLS, HTTP2 o estadísticas sobre consultas DNS difieren de los resultados de Facebook, Uber, Akamai, porque tenemos otros dispositivos, clientes y flujos de datos.
- No persigas modas sin necesidad y sin evaluar su eficacia.
Comienza con lo simple. Es mejor crear un sistema básico funcional en poco tiempo que gastar una gran cantidad de tiempo desarrollando componentes que no necesitas. Resuelve tareas y problemas que son importantes basándote en tus mediciones y resultados.
- Prepárese para nuevas aplicaciones.
Al igual que es difícil prever todos los problemas, también lo es anticipar los beneficios y aplicaciones. Mire el ejemplo de las startups: su capacidad para adaptarse a las condiciones del cliente. En su caso, puede descubrir nuevos problemas y sus soluciones. En nuestro proyecto, nos propusimos reducir la latencia de las solicitudes. Sin embargo, durante el análisis y las discusiones, nos dimos cuenta de que también podemos aplicar servidores proxy:
- para equilibrar el tráfico entre regiones de AWS y reducir costos;
- para modelar la estabilidad de la CDN;
- para configurar el DNS;
- para configurar TLS/TCP.
Conclusión
En el informe, describí cómo Netflix aborda el desafío de acelerar las solicitudes de internet entre clientes y la nube. Cómo recopilamos datos usando un sistema de muestreo en los clientes y utilizamos los datos históricos recopilados para dirigir las solicitudes de producción desde los clientes a través del camino más rápido en internet. Cómo utilizamos los principios de los protocolos de red, nuestra infraestructura de CDN, la red backbone y los servidores DNS para lograr este objetivo.
Sin embargo, nuestra solución es tan solo un ejemplo de cómo hemos implementado un sistema así en Netflix. Lo que funcionó para nosotros. La parte práctica de mi informe para ustedes son los principios de desarrollo y soporte que seguimos para lograr buenos resultados.
Nuestra solución al problema puede no ser adecuada para ustedes. Sin embargo, la teoría y los principios de desarrollo permanecen, incluso si no tienen su propia infraestructura de CDN, o si es significativamente diferente de la nuestra.
También sigue siendo importante la velocidad de las solicitudes para el negocio. Y incluso para un servicio sencillo es necesario tomar decisiones: entre proveedores 'cloud', la ubicación de los servidores, la CDN y los proveedores de DNS. Su elección afectará la eficiencia de las solicitudes de internet para sus clientes. Y es importante medir y comprender esa influencia.
Comience con soluciones simples, preocúpese por cómo modifica el producto. Aprenda en el proceso y mejore el sistema basado en los datos de sus clientes, su infraestructura y su negocio. Piense en la posibilidad de fallos inesperados durante el diseño. Y así podrá acelerar su proceso de desarrollo, mejorar la eficiencia de la solución, evitar una carga excesiva en el soporte y dormir tranquilo.
Este año en formato online. ¡Podrás hacer preguntas a uno de los padres de DevOps, el mismo John Willis!
Fuente: habr.com
