

En este artículo, les explicaré cómo configurar un entorno para aprendizaje automático en 30 minutos, crear una red neuronal para el reconocimiento de imágenes y después ejecutar esa misma red en una unidad de procesamiento gráfico (GPU).
Para comenzar, definamos qué es una red neuronal.
En nuestro caso, es un modelo matemático, así como su implementación programática o de hardware, construido según el principio de organización y funcionamiento de las redes neuronales biológicas: redes de células nerviosas de un organismo vivo. Este concepto surgió al estudiar los procesos que ocurren en el cerebro y al intentar modelar dichos procesos.
Las redes neuronales no se programan en el sentido tradicional de la palabra, se entrenan. La capacidad de aprendizaje es una de las principales ventajas de las redes neuronales sobre los algoritmos tradicionales. Técnicamente, el aprendizaje consiste en encontrar los coeficientes de las conexiones entre neuronas. Durante el proceso de aprendizaje, la red neuronal puede identificar relaciones complejas entre los datos de entrada y salida, así como realizar generalizaciones.
Desde la perspectiva del aprendizaje automático, una red neuronal es un caso particular de métodos de reconocimiento de patrones, análisis discriminante, métodos de clustering y otros métodos.
Hardware
Primero, aclaremos el hardware. Necesitamos un servidor con un sistema operativo Linux instalado. El hardware necesario para trabajar con sistemas de aprendizaje automático debe ser bastante potente y, como consecuencia, costoso. Aquellos que no tienen una buena máquina a mano, les recomiendo considerar la oferta de los proveedores de la nube. Se puede rentar rápidamente el servidor necesario y pagar solo por el tiempo de uso.
En proyectos donde es necesario crear redes neuronales, utilizo servidores de uno de los proveedores de nube rusos. La empresa ofrece servidores en la nube específicamente para aprendizaje automático con potentes unidades de procesamiento gráfico (GPU) Tesla V100 de NVIDIA. En resumen: el uso de un servidor con GPU puede ser decenas de veces más eficiente (rápido) en comparación con un servidor similar en costo que utiliza CPU (el conocido procesador central). Esto se logra gracias a las características de la arquitectura de la GPU, que maneja los cálculos más rápidamente.
Para realizar los ejemplos que se describen a continuación, adquirimos un servidor por unos días:
- Disco SSD de 150 GB
- RAM de 32 GB
- Procesador Tesla V100 de 16 Gb con 4 núcleos
En la máquina instalamos Ubuntu 18.04.
Instalamos el entorno
Ahora instalaremos en el servidor todo lo necesario para trabajar. Dado que nuestro artículo está dirigido principalmente a principiantes, comentaré algunos aspectos que serán útiles especialmente para ellos.
Gran parte del trabajo al configurar el entorno se realiza a través de la línea de comandos. La mayoría de los usuarios utilizan Windows como sistema operativo. La consola estándar en este sistema deja mucho que desear. Por lo tanto, utilizaremos una herramienta conveniente . Descargamos la versión mini y ejecutamos Cmder.exe. Luego necesitamos conectarnos al servidor mediante el protocolo SSH:
ssh root@server-ip-or-hostnameEn lugar de server-ip-or-hostname, indique la dirección IP o el nombre DNS de su servidor. Luego ingrese la contraseña y, al conectarse exitosamente, deberíamos recibir un mensaje similar a este.
Welcome to Ubuntu 18.04.3 LTS (GNU/Linux 4.15.0-74-generic x86_64)El principal lenguaje para desarrollar modelos de ML es Python. Y la plataforma más popular para su uso en Linux es .
La instalaremos en nuestro servidor.
Comenzamos actualizando el administrador de paquetes local:
sudo apt-get updateInstalamos curl (una herramienta de línea de comandos):
sudo apt-get install curlDescargamos la última versión de Anaconda Distribution:
cd /tmp
curl –O https://repo.anaconda.com/archive/Anaconda3-2019.10-Linux-x86_64.sh
Iniciamos la instalación:
bash Anaconda3-2019.10-Linux-x86_64.shDurante la instalación, se le pedirá que confirme el acuerdo de licencia. Al finalizar la instalación, debería ver esto:
Thank you for installing Anaconda3!Se han creado muchos frameworks para desarrollar modelos de ML, trabajamos con los más populares: y .
El uso de un framework permite acelerar el desarrollo y utilizar herramientas ya preparadas para tareas estándar.
En este ejemplo trabajaremos con PyTorch. Lo instalaremos:
conda install pytorch torchvision cudatoolkit=10.1 -c pytorchAhora necesitamos ejecutar Jupyter Notebook, una herramienta de desarrollo popular entre los especialistas en ML. Permite escribir código y ver los resultados de su ejecución de inmediato. Jupyter Notebook está incluido en Anaconda y ya está instalado en nuestro servidor. Es necesario conectarse a él desde nuestro sistema de escritorio.
Para ello, primero ejecutaremos Jupyter en el servidor especificando el puerto 8080:
jupyter notebook --no-browser --port=8080 --allow-rootLuego, abriendo otra pestaña en nuestra consola Cmder (menú superior — Diálogo nueva consola) nos conectaremos al servidor a través del puerto 8080 usando SSH:
ssh -L 8080:localhost:8080 root@server-ip-or-hostnameAl ingresar el primer comando, se nos ofrecerán enlaces para abrir Jupyter en nuestro navegador:
Para acceder al notebook, abre este archivo en un navegador:
        file:///root/.local/share/jupyter/runtime/nbserver-18788-open.html
    O copia y pega una de estas URL:
        http://localhost:8080/?token=cca0bd0b30857821194b9018a5394a4ed2322236f116d311
     o http://127.0.0.1:8080/?token=cca0bd0b30857821194b9018a5394a4ed2322236f116d311
Usaremos el enlace para localhost:8080. Copie la ruta completa y péguela en la barra de direcciones de su navegador local. Se abrirá Jupyter Notebook.
Crearemos un nuevo notebook: Nuevo — Notebook — Python 3.
Verificaremos el correcto funcionamiento de todos los componentes que hemos instalado. Ingresaremos un ejemplo de código de PyTorch en Jupyter y ejecutaremos (botón Ejecutar):
from __future__ import print_function
import torch
x = torch.rand(5, 3)
print(x)
El resultado debería ser aproximadamente así:
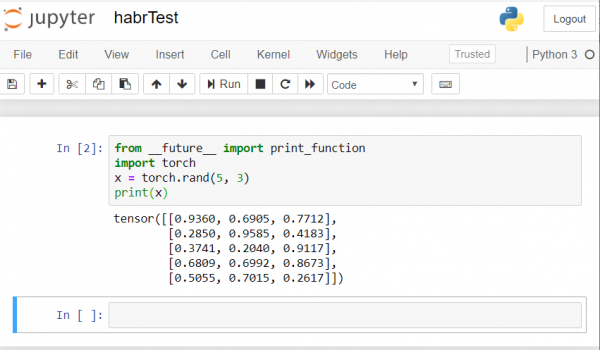
Si tienes un resultado similar, significa que hemos configurado todo correctamente y podemos comenzar a desarrollar la red neuronal.
Creamos una red neuronal
Vamos a crear una red neuronal para el reconocimiento de imágenes. Tomaremos como base la siguiente .
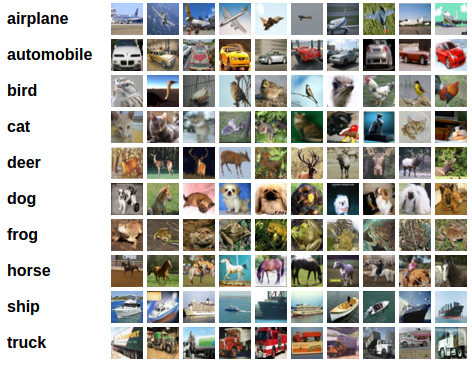
Para entrenar la red, utilizaremos el conjunto de datos de acceso público CIFAR10. Tiene clases: 'avión', 'automóvil', 'pájaro', 'gato', 'ciervo', 'perro', 'rana', 'caballo', 'barco', 'camión'. Las imágenes en CIFAR10 tienen un tamaño de 3x32x32, es decir, imágenes en color de 3 canales de tamaño 32×32 píxeles.
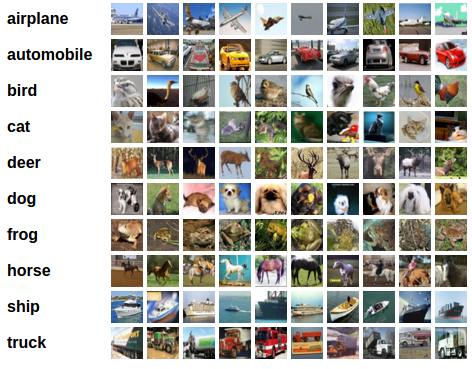
Para trabajar, utilizaremos el paquete de PyTorch creado para trabajar con imágenes: torchvision.
Haremos los siguientes pasos en orden:
- Cargar y normalizar los conjuntos de datos de entrenamiento y prueba
- Definir la red neuronal
- Entrenar la red con los datos de entrenamiento
- Probar la red con los datos de prueba
- Repetir el entrenamiento y la prueba utilizando GPU
Todo el código a continuación lo ejecutaremos en Jupyter Notebook.
Carga y normalización de CIFAR10
Copia y ejecuta en Jupyter el siguiente código:
import torch
import torchvision
import torchvision.transforms as transforms

transform = transforms.Compose(
    [transforms.ToTensor(),
     transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

trainset = torchvision.datasets.CIFAR10(root='./data', train=True,
                                        download=True, transform=transform)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=4,
                                          shuffle=True, num_workers=2)

testset = torchvision.datasets.CIFAR10(root='./data', train=False,
                                       download=True, transform=transform)
testloader = torch.utils.data.DataLoader(testset, batch_size=4,
                                         shuffle=False, num_workers=2)

classes = ('avión', 'automóvil', 'pájaro', 'gato',
           'ciervo', 'perro', 'rana', 'caballo', 'barco', 'camión')
La respuesta debe ser así:
Descargando https://www.cs.toronto.edu/~kriz/cifar-10-python.tar.gz a ./data/cifar-10-python.tar.gz
Extrayendo ./data/cifar-10-python.tar.gz a ./data
Archivos ya descargados y verificados
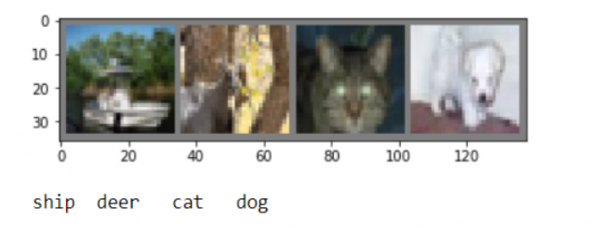
Mostraremos algunas imágenes de entrenamiento para verificar:
import matplotlib.pyplot as plt
import numpy as np

# funciones para mostrar una imagen

def imshow(img):
    img = img / 2 + 0.5     # desnormalizar
    npimg = img.numpy()
    plt.imshow(np.transpose(npimg, (1, 2, 0)))
    plt.show()

# obtener algunas imágenes aleatorias de entrenamiento
dataiter = iter(trainloader)
images, labels = dataiter.next()

# mostrar imágenes
imshow(torchvision.utils.make_grid(images))
# imprimir etiquetas
print(' '.join('%5s' % classes[labels[j]] for j in range(4)))
Definir la red neuronal
Primero, consideremos cómo funciona la red neuronal para el reconocimiento de imágenes. Es una red simple de conexión directa. Toma datos de entrada, los pasa a través de varias capas una tras otra y, finalmente, produce la salida.
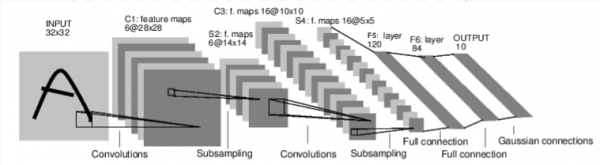
Creamos una red similar en nuestro entorno:
import torch.nn as nn
import torch.nn.functional as F

class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(3, 6, 5)
        self.pool = nn.MaxPool2d(2, 2)
        self.conv2 = nn.Conv2d(6, 16, 5)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        x = self.pool(F.relu(self.conv1(x)))
        x = self.pool(F.relu(self.conv2(x)))
        x = x.view(-1, 16 * 5 * 5)
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return x

net = Net()
También definiremos la función de pérdida y el optimizador
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
Entrenar la red con los datos de entrenamiento
Comenzamos el entrenamiento de nuestra red neuronal. Cabe destacar que después de ejecutar este código, habrá que esperar un tiempo hasta que termine de ejecutarse. A mí me tomó 5 minutos. Entrenar la red requiere tiempo.
 por época en rango(2): # recorrer el conjunto de datos varias veces

 pérdida_corriente = 0.0
 para i, datos en enumerar(trainloader, 0):
 # obtener las entradas; los datos son una lista de [entradas, etiquetas]
 entradas, etiquetas = datos

 # poner a cero los gradientes de los parámetros
 optimizador.cero_grad()

 # adelante + atrás + optimizar
 salidas = red(entradas)
 pérdida = criterio(salidas, etiquetas)
 pérdida.backward()
 optimizador.step()

 # imprimir estadísticas
 pérdida_corriente += pérdida.item()
 si i % 2000 == 1999: # imprimir cada 2000 mini-batches
 print('[%d, ] pérdida: %.3f' %
 (época + 1, i + 1, pérdida_corriente / 2000))
 pérdida_corriente = 0.0

print('Entrenamiento terminado')
Obtendremos el siguiente resultado:
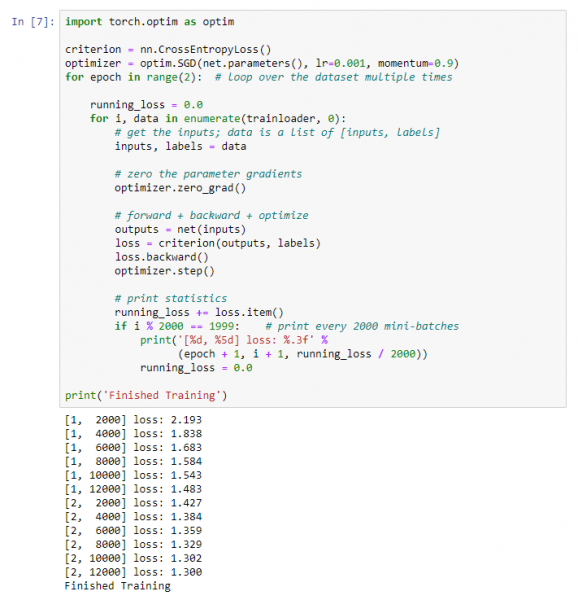
Guardamos nuestro modelo entrenado:
RUTA = './cifar_net.pth'
torch.save(red.state_dict(), RUTA)
Probar la red con los datos de prueba
Hemos entrenado la red utilizando un conjunto de datos de entrenamiento. Pero necesitamos comprobar si la red ha aprendido algo.
Lo comprobaré predecir la etiqueta de clase que la red neuronal presenta y verificar su veracidad. Si la predicción es correcta, añadimos la muestra a la lista de predicciones correctas.
Mostremos una imagen del conjunto de prueba:
iterador_datos = iter(testloader)
imágenes, etiquetas = iterador_datos.siguiente()

# imprimir imágenes
mostrar(torchvision.utils.make_grid(imágenes))
print('VerdadTerreno: ', ' '.join('%5s' % clases[etiquetas[j]] para j en rango(4))) 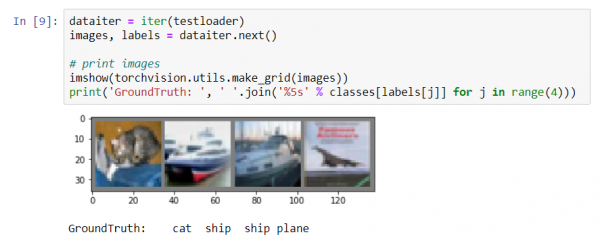
Ahora le pediremos a la red neuronal que nos diga qué hay en estas imágenes:
red = Red()
red.load_state_dict(torch.load(RUTA))

salidas = red(imágenes)

_, predicho = torch.max(salidas, 1)

print('Predicciones: ', ' '.join('%5s' % clases[predicho[j]]
                              para j en rango(4)))
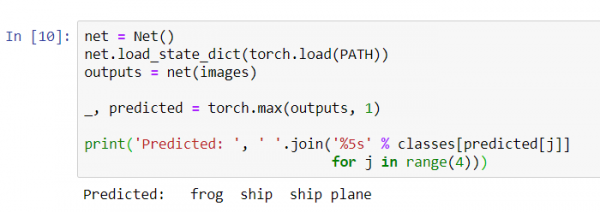
Los resultados parecen bastante buenos: la red identificó correctamente tres imágenes de cuatro.
Veamos cómo funciona la red en todo el conjunto de datos.
correcto = 0
total = 0
con torch.no_grad():
    para datos en testloader:
        imágenes, etiquetas = datos
        salidas = red(imágenes)
        _, predicho = torch.max(salidas.data, 1)
        total += etiquetas.size(0)
        correcto += (predicho == etiquetas).suma().item()

print('Precisión de la red en las 10000 imágenes de prueba: %d %%' % (
100 * correcto / total)) 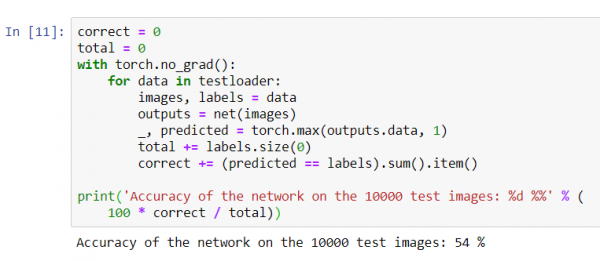
Parece que la red sabe algo y funciona. Si estuviera clasificando las clases al azar, la precisión sería del 10%.
Ahora veamos qué clases identifica mejor la red:
clase_correcta = lista(0. para i en rango(10))
clase_total = lista(0. para i en rango(10))
con torch.no_grad():
 para datos en testloader:
 imágenes, etiquetas = datos
 salidas = red(imágenes)
 _, predicho = torch.max(salidas, 1)
 c = (predicho == etiquetas).squeeze()
 para i en rango(4):
 etiqueta = etiquetas[i]
 clase_correcta[etiqueta] += c[i].item()
 clase_total[etiqueta] += 1


para i en rango(10):
 print('Precisión de %5s : %%' % (
clases[i], 100 * clase_correcta[i] / clase_total[i])) 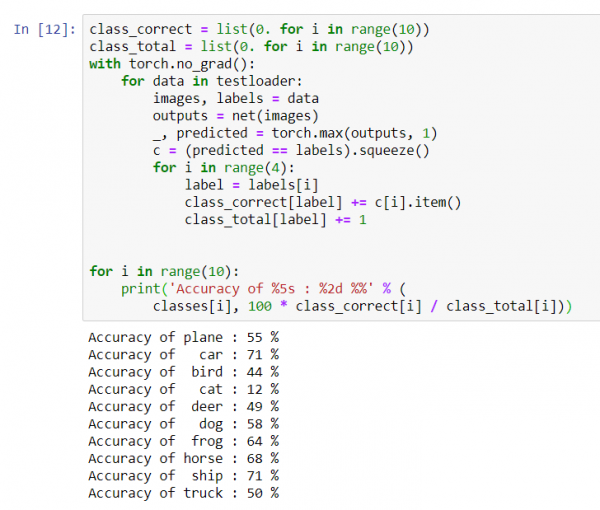
Parece que la red identifica mejor los automóviles y barcos: 71% de precisión.
Así que la red funciona. Ahora intentemos transferir su operación a la unidad de procesamiento gráfico (GPU) y veamos qué cambia.
Entrenamiento de la red neuronal en GPU
Primero explicaré brevemente qué es CUDA. CUDA (Compute Unified Device Architecture) es una plataforma de computación paralela diseñada por NVIDIA para cálculos generales en unidades de procesamiento gráfico (GPU). Con CUDA, los desarrolladores pueden acelerar significativamente las aplicaciones de computación aprovechando las capacidades de las GPU. En nuestro servidor que adquirimos, esta plataforma ya está instalada.
Primero, definamos nuestra GPU como el primer dispositivo visible de CUDA.
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
# Suponiendo que estamos en una máquina CUDA, esto debería imprimir un dispositivo CUDA:
print(device) 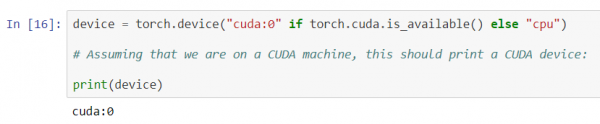
Enviamos la red a la GPU:
net.to(device)También tendremos que enviar las entradas y los objetivos en cada paso a la GPU:
inputs, labels = data[0].to(device), data[1].to(device)Iniciaremos el reentrenamiento de la red ya en la GPU:
importar torch.optim como optim

criterio = nn.CrossEntropyLoss()
optimizador = optim.SGD(red.parameters(), lr=0.001, momentum=0.9)
por época en rango(2): # recorrer el conjunto de datos varias veces

 pérdida_corriente = 0.0
 para i, datos en enumerar(trainloader, 0):
 # obtener las entradas; los datos son una lista de [entradas, etiquetas]
 entradas, etiquetas = datos[0].to(dispositivo), datos[1].to(dispositivo)

 # poner a cero los gradientes de los parámetros
 optimizador.cero_grad()

 # adelante + atrás + optimizar
 salidas = red(entradas)
 pérdida = criterio(salidas, etiquetas)
 pérdida.backward()
 optimizador.step()

 # imprimir estadísticas
 pérdida_corriente += pérdida.item()
 si i % 2000 == 1999: # imprimir cada 2000 mini-batches
 print('[%d, ] pérdida: %.3f' %
 (época + 1, i + 1, pérdida_corriente / 2000))
 pérdida_corriente = 0.0

print('Entrenamiento terminado')
En esta ocasión, el entrenamiento de la red duró aproximadamente 3 minutos. Recordemos que la misma etapa en un procesador convencional tardó 5 minutos. La diferencia no es significativa, esto sucede porque nuestra red no es tan grande. Con conjuntos de datos más grandes, la diferencia entre la velocidad de la GPU y la del procesador tradicional aumentará.
Esto parece ser todo. Lo que hemos logrado hacer:
- Hemos revisado qué es una GPU y seleccionamos un servidor donde está instalada;
- Configuramos el entorno de programación para crear una red neuronal;
- Creamos una red neuronal para el reconocimiento de imágenes y la entrenamos;
- Reentrenamos la red utilizando la GPU y obtuvimos un aumento en la velocidad.
Estaré encantado de responder a sus preguntas en los comentarios.
Fuente: habr.com
