

VictoriaMetrics: una base de datos rápida y escalable para el almacenamiento y procesamiento de datos en forma de series temporales (una entrada consiste en un tiempo y un conjunto de valores correspondientes a ese tiempo, por ejemplo, obtenidos a través de la supervisión periódica del estado de los sensores o la recolección de métricas).
Me llamo Pavel Kolobayev. DevOps, SRE, LeroyMerlin, todo como código - esto es de lo que se trata: de mí y de otros empleados de LeroyMerlin.
Hay un nube basada en OpenStack. Aquí hay un pequeño enlace al radar tecnológico.
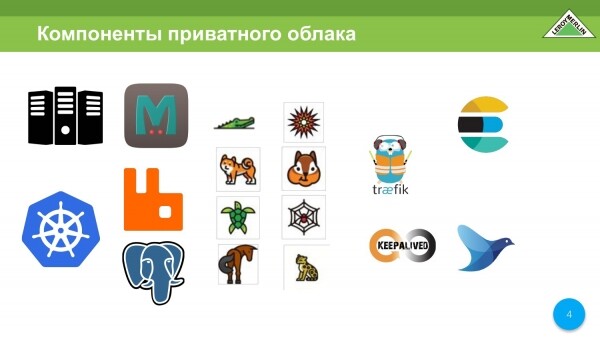
Está construido sobre hardware de Kubernetes, así como en todos los servicios asociados a OpenStack y registro.
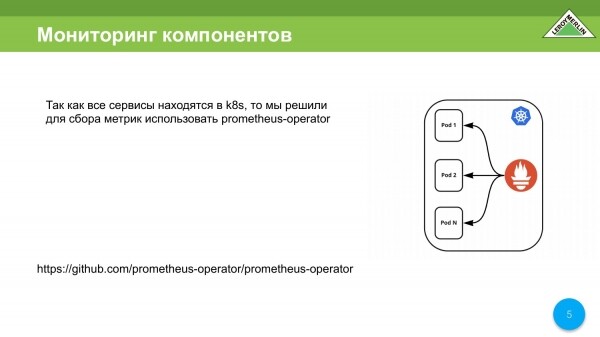
El esquema que teníamos durante el desarrollo era el siguiente. Cuando desarrollábamos todo esto, teníamos un operador Prometheus que almacenaba datos dentro del propio clúster de K8s. Automáticamente encuentra lo que necesita ser rastreado y lo almacena, por así decirlo.
Todos los datos deben ser extraídos del clúster de Kubernetes, porque si algo sucede, debemos entender qué y dónde.
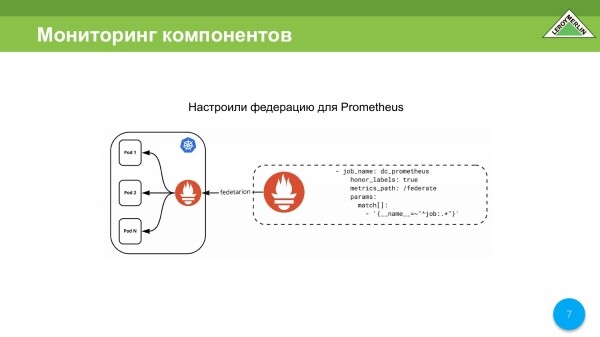
La primera solución es que utilizamos federation, cuando tenemos un Prometheus externo, al que accedemos al clúster de Kubernetes a través del mecanismo de federation.
Pero aquí surgen pequeños problemas. En nuestro caso, los problemas comenzaron cuando teníamos 250,000 métricas, y cuando llegamos a 400,000 métricas, nos dimos cuenta de que no podíamos trabajar así. Aumentamos el scrape_timeout a 25 segundos.
¿Por qué tuvimos que hacer esto? Prometheus comienza a contar el tiempo de espera desde el inicio de la recolección. Y no importa que los datos todavía se estén transmitiendo. Si en ese intervalo de tiempo especificado no se han transmitido datos y la sesión no se ha cerrado por http, se considera que la sesión falló y los datos no llegan a Prometheus.
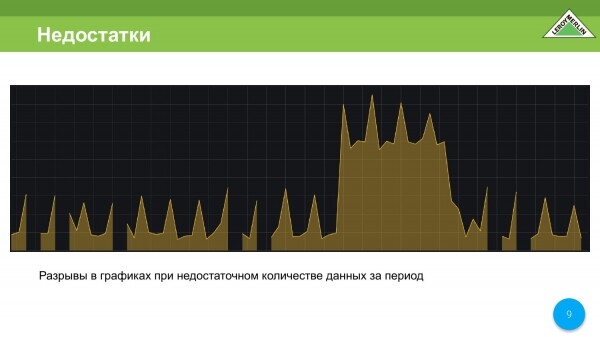
Todos conocen las gráficas que obtenemos cuando faltan algunos datos. Las gráficas están rotas y eso no nos satisface.
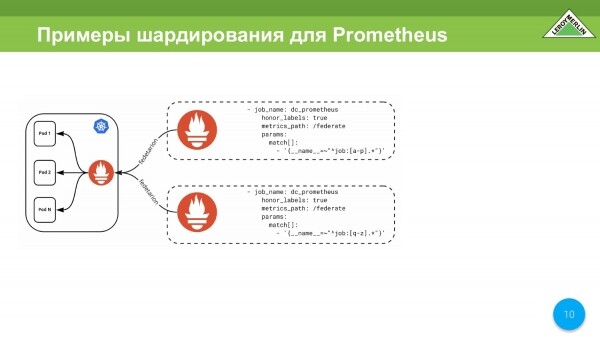
La siguiente opción es el sharding basado en dos Prometheus diferentes a través del mismo mecanismo de federation.
Por ejemplo, simplemente tomar y hacer sharding por nombre. Esto también se puede usar, pero decidimos avanzar más.
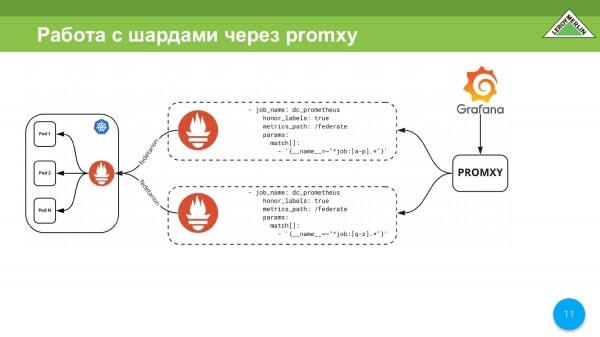
Ahora tendremos que procesar estos shards de alguna manera. Se puede utilizar promxy, que accede al área del shard, multiplica los datos. Funciona con dos shards como un único punto de entrada. Esto se puede implementar a través de promxy, pero por ahora es demasiado complicado.
La primera opción es que queremos deshacernos del mecanismo de federation, porque es muy lento.
Los desarrolladores de Prometheus dicen claramente: «Chicos, usen otras TimescaleDB, porque no vamos a soportar un almacenamiento prolongado de métricas». No es su tarea. 
Anotamos en papel que necesitamos una exportación externa para no almacenar todo en un solo lugar.
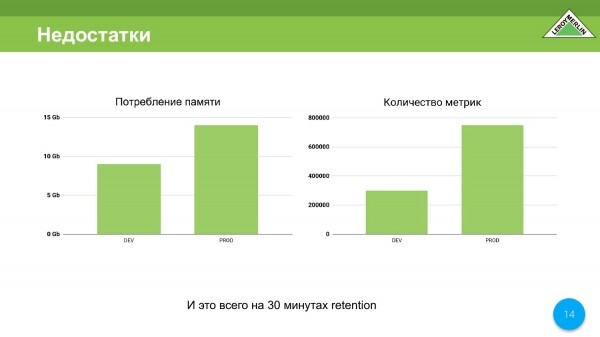
El segundo inconveniente es el consumo de memoria. Sí, entiendo que muchos dirán que en 2020 un par de gigabytes de memoria es barato, pero aun así.
Ahora tenemos un entorno de desarrollo y producción. En desarrollo, ocupamos alrededor de 9 gigabytes para 350,000 métricas. En producción, son 14 gigabytes con un poco más para 780,000 métricas. Además, nuestro tiempo de retención es de solo 30 minutos. Eso es un problema, y voy a explicar por qué.
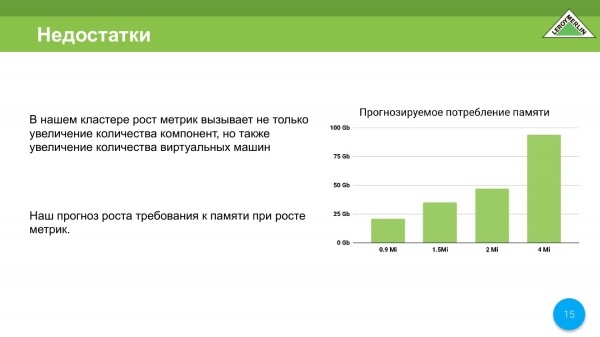
Hacemos un cálculo, es decir, con un millón y medio de métricas, que ya estamos alcanzando, en la etapa de diseño obtenemos 35-37 gigabytes de memoria. Pero ya para 4 millones de métricas se necesitan alrededor de 90 gigabytes de memoria. Es decir, esto fue calculado según la fórmula que proporcionan los desarrolladores de Prometheus. Observamos la correlación y entendimos que no queremos pagar un par de millones por un servidor solo para monitorear.
No solo aumentará la cantidad de máquinas, sino que también monitoreamos las propias máquinas virtuales. Por lo tanto, cuanto más virtuales sean las máquinas, más métricas de diferentes tipos habrá, etc. Tendremos un crecimiento especial de nuestro clúster en términos de métricas.
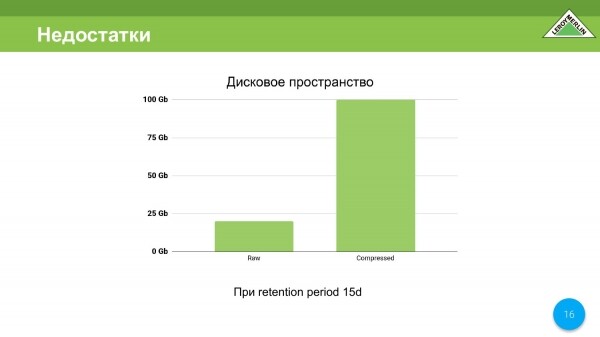
En cuanto al espacio en disco, aquí no está tan mal, pero nos gustaría mejorarlo. En 15 días, hemos acumulado 120 gigabytes, de los cuales 100 son datos comprimidos y 20 son datos sin comprimir, pero siempre queremos menos.
Por lo tanto, anotamos otro punto: es un alto consumo de recursos, que queremos seguir economizando, porque no queremos que nuestro clúster de monitoreo consuma más recursos que nuestro clúster que gestiona OpenStack.
Hay otro inconveniente con Prometheus que hemos identificado: hay alguna limitación en la memoria. Con Prometheus es mucho peor, porque no tiene tales configuraciones. Usar limitaciones en Docker tampoco es una opción. Si su RAF falla y hay 20-30 gigabytes, tardará mucho en levantarse.
Esta es otra razón por la que Prometheus no nos sirve, es decir, no se puede limitar el consumo de memoria.
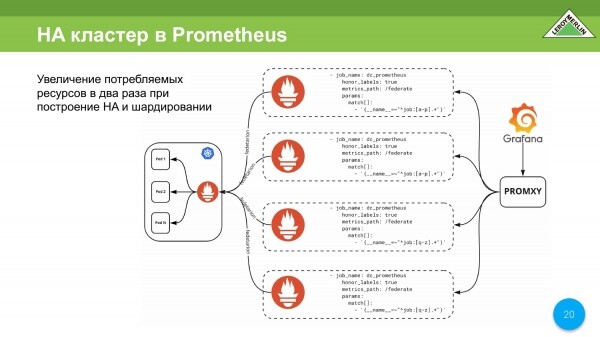
Se podría llegar a un esquema así. Este esquema lo necesitamos para organizar un clúster HA. Queremos que nuestras métricas estén disponibles siempre y en cualquier lugar, incluso en caso de caída del servidor que almacena estas métricas. Por lo tanto, tendremos que construir un esquema así.
Este esquema indica que tendremos duplicación de shards y, por ende, duplicación de los recursos consumidos. Se puede escalar horizontalmente casi, pero aún así el consumo de recursos será enorme.
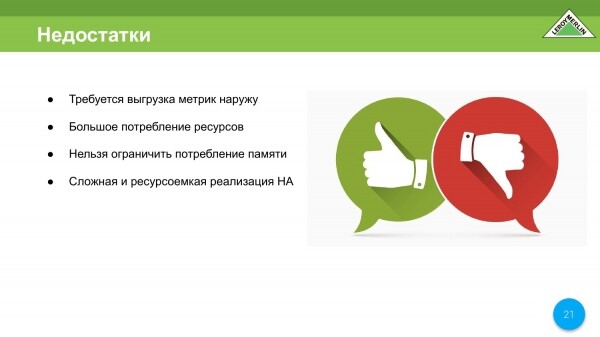
Los inconvenientes en el orden que los hemos enumerado son:
- Es necesario exportar métricas hacia el exterior.
- Alto consumo de recursos.
- No se puede limitar el consumo de memoria.
- Implementación de HA complicada y que consume muchos recursos.
Hemos decidido abandonar Prometheus como solución de almacenamiento.
Hemos identificado algunos requisitos adicionales que necesitamos. Son:
- Soporte para promql, ya que hay muchas cosas escritas para Prometheus: consultas, alertas.
- Y luego tenemos Grafana, que también está escrita para Prometheus como backend. No queremos reescribir los paneles.
- Queremos construir una arquitectura HA adecuada.
- Queremos reducir el consumo de cualquier recurso.
- Hay un pequeño matiz. No podemos utilizar varios tipos de sistemas de recolección de métricas en la nube. No sabemos qué se perderá en estas métricas por el momento. Y dado que puede ir cualquier cosa, tenemos que limitarnos a una implementación local.
La elección fue pequeña. Recopilamos todo lo que teníamos experiencia. Miramos la página de Prometheus en la sección de integración, leímos un montón de artículos, observamos qué hay en general. Y para nosotros elegimos VictoriaMetrics como reemplazo de Prometheus.
¿Por qué? Porque:
- Soporta promql.
- Tiene una arquitectura modular.
- No requiere cambios en Grafana.
- Y lo más importante, tal vez proporcionemos almacenamiento de métricas dentro de nuestra empresa como un servicio, por lo que miramos de antemano hacia limitaciones de varios tipos, para que los usuarios puedan usar todos los recursos del clúster de alguna manera limitada, ya que hay una posibilidad de que sea multitenancy.
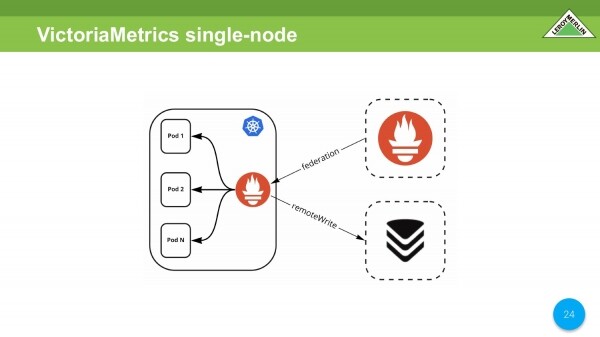
Hacemos la primera comparación. Tomamos el mismo Prometheus dentro del clúster, y va a un Prometheus externo. Agregamos a través de remoteWrite VictoriaMetrics.
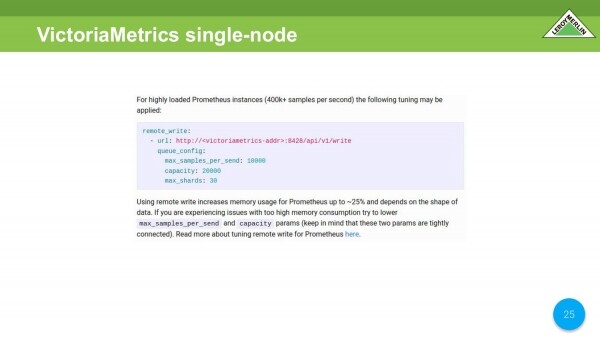
De inmediato aclaro que aquí hemos observado un pequeño aumento en el consumo de CPU por parte de VictoriaMetrics. En la wiki de VictoriaMetrics se indica qué parámetros son más adecuados. Los hemos comprobado. Reducen muy bien el consumo específicamente de CPU.
En nuestro caso, el consumo de memoria de Prometheus, que se encuentra en el clúster de Kubernetes, ha aumentado de manera poco significativa.
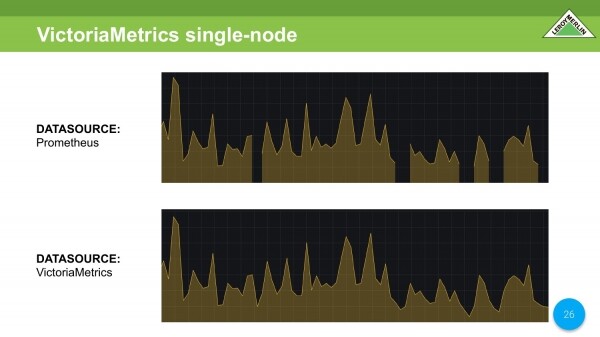
Comparamos dos fuentes de datos de la misma información. En Prometheus vemos todos esos datos faltantes. En VictoriaMetrics todo está bien.
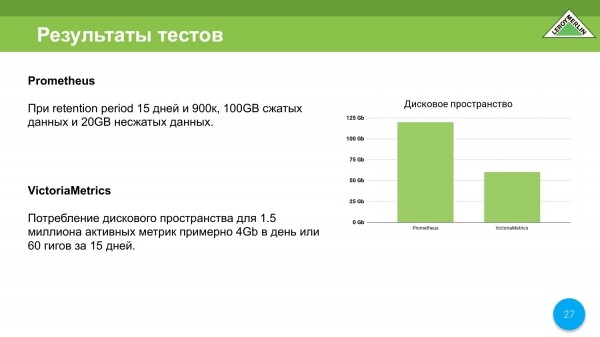
Resultados de las pruebas con el espacio en disco. En Prometheus obtuvimos un total de 120 gigabytes. En VictoriaMetrics obtenemos ya 4 gigabytes por día. Allí hay un mecanismo un poco diferente al que acostumbramos ver en Prometheus. Es decir, los datos ya se comprimen bastante bien en un día, en media hora. Se han comprimido bien en un día, en media hora, a pesar de que luego se fusionarán los datos. Al final, hemos ahorrado en espacio en disco.
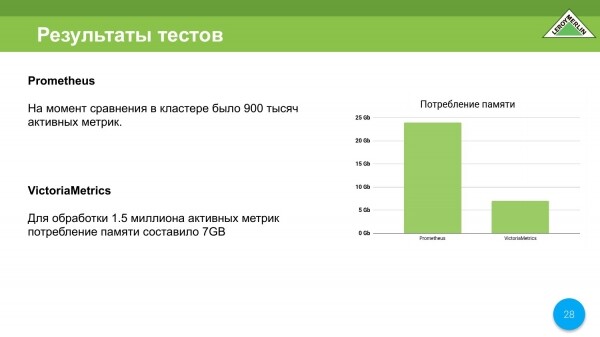
También estamos ahorrando en el consumo de recursos de memoria. En el momento de las pruebas, Prometheus estaba desplegado en una máquina virtual con 8 núcleos y 24 gigabytes. Prometheus consume prácticamente todo. Se cayó por el OOM Killer. En él había aproximadamente 900,000 métricas activas. Eso es alrededor de 25,000-27,000 métricas por segundo.
VictoriaMetrics se ejecutó en una máquina virtual de dos núcleos con 8 gigabytes de RAM. Logramos hacer que VictoriaMetrics funcionara bien ajustando algunas cosas en la máquina de 8 gigabytes. Al final, nos mantuvimos en 7 gigabytes. Al mismo tiempo, obtuvimos una velocidad de entrega de contenido, es decir, métricas, incluso superior a la de Prometheus.
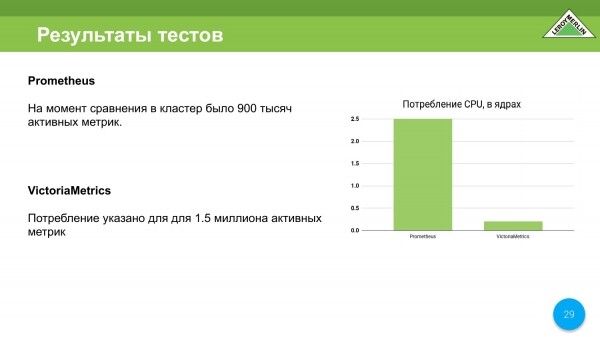
El rendimiento de CPU es mucho mejor en comparación con Prometheus. Aquí Prometheus consume 2.5 núcleos, mientras que VictoriaMetrics solo consume 0.25 núcleos. Al inicio, consume 0.5 núcleos. A medida que se fusiona, llega a un núcleo, pero esto es extremadamente raro.
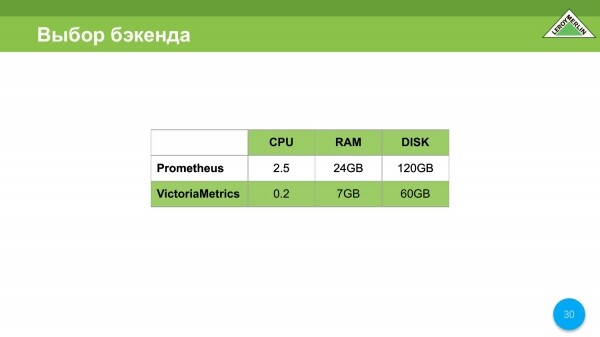
En nuestro caso, la elección recayó en VictoriaMetrics por razones evidentes, queríamos ahorrar y lo hemos logrado.
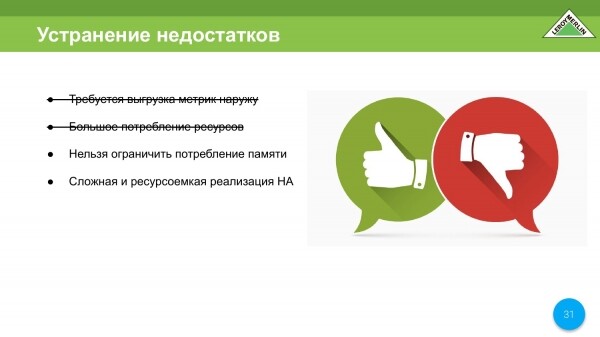
De inmediato descartamos dos puntos: la exportación de métricas y el alto consumo de recursos. Y nos queda resolver dos puntos que aún dejamos pendientes.
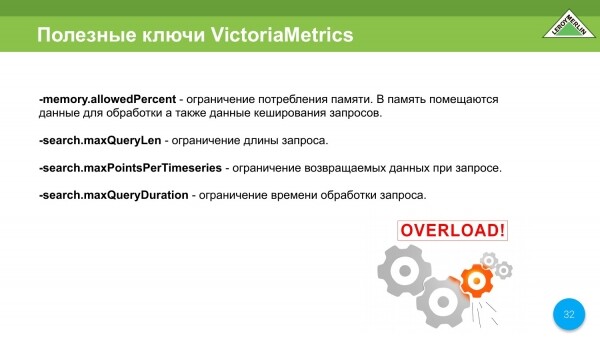
Aquí aclaro de inmediato que consideramos a VictoriaMetrics como el almacenamiento de métricas. Pero como probablemente proporcionaremos VictoriaMetrics como almacenamiento para todo Leroy, necesitamos limitar a quienes utilizarán este clúster para evitar que lo colapsen.
Hay un parámetro excelente que permite limitar el tiempo, el volumen de datos y el tiempo de ejecución.
También hay una gran opción que permite limitar el consumo de memoria, de modo que podamos encontrar ese equilibrio que nos proporcione una velocidad de trabajo adecuada y un consumo de recursos razonable.
Se tacha otro punto, es decir, no se puede limitar el consumo de memoria.
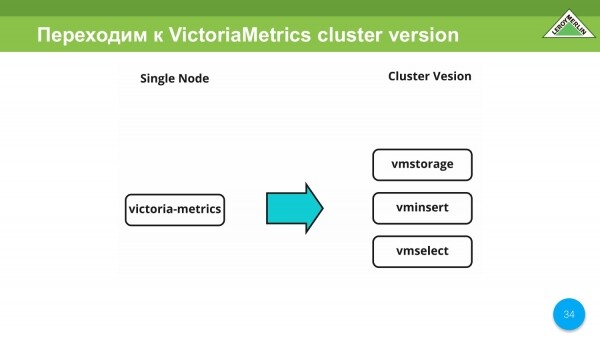
En las primeras iteraciones, probamos VictoriaMetrics Single Node. Luego pasamos a la versión de clúster de VictoriaMetrics.
Aquí tenemos libertad para distribuir diferentes servicios en VictoriaMetrics dependiendo de qué recursos consumirán y en qué se ejecutarán. Es una solución muy flexible y conveniente. Lo hemos utilizado personalmente.
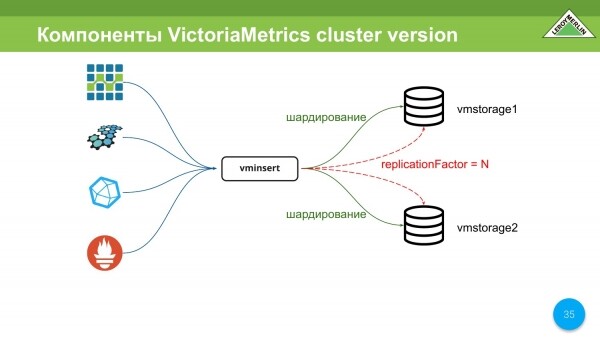
Los componentes principales de la versión de clúster de VictoriaMetrics son vmstorage. Puede haber una cantidad N de ellos. En nuestro caso, por ahora hay 2.
Y está vminsert. Este es un servidor proxy que nos permite: establecer el sharding entre todos los storages que le hemos indicado, y también permite hacer réplicas, es decir, tendrás tanto sharding como réplicas.
Vminsert soporta los protocolos OpenTSDB, Graphite, InfluxDB y remoteWrite de Prometheus.
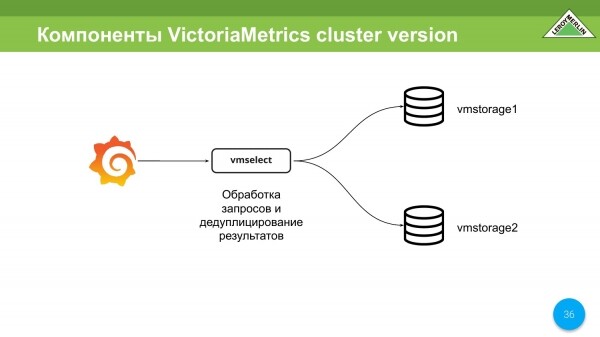
También existe vmselect. Su tarea principal es consultar vmstorage, obtener los datos de ellos, deduplicar esos datos y entregarlos al cliente.
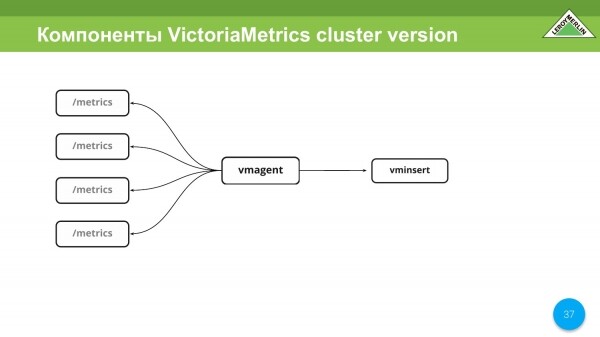
Hay una herramienta maravillosa llamada vmagent. Nos gusta mucho. Permite configurarse exactamente como Prometheus y hacer todo de la misma manera que Prometheus, es decir, recopila métricas de diferentes entidades y servicios y las envía a vminsert. Después, todo depende de ti.
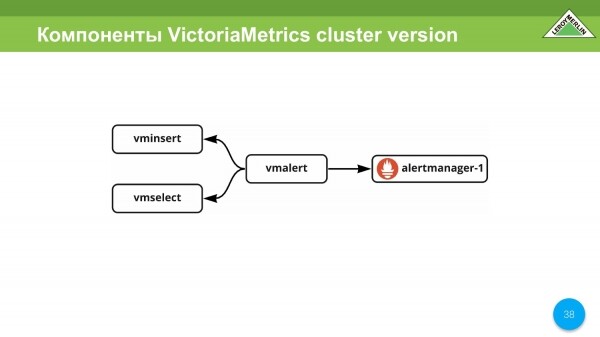
Otro servicio asombroso es vmalert, que permite utilizar VictoriaMetrics como backend, recibir datos de vminsert y enviarlos a vmselect para su procesamiento. Procesa tanto las alertas como las reglas. En caso de alertas, recibimos la alerta a través de alertmanager.
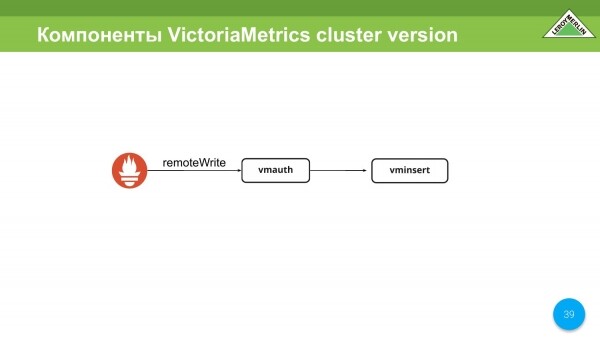
Hay un componente llamado wmauth. Tal vez lo utilicemos, o tal vez no (aún no hemos decidido) como sistema de autorización para las versiones multitenancy de los clústeres. Soporta remoteWrite para Prometheus y puede autorizar según la URL, más concretamente, la segunda parte de la misma, donde se puede o no escribir.
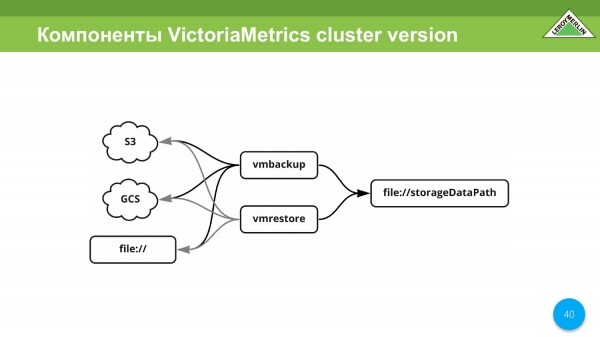
También hay vmbackup y vmrestore. Esto, en esencia, es la recuperación y el backup de todos los datos. Soporta S3, GCS y archivos.
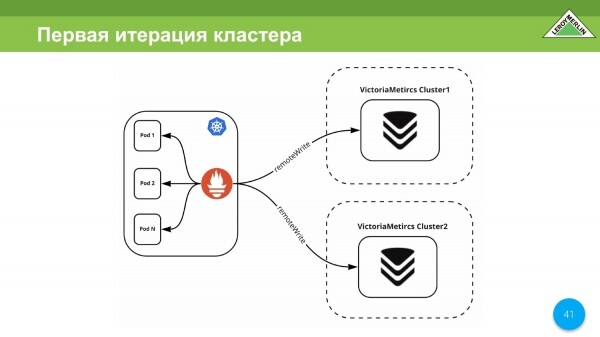
La primera iteración de nuestro clúster se realizó durante la cuarentena. En ese momento no había réplica, así que nuestra iteración consistía en dos clústeres diferentes e independientes, de los cuales recibíamos datos a través de remoteWrite.
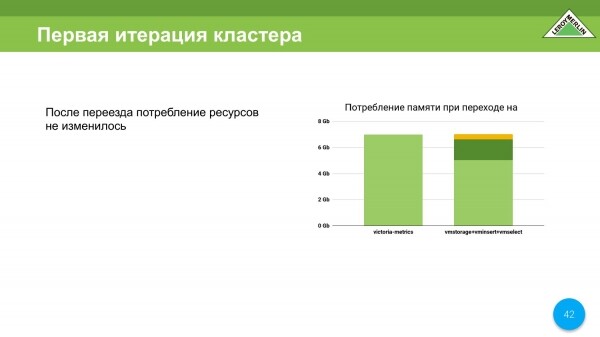
Aquí aclaro que, cuando migramos de VictoriaMetrics Single Node a VictoriaMetrics Cluster Version, seguimos utilizando los mismos recursos consumidos, es decir, la principal es la memoria. Así es como se distribuyeron nuestros datos, es decir, el consumo de recursos.
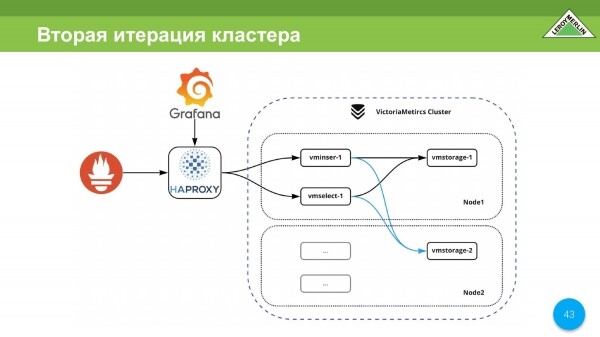
Aquí ya se había añadido una réplica. Unimos todo esto en un clúster relativamente grande. Todos nuestros datos se fragmentan y se replican.
Todo el clúster tiene N puntos de entrada, es decir, Prometheus puede añadir datos a través de HAPROXY. Este es nuestro punto de entrada. A través de este punto de entrada se puede acceder desde Grafana.
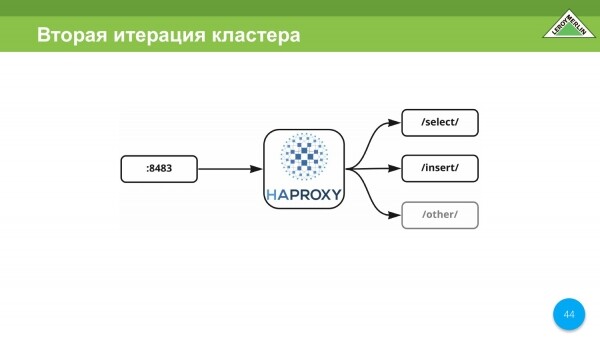
En nuestro caso, HAPROXY es el único puerto que proxies select, insert y otros servicios dentro de este clúster. No pudimos crear una sola dirección, tuvimos que hacer varios puntos de entrada, porque las máquinas virtuales que ejecutan el clúster de VictoriaMetrics se encuentran en diferentes zonas de un mismo proveedor de nube, es decir, no dentro de nuestra nube, sino afuera.
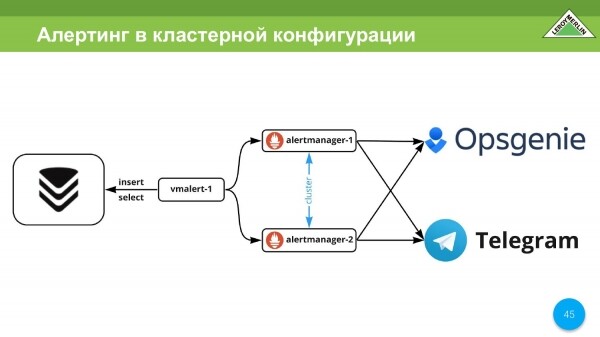
Tenemos alertas. Las utilizamos. Usamos alertmanager de Prometheus. Como canal de entrega de alertas utilizamos Opsgenie y Telegram. En Telegram llegan alertas de dev, quizás algo de prod, pero sobre todo datos estadísticos que son útiles para los ingenieros. Opsgenie es crítico. Estas son llamadas, gestión de incidentes.
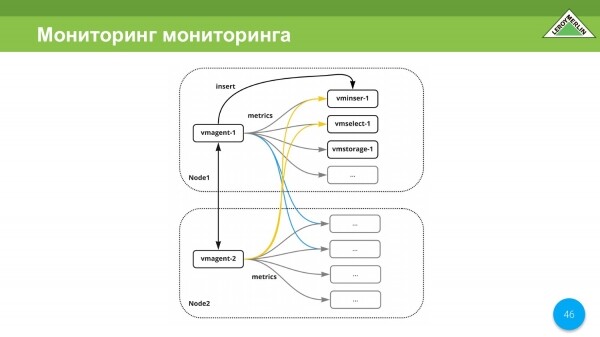
La eterna pregunta: "¿Quién monitorea el monitoreo?". En nuestro caso, el monitoreo monitorea a sí mismo, porque usamos vmagent en cada nodo. Y dado que nuestros nodos están distribuidos en diferentes centros de datos de un proveedor, cada centro de datos tiene su propio canal, son independientes y, incluso si ocurre un split brain, aún así recibiremos alertas. Sí, serán más, pero es mejor recibir más alertas que ninguna.
Concluimos nuestra lista con la implementación de HA.
Y me gustaría resaltar la experiencia de interactuar con la comunidad de VictoriaMetrics. Ha sido muy positiva. Los chicos son muy atentos. Intentan entender cada caso que se presenta.
He abierto incidencias en GitHub. Fueron resueltas muy rápidamente. Hay un par de incidencias que no están completamente cerradas, pero ya veo por el código que el trabajo en esta dirección está en marcha.
El principal problema durante las iteraciones para mí era que si apago un nodo, durante los primeros 30 segundos vminsert no podía entender que el backend no estaba disponible. Ahora esto ya se ha resuelto. En tan solo uno o dos segundos, los datos se recogen de todos los nodos restantes, y la solicitud deja de esperar al nodo que falta.
En algún momento queríamos un operador de VictoriaMetrics. Ya lo tenemos. Actualmente estamos en la fase activa de construir un envoltorio sobre el operador de VictoriaMetrics para tomar todas las reglas de pre-cálculo, etc., de Prometheus, ya que usamos activamente las reglas que vienen con el operador de Prometheus.
Hay sugerencias para mejorar la implementación del clúster. Las expuse anteriormente.
También deseo mucho el downsampling. En nuestro caso, el downsampling se necesita exclusivamente para visualizar tendencias. Bastaría con una sola métrica durante el día. Estas tendencias son necesarias para un año, tres, cinco o diez años. Y un solo valor de métrica es más que suficiente.
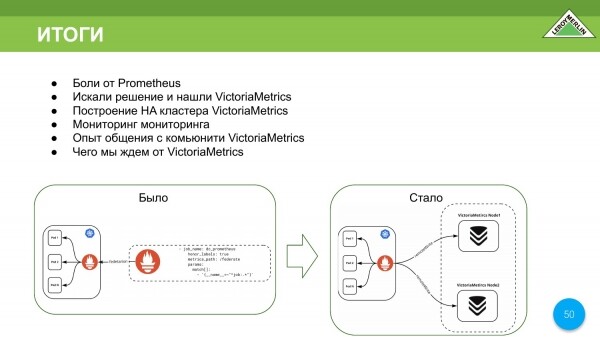
- Conocimos el dolor, al igual que algunos de nuestros colegas, al usar Prometheus.
- Elegimos VictoriaMetrics.
- Se escala bastante bien tanto vertical como horizontalmente.
- Podemos distribuir diferentes componentes en diversos nodos dentro del clúster, limitarlos por volumen de memoria, añadir memoria, etc.
Usaremos VictoriaMetrics, porque nos gustó mucho. Así era y así es ahora.
Un par de códigos qr para el chat de VictoriaMetrics, mis contactos, radar técnico de LeroyMerlin.
Fuente: habr.com
