

Antecedentes
Resultó que el servidor fue atacado por un virus de ransomware que, por "suerte", dejó parcialmente intactos los archivos .ibd (archivos de datos en bruto de las tablas innodb), pero en cambio encriptó completamente los archivos .fpm (archivos de estructuras). Los archivos .idb se podrían clasificar en:
- recuperables a través de medios y guías estándar. Para tales casos, existe una excelente ;
- tablas parcialmente encriptadas. Principalmente se trata de tablas grandes, sobre las que (según entendí), a los atacantes no les bastó la memoria RAM para realizar un cifrado completo;
- y tablas completamente encriptadas, que no son recuperables.
Determinar a cuál de las opciones pertenecen las tablas se logró simplemente abriendo el archivo en cualquier editor de texto con la codificación adecuada (en mi caso, UTF8) y revisando el archivo en busca de campos de texto, por ejemplo:
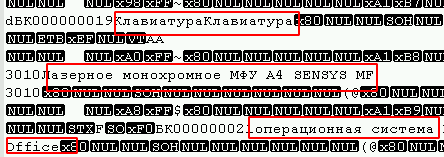
Además, al principio del archivo se puede observar una gran cantidad de bytes cero, y los virus que utilizan un algoritmo de cifrado por bloques (que es el más común) suelen afectar también a estos.

En mi caso, los atacantes dejaban al final de cada archivo encriptado una cadena de 4 bytes (1, 0, 0, 0), lo que facilitó la tarea. Para buscar archivos no infectados, fue suficiente con el siguiente script:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
De este modo, se lograron encontrar los archivos que pertenecían al primer tipo. El segundo implica un largo trabajo manual, pero ya lo encontrado era suficiente. Todo estaría bien, pero es necesario conocer la estructura absolutamente precisa y (por supuesto) surgió el caso en que tuve que trabajar con una tabla que cambiaba frecuentemente. Nadie recordaba si el tipo de campo cambiaba, o si se añadía una nueva columna.
Desafortunadamente, el equipo de Debris City no pudo ayudar con este caso, por lo que se escribe este artículo.
Yendo al grano
Hay una estructura de tabla de hace 3 meses que no coincide con la actual (posiblemente por un solo campo, o tal vez por más). La estructura de la tabla es:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
además, es necesario extraer:
id_puntoINT (11);id_usuarioINT (11);fecha_inicioDATETIME ;fecha_finDATETIME .
Para la recuperación se utiliza un análisis byte a byte del archivo .ibd, seguido de la conversión a un formato más legible. Dado que para buscar lo requerido, solo necesitamos analizar tipos de datos como int y datetime, en el artículo solo se describirán estos, aunque a veces me referiré a otros tipos de datos que pueden ayudar en otros incidentes similares.
Problema 1: en los campos con tipos DATETIME y TEXT había valores NULL, y en el archivo simplemente se omiten, por lo tanto, no pude determinar la estructura para la recuperación en mi caso. En las nuevas columnas, el valor por defecto era null, y parte de la transacción podría haberse perdido debido a la configuración innodb_flush_log_at_trx_commit = 0, por lo que habría que gastar tiempo adicional para determinar la estructura.
Problema 2: se debe tener en cuenta que las filas eliminadas mediante DELETE seguirán estando en el archivo ibd, pero al ALTER TABLE su estructura no se actualizará. Como resultado, la estructura de los datos puede variar desde el inicio del archivo hasta su final. Si utiliza con frecuencia OPTIMIZE TABLE, es poco probable que se enfrente a este problema.
Presta atención, la versión del SGBD influye en la forma de almacenamiento de datos, y este ejemplo puede no funcionar para otras versiones principales. En mi caso, se utilizó la versión Windows de mariadb 10.1.24. Además, aunque en mariadb trabaje con tablas InnoDB, en realidad son , lo que excluye la aplicabilidad del método con InnoDB mysql.
Análisis del archivo
En python, el tipo de datos muestra los datos en unicode en lugar de un conjunto habitual de números. Aunque se puede considerar el archivo en esta forma, para mayor comodidad se pueden convertir los bytes en formato numérico convirtiendo el array de bytes en un array normal (list(example_byte_array)). En cualquier caso, ambos métodos son útiles para el análisis.
Al revisar varios archivos ibd, se pueden encontrar los siguientes:
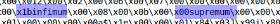
Además, si se divide el archivo por estas palabras clave, se obtienen bloques de datos predominantemente uniformes. Usaremos infimum como divisor.
table = table.split("infimum".encode())Una observación interesante, para tablas con una cantidad pequeña de datos, entre infimum y supremum hay un apuntador al número de filas en el bloque.
 — tabla de prueba con 1 fila
 — tabla de prueba con 2 filas
El array de cadenas table[0] se puede omitir. Al revisarlo, no logré encontrar datos sin procesar de las tablas. Lo más probable es que este bloque sirva para almacenar índices y claves.
A partir de table[1] y al convertirlo en un array numérico, ya se pueden notar ciertos patrones, a saber:
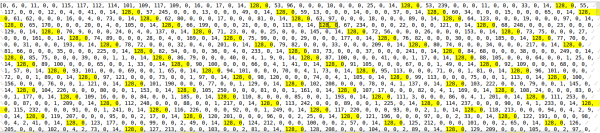
Estos son valores de tipo int almacenados en una cadena. El primer byte indica si el número es positivo o negativo. En mi caso, todos los números son positivos. A partir de los otros 3 bytes, se puede determinar el número utilizando la siguiente función. Script:
def find_int(val: str):  # ejemplo '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Por ejemplo, 128, 0, 0, 1 = 1, o 128, 0, 75, 108 = 19308.
En la tabla había una clave primaria con auto-incremento, y aquí también se puede encontrar.
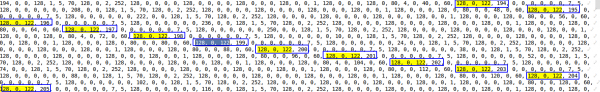
Al comparar los datos de las tablas de prueba, se descubrió que el objeto DATETIME consiste en 5 bytes que comienzan con 153 (probablemente indica intervalos anuales). Dado que el rango DATTIME es de ‘1000-01-01’ a ‘9999-12-31’, creo que el número de bytes puede variar, pero en mi caso, los datos caen dentro del rango de 2016 a 2019, por lo que consideraremos que 5 bytes son suficientes.
Para determinar la hora sin segundos, se escribieron las siguientes funciones. Script:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Para el año y el mes no logré escribir una función que funcione correctamente, así que tuve que codificar. Script:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Estoy seguro de que si se dedica un tiempo n, también se puede corregir este malentendido.
A continuación, una función que devuelve un objeto datetime a partir de una cadena. Script:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Se han encontrado valores que se repiten con frecuencia de int, int, datetime, datetime. 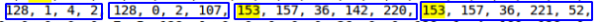 , parece que esto es lo que se necesita. Además, esta secuencia no se repite dos veces en la cadena.
Utilizando expresiones regulares, encontramos los datos necesarios:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Tenga en cuenta que al buscar con esta expresión, no se podrán identificar los valores NULL en los campos requeridos, pero en mi caso esto no es crítico. Luego, iteramos sobre lo encontrado. Script:
resultado = []
for val in fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    result.append(pre_result)
En realidad, todos los datos del array result son los que necesitamos. ###PS.###
Entiendo que este método no será adecuado para todos, pero el objetivo principal del artículo es más bien motivar a la acción que resolver todos sus problemas. Creo que la solución más correcta sería comenzar a estudiar el código fuente del mismo. , pero debido al tiempo limitado, este método me pareció el más rápido.
En algunos casos, al analizar el archivo, podrá determinar la estructura aproximada y restaurarla utilizando uno de los métodos estándar mencionados anteriormente. Esto será mucho más adecuado y generará menos problemas.
Fuente: habr.com
