

Hoy hablaremos sobre los principios y modelos de GitOps, así como sobre cómo se implementan estos modelos en la plataforma OpenShift. Una guía interactiva sobre este tema está disponible. .
En resumen, GitOps es un conjunto de prácticas para utilizar pull requests de Git para gestionar configuraciones de infraestructura y aplicaciones. En GitOps, el repositorio Git se considera como la única fuente de información sobre el estado del sistema, y cualquier cambio en este estado está completamente rastreado y sujeto a auditoría.
La idea de rastrear cambios en GitOps no es nueva; este enfoque se ha aplicado durante mucho tiempo y de forma prácticamente generalizada en el trabajo con el código fuente de las aplicaciones. GitOps simplemente implementa funciones similares (revisiones, pull requests, etiquetas, etc.) en la gestión de configuraciones de infraestructura y aplicaciones, ofreciendo beneficios análogos a los que se obtienen al gestionar el código fuente.
Para GitOps no existe una definición académica o un conjunto de reglas aprobado, sólo un conjunto de principios en los que se basa esta práctica:
- La descripción declarativa del sistema se almacena en un repositorio de Git (configuraciones, monitoreo, etc.).
- Los cambios en el estado se realizan a través de pull requests.
- El estado de los sistemas en funcionamiento se alinea con los datos en el repositorio mediante push requests de Git.
Principios de GitOps
- Las definiciones de los sistemas se describen como código fuente.
La configuración de los sistemas se considera como código, por lo que puede almacenarse y versionarse automáticamente en un repositorio de Git, que sirve como la única fuente de verdad. Este enfoque permite implementar (rollout) y revertir (rollback) cambios en los sistemas con facilidad.
- El estado y la configuración deseados de los sistemas se definen y versionan en Git.
Al almacenar y versionar el estado deseado de los sistemas en Git, obtenemos la posibilidad de implementar y revertir cambios fácilmente en los sistemas y aplicaciones. También podemos utilizar los mecanismos de seguridad de Git para controlar la propiedad del código y confirmar su autenticidad.
- Los cambios en las configuraciones pueden aplicarse automáticamente mediante pull requests.
Al utilizar solicitudes de pull de Git, podemos gestionar fácilmente cómo se aplican los cambios a las configuraciones en el repositorio. Por ejemplo, pueden ser revisados por otros miembros del equipo o sometidos a pruebas de CI.
Y no es necesario otorgar privilegios de administrador de manera indiscriminada. Para realizar un commit de cambios en la configuración, los usuarios solo necesitan los permisos adecuados en el repositorio de Git donde se almacenan dichas configuraciones.
- Solución del problema de deriva incontrolada de configuraciones
Cuando el estado deseado del sistema está almacenado en un repositorio de Git, solo nos queda encontrar un software que controle que el estado actual del sistema corresponda a su estado deseado. Si no es así, este software debe, dependiendo de la configuración, o bien corregir automáticamente la discrepancia, o bien notificarnos sobre la deriva de configuraciones.
Modelos de GitOps para OpenShift
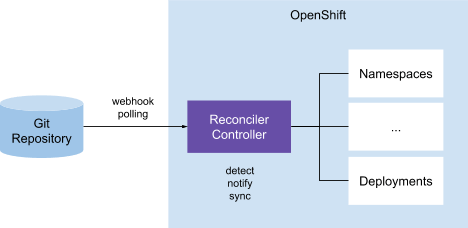
Reconciliador de recursos en el clúster
Según este modelo, hay un controlador en el clúster que se encarga de comparar los recursos de Kubernetes (archivos YAML) en el repositorio de Git con los recursos reales del clúster. Al detectar discrepancias, el controlador envía notificaciones y, posiblemente, toma medidas para corregir las inconsistencias. Este modelo de GitOps se utiliza en Anthos Config Management y Weaveworks Flux.
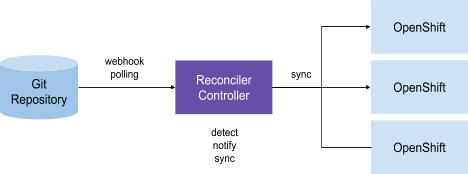
Reconciliador de recursos externos (Push)
Este modelo se puede considerar una variante del anterior, donde tenemos uno o varios controladores responsables de sincronizar recursos en pares "repositorio Git - clúster Kubernetes". La diferencia aquí es que no necesariamente cada clúster gestionado debe tener su propio controlador separado. Los pares "Git - clúster k8s" a menudo se definen como descripciones de CRD (definición de recursos personalizados), donde se puede describir cómo debe el controlador llevar a cabo la sincronización. En este modelo, los controladores comparan el repositorio de Git especificado en el CRD con los recursos del clúster de Kubernetes que también están definidos en el CRD y realizan las acciones correspondientes basadas en los resultados de la comparación. En particular, este modelo de GitOps se utiliza en ArgoCD.
GitOps en la plataforma OpenShift
Administración de infraestructura Kubernetes multicluestro
Con la expansión de Kubernetes y el aumento de la popularidad de las estrategias multicloud y la computación en el borde, también aumenta el número promedio de clústeres de OpenShift por cliente.
Por ejemplo, al utilizar computación periférica, los clústeres de un solo cliente pueden desplegarse por cientos e incluso miles. Como resultado, se ve obligado a gestionar varios clústeres de OpenShift independientes o coordinados en la nube pública y en local.
En este proceso, es necesario resolver una gran cantidad de problemas, en particular:
- Controlar que los clústeres se encuentren en un estado idéntico (configuraciones, monitoreo, almacenamiento, etc.)
- Recrear (o restaurar) clústeres a partir de un estado conocido.
- Crear nuevos clústeres a partir de un estado conocido.
- Aplicar cambios en varios clústeres de OpenShift.
- Revertir cambios en varios clústeres de OpenShift.
- Asociar configuraciones plantilladas con diferentes entornos.
Configuraciones de la aplicación
Durante su ciclo de vida, las aplicaciones a menudo atraviesan una cadena de clústeres (desarrollo, pruebas, etc.) antes de llegar al clúster de producción. Además, debido a las demandas de disponibilidad y escalabilidad, los clientes a menudo despliegan aplicaciones simultáneamente en varios clústeres locales o en varias regiones de una plataforma de nube pública.
En este contexto, se deben abordar las siguientes tareas:
- Asegurar el movimiento de aplicaciones (binarios, configuraciones, etc.) entre clústeres (desarrollo, pruebas, etc.).
- Aplicar cambios en las aplicaciones (binarios, configuraciones, etc.) en varios clústeres de OpenShift.
- Revertir cambios en las aplicaciones a un estado previamente conocido.
Casos de uso de OpenShift GitOps
1. Aplicar cambios desde el repositorio de Git
El administrador del clúster puede almacenar las configuraciones del clúster de OpenShift en un repositorio de Git y aplicarlas automáticamente para crear nuevos clústeres y llevarlos a un estado idéntico al estado conocido que se almacena en el repositorio de Git.
2. Sincronización con Secret Manager
Al administrador también le será útil la posibilidad de sincronizar objetos de secretos de OpenShift con software correspondiente como Vault, para gestionarlos utilizando herramientas especialmente diseñadas para ello.
3. Control de la desviación de configuraciones
El administrador estará satisfecho si OpenShift GitOps puede identificar y advertir automáticamente sobre discrepancias entre las configuraciones reales y las que están establecidas en el repositorio, para poder reaccionar rápidamente ante la desviación.
4. Notificaciones sobre el desvío de configuraciones
Serán útiles cuando el administrador quiera conocer rápidamente los casos de desvío de configuraciones para tomar las medidas adecuadas por su cuenta.
5. Sincronización manual de configuraciones en caso de desvío
Permite al administrador sincronizar el clúster de OpenShift con el repositorio de Git en caso de desvío de configuraciones, para devolver rápidamente el clúster a su estado conocido anterior.
6. Sincronización automática de configuraciones en caso de desvío
El administrador también puede configurar el clúster de OpenShift para sincronizarse automáticamente con el repositorio al detectar un desvío, de modo que la configuración del clúster siempre coincida con los archivos de configuración en Git.
7. Varios clústeres – un solo repositorio
El administrador puede almacenar en un solo repositorio de Git las configuraciones de varios clústeres de OpenShift diferentes y aplicarlas selectivamente según sea necesario.
8. Jerarquía de configuraciones de clústeres (herencia)
El administrador puede establecer una jerarquía de configuraciones de clústeres en el repositorio (stage, prod, portafolio de aplicaciones, etc. con herencia). En otras palabras, puede definir cómo deben aplicarse las configuraciones: a uno o varios clústeres.
Por ejemplo, si el administrador establece en el repositorio de Git una jerarquía "Clústeres de producción (prod) → Clústeres del sistema X → Clústeres de producción del sistema X", entonces a los clústeres de producción del sistema X se les aplica la combinación de las siguientes configuraciones:
- Configuraciones comunes para todos los clústeres de producción.
- Configuraciones para el clúster del sistema X.
- Configuraciones para el clúster de producción del sistema X.
9. Plantillas y sobrescritura de configuraciones
El administrador puede sobrescribir el conjunto de configuraciones heredadas y sus valores, por ejemplo, para ajustar más finamente la configuración para ciertos clústeres a los que se aplicarán.
10. Inclusiones y exclusiones selectivas para configuraciones, configuraciones de aplicaciones
El administrador puede establecer condiciones para aplicar o no aplicar ciertas configuraciones a clústeres con características específicas.
11. Soporte de plantillas
A los desarrolladores les será útil tener la posibilidad de elegir cómo se definirán los recursos de la aplicación (Helm Chart, yaml puro de Kubernetes, etc.), para utilizar el formato más adecuado para cada aplicación concreta.
Herramientas GitOps en la plataforma OpenShift
ArgoCD
ArgoCD implementa el modelo External Resource Reconcile y ofrece una interfaz de usuario centralizada para orquestar las relaciones entre clústeres y repositorios de Git en un esquema de "uno a muchos". Las desventajas de este programa incluyen la imposibilidad de gestionar aplicaciones sin un ArgoCD en funcionamiento.
Flux
Flux implementa el modelo On-Cluster Resource Reconcile y, como consecuencia, no hay gestión centralizada del repositorio de definiciones, lo cual es un punto débil. Por otro lado, precisamente debido a la falta de centralización, la posibilidad de gestionar aplicaciones se mantiene incluso cuando un clúster falla.
Instalación de ArgoCD en OpenShift
ArgoCD ofrece una excelente interfaz de línea de comandos y consola web, por lo que no consideraremos Flux y otras alternativas aquí.
Para desplegar ArgoCD en la plataforma OpenShift 4, sigue los siguientes pasos como administrador del clúster:
Despliegue de componentes de ArgoCD en la plataforma OpenShift
# Create a new namespace for ArgoCD components
oc create namespace argocd
# Apply the ArgoCD Install Manifest
oc -n argocd apply -f https://raw.githubusercontent.com/argoproj/argo-cd/v1.2.2/manifests/install.yaml
# Get the ArgoCD Server password
ARGOCD_SERVER_PASSWORD=$(oc -n argocd get pod -l "app.kubernetes.io/name=argocd-server" -o jsonpath='{.items[*].metadata.name}')
Modificación del ArgoCD Server para que sea visible a través de OpenShift Route
# Patch ArgoCD Server so no TLS is configured on the server (--insecure)
PATCH='{"spec":{"template":{"spec":{"$setElementOrder/containers":[{"name":"argocd-server"}],"containers":[{"command":["argocd-server","--insecure","--staticassets","/shared/app"],"name":"argocd-server"}]}}}}'
oc -n argocd patch deployment argocd-server -p $PATCH
# Expose the ArgoCD Server using an Edge OpenShift Route so TLS is used for incoming connections
oc -n argocd create route edge argocd-server --service=argocd-server --port=http --insecure-policy=Redirect
Despliegue de la herramienta ArgoCD Cli
# Download the argocd binary, place it under /usr/local/bin and give it execution permissions
curl -L https://github.com/argoproj/argo-cd/releases/download/v1.2.2/argocd-linux-amd64 -o /usr/local/bin/argocd
chmod +x /usr/local/bin/argocd
Cambio de la contraseña de administrador del ArgoCD Server
# Get ArgoCD Server Route Hostname
ARGOCD_ROUTE=$(oc -n argocd get route argocd-server -o jsonpath='{.spec.host}')
# Login with the current admin password
argocd --insecure --grpc-web login ${ARGOCD_ROUTE}:443 --username admin --password ${ARGOCD_SERVER_PASSWORD}
# Update admin's password
argocd --insecure --grpc-web --server ${ARGOCD_ROUTE}:443 account update-password --current-password ${ARGOCD_SERVER_PASSWORD} --new-password
Después de realizar estos pasos, se puede interactuar con el ArgoCD Server a través de la consola web ArgoCD WebUI o del conjunto de herramientas de línea de comandos ArgoCD Cli.
GitOps – nunca es demasiado tarde
"El tren ya salió" – así se dice sobre una situación en la que se ha perdido la oportunidad de hacer algo. En el caso de OpenShift, el deseo de comenzar a usar esta nueva y genial plataforma a menudo crea exactamente esa situación en la gestión y mantenimiento de rutas, despliegues y otros objetos de OpenShift. Pero, ¿siempre se ha perdido la oportunidad por completo?
Continuando con la serie de artículos sobre , hoy mostraremos cómo transformar una aplicación creada manualmente y sus recursos en un proceso donde todo es gestionado por el conjunto de herramientas GitOps. Para ello, primero desplegaremos manualmente la aplicación httpd. En la captura de pantalla a continuación se muestra cómo creamos un espacio de nombres, un despliegue y un servicio, y luego hacemos expose para este servicio para crear una ruta.
oc create -f https://raw.githubusercontent.com/openshift/federation-dev/master/labs/lab-4-assets/namespace.yaml
oc create -f https://raw.githubusercontent.com/openshift/federation-dev/master/labs/lab-4-assets/deployment.yaml
oc create -f https://raw.githubusercontent.com/openshift/federation-dev/master/labs/lab-4-assets/service.yaml
oc expose svc/httpd -n simple-app
Así que tenemos una aplicación creada manualmente. Ahora debe ser trasladada a la gestión de GitOps sin perder disponibilidad. En resumen, esto se hace de la siguiente manera:
- Creamos un repositorio Git para el código.
- Exportamos nuestros objetos actuales y los cargamos en el repositorio Git.
- Seleccionamos e implementamos la herramienta GitOps.
- Agregamos nuestro repositorio a esta herramienta.
- Definimos la aplicación en nuestra herramienta GitOps.
- Realizamos una prueba de inicio de la aplicación utilizando la herramienta GitOps.
- Sincronizamos los objetos con la herramienta GitOps.
- Activamos la limpieza (pruning) y la auto-sincronización de los objetos.
Como ya se mencionó anteriormente, en GitOps hay una y solo una fuente de información sobre todos los objetos en el(los) clúster(es) de Kubernetes: el repositorio Git. A partir de aquí, partimos de la premisa de que en su organización ya se utiliza un repositorio Git. Este puede ser público o privado, pero debe estar accesible para los clústeres de Kubernetes. Puede ser el mismo repositorio que el de los códigos de las aplicaciones, o un repositorio separado creado específicamente para los despliegues. Se recomienda tener permisos estrictos en el repositorio, ya que se almacenarán objetos secretos, rutas y otras cosas sensibles a la seguridad.
En nuestro ejemplo, crearemos un nuevo repositorio público en GitHub. Puede llamarlo como desee, nosotros usaremos el nombre blogpost.
Si los archivos YAML de los objetos no se han almacenado localmente o en Git, se deberá utilizar los binarios oc o kubectl. En la captura de pantalla a continuación, solicitamos YAML para nuestro espacio de nombres, el despliegue, el servicio y la ruta. Antes de esto, clonamos el repositorio recién creado y entramos en él con el comando cd.
oc get namespace simple-app -o yaml --export > namespace.yaml
oc get deployment httpd -o yaml -n simple-app --export > deployment.yaml
oc get service httpd -o yaml -n simple-app --export > service.yaml
oc get route httpd -o yaml -n simple-app --export > route.yaml
Ahora corregiremos el archivo deployment.yaml para eliminar el campo que Argo CD no puede sincronizar.
sed -i '/sgeneration: .* /d' deployment.yamlAdemás, necesitamos modificar la ruta. Primero, definiremos una variable de múltiples líneas y luego reemplazaremos ingress: null con el contenido de esa variable.
export ROUTE="  ingress:
    - conditions:
        - status: 'True'
          type: Admitted"

sed -i "s/  ingress: null/$ROUTE/g" route.yaml
Así, con los archivos resueltos, solo queda guardarlos en el repositorio Git. A partir de ahí, este repositorio se convierte en la única fuente de información, y cualquier cambio manual en los objetos debe estar estrictamente prohibido.
git commit -am 'initial commit of objects'
git push origin master
A partir de aquí, asumimos que ya tiene ArgoCD desplegado (cómo hacerlo – vea lo anterior) ). Por lo tanto, agregaremos a Argo CD el repositorio que creamos, que contiene el código de la aplicación de nuestro ejemplo. Solo asegúrese de especificar exactamente el repositorio que creó anteriormente.
argocd repo add https://github.com/cooktheryan/blogpostAhora creamos la aplicación. La aplicación establece los valores para que la herramienta GitOps entienda qué repositorio y rutas usar, qué OpenShift es necesario para administrar los objetos, así como qué rama específica del repositorio se necesita, y si se debe realizar la auto-sincronización de los recursos.
argocd app create --project default
--name simple-app --repo https://github.com/cooktheryan/blogpost.git
--path . --dest-server https://kubernetes.default.svc
--dest-namespace simple-app --revision master --sync-policy none
Después de que la aplicación esté configurada en Argo CD, esta herramienta comienza a verificar los objetos ya desplegados para que coincidan con las definiciones en el repositorio. En nuestro ejemplo, la auto-sincronización y la limpieza están desactivadas, por lo que los elementos no cambian por ahora. Tenga en cuenta que en la interfaz de Argo CD, nuestra aplicación tendrá el estado 'Fuera de Sincronización' (Out of Sync), ya que no hay etiqueta que asigne ArgoCD.
Es por eso que, cuando más adelante iniciemos la sincronización, no se volverán a desplegar los objetos.
Ahora realizaremos un ensayo para asegurarnos de que no hay errores en nuestros archivos.
argocd app sync simple-app --dry-runSi no hay errores, se puede proceder a la sincronización.
argocd app sync simple-appDespués de ejecutar el comando argocd get sobre nuestra aplicación, debemos ver que el estado de la aplicación ha cambiado a Saludable (Healthy) o Sincronizado (Synced). Esto indicará que todos los recursos en el repositorio de Git ahora coinciden con los recursos ya desplegados.
argocd app get simple-app
Name:               simple-app
Project:            default
Server:             https://kubernetes.default.svc
Namespace:          simple-app
URL:                https://argocd-server-route-argocd.apps.example.com/applications/simple-app
Repo:               https://github.com/cooktheryan/blogpost.git
Target:             master
Path:               .
Sync Policy:
Sync Status:        Synced to master (60e1678)
Health Status:      Healthy
...
Ahora sí, ya se puede habilitar la auto-sincronización y la limpieza, para garantizar que nada se cree manualmente y que cada vez que un objeto se crea o actualiza en el repositorio, se realice un despliegue.
argocd app set simple-app --sync-policy automated --auto-prune Así que hemos migrado con éxito a un control de GitOps una aplicación que originalmente no utilizaba GitOps de ninguna manera.
Fuente: habr.com
